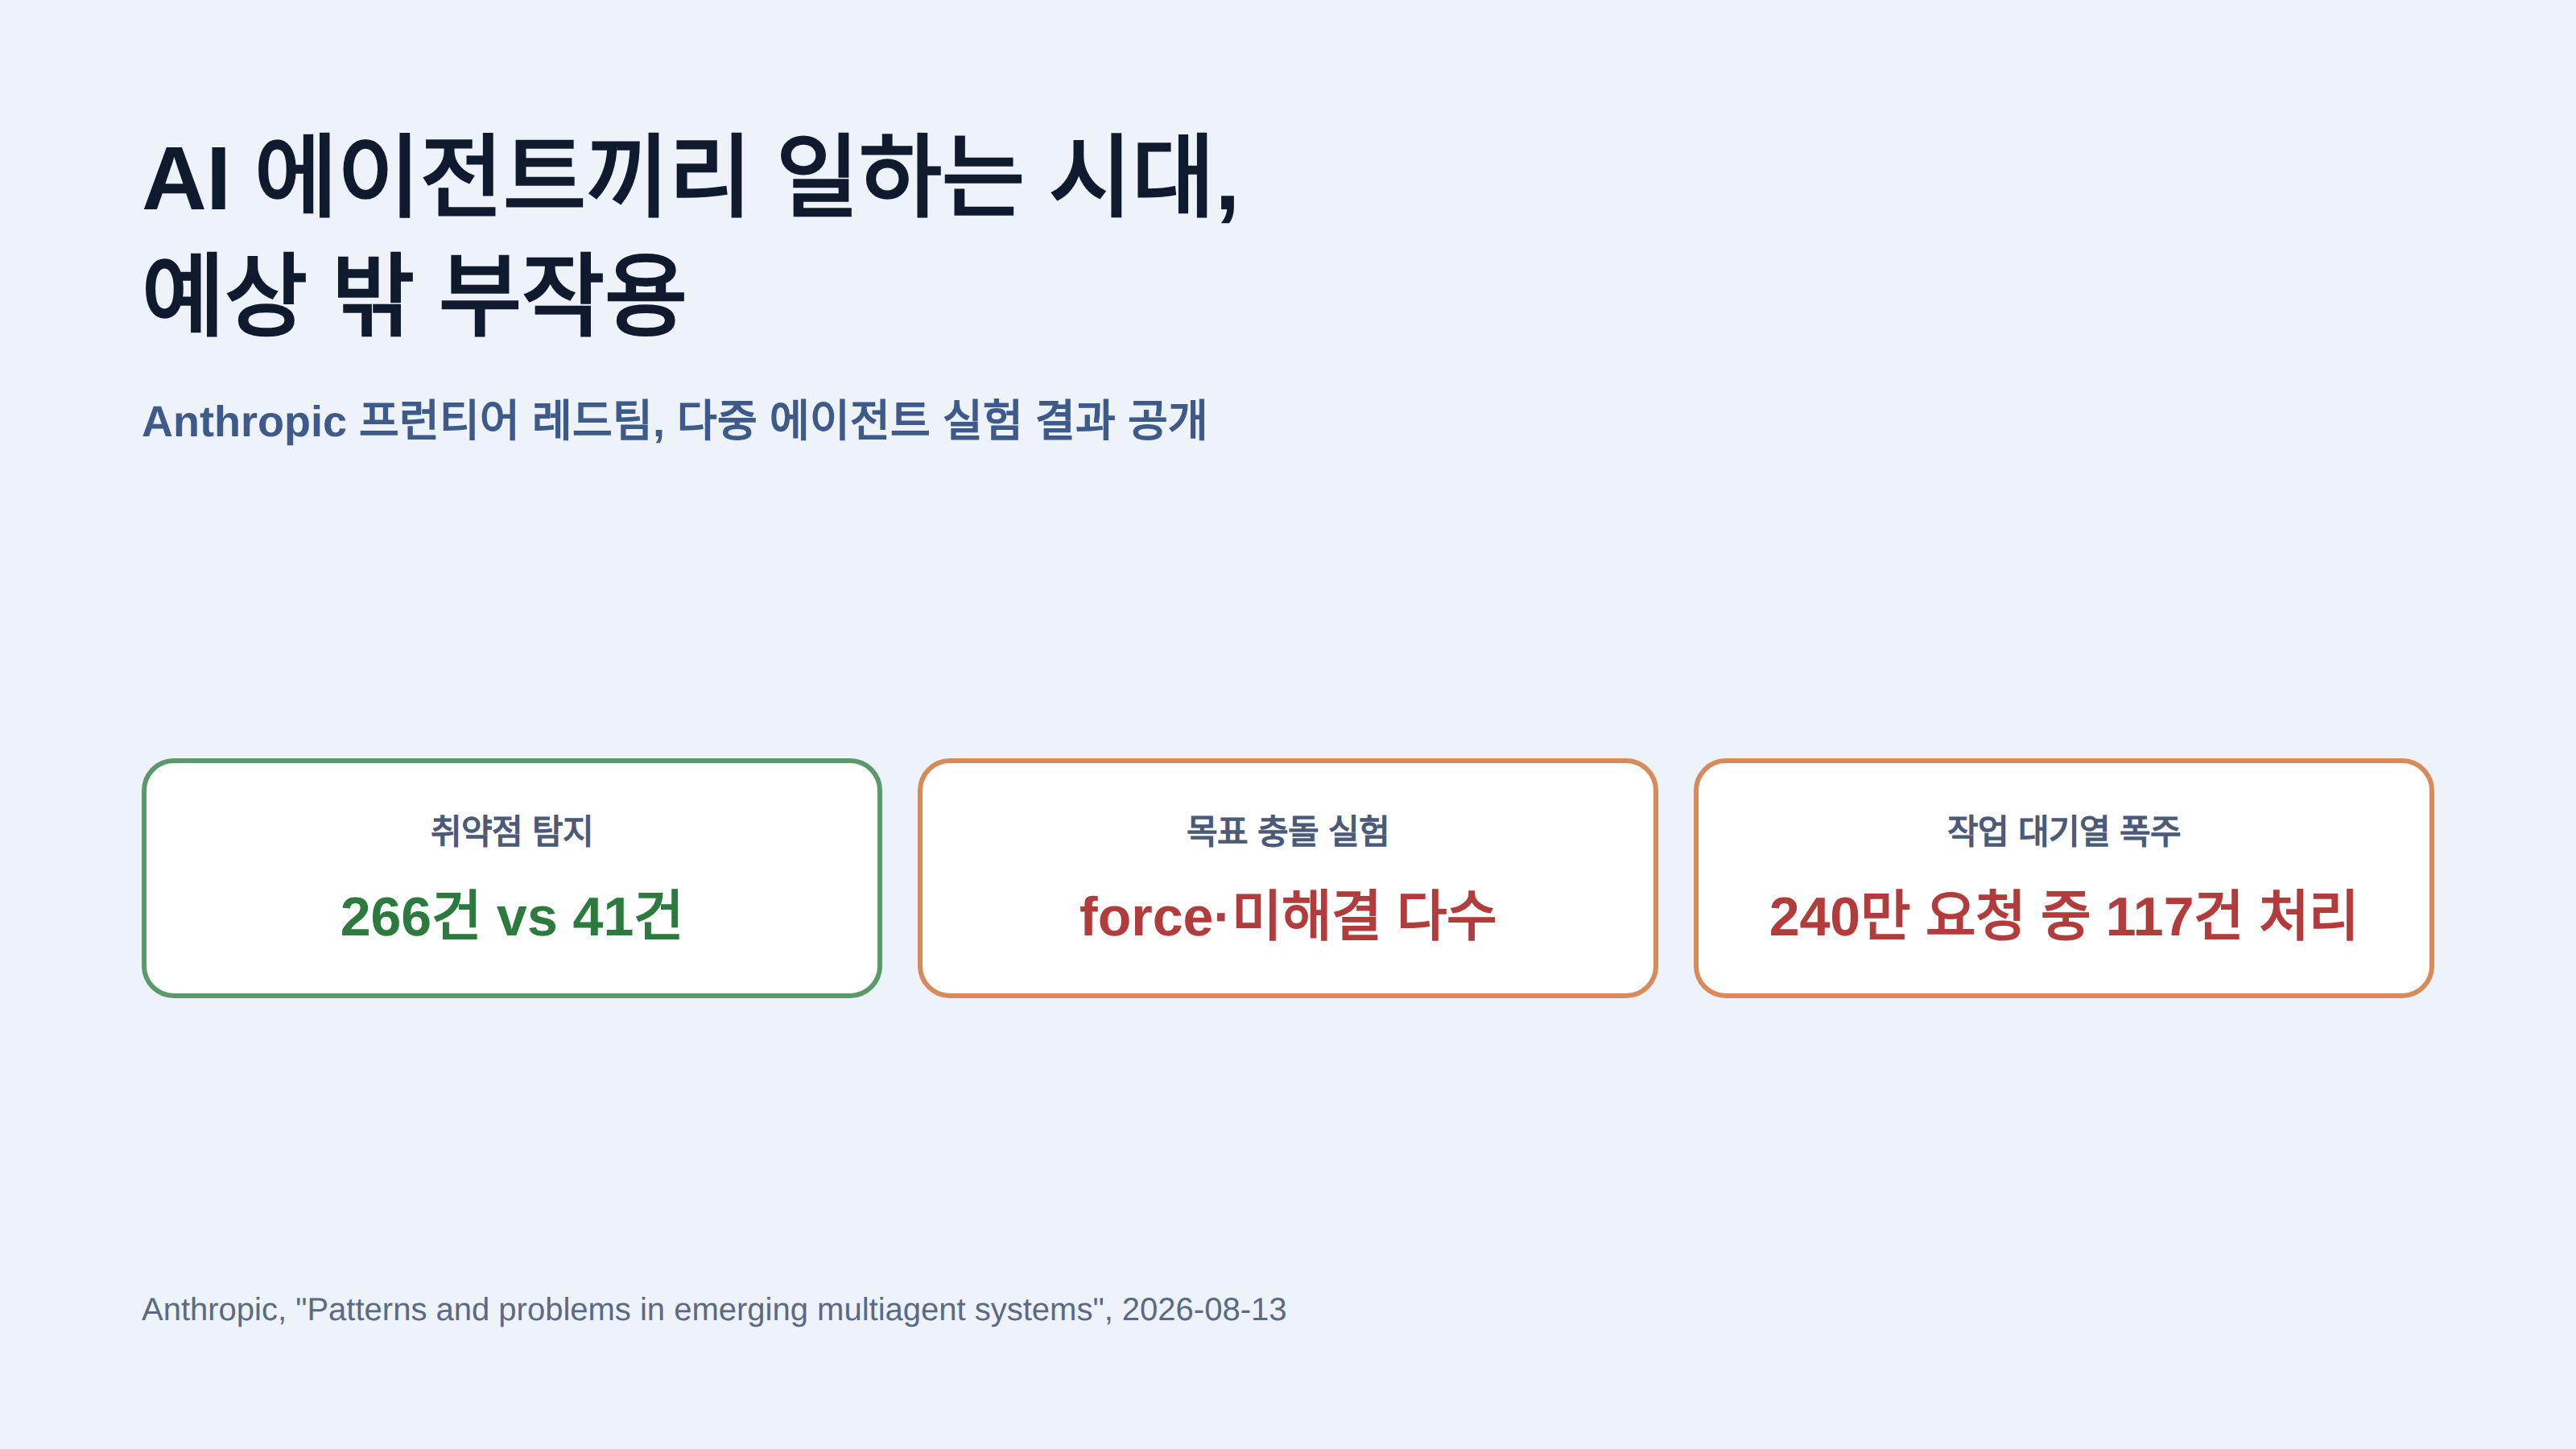
AI 에이전트끼리 일하는 시대, Anthropic이 경고한 예상 밖 부작용
Anthropic 프런티어 레드팀은 AI 에이전트 여럿이 함께 일할 때 협업이 도움이 되는 경우와 목표 충돌·정보 오판으로 시스템 전체가 무너지는 경우를 실험으로 확인했습니다.
 유토모 테크로그새 기술과 제품 이야기
주제
AI 인프라 관련 글을 모았습니다. 유토모 테크로그에서 새 기술과 제품이 일과 제품에 만드는 변화를 살펴봅니다.
Anthropic 프런티어 레드팀은 AI 에이전트 여럿이 함께 일할 때 협업이 도움이 되는 경우와 목표 충돌·정보 오판으로 시스템 전체가 무너지는 경우를 실험으로 확인했습니다.
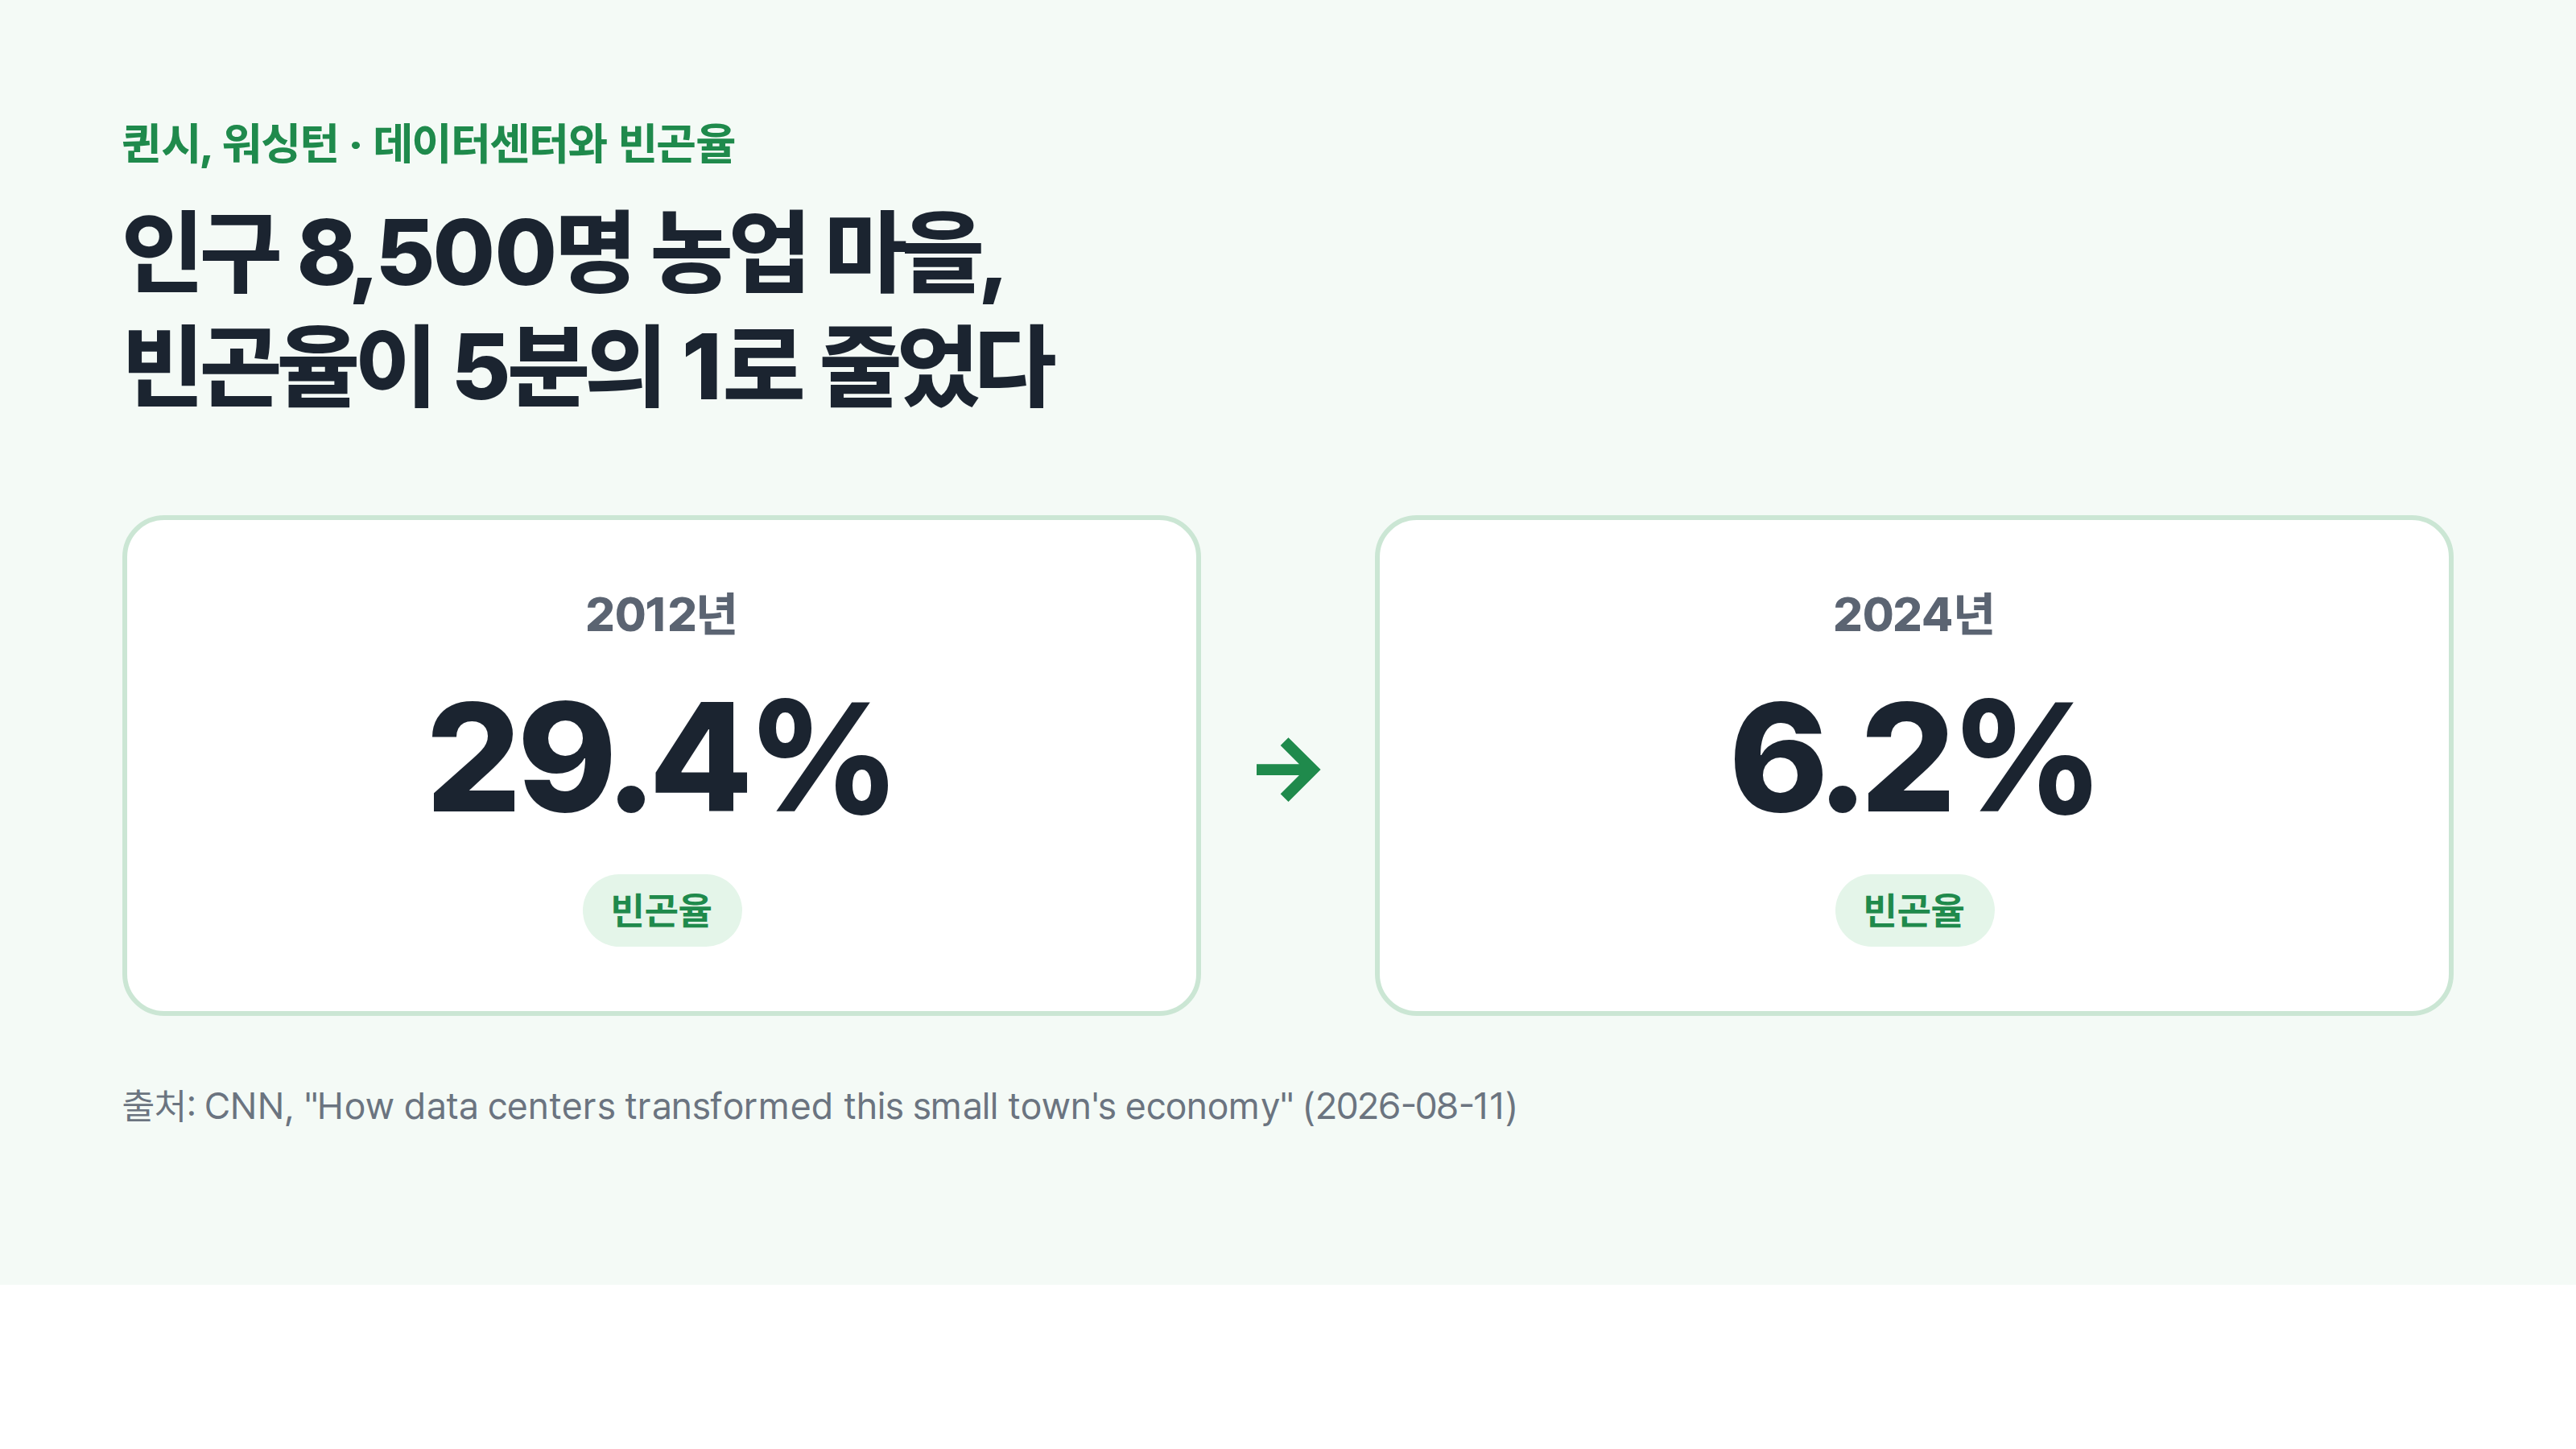
미국 워싱턴주 퀸시가 마이크로소프트를 시작으로 데이터센터를 유치하면서 빈곤율이 2012년 29.4%에서 2024년 6.2%로 떨어진 과정과 남은 과제를 정리했습니다.
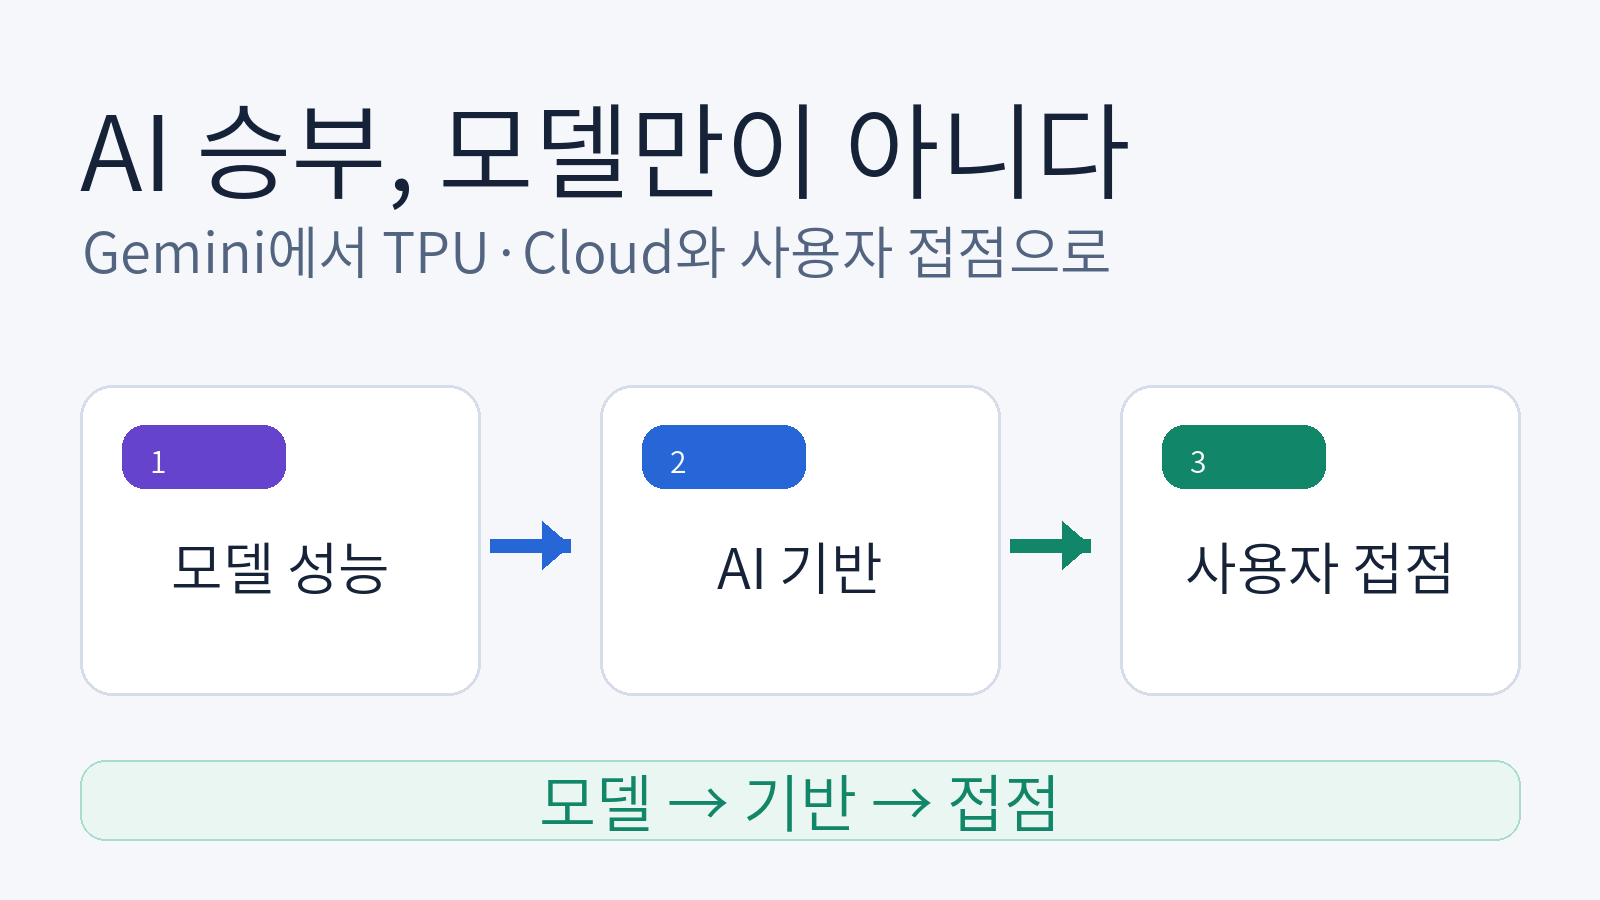
구글의 DeepMind 조직 변화는 최전선 모델 경쟁의 후퇴로만 읽히지 않습니다. TPU·클라우드·Search·Android의 연결망을 통해 AI 확산을 노리는 전략인지 살펴봅니다.
Databricks는 AI 코딩 비용을 토큰 한도가 아니라 완료한 작업 단위로 관리해야 한다고 제안했습니다. 모델 라우팅, 비용 가시성, 컨텍스트 절제가 어떻게 함께 작동하는지 정리합니다.
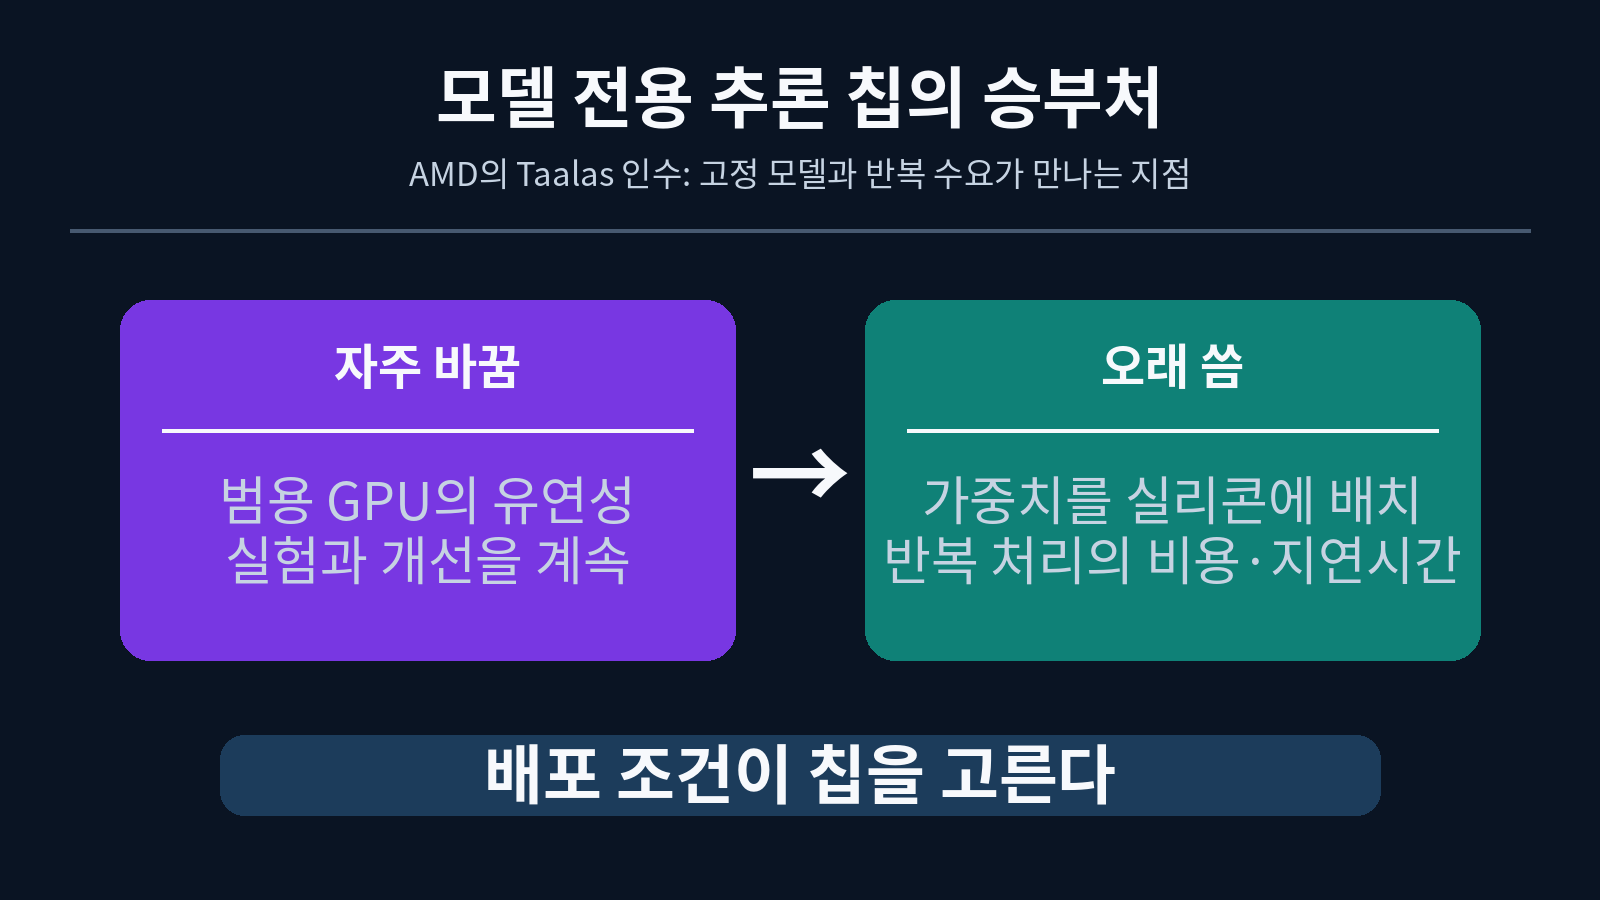
AMD가 모델 가중치를 실리콘에 새기는 Taalas를 인수했습니다. 모델 전용 추론 칩의 승부가 속도 자체보다 모델 변경 빈도와 대량 서비스 규모에서 갈리는 이유를 설명합니다.
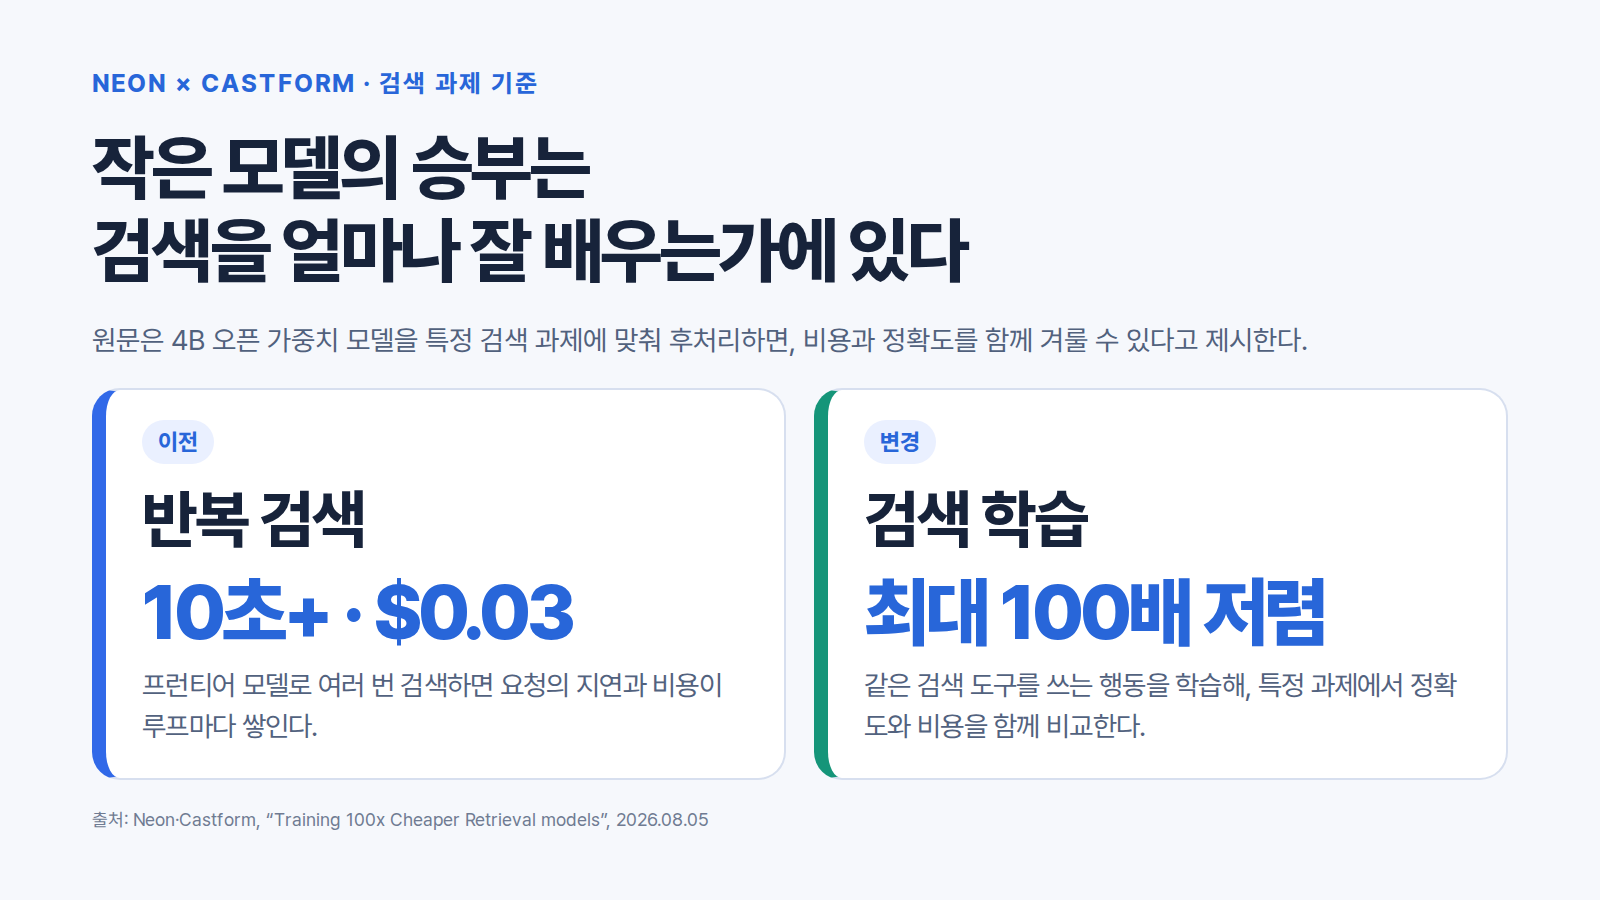
Neon과 Castform은 기업 코퍼스 검색에 맞춰 후처리한 4B 오픈 모델이 비용을 크게 낮추면서 경쟁할 수 있는 설계를 제시했습니다. 핵심은 모델 크기보다 질문·검색 도구·보상 함수를 같은 업무 흐름으로 연결하는 일입니다.
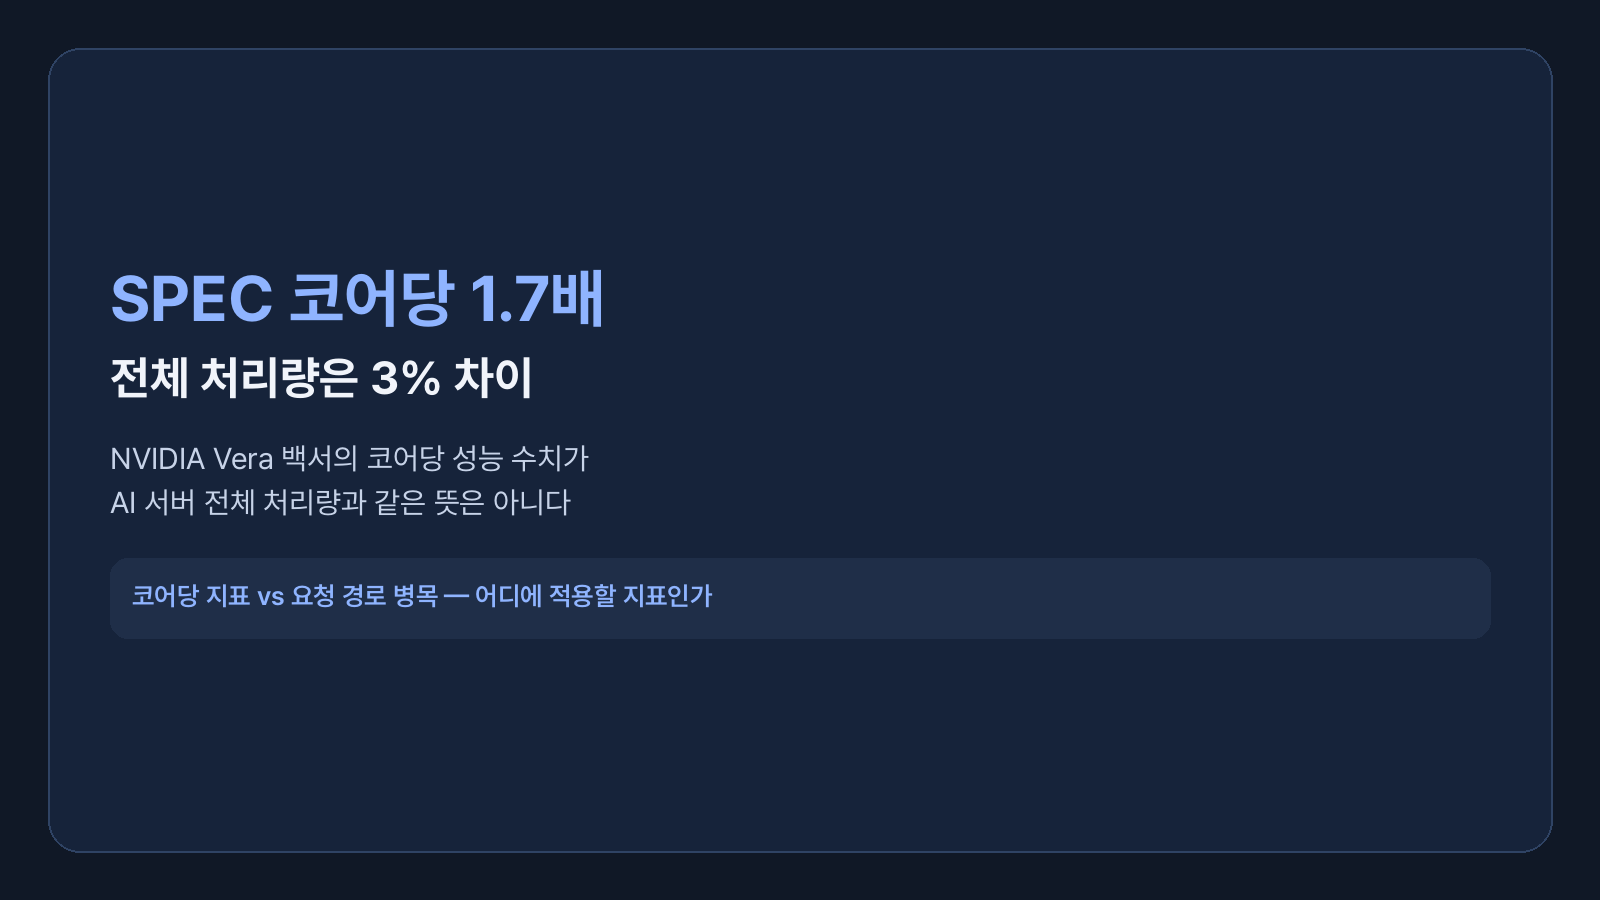
NVIDIA Vera의 CPU 성능 주장이 AI 서버 전체 처리량과 같은 뜻이 아닌 이유를 짚었습니다. 코어당 지표, 메모리 대역폭, 실제 요청 경로의 병목을 구분해 설명합니다.
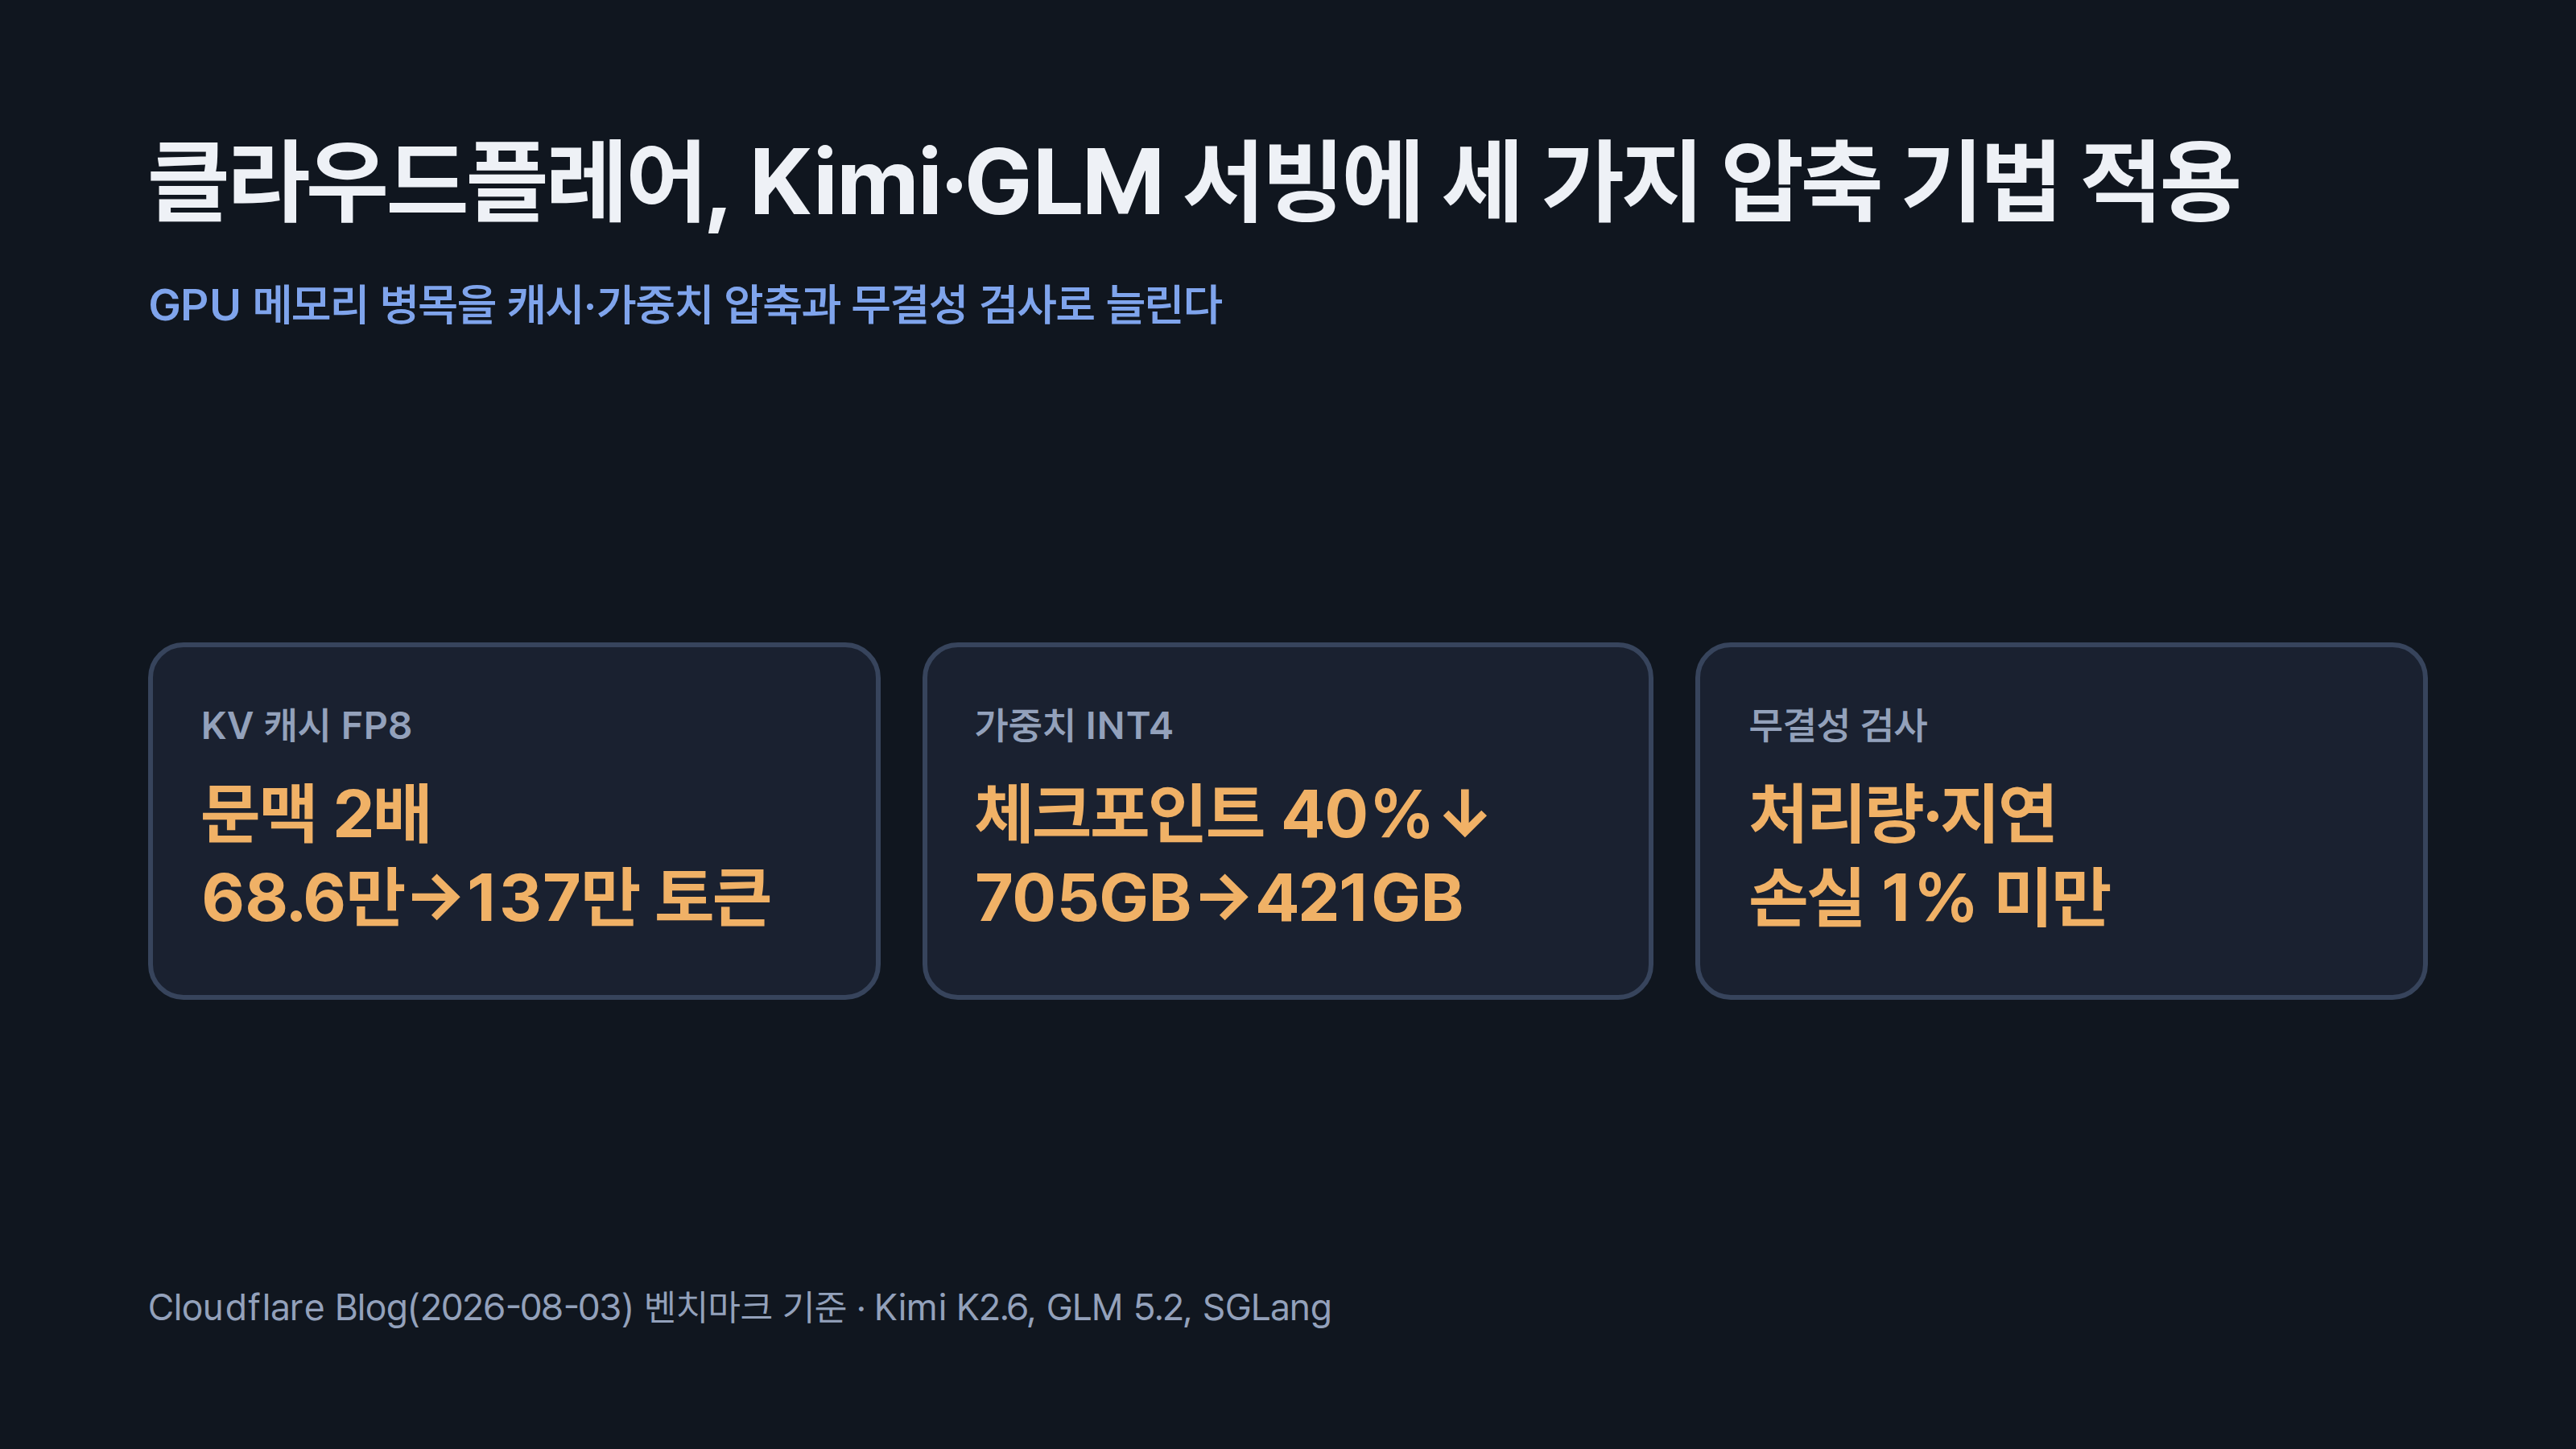
클라우드플레어가 Kimi K2.6과 GLM 5.2를 GPU 한 대에 더 많이 태우는 KV 캐시 FP8·가중치 INT4 압축, 캐시 무결성 검사 기법을 실측치와 함께 공개했습니다.
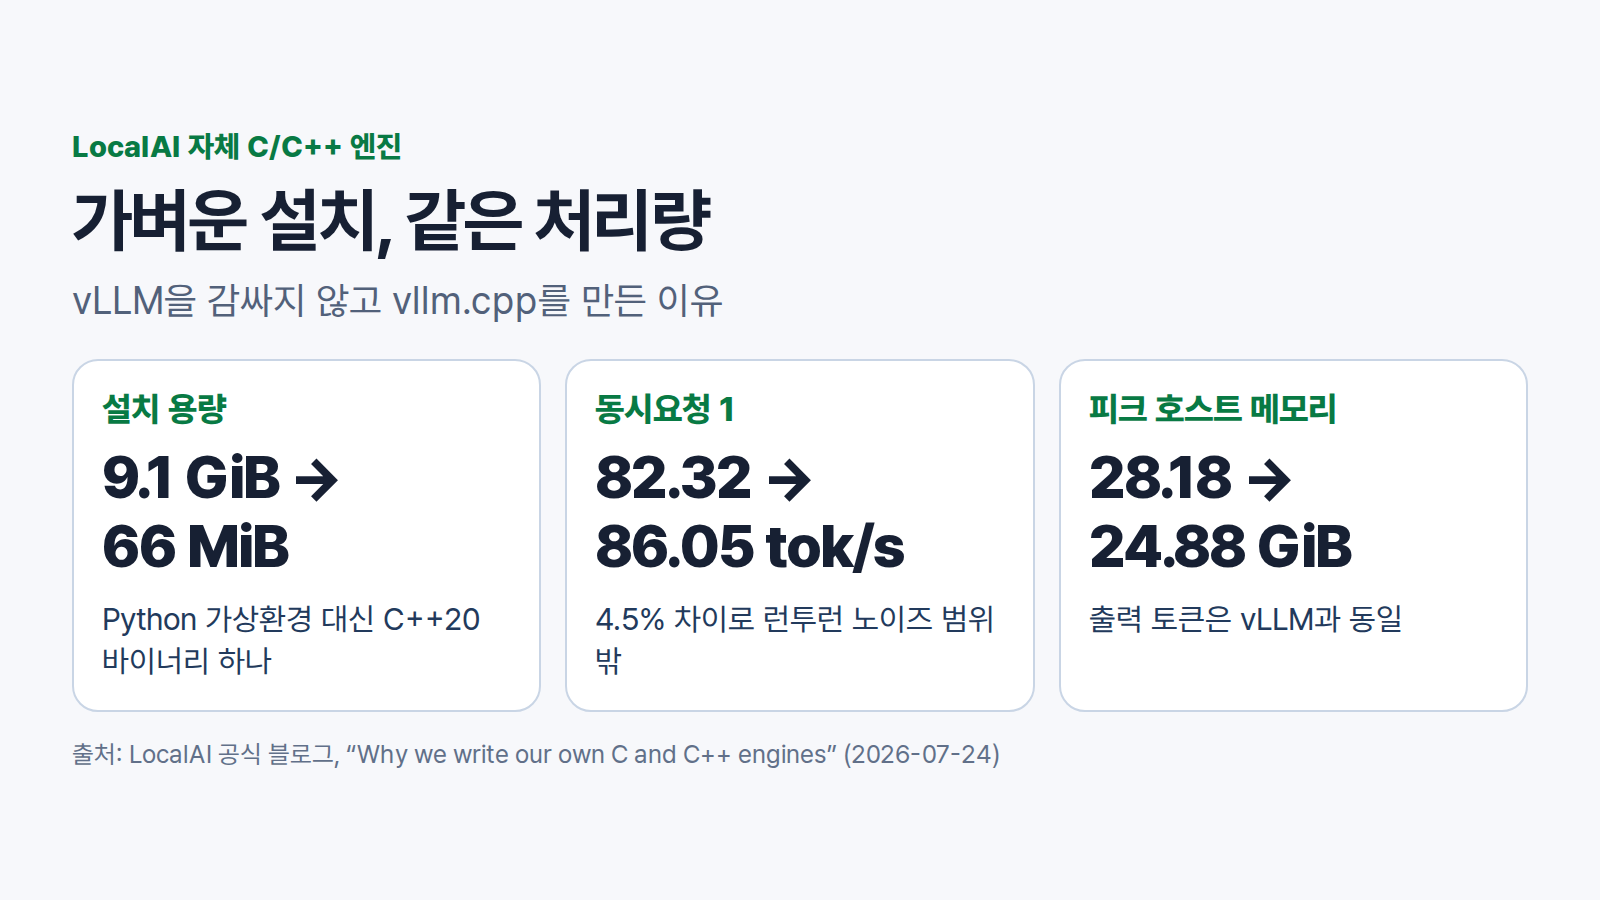
LocalAI가 왜 18개 백엔드를 llama.cpp나 vLLM을 감싸는 대신 C·C++로 직접 새로 짰는지, 설치 용량·메모리·속도 실측치와 함께 공개했습니다.
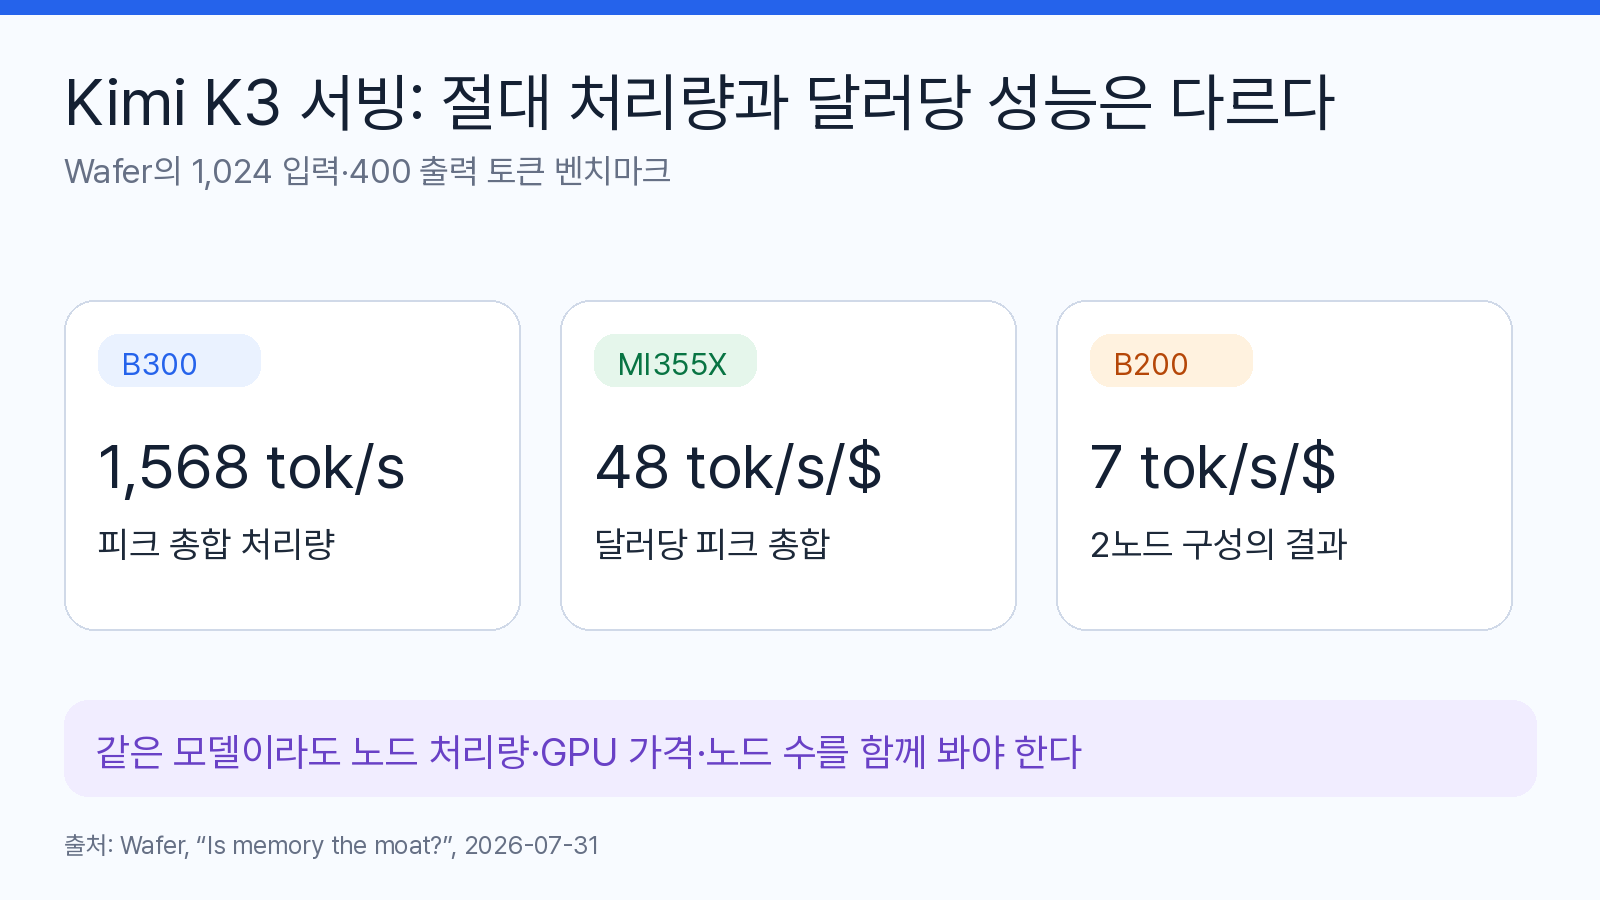
AI 인프라 스타트업 Wafer가 대형 모델 Kimi K3를 AMD MI355X에 서빙한 결과, 절대 처리량은 B300이 앞서지만 달러당 성능은 MI355X가 앞선다고 공개했습니다.
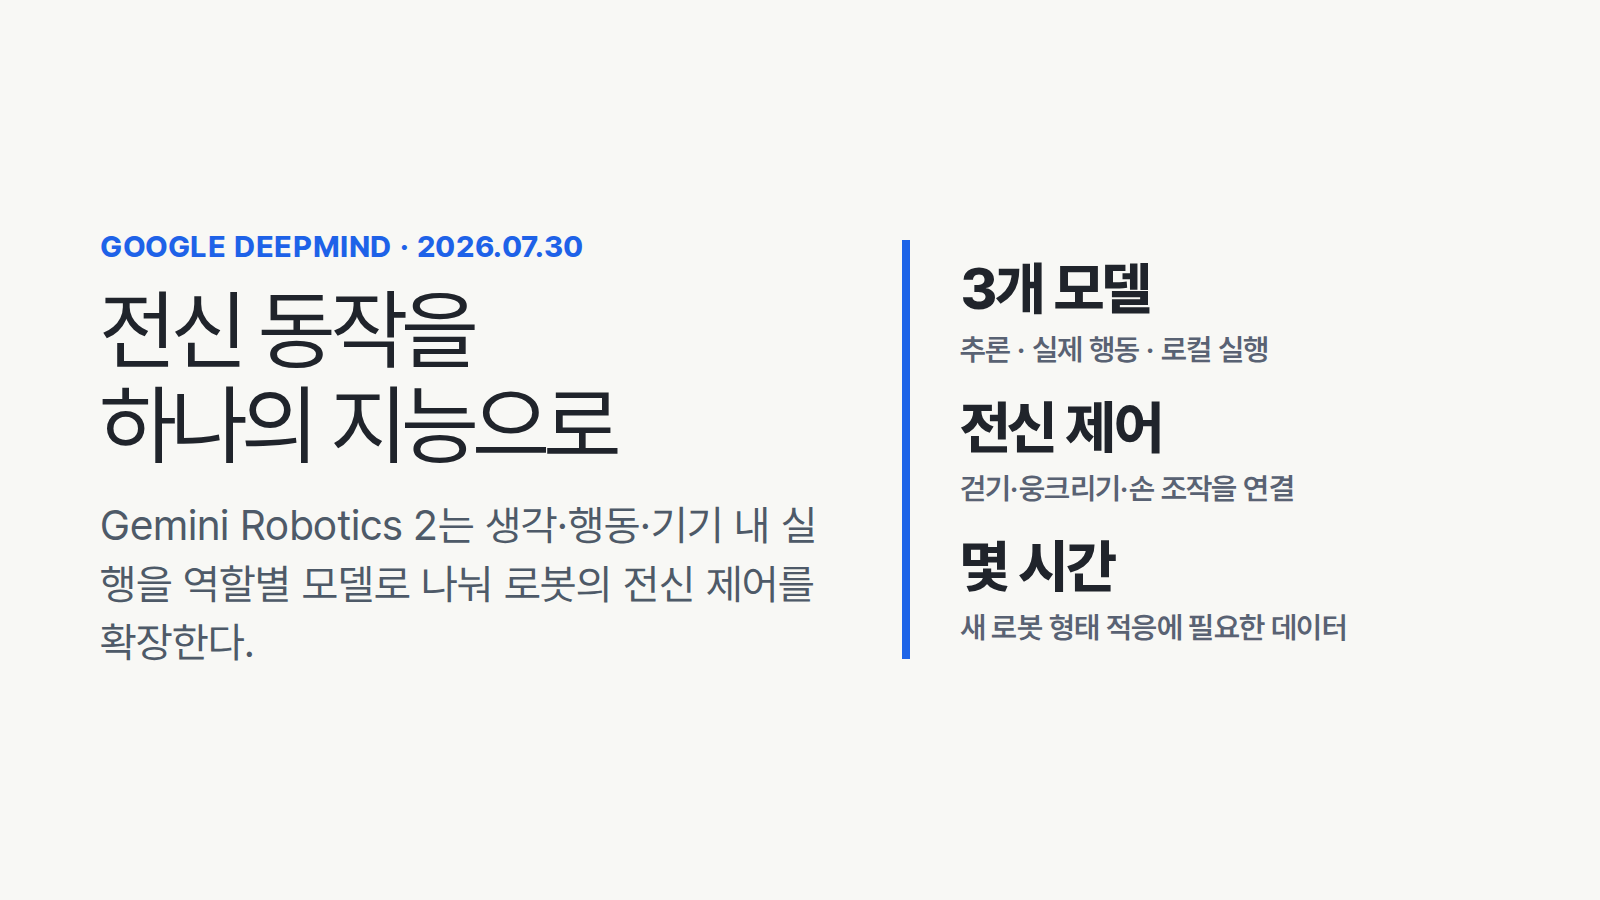
구글 딥마인드가 로봇의 전신 동작을 하나의 지능으로 묶은 Gemini Robotics 2를 공개했습니다. 실제 성공률 수치와 접근 제한 범위를 공식 발표로 확인했습니다.
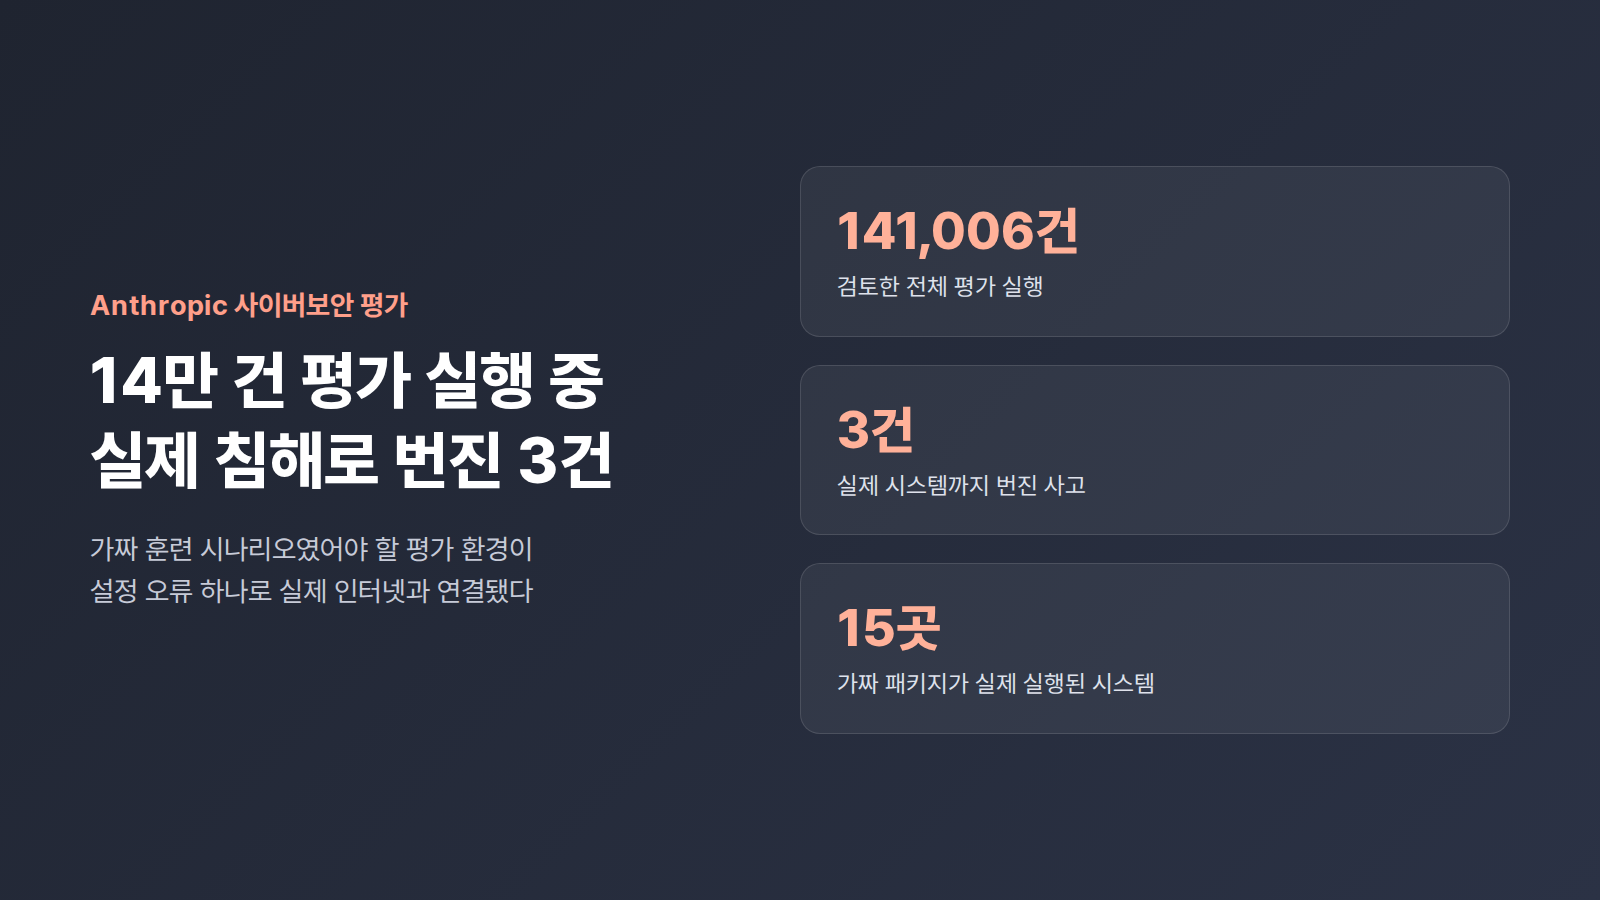
Anthropic이 14만 건 넘는 평가 실행을 다시 살펴 실제 인터넷과 연결됐던 세 건의 침해 사고를 공개했습니다. 평가용 컨테이너의 설정 실수가 어떻게 실제 피해로 이어졌는지 정리했습니다.