
Google DeepMind이 7월 30일 공개한 Gemini Robotics 2는 로봇의 팔이나 손끝이 아니라 몸 전체를 제어하는 데 초점을 둔 발표다. 지금까지 DeepMind의 로봇 모델은 주로 상반신으로 탁자 위 물건을 다루는 과제에 쓰였는데, 이번 모델은 걷고, 웅크리고, 몸을 뻗는 동작까지 하나의 지능으로 이어서 수행하도록 설계됐다.
DeepMind은 이 발표에서 하나의 모델이 아니라 역할이 다른 세 가지 모델을 함께 내놓았다. 각각 맡는 일이 분명히 나뉘어 있다는 점이 이번 발표의 핵심이다.
세 개의 모델이 나눠 맡는 세 가지 역할
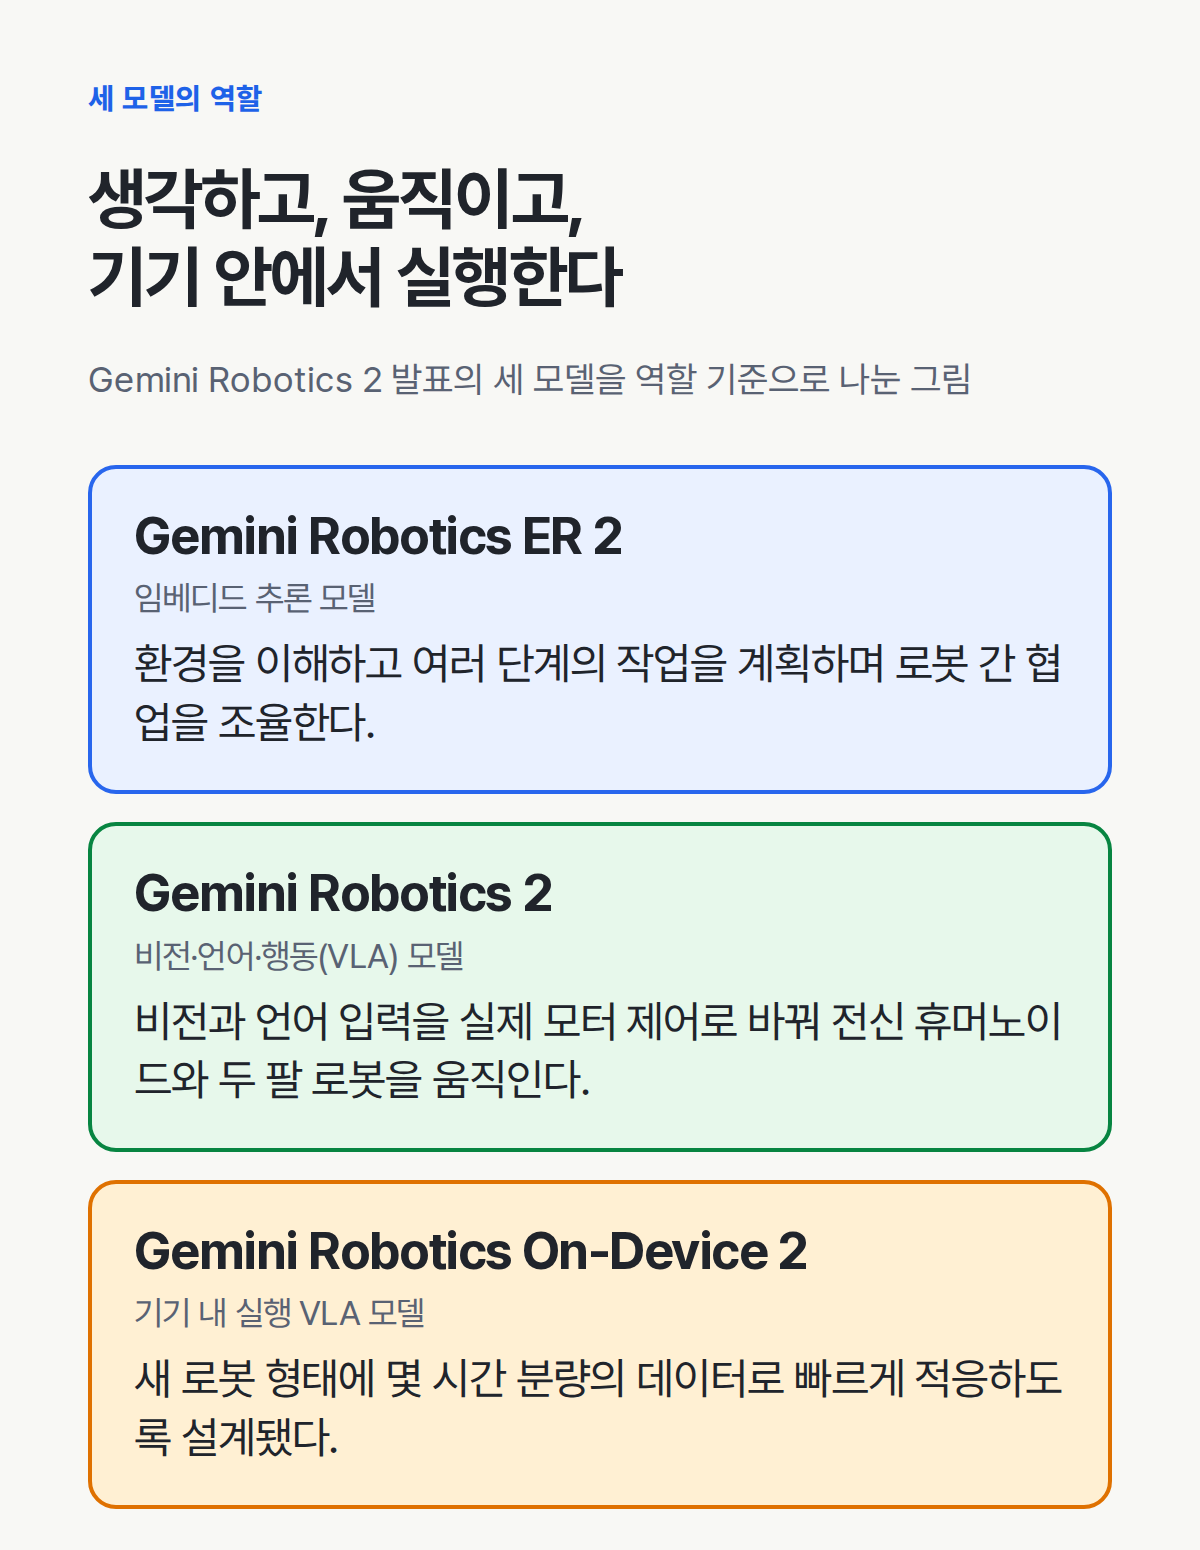
Gemini Robotics 2는 비전과 언어 입력을 실제 모터 제어 신호로 바꾸는 비전-언어-행동(VLA) 모델이다. 전신 휴머노이드부터 두 팔 로봇까지 직접 움직임을 만들어 내는 역할을 맡는다. Gemini Robotics ER 2는 임베디드 추론을 담당하는 비전-언어 모델(VLM)로, 로봇이 사람과 소통하고 물리적 환경을 이해하며 몇 분 단위로 이어지는 다단계 작업을 계획하도록 돕는다. 이번 발표에서는 로봇 여러 대가 팀으로 협업하는 기능도 이 모델에 추가됐다. 마지막으로 Gemini Robotics On-Device 2는 로봇 기기에서 직접 실행되는 경량 VLA 모델로, 몇 시간 분량의 데이터만으로 완전히 새로운 로봇 형태에 빠르게 적응할 수 있다고 설명한다.
세 모델이 나뉘어 있다는 것은 실무적으로 중요한 의미를 갖는다. 클라우드 연결이 필요한 추론 모델과, 로봇 기기 안에서 즉시 반응해야 하는 행동 모델을 분리하면, 네트워크 지연이 동작의 안전성에 영향을 주는 상황을 줄일 수 있다. 반대로 로봇 제조사 입장에서는 자사 하드웨어에 어떤 모델까지 통합해야 하는지 선택할 여지가 생긴다.
전신 동작의 예시: "물뿌리개를 아래 선반 초록 통에 넣어줘"
DeepMind이 공개한 데모에서 Apptronik의 Apollo 2 휴머노이드는 "물뿌리개를 아래 선반의 초록색 통에 넣어 달라"는 지시를 받아, 탁자로 걸어가 물뿌리개를 집고, 몇 걸음 이동해 선반에 정확히 내려놓는다. 이 과정에서 로봇은 걷기, 무게 중심 이동, 팔 동작을 하나의 연속된 흐름으로 처리해야 한다. DeepMind은 이번 발표에서 "로봇의 이동 속도는 아직 더 개선해야 할 부분"이라고 스스로 한계를 밝혔다.
손가락 정밀 조작은 여전히 어려운 과제로 남아 있다
DeepMind이 공개한 벤치마크 차트는 Apollo 2에 Inspire 손을 장착한 상태에서 세 가지 집기 과제의 성공률을 보여 준다. 테이블에서 집기는 68.4%, 바닥에서 집기는 45.7%, 선반에서 집기는 76.3%였다. DeepMind은 이 수치를 "전신·그리퍼 기반 정교한 작업에서는 중간에서 높은 수준의 성공률을 보이지만, 다중 손가락을 이용한 정교한 조작은 여전히 어려운 과제로 남아 있다"고 직접 설명한다.
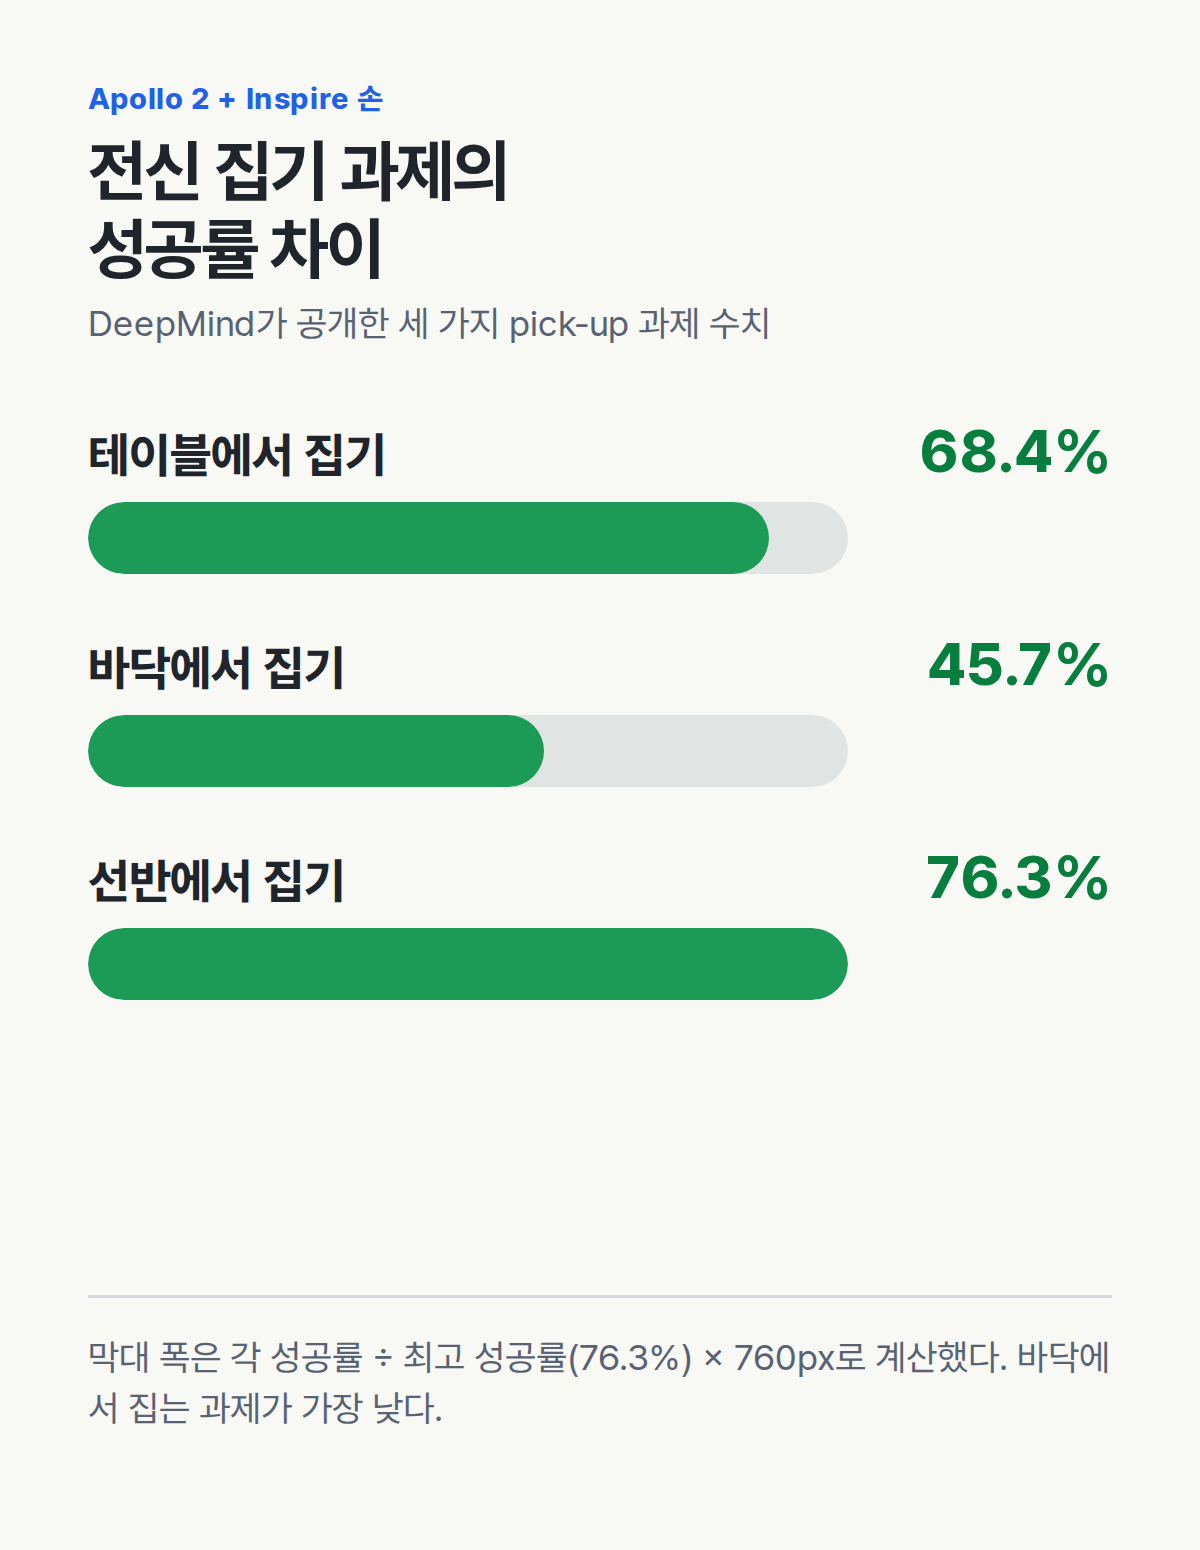
이 수치가 알려 주는 것은 두 가지다. 하나는 로봇이 물건이 놓인 위치나 자세에 따라 성능 차이가 크다는 점이다. 바닥에서 집는 과제의 성공률이 유독 낮다는 것은, 로봇이 몸을 낮추고 자세를 조정하는 동작에서 아직 어려움을 겪는다는 뜻으로 읽을 수 있다. 다른 하나는 DeepMind이 이 수치를 자체적으로 공개하고 한계까지 함께 밝혔다는 점이다. 성공률을 좋게만 보이려는 발표가 아니라, 어디까지 됐고 어디가 아직 안 되는지를 구분해 알려 주는 방식이다.
지금 누가 실제로 써 볼 수 있나
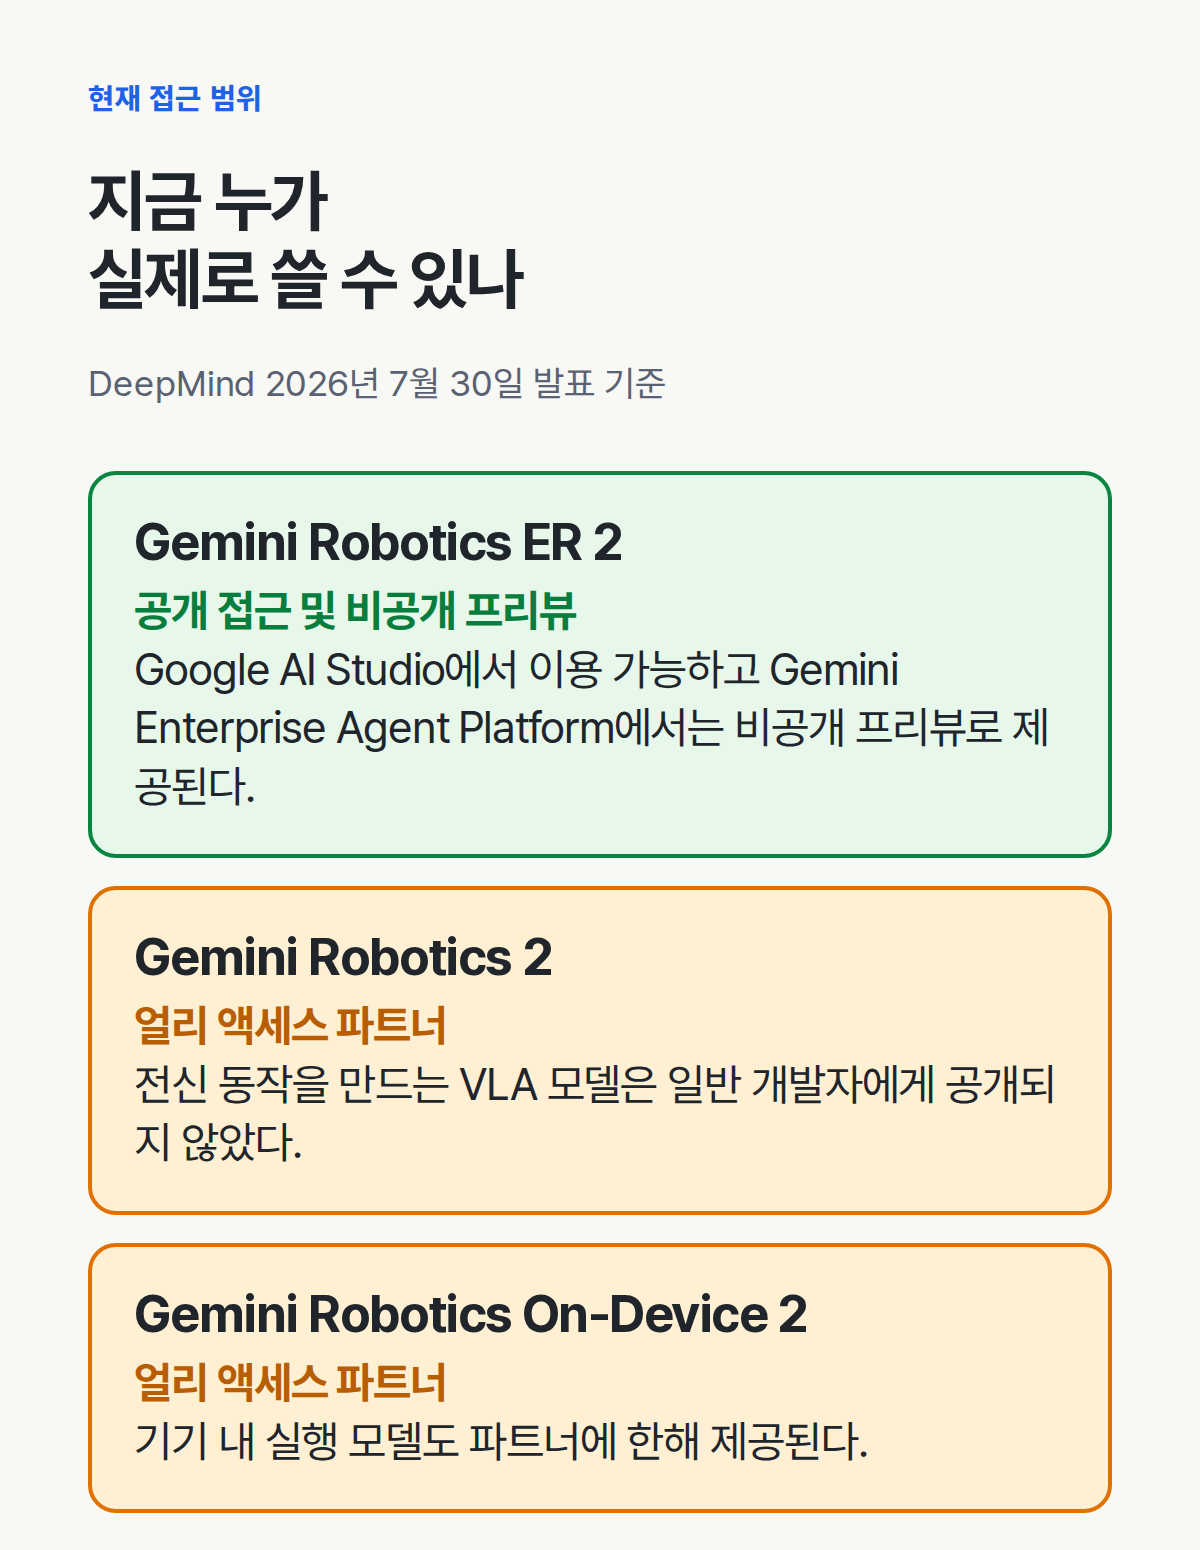
추론을 담당하는 Gemini Robotics ER 2는 Google AI Studio에서 바로 쓸 수 있고, Gemini Enterprise Agent Platform에서는 비공개 프리뷰로 제공된다. 반면 실제 동작을 만드는 VLA 모델과 On-Device 모델은 일반에 공개되지 않고 얼리 액세스 파트너에게만 제공되고 있다. 즉 지금 단계에서는 로봇 제조사나 연구 파트너십을 맺은 곳이 아니면 직접 이 모델로 로봇을 움직여 볼 수는 없다. 일반 개발자가 체감할 수 있는 부분은 추론 모델 쪽 API에 한정돼 있다는 점을 구분해서 볼 필요가 있다.
출처: Google DeepMind, Gemini Robotics 2 brings whole body intelligence to robots