
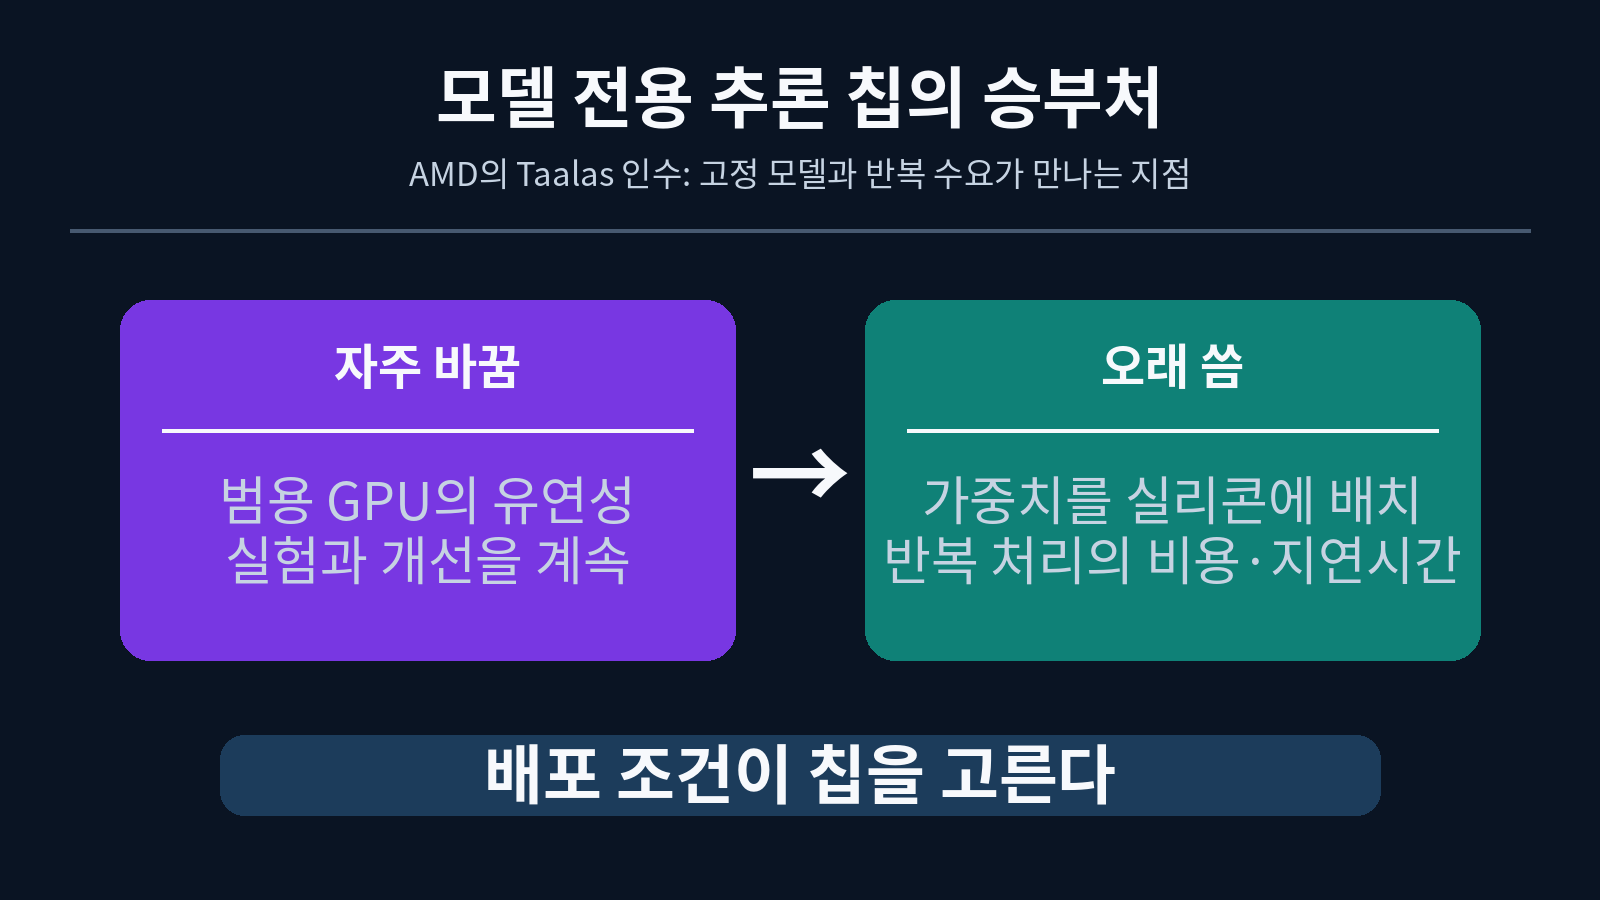
AMD가 8월 6일 AI 추론 칩 스타트업 Taalas 인수를 발표했다. Taalas는 모델 가중치를 외부 고대역폭메모리(HBM)에서 읽어 오는 대신 칩의 마스크 ROM 영역에 새기는 방식을 택한다. 범용 GPU의 유연성을 줄여 모델 하나의 토큰 생성 경로를 짧게 만드는 설계다.
이 인수의 핵심은 GPU를 대체할 새 가속기 하나가 아니다. 모델이 충분히 안정된 뒤에는 같은 서비스의 추론 비용·지연시간·전력이라는 병목이 더 중요해진다. 학습용 모델을 고르는 경쟁과, 정해진 모델로 요청을 오래 처리하는 경쟁은 필요한 하드웨어가 다르다. AMD는 이 구간에 모델 전용 실리콘을 붙여, 범용 Instinct GPU가 맡는 작업과 서로 다른 역할을 만들려 한다.
가중치를 실리콘에 넣으면 무엇이 달라지나
일반적인 가속기는 모델 가중치를 메모리에 두고 계산 장치로 옮긴다. Taalas의 HC 계열은 가중치를 mask-ROM recall fabric에 넣고, KV 캐시와 미세조정 어댑터는 SRAM recall fabric에 둔다. 무거운 가중치 이동을 줄이고 저장과 곱셈을 가깝게 묶는 것이 구조의 출발점이다.
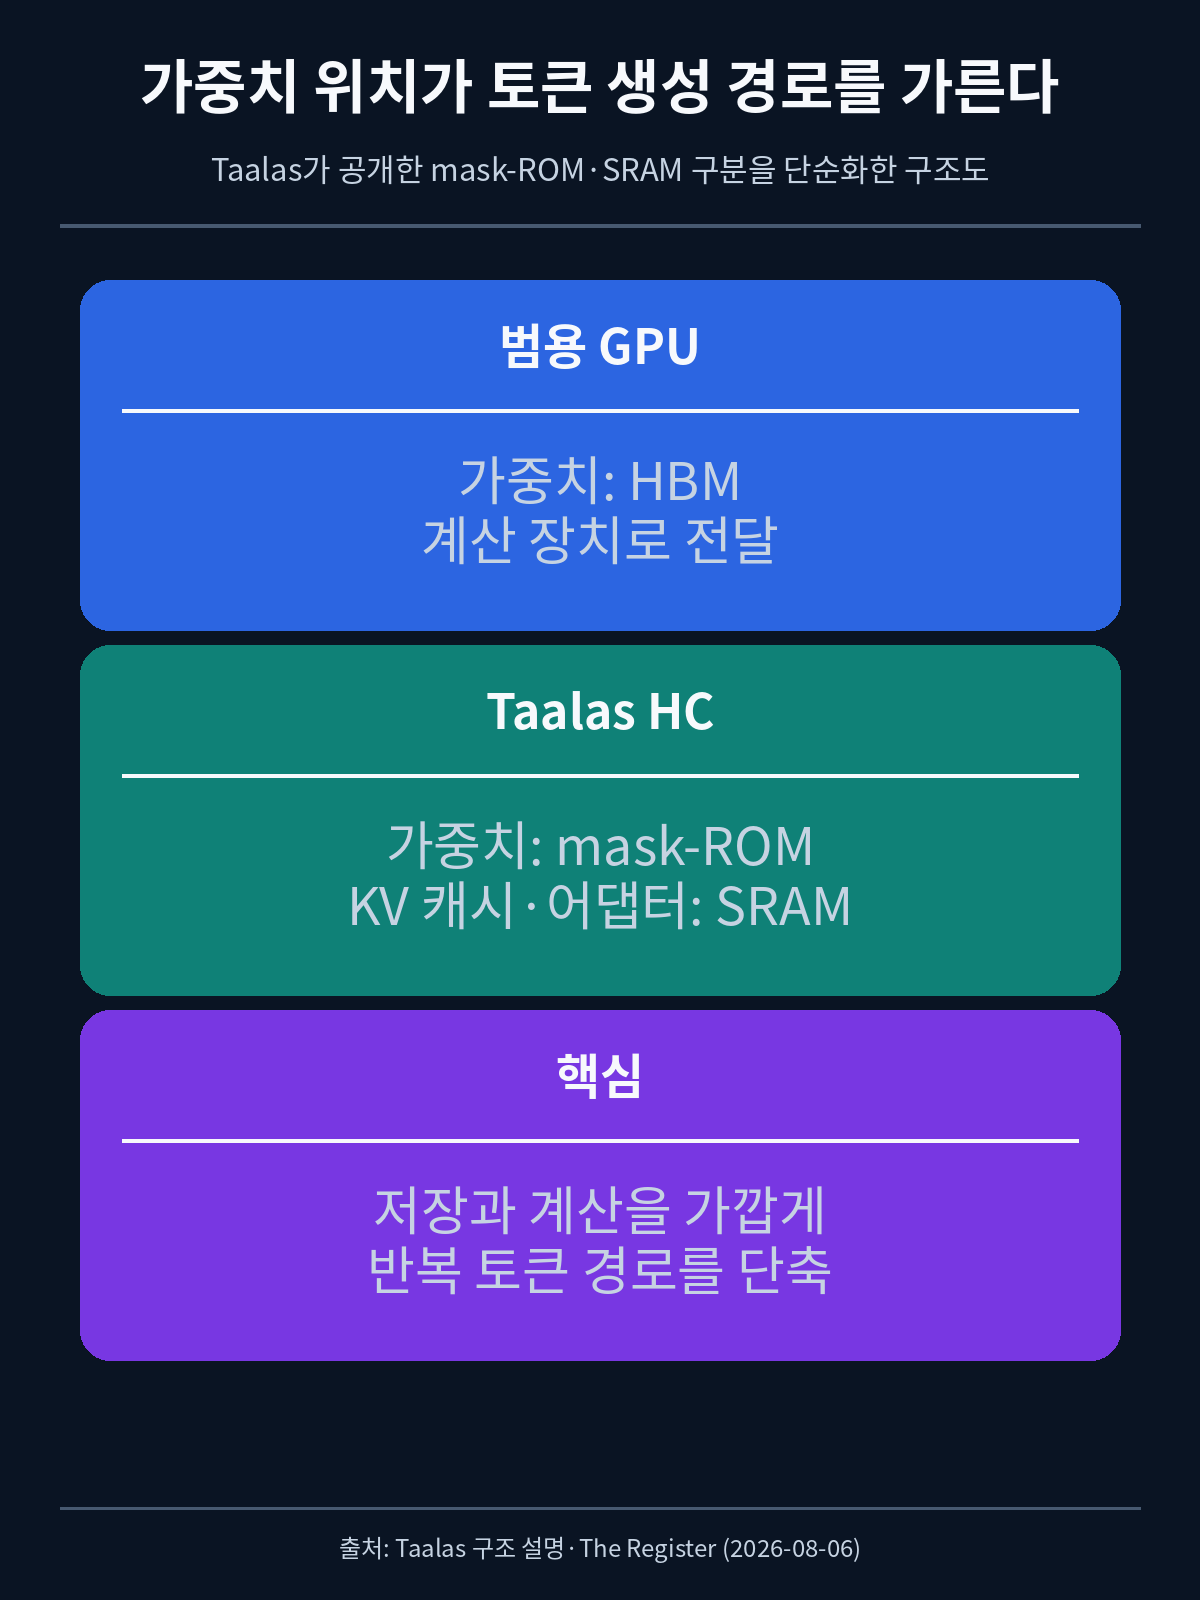
회사가 발표한 HC1 초기 측정에서는 TSMC 6nm 공정 칩이 Llama 3.1 8B를 초당 16,960토큰으로 제공했다. 이 숫자는 모델, 배치, 입출력 길이와 비교 대상이 고정돼야 구매 지표가 된다. 그래도 토큰을 하나씩 이어 붙이는 생성 구간에서 메모리 왕복을 줄이는 설계가 왜 강력한지는 보여 준다.
승부처는 최고 속도보다 모델의 안정성이다
모델 전용 칩은 배포 뒤 모델 자체가 바뀌면 다시 설계해야 한다. Taalas는 새 모델에 맞출 때 칩 전체를 처음부터 다시 만드는 대신 금속층 두 개만 바꾸는 방식이라고 설명한다. 그럼에도 월 단위로 모델을 바꾸며 품질과 기능을 시험하는 서비스에는 범용 GPU가 더 자연스럽다.
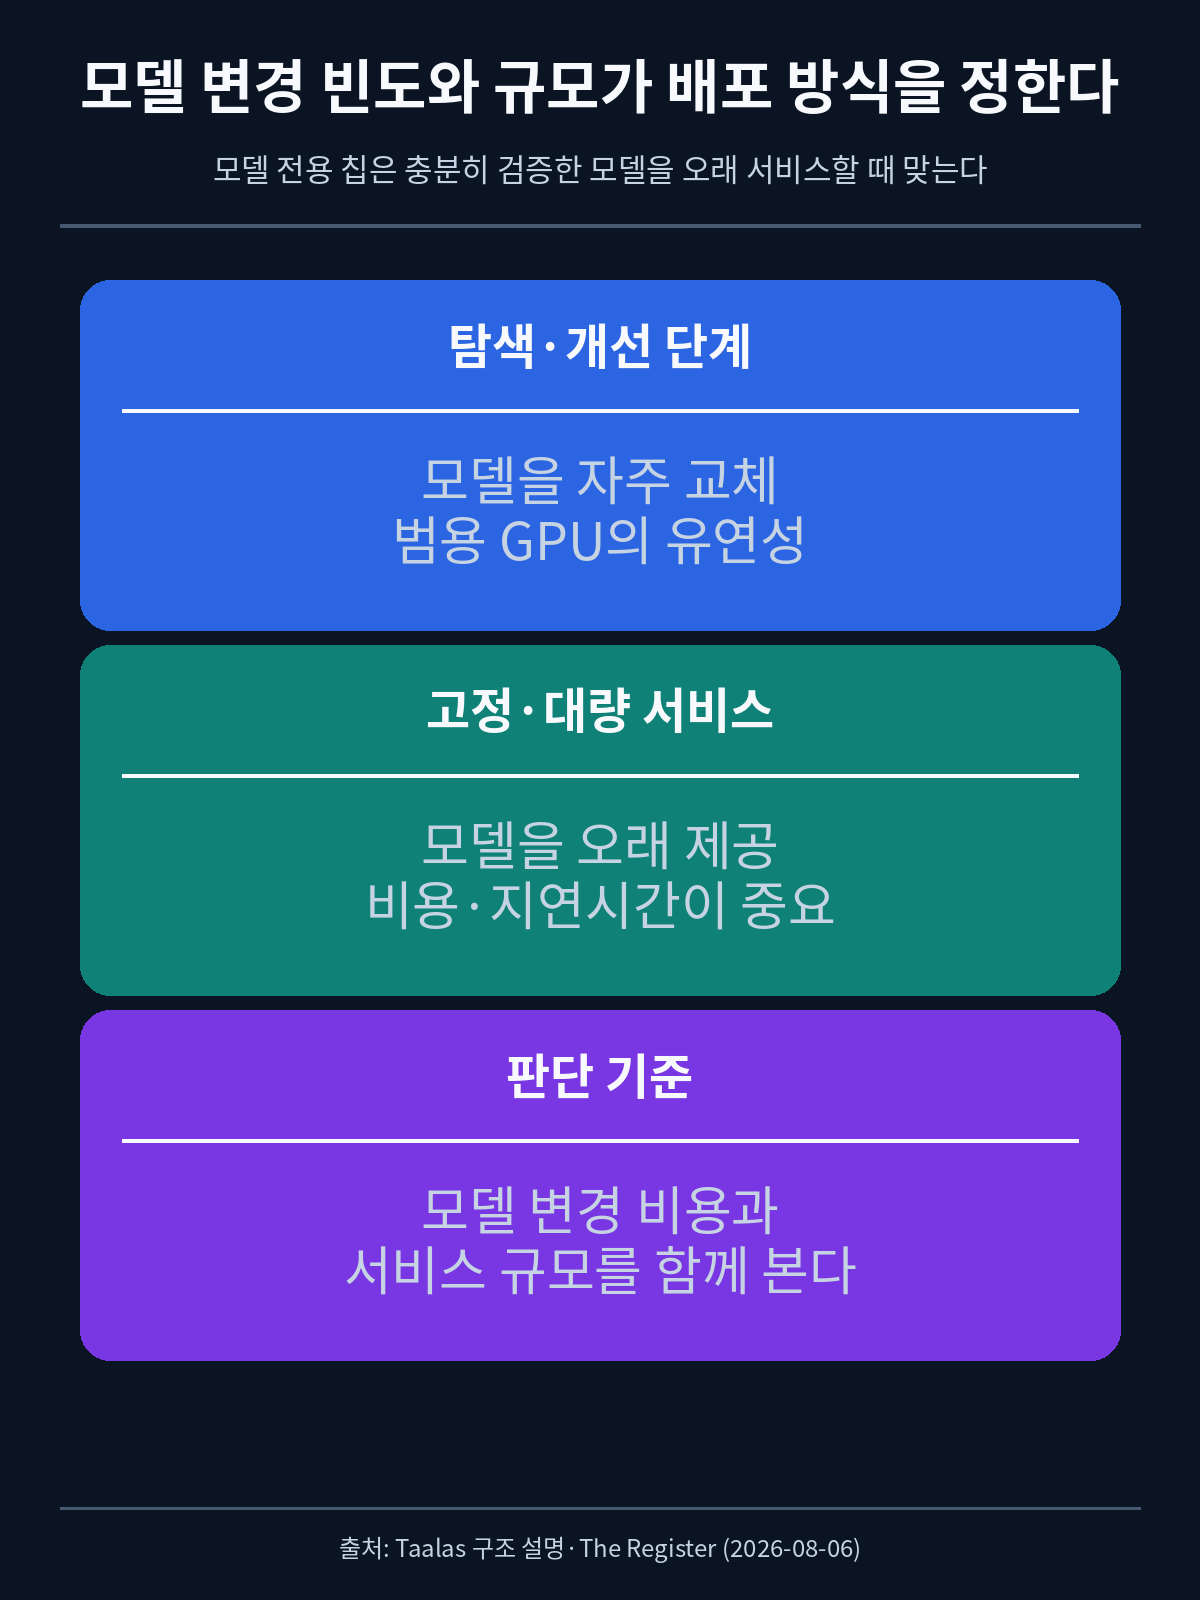
따라서 타깃은 모든 챗봇이 아니다. 충분히 검증한 모델을 큰 요청량으로 오래 제공하는 모델 사업자, 인프라 사업자, 추론 사업자가 먼저 맞는다. 모델을 계속 교체하는 동안에는 재설계 비용과 공급 리드타임이 절감한 토큰 비용을 상쇄할 수 있다.
AMD가 GPU와 전용칩을 함께 묶으려는 이유
The Register는 AMD가 Instinct 기반 Helios 랙과 Taalas 기술 기반 칩을 결합하는 구성을 염두에 둔다고 전했다. 이 구도에서는 긴 입력을 읽고 병렬 계산이 많은 프리필은 GPU가, 응답 토큰을 반복 생성하는 디코드는 전용칩이 맡을 수 있다. 아직 거래는 규제 승인을 전제로 4분기 종결이 예상되는 단계이므로, 실제 제품의 분할 방식과 일정은 AMD의 후속 발표가 정할 부분이다.
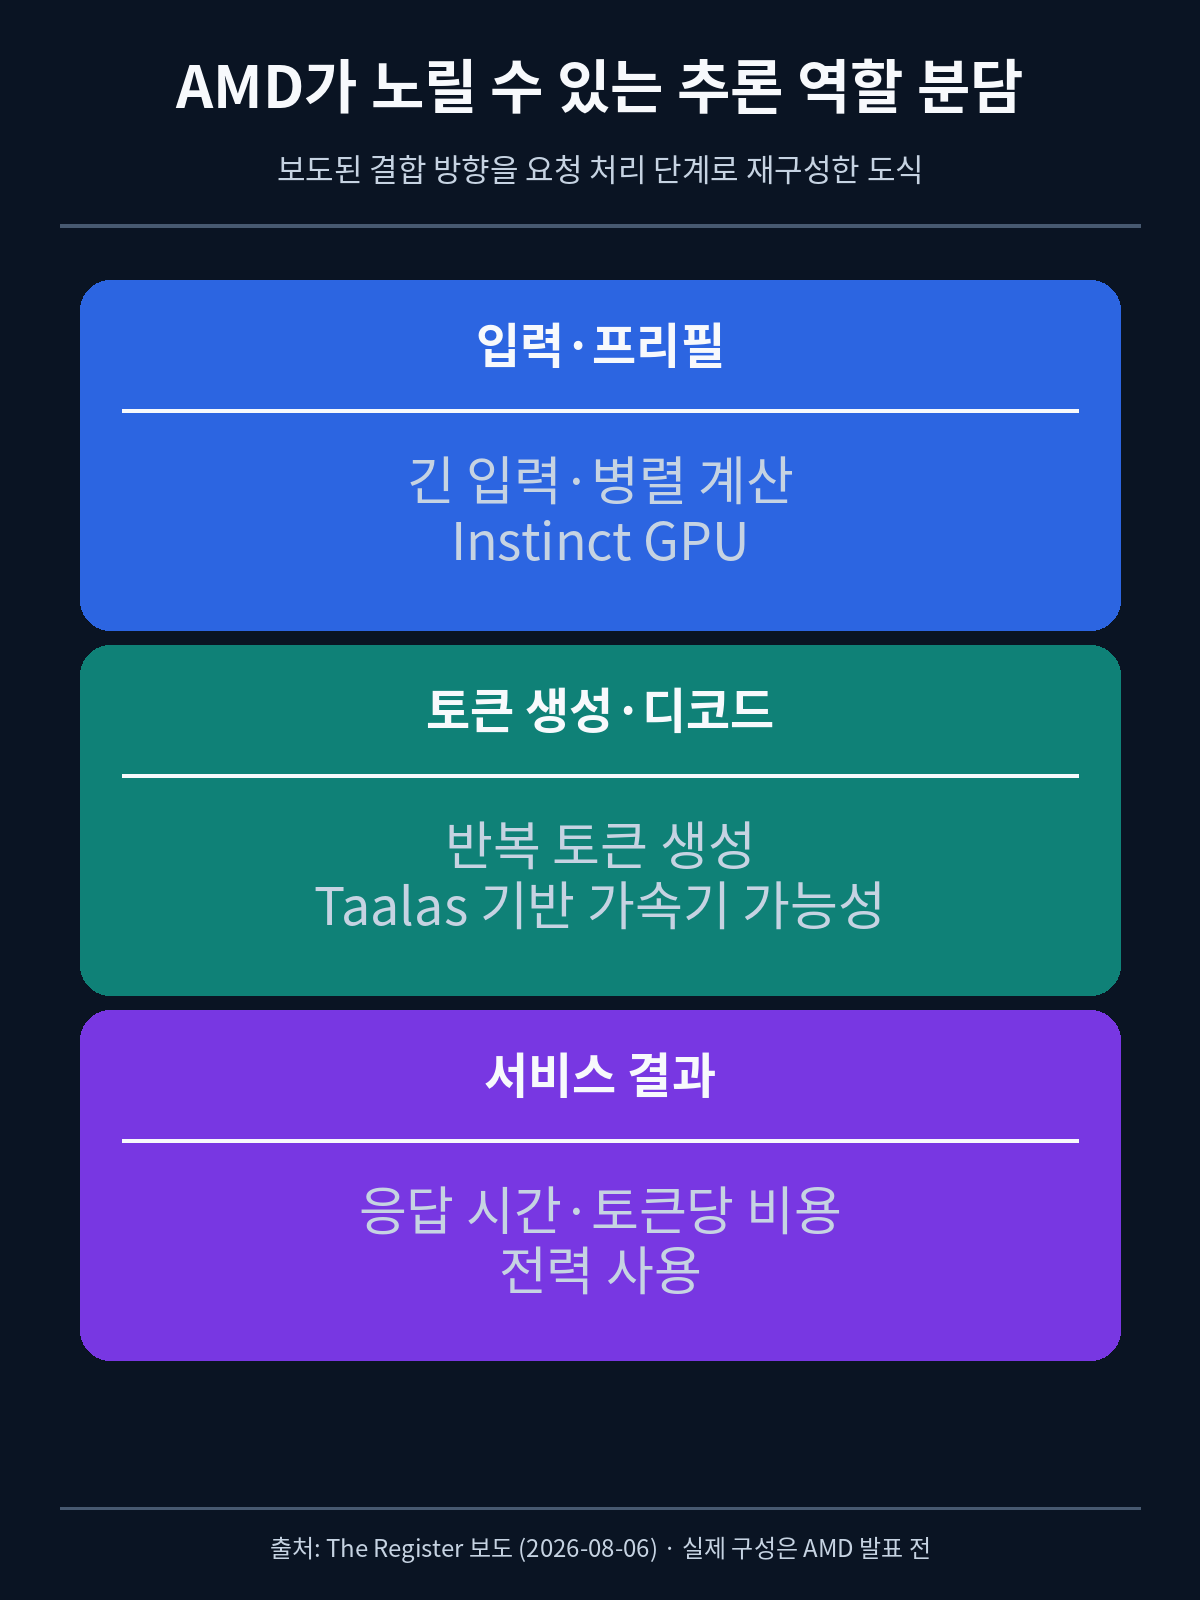
이 역할 분담은 추론을 더 오래 돌려 답의 품질을 높이려는 테스트타임 스케일링에도 맞닿는다. 생각하는 토큰이 늘수록 비용과 응답 대기는 커진다. 안정된 모델을 전용칩으로 옮겨 출력 토큰당 비용과 속도를 낮출 수 있다면, 경쟁은 모델의 최고 성능만이 아니라 어느 모델을 얼마나 오래 고정해 서비스할 수 있는지로 이동한다.
출처: The Register, “AMD acquires AI chip startup Taalas to boost inference performance by etching models into silicon” (2026-08-06)