
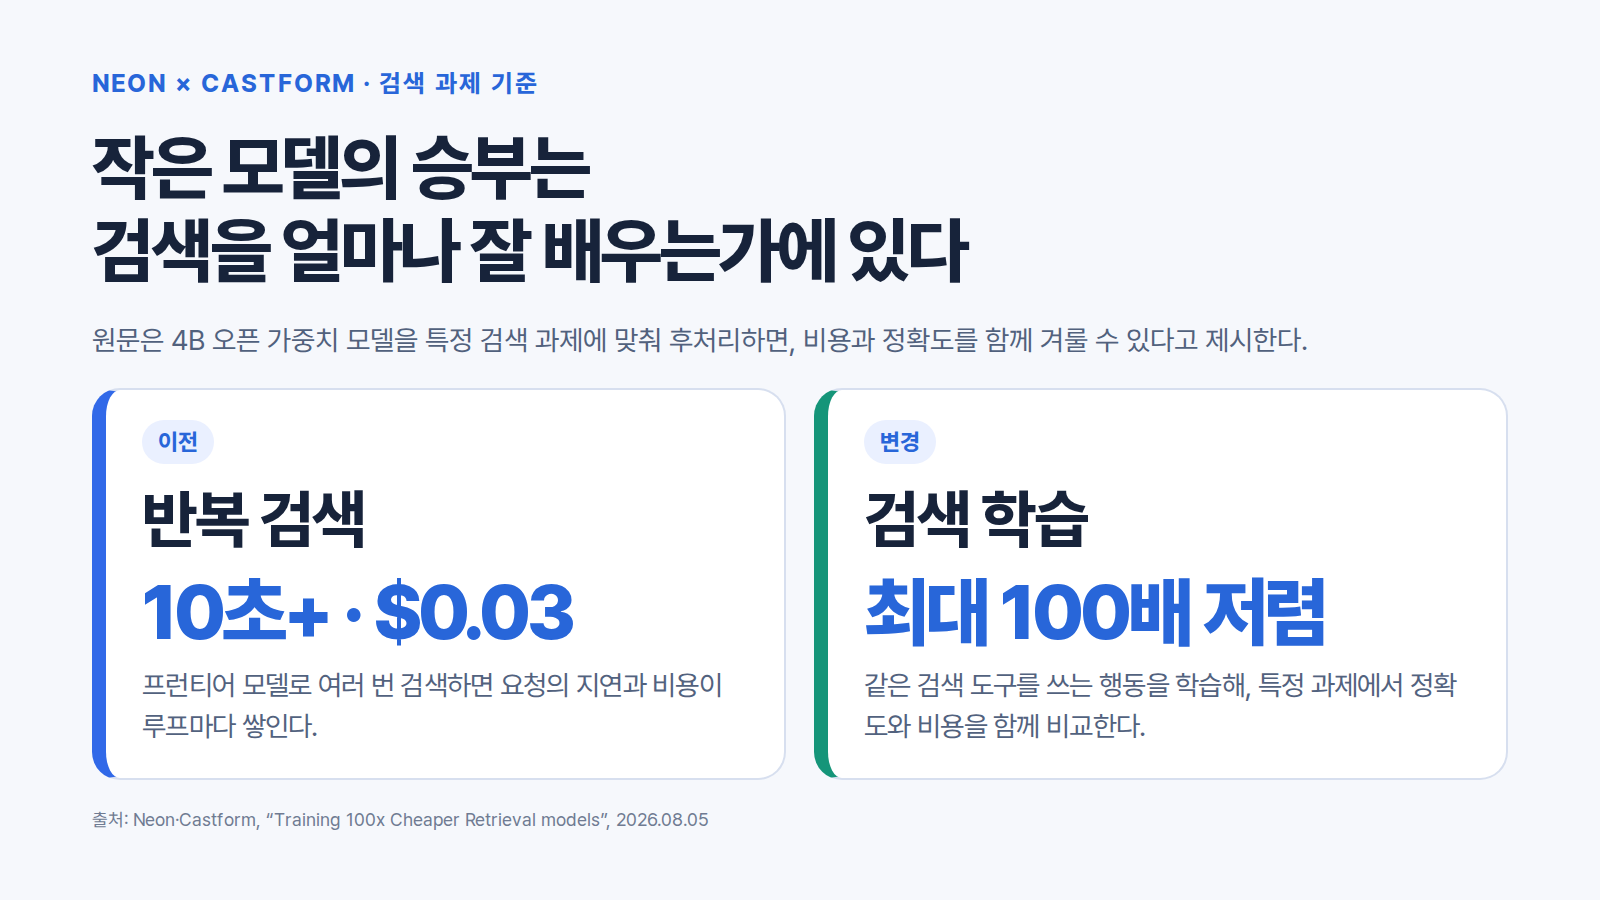
Neon과 Castform은 2026년 8월 5일, Postgres에 있는 기업 코퍼스를 검색 도구로 연결해 4B 오픈 가중치 모델을 강화학습 후처리하는 방식을 공개했다. 이들이 내세우는 결과는 특정 검색 과제에서 작은 모델이 프런티어 모델 수준의 정확도로 경쟁하면서 추론 비용을 100분의 1까지 낮출 수 있다는 것이다. 여기서 핵심은 값싼 모델 자체가 아니라, 모델이 자기 지식만으로 답하게 하지 않고 필요한 근거를 찾아오는 행동을 학습시키는 설계다.
에이전트형 검색은 질문 하나에 검색을 여러 차례 실행한다. 원문은 gpt-5.6-sol로 다회 검색을 수행하면 요청 하나가 10초를 넘기고 약 0.03달러가 든다고 적는다. 작은 오픈 가중치 모델은 원래 훨씬 싸지만, 범용 상태에서는 폐쇄형 API 모델보다 검색 판단력이 약하다. 따라서 “100배 저렴하다”는 비용표의 결론이 아니라, 그 격차를 검색 도구 사용 훈련으로 메울 수 있느냐가 경쟁의 출발점이 된다.
왜 검색을 여러 번 하는 모델에서 비용 차이가 커지는가
기존 RAG는 보통 질문을 임베딩으로 바꿔 가까운 문서를 한 번 꺼내고 답을 생성한다. 에이전트형 검색은 큰 질문을 더 작은 질문으로 나누고, 중간 검색 결과를 읽은 뒤 다음 검색어를 다시 고른다. 한 번의 모델 호출 비용 차이는 작아 보여도 이 루프가 반복되면 요청당 지연과 비용에 그대로 누적된다. 작은 모델을 쓰려는 이유는 이 반복을 감당할 수 있게 만들기 위해서다.
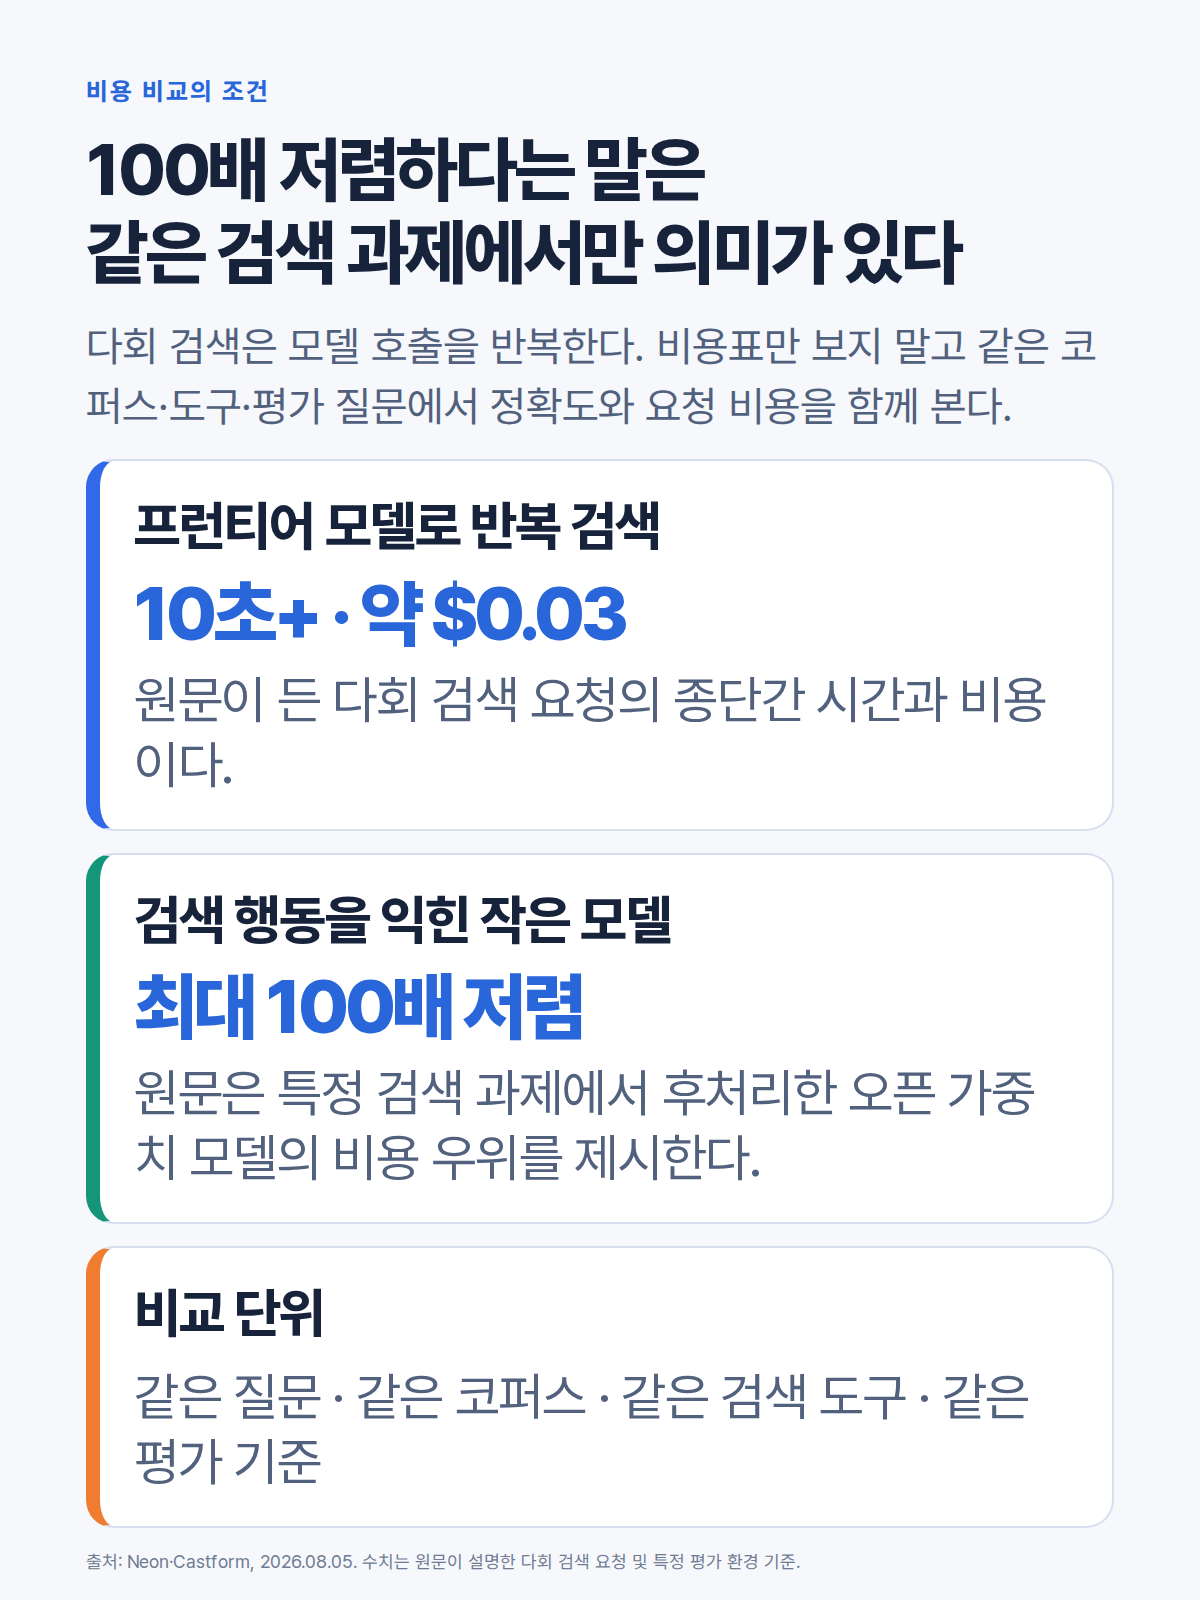
하지만 검색은 언어 생성보다 실패 양상이 많다. 검색어가 너무 넓으면 문서 조각이 넘치고, 너무 좁으면 답의 근거가 빠진다. 첫 결과가 부족할 때 다시 검색할지, 어느 문장을 인용할지, 언제 답변을 끝낼지까지가 모델의 정책이 된다. 작은 모델이 경쟁하려면 이 정책을 범용 추론 능력의 대체재로 만들기보다, 한 코퍼스와 하나의 도구 환경에 맞춘 반복 작업으로 좁혀야 한다.
학습 데이터는 문서 묶음이 아니라 과제·도구·보상으로 바뀐다
원문이 설명한 강화학습 후처리에는 세 요소가 필요하다. 첫째는 답해야 할 과제, 둘째는 에이전트가 실행할 검색 도구 환경, 셋째는 시도를 채점할 보상 함수다. 기업에는 내부 문서, 제품 기록, 지원 문서, 고객 상호작용, 위키, 운영 데이터가 이미 있다. Castform의 접근은 이 코퍼스에서 질문과 정답을 합성하고, 모델이 검색을 실행한 흔적을 보상으로 되돌리는 데 있다.
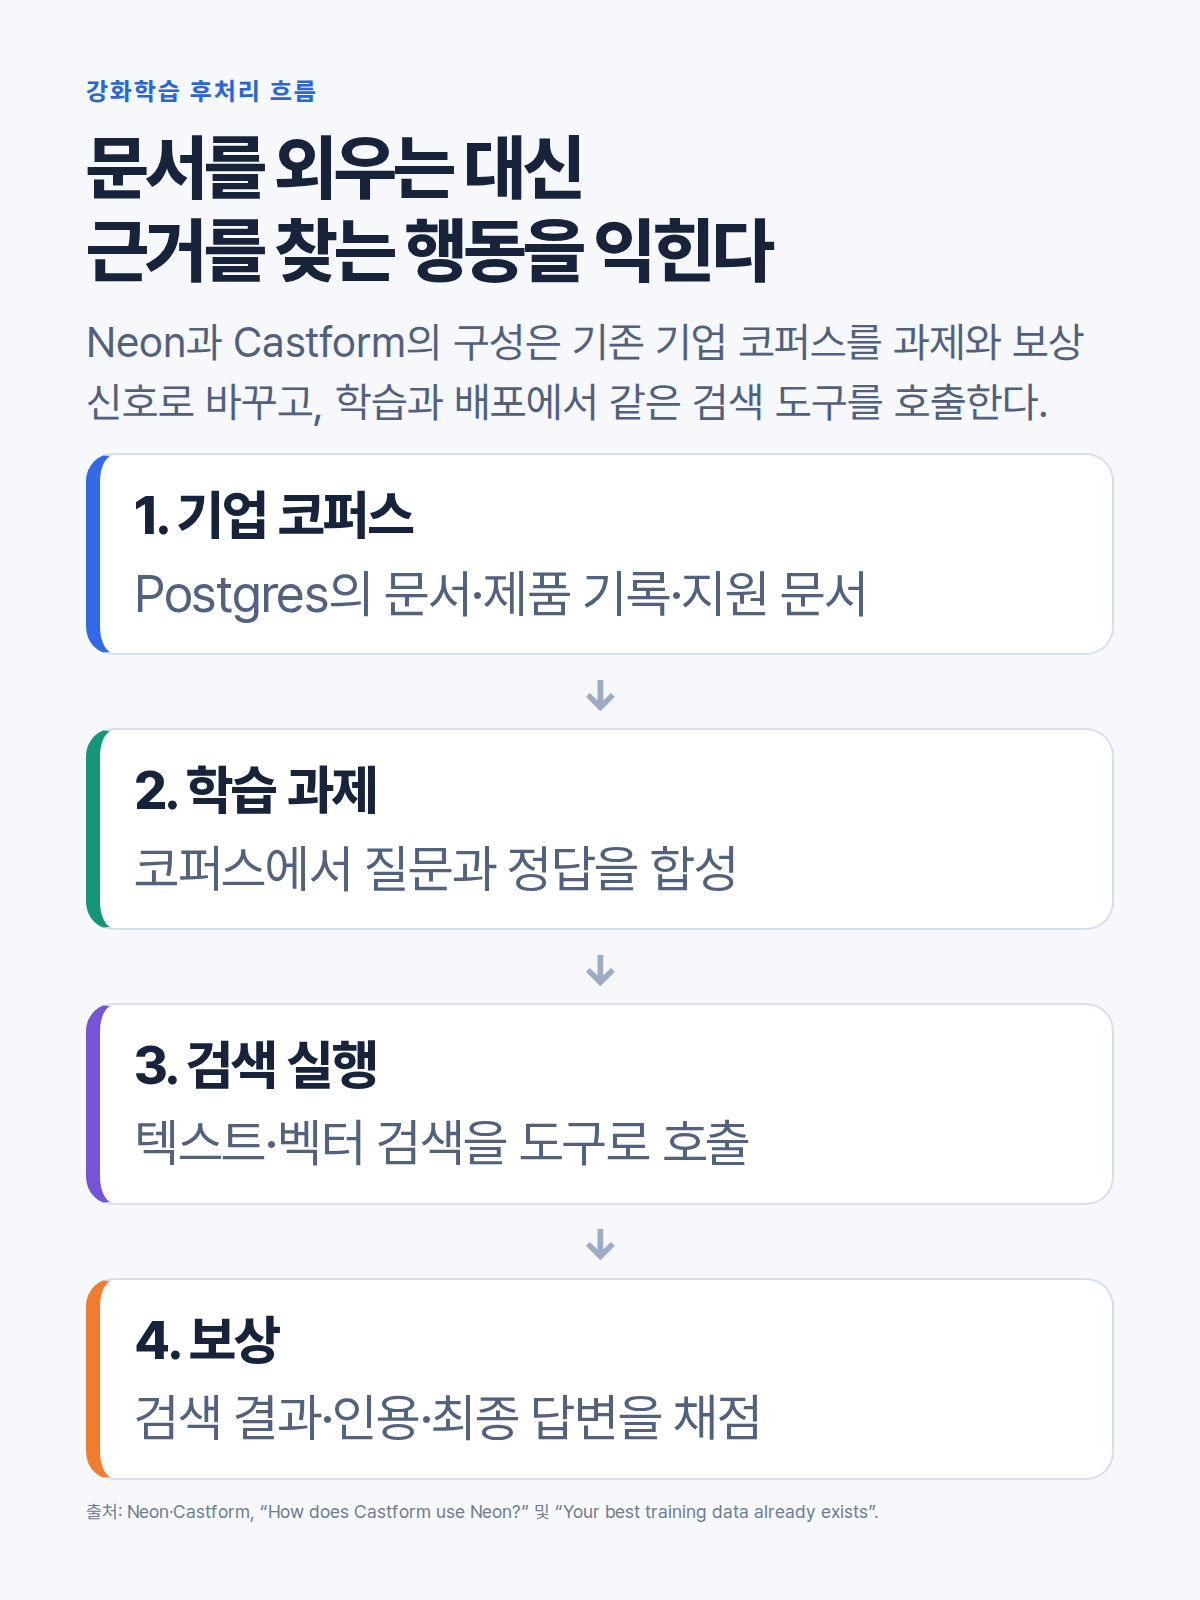
예시 코드에서 검색 도구는 Lakebase의 텍스트 검색과 벡터 검색 결과를 결합한다. 보상 함수는 최종 답이 맞는지만 보지 않고, 올바른 소스를 검색했는지와 올바른 청크를 인용했는지도 함께 더한다. 이 분해가 중요한 이유는 우연히 맞힌 답과 재현 가능한 검색 행동을 구분하기 때문이다. 배포에서도 같은 검색 도구를 호출한다면, 모델은 문서 내용을 파라미터에 압축하는 대신 필요한 순간에 근거를 찾아오는 경로를 익힌다.
작은 모델의 강점은 범용성 대신 검색 경로를 고정하는 데서 나온다
이 방식이 맞는 곳은 질문 종류와 코퍼스가 비교적 분명한 제품 지원, 내부 정책 조회, 운영 문서 탐색처럼 검색 경로를 측정할 수 있는 업무다. 학습 질문이 실제 요청을 대표하지 못하거나, 배포 시 인덱스·권한·결과 형식이 달라지면 학습에서 얻은 보상은 운영 품질로 이어지기 어렵다. 원문의 수치도 Castform과 Neon이 구성한 특정 평가 환경의 결과이므로, 도입팀은 자사 질문 집합에서 별도로 정확도·인용 정확도·재검색 횟수·요청당 비용을 나란히 측정해야 한다.
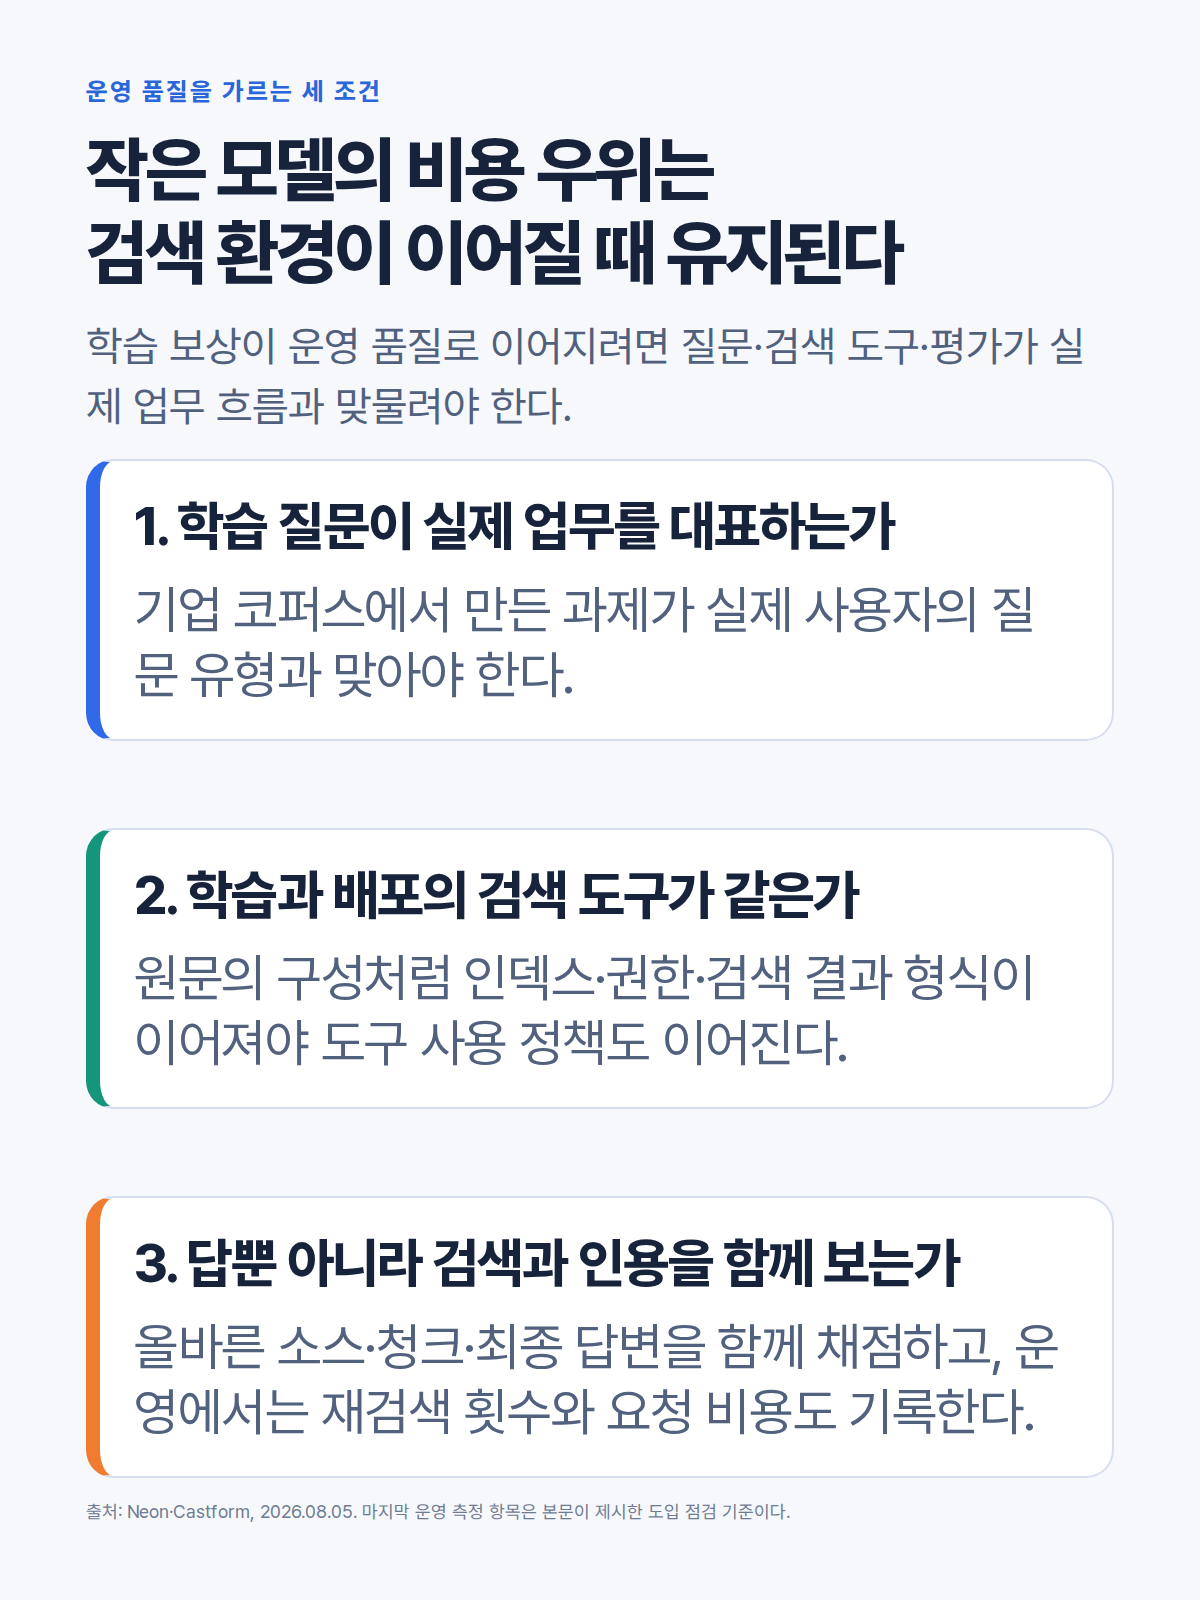
운영에서 먼저 확인할 것은 모델 크기가 아니다. 실제 질문을 유형별로 나누고, 각 질문에서 정답 문서가 검색됐는지, 인용이 맞는지, 몇 번의 도구 호출 뒤에 답을 냈는지 기록해야 한다. 그다음 프런티어 모델과 후처리한 오픈 모델을 동일한 코퍼스·권한·검색 설정에서 비교하면, 비용 절감이 정확도 손실을 숨긴 결과인지 아니면 특정 검색 과제에 맞춘 설계의 성과인지 구분할 수 있다. 검색에서 경쟁하는 작은 모델의 설계는 결국 더 싼 생성기가 아니라, 측정 가능한 검색 행동을 만드는 일이다.