
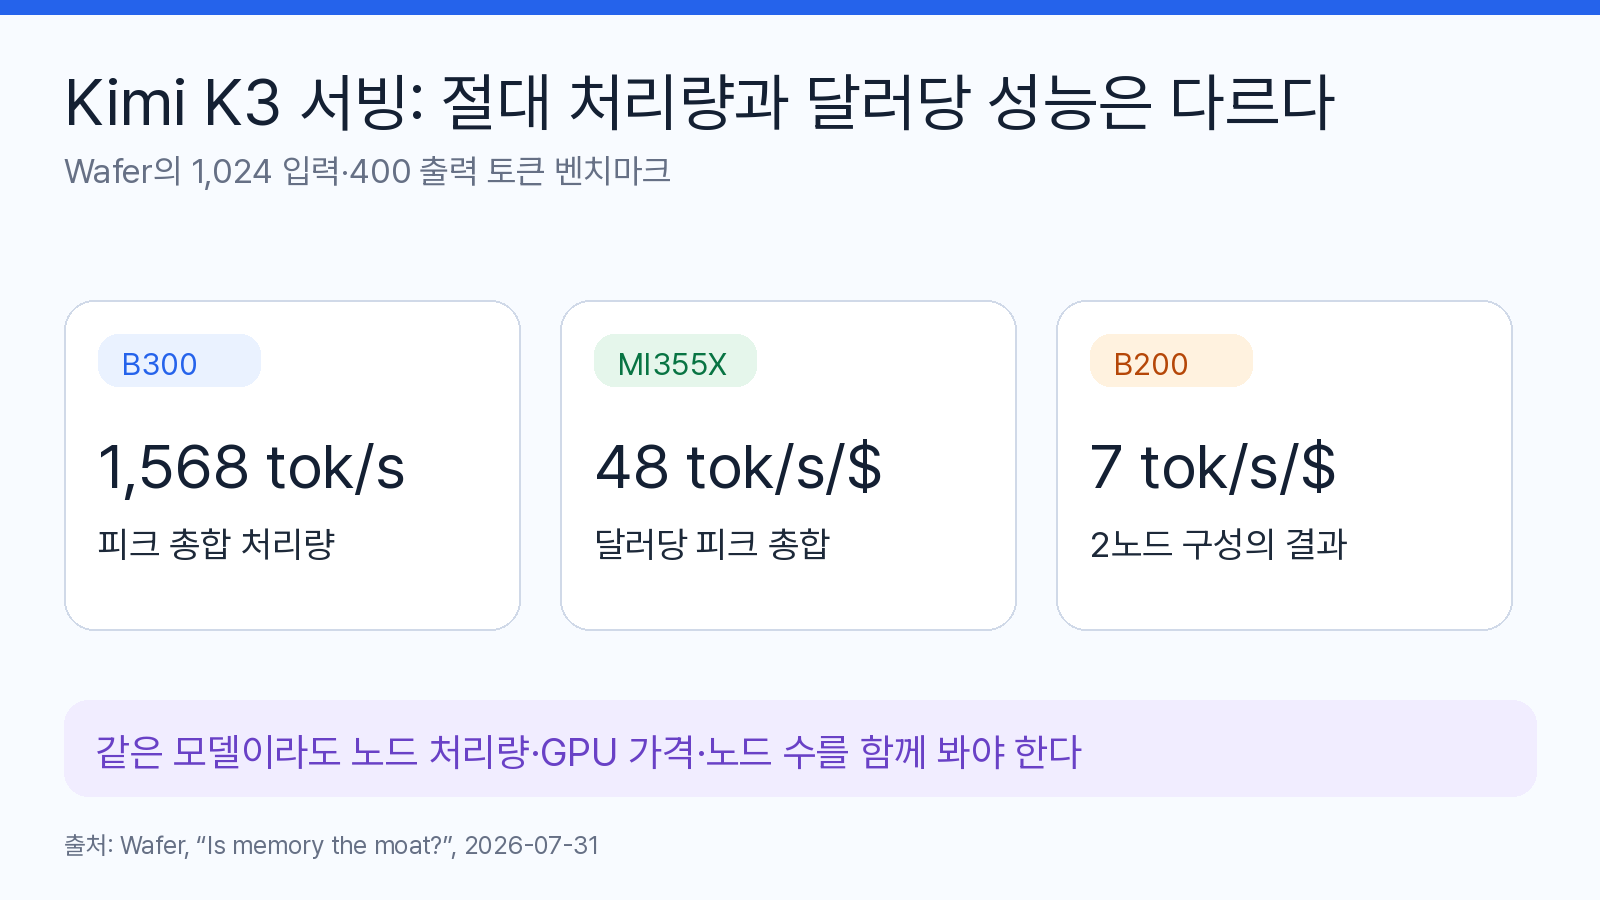
AI 인프라 스타트업 Wafer가 7월 31일 자사 블로그에서 밝힌 내용은 중국 Moonshot AI의 대형 오픈소스 모델 Kimi K3를 AMD MI355X GPU에 서빙한 결과다. 1,024토큰 입력·400토큰 출력 기준 벤치마크에서 MI355X 8장(TP8) 노드는 초당 952토큰(피크 총합)을 냈고, 이를 시간당 GPU 가격으로 나누면 tok/s당 1달러 기준으로 Nvidia B300보다 앞서는 성능 대비 가격이 나왔다.
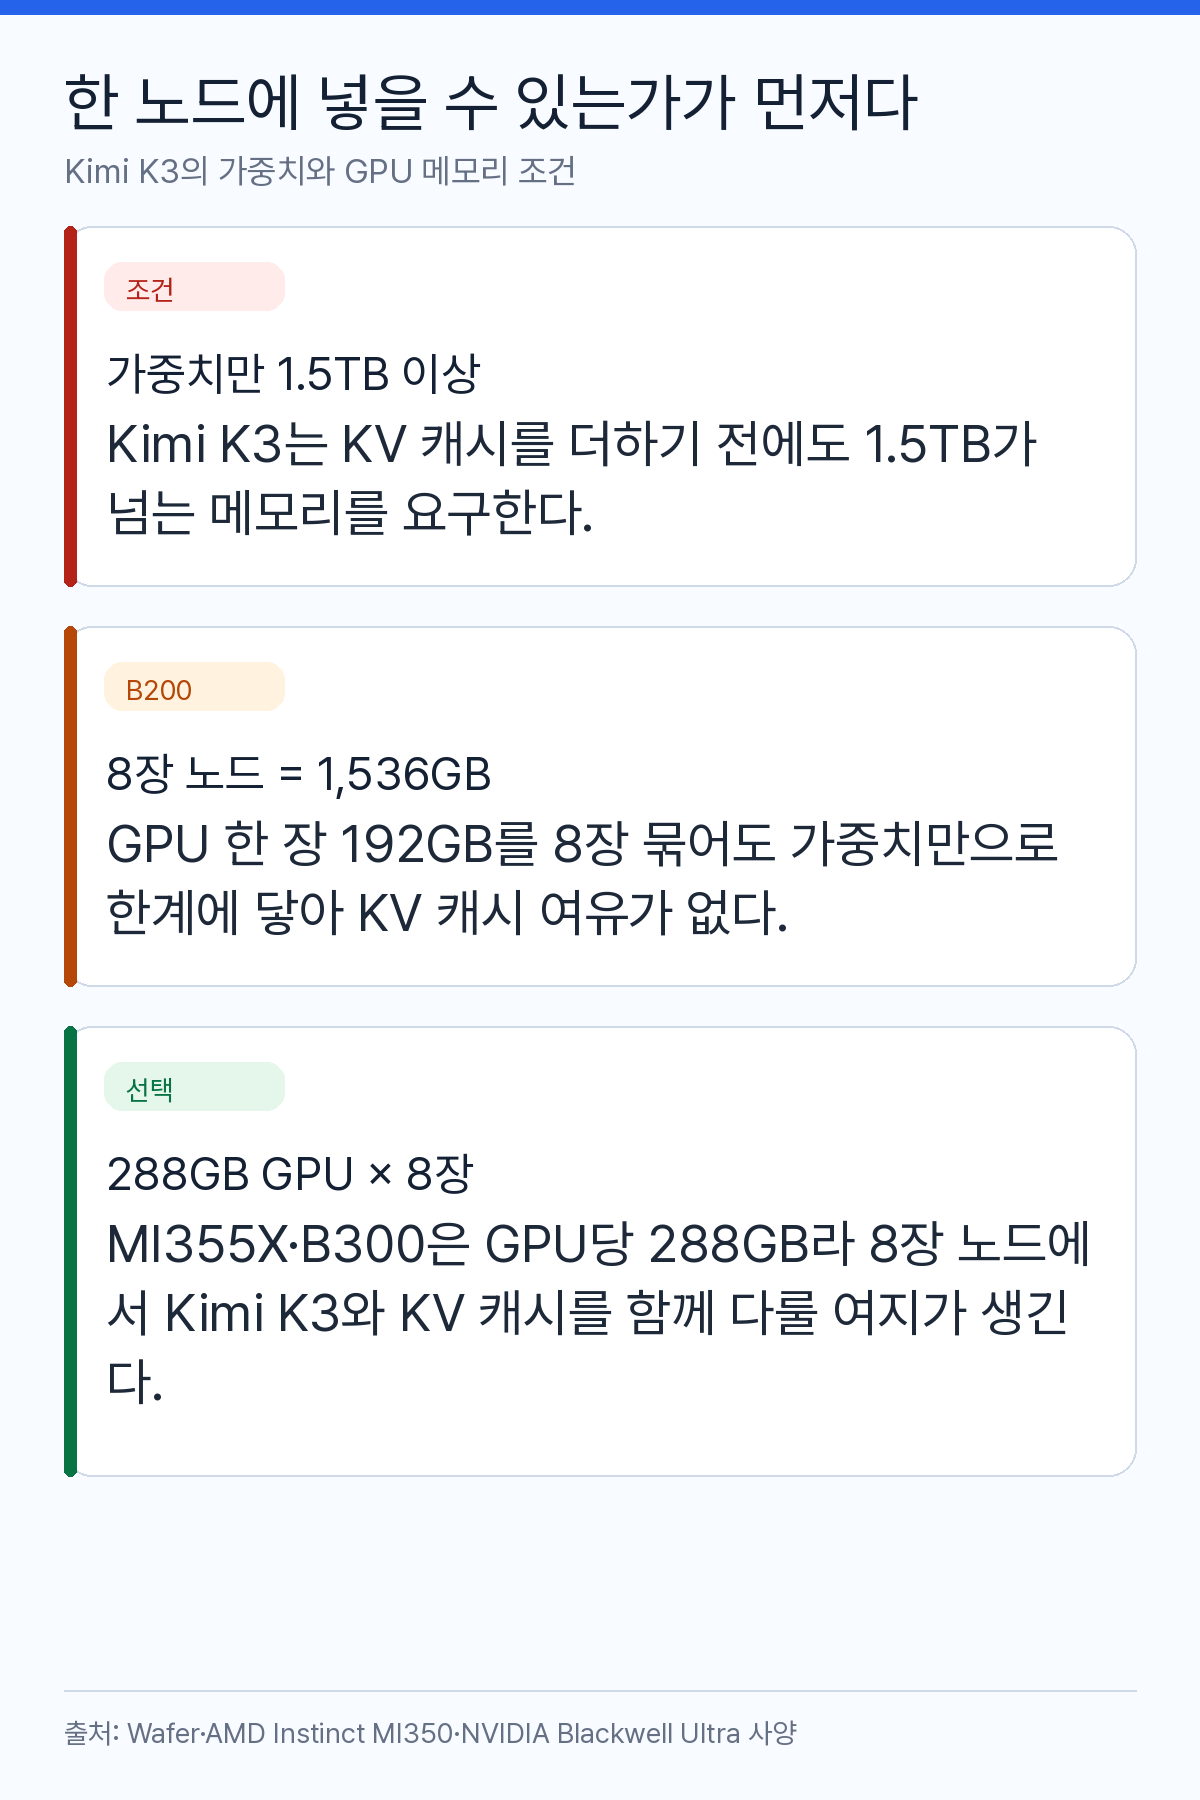
Kimi K3는 2.8조 개 파라미터를 가진 Moonshot AI의 최신 모델로, Cloudflare의 공식 모델 카드에 따르면 Kimi Delta Attention이라는 하이브리드 선형 어텐션 구조와 100만 토큰 컨텍스트 윈도우를 지원한다. 이만한 크기의 모델은 가중치만으로 1.5TB가 넘는 VRAM이 필요해, GPU 한 장이 아니라 노드 단위 설계가 필요하다.
Kimi K3는 왜 GPU 한 장에 안 들어가나
Nvidia의 B200은 GPU 한 장당 192GB의 HBM3E 메모리를 갖고 있어, 8장을 묶은 노드 전체로도 최대 1,536GB밖에 되지 않는다. Kimi K3는 KV 캐시를 더하기 전 가중치만으로 이 용량을 넘어서기 때문에, B200 노드 한 대에는 아예 올라가지 않는다. Nvidia 개발자 블로그가 밝힌 스펙에 따르면 B300이 속한 Blackwell Ultra 세대 GPU는 최대 288GB의 HBM3E 메모리를 갖췄고, AMD 공식 제품 페이지에 따르면 MI355X 역시 288GB 메모리로 같은 조건을 만족한다. 결국 Kimi K3를 서빙하려면 B300 노드 1대, B200 2노드를 텐서 병렬(TP16)로 묶는 방식, 또는 MI355X 노드 1대 중 하나를 선택해야 한다.
실제 처리량은 어느 정도 차이 나나
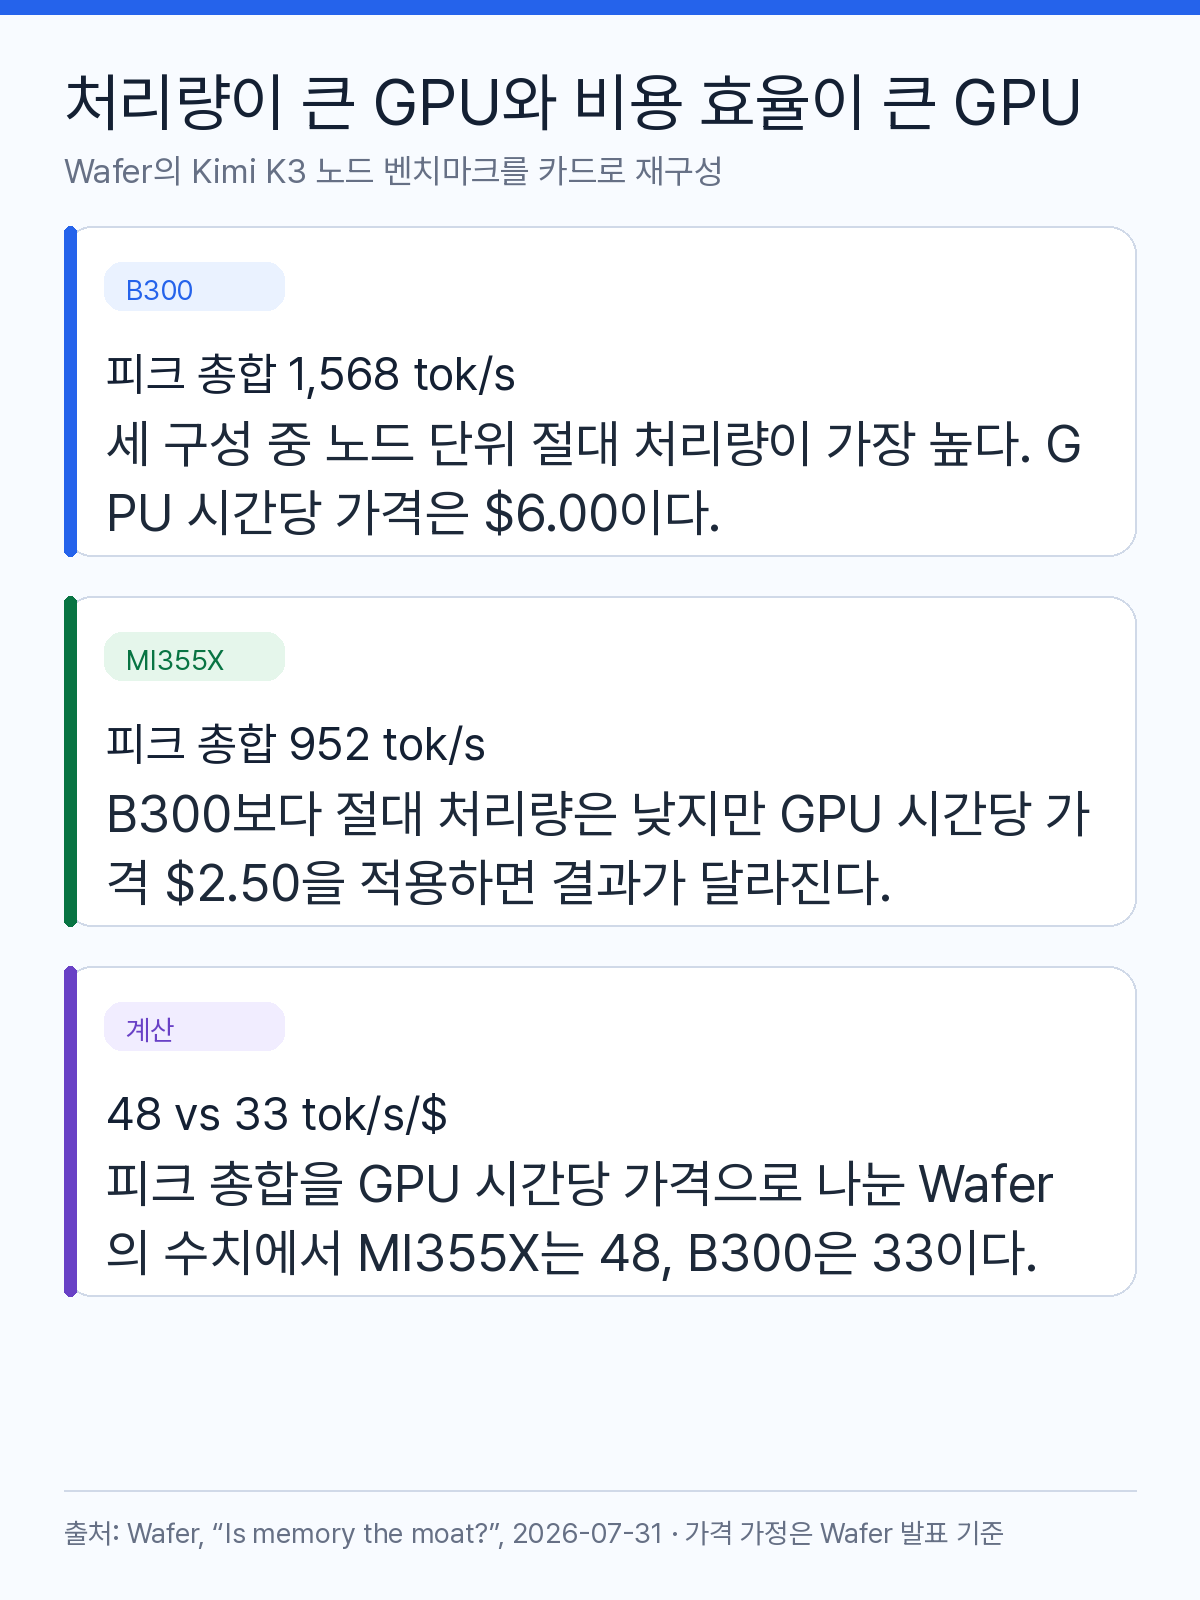
Wafer가 공개한 벤치마크 표를 보면, 절대 처리량 자체는 B300이 가장 높다. B300(TP8+DCP8) 노드는 싱글 스트림 디코드에서 초당 172토큰, 피크 총합 처리량에서 초당 1,568토큰을 기록해 MI355X의 952토큰보다 약 1.65배 앞섭니다. 하지만 Wafer가 적용한 GPU 시간당 가격(MI355X 2.50달러, B300 6.00달러, B200 4.25달러) 기준으로 계산하면 이야기가 달라집니다. MI355X는 GPU 시간당 가격 대비 초당 48토큰을 내는 반면 B300은 33토큰, B200은 7토큰에 그칩니다. B300이 노드당 처리량은 더 높지만, 가격이 2.4배 비싸기 때문에 달러당 성능에서는 MI355X가 앞선다는 것이 Wafer의 결론이다.
B200이 상대적으로 낮은 수치를 낸 이유도 짚을 필요가 있다. Kimi K3가 100만 토큰 KV 캐시까지 감안하면 8장짜리 B200 노드 하나에 들어가지 않기 때문에, Wafer의 B200 구성은 2개 노드를 텐서 병렬 16(TP16)으로 묶은 방식이다. 이 경우 디코드 과정에서 노드 간 all-reduce 통신이 초당 195Gb/s의 RoCE v2 네트워크를 거쳐야 해서, 단일 노드로 끝나는 MI355X·B300 구성보다 통신 지연이 추가로 발생한다.
서빙 과정에서 실제로 무엇을 고쳤나
AMD는 Kimi K3에 대해 데이 제로(day-0) 지원을 제공했지만, 실제 처리량을 끌어올리는 과정에서 Wafer는 두 가지 ROCm 환경 특유의 버그를 직접 고쳐야 했다. 첫 번째는 추론 속도를 높이는 speculative decode 경로였다. Kimi K3는 자체 draft 텐서(MTP, EAGLE 등)를 전혀 제공하지 않아 RadixArk의 외부 블록-확산 draft 모델인 Kimi-K3-DSpark를 붙여야 하는데, 이 경로가 ROCm에서 처음 요청을 처리할 때 스케줄러 전체가 멈추는 오류를 냈다. 원인은 커널이 없어서가 아니라, sglang의 조밀한(dense) 샘플링 경로가 부르는 top_k_renorm_prob 함수가 ROCm 빌드에는 별칭 처리되지 않은 채 정의 자체가 빠져 있었기 때문이다. Wafer는 새 커널을 만드는 대신 PyTorch 연산만으로 이 top-k 재정규화 로직(정렬→상위 k개만 남기고 나머지 마스킹→합이 1이 되도록 재조정)을 직접 구현해 끼워 넣었다.
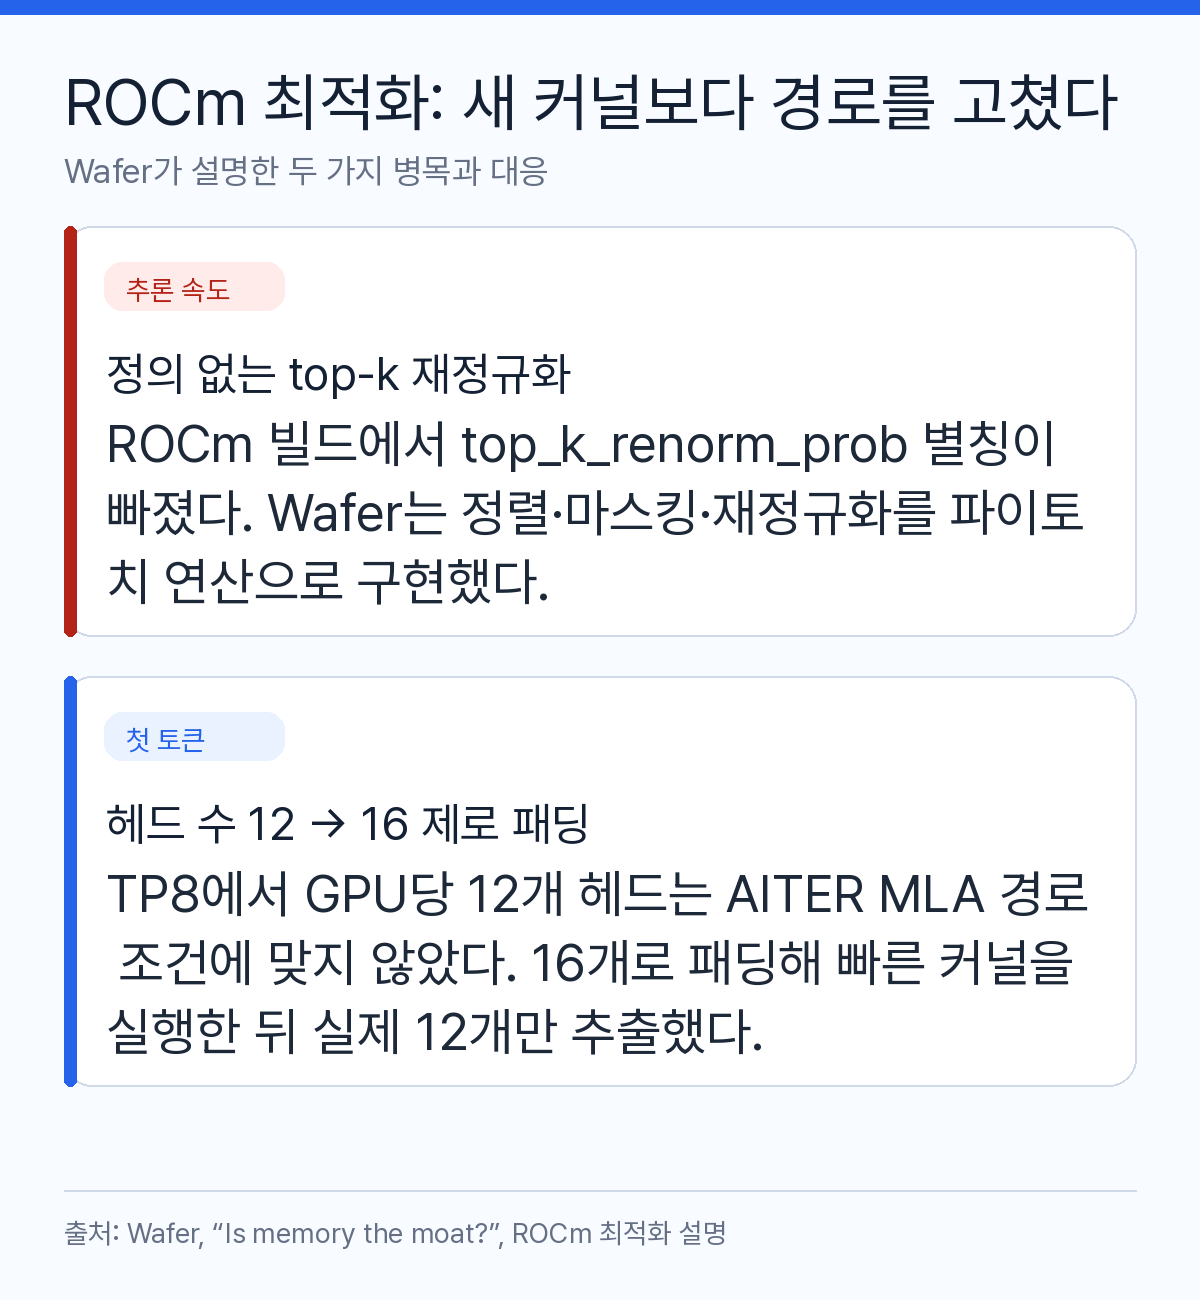
두 번째는 첫 토큰이 나오기까지 걸리는 시간(TTFT)과 직결된 prefill 단계였다. 172,000토큰짜리 냉간 prefill을 기준으로 MI355X는 약 51초가 걸린 반면 B300은 약 23초에 그쳤는데, 원인은 빠른 AITER MLA prefill 커널이 로드되지 않고 느린 범용 Triton 어텐션으로 대체되는 문제였다. Kimi K3를 TP8로 나누면 GPU 하나당 어텐션 헤드가 12개가 되는데, AITER의 MLA 경로는 4·8·16개 또는 그 배수만 지원해 12개 헤드에서는 커널이 아예 로드되지 않았다. Wafer는 헤드 수를 12개에서 16개로 제로 패딩한 뒤 빠른 커널을 그대로 실행하고, 결과에서 실제 12개 헤드만 다시 추출하는 방식으로 문제를 풀었다. 그 결과 같은 172,000토큰 냉간 prefill에서 처리 속도가 초당 4,000~7,000토큰이던 Triton 대체 경로 대비 약 13,000토큰까지 올라가, 2~3배 빨라졌다. 이 최적화는 디코드 처리량 자체는 바꾸지 않고, 사용자가 첫 응답을 받기까지 기다리는 시간만 줄이는 효과를 낸다.
이번 사례가 보여주는 것
Wafer는 앞서 6월에도 GLM5.2를 MI355X에 서빙하며 비슷한 성능 대비 가격 우위를 보인 바 있는데, 이번 Kimi K3 사례에서는 그때보다 프레임워크 관련 버그 수가 더 적었고 커스텀 커널을 새로 짜야 하는 상황도 없었다고 밝혔다. AMD가 신모델 공개 당일 지원을 갖추는 속도가 빨라지면서, 남은 격차는 이런 소프트웨어 디테일을 얼마나 빨리 찾아 고치느냐로 좁혀지고 있다는 뜻이다. 한편 Moonshot AI가 7월 17일 Kimi K3를 처음 공개했을 때 CNBC 보도에 따르면, 이 모델은 코딩과 범용 에이전트 벤치마크에서 Claude Opus 4.8과 GPT 5.5를 앞섰지만 최상위 모델인 Claude Fable 5, GPT 5.6 Sol에는 미치지 못한다고 Moonshot AI 스스로 밝힌 바 있다.