
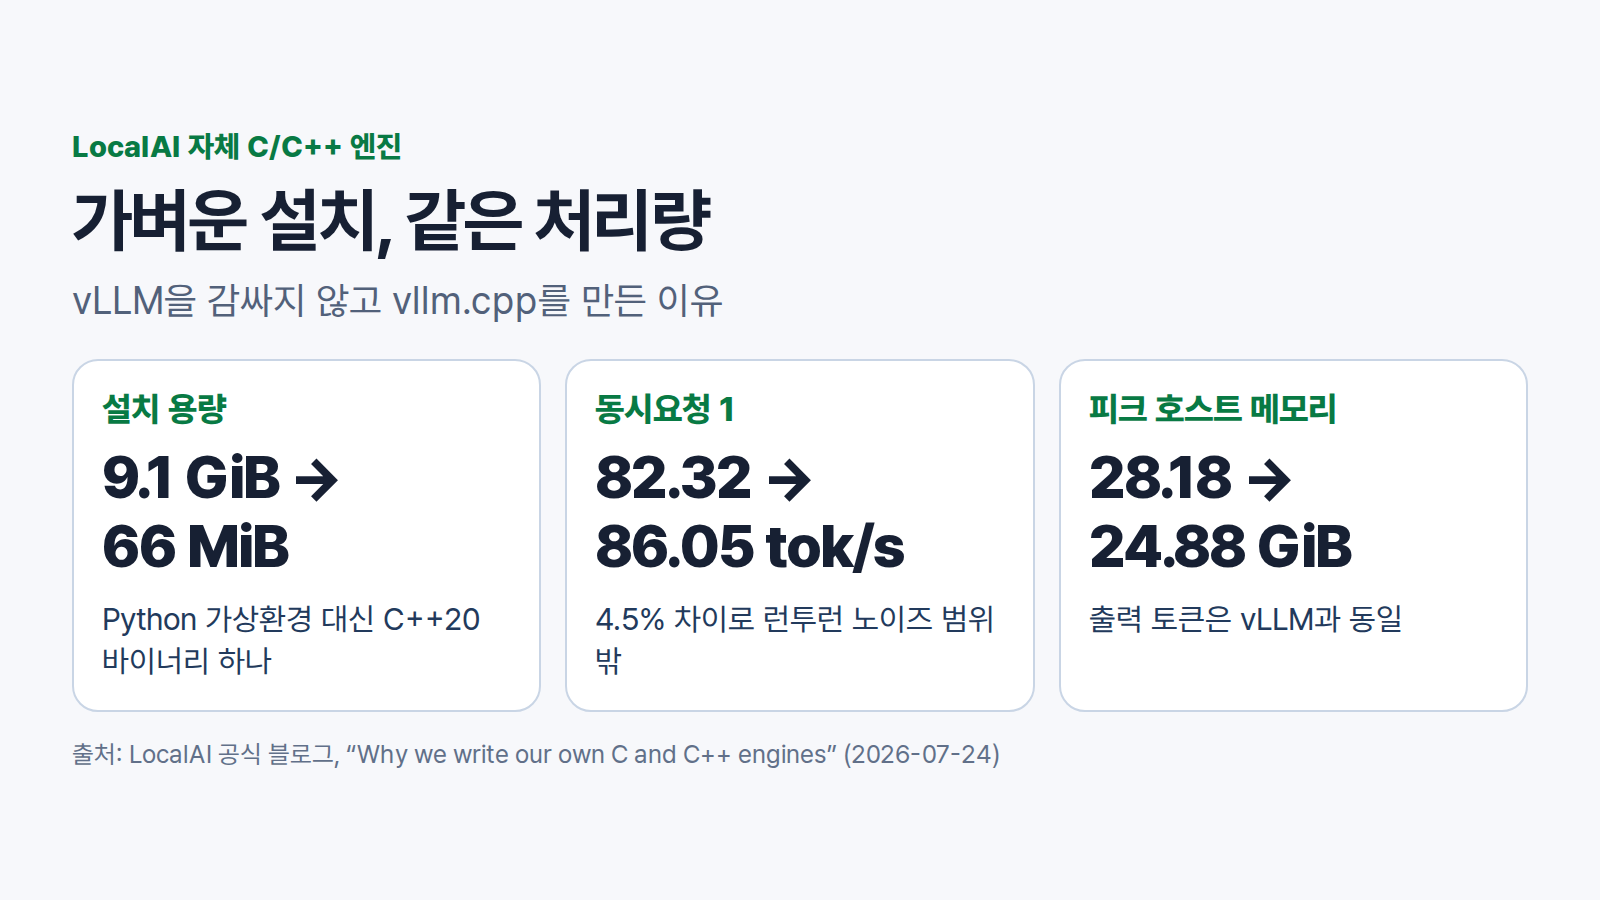
오픈소스 로컬 추론 서버 LocalAI가 7월 24일 공식 블로그에 올린 글에서, 자사 백엔드 중 18개를 왜 llama.cpp나 vLLM처럼 남의 엔진을 감싸는 대신 C·C++로 직접 새로 짰는지를 실측치와 함께 밝혔다. 핵심은 이식(포팅) 자체가 목적이 아니라, Python 스택을 그대로 배포할 수 없는 상황에서 설치 용량과 메모리를 줄이면서도 처리량은 잃지 않는 방법을 찾았다는 것이다.
LocalAI는 llama.cpp, vLLM, whisper.cpp, stable-diffusion, MLX 같은 대형 엔진은 그대로 감싸 쓰는 것이 기본값이라고 밝히고 있다. 이런 프로젝트는 이미 그 모델을 가장 잘 아는 사람들이 유지보수하고 있어서, 감싸는 데 드는 비용이 Dockerfile 하나와 gRPC 어댑터 정도로 작기 때문이다. 반대로 18개 백엔드는 처음부터 C·C++로 새로 만들었는데, 그 이유는 세 가지 중 하나다. 업스트림 엔진을 감싸려면 수 기가바이트짜리 Python 설치본을 배포해야 하거나, CUDA에만 묶인 비휴대성 스택을 강제로 써야 하거나, 아예 그 모델에 대한 C++ 구현이 존재하지 않는 경우다.
Python 스택을 없애면 설치 용량이 얼마나 줄어드나
가장 뚜렷한 사례는 vLLM의 V1 서빙 아키텍처를 C++20으로 새로 짠 vllm.cpp이다. vLLM을 설치하면 9.1GiB짜리 virtualenv가 만들어지는 반면, vllm.cpp는 66MiB 바이너리 하나로 끝납니다. vllm.cpp는 페이지 단위 KV 캐시, 연속 배칭, prefix 캐싱, 스케줄러, 샘플러까지 vLLM 원본이 구현한 기능을 그대로 옮겨 담았고, 추론 시점에는 Python·PyTorch·ggml 중 어느 것도 쓰지 않는다.
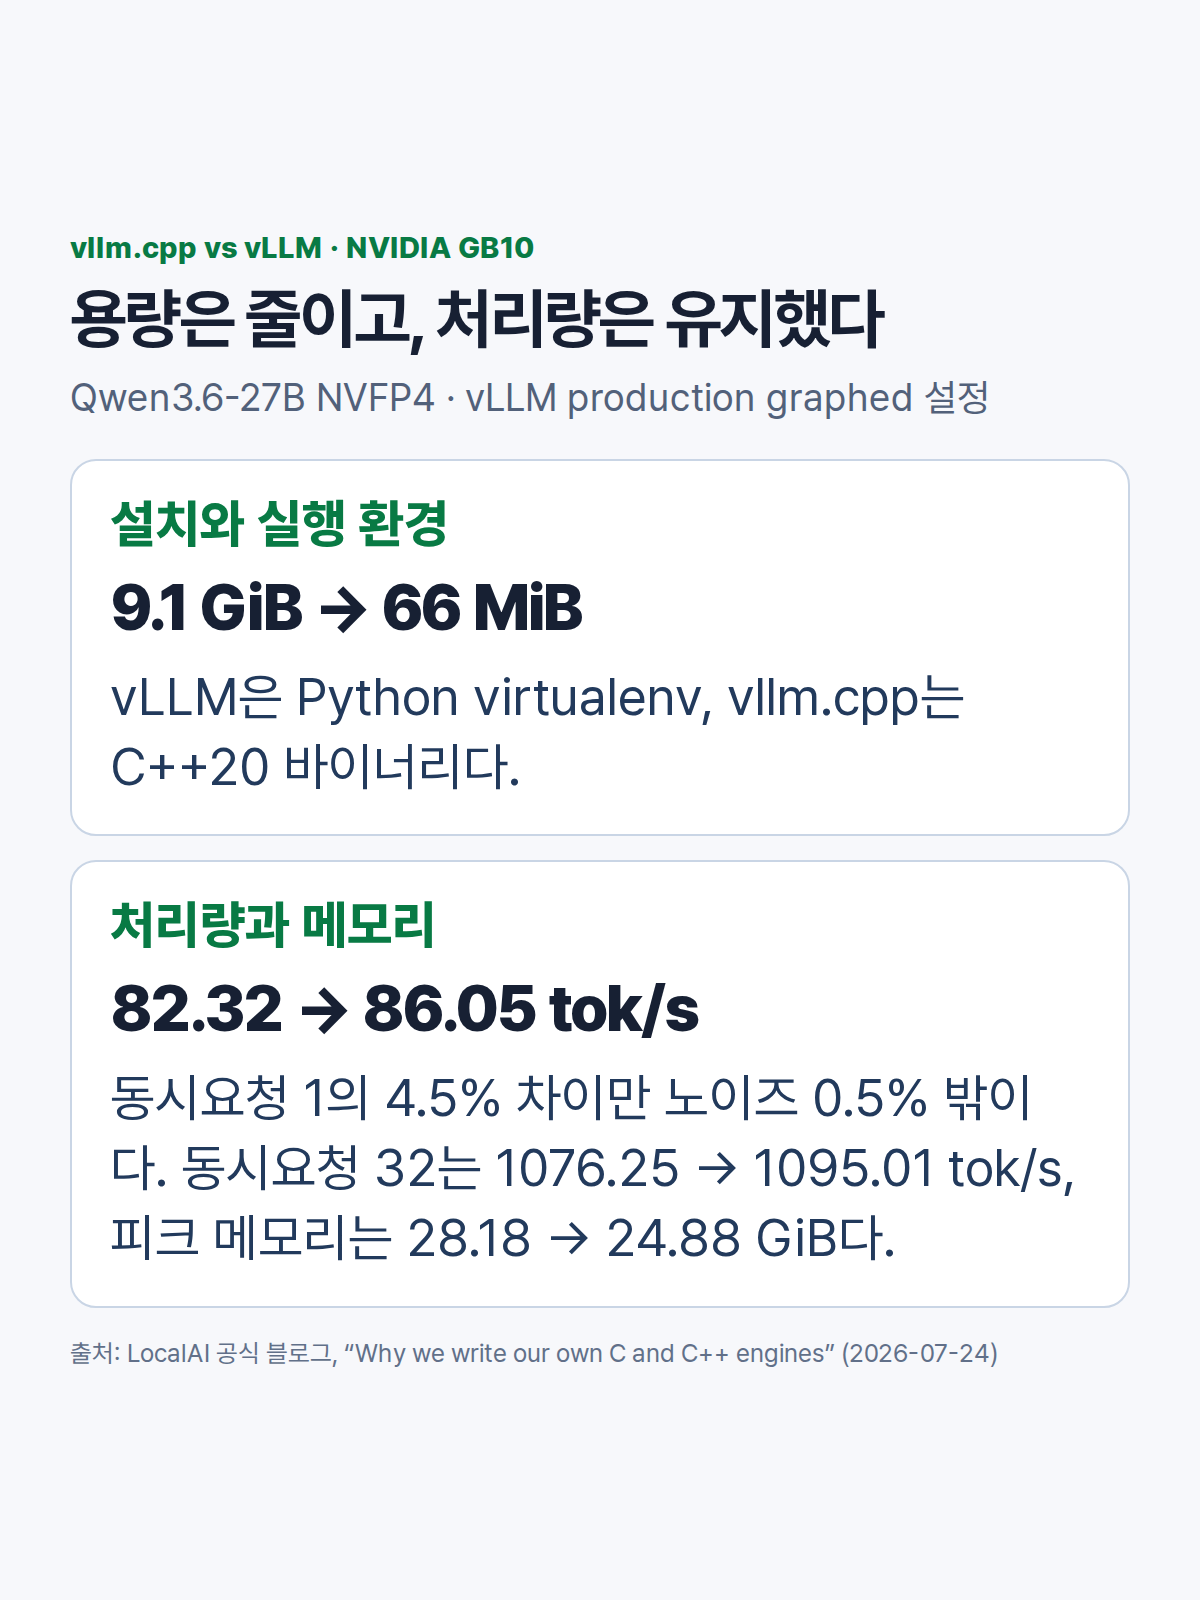
용량을 줄인 대가로 속도가 떨어지는지가 당연히 궁금한 부분인데, LocalAI가 NVIDIA GB10에서 Qwen3.6-27B를 NVFP4로 돌리며 vLLM의 프로덕션 그래프 모드(--enforce-eager를 끈 상태)와 비교한 결과는 동시요청 1·2·4·8·16·32 여섯 구간 모두에서 vllm.cpp가 앞섰다. 다만 LocalAI 스스로 이 결과를 해석하면서, 런투런(같은 조건을 반복 실행했을 때의) 노이즈 밴드가 0.5%이고 동시요청 2~32 구간의 차이가 0.7~1.7%에 머문다는 점을 함께 밝혔다. 그러면 노이즈 밖에 있다고 확실히 말할 수 있는 차이는 동시요청 1에서 나온 4.5%(vllm.cpp 86.05 tok/s, vLLM 82.32 tok/s) 뿐이고, 나머지 다섯 구간은 실질적으로 동률에 가깝다는 뜻이다. 출력 토큰은 vLLM과 완전히 동일했고, 피크 호스트 메모리는 vllm.cpp가 24.88GiB로 vLLM의 28.18GiB보다 적었다. 같은 GGUF 파일로 CPU에서 llama.cpp와 비교하면 프리필(첫 응답 준비 단계)이 1.18배 빠르고(223.8 대 177.3 tok/s), 디코드는 llama.cpp 자체 편차 범위 안에서 동률이었다. Apple M4의 MLX-LM과 비교하면 프리필의 첫 토큰 도달 시간은 1.5% 앞섰지만, 워밍업 후 전체 처리량은 MLX-LM의 97.6%로 디코드 구간에서 2.4% 뒤졌다.
단순히 더 빨라진 경우도 있다
ByteDance의 Depth Anything 3를 포팅한 depth-anything.cpp는 한 장의 사진에서 미터 단위 깊이, 픽셀별 신뢰도, 카메라 내·외부 파라미터, 포인트 클라우드까지 뽑아내는 모델인데, CPU에서는 같은 모델을 돌리는 PyTorch보다 더 빠르다. Ryzen 9 9950X3D에서 504x336 입력을 16스레드로 처리했을 때 PyTorch(f32, 516MB 모델)는 로드에 749ms, 추론에 416.9ms, 피크 메모리 1328MB가 들었다. C++/ggml 포팅(q8_0 양자화, 142MB 모델)은 로드 40ms, 추론 319.4ms, 피크 메모리 363MB로, 속도는 1.31배, 메모리는 27% 수준이었다. q4_k로 더 양자화한 빌드는 99MB까지 줄어들면서도 정확도 손실은 거의 없다고 밝혔다.
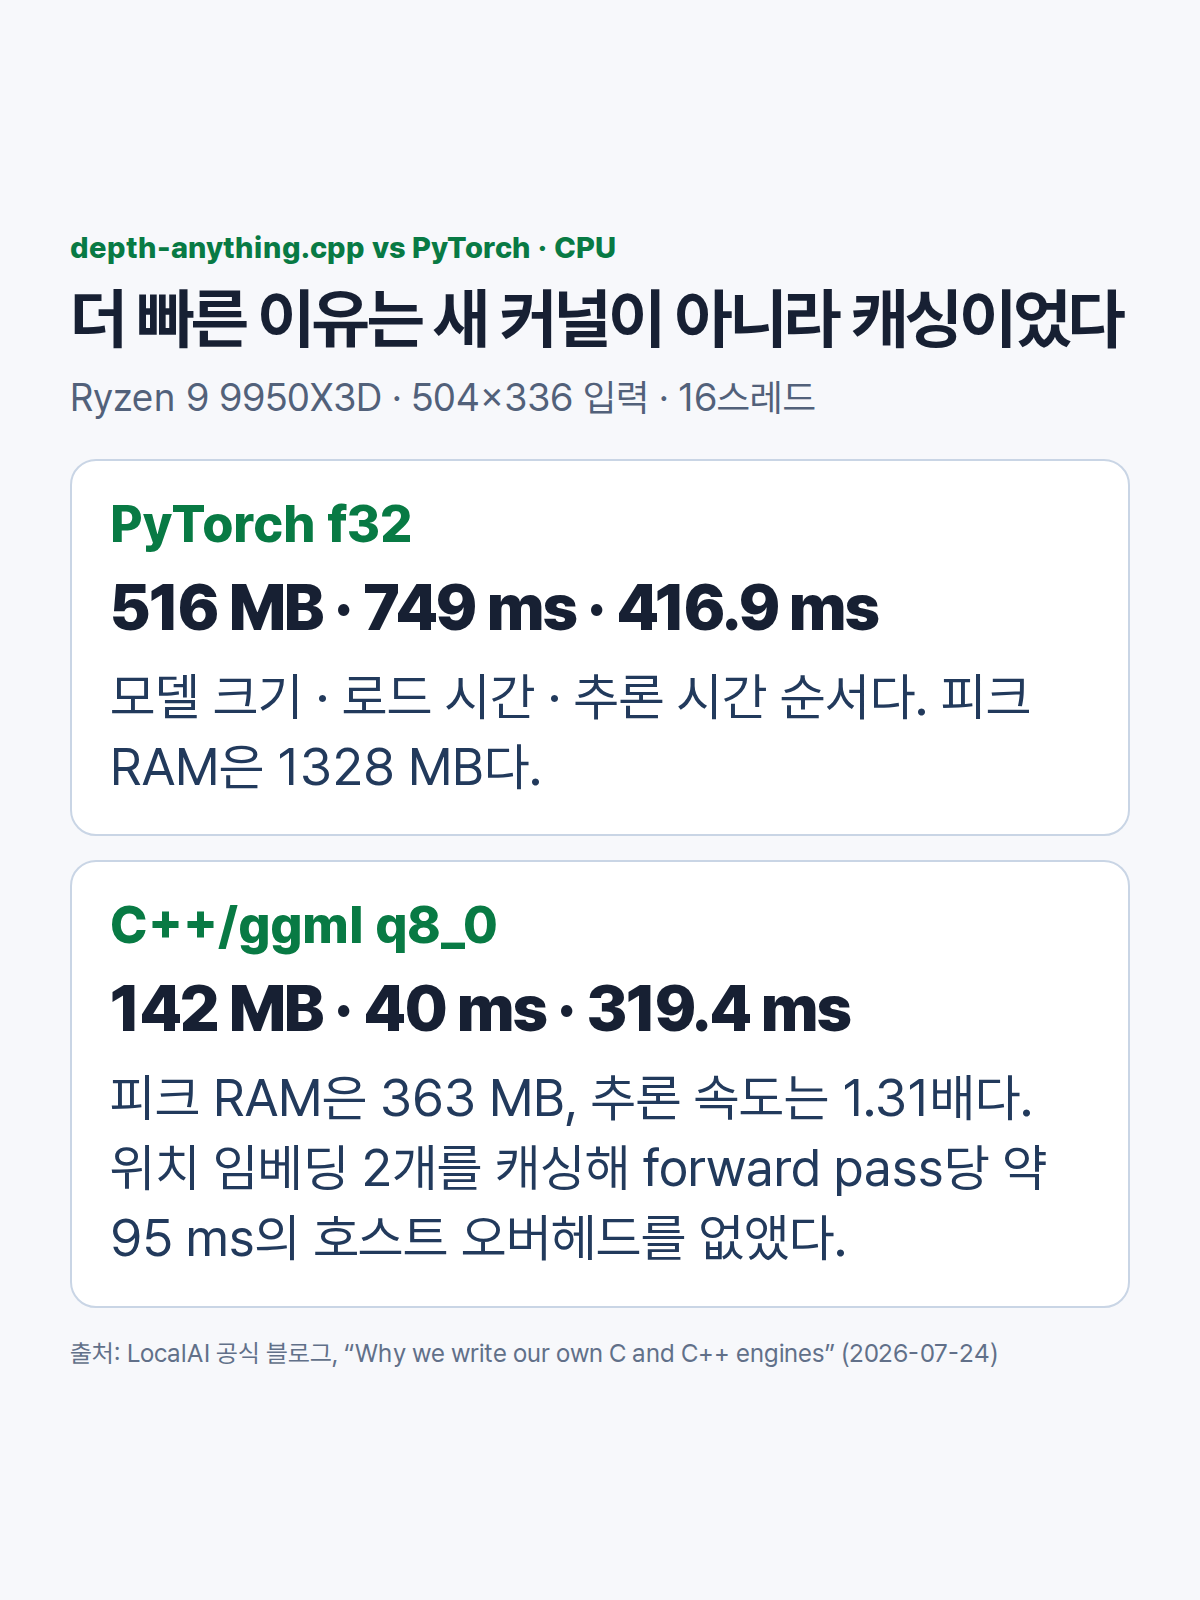
속도 차이의 원인은 더 나은 행렬곱(matmul) 커널을 짰기 때문이 아니라고 LocalAI는 밝히고 있다. DPT 헤드의 UV 임베딩과 백본의 bicubic 위치 임베딩, 이렇게 두 개의 위치 임베딩이 입력 기하 구조에만 의존해 매 호출마다 값이 동일한데도 PyTorch 참조 구현은 이걸 매 forward pass마다 단일 스레드 스칼라 sin·cos·bicubic 루프로 다시 계산하고 있었다. 이 값을 캐싱해서 없앤 것이 forward pass당 약 95ms의 오버헤드였고, 이것이 전체 격차의 대부분을 차지했다. GPU에서는 이 격차가 다시 사라져, ggml의 CUDA 백엔드와 flash attention을 쓰면 GB10에서 depth-anything.cpp와 PyTorch의 튜닝된 cuDNN이 forward당 47.3ms로 동률을 이루고, depth-anything.cpp가 이기는 부분은 콜드 스타트(로딩 1.75~2.9배 빠름)뿐이다.
속도보다 원본과의 일치가 먼저인 경우
얼굴 인식용 face-detect.cpp와 화자 인식용 voice-detect.cpp는 LocalAI의 기존 Python insightface·speaker-recognition 백엔드를 대체했는데, 이 두 엔진은 CPU 속도에서 이겼다고 주장하지 않는데도 그대로 배포됐다. 바이오메트릭(생체 인식) 파이프라인에서는 원본과 정확히 같은 값을 내는 것이 빠른 것보다 더 중요하기 때문이다. 임베딩 값이 소수점 네 번째 자리만 달라져도 특정 임계값에서 인증 판정이 바뀔 수 있고, 그러면 이미 등록된 모든 템플릿을 다시 계산해야 한다.
face-detect.cpp는 insightface의 buffalo 체인 전체, 즉 SCRFD 얼굴 검출과 5개 랜드마크 기반 112x112 정렬, ArcFace 임베딩까지를 Python이나 onnxruntime 없이 하나의 GGUF 파일로 실행한다. 검출 박스와 랜드마크는 insightface와 1픽셀 이내로 일치하고, 인식 임베딩은 코사인 유사도 1.000000으로 스레드 수와 무관하게 일치한다. CPU 속도만 보면 onnxruntime보다 느린데, SCRFD 검출은 스레드 1개일 때 약 0.83배, 8개일 때 0.69배이고 ArcFace 임베딩은 각각 약 0.61배, 0.84배다. GPU로 옮겨 같은 합성곱 연산을 cuDNN으로 돌리면 SCRFD 검출이 14.8ms에서 6.4ms로 줄어 PyTorch·cuDNN과 동률에 도달한다. voice-detect.cpp는 화자 검증 시 메모리를 약 62MB만 쓰는데, CPU 전용 Python·torch·onnxruntime 조합은 약 334MB를 써서 약 5.4배 차이가 나고, 판정 결과와 임베딩 코사인 값은 1.000000으로 동일하다.
새 엔진을 만드는 절차와 비용
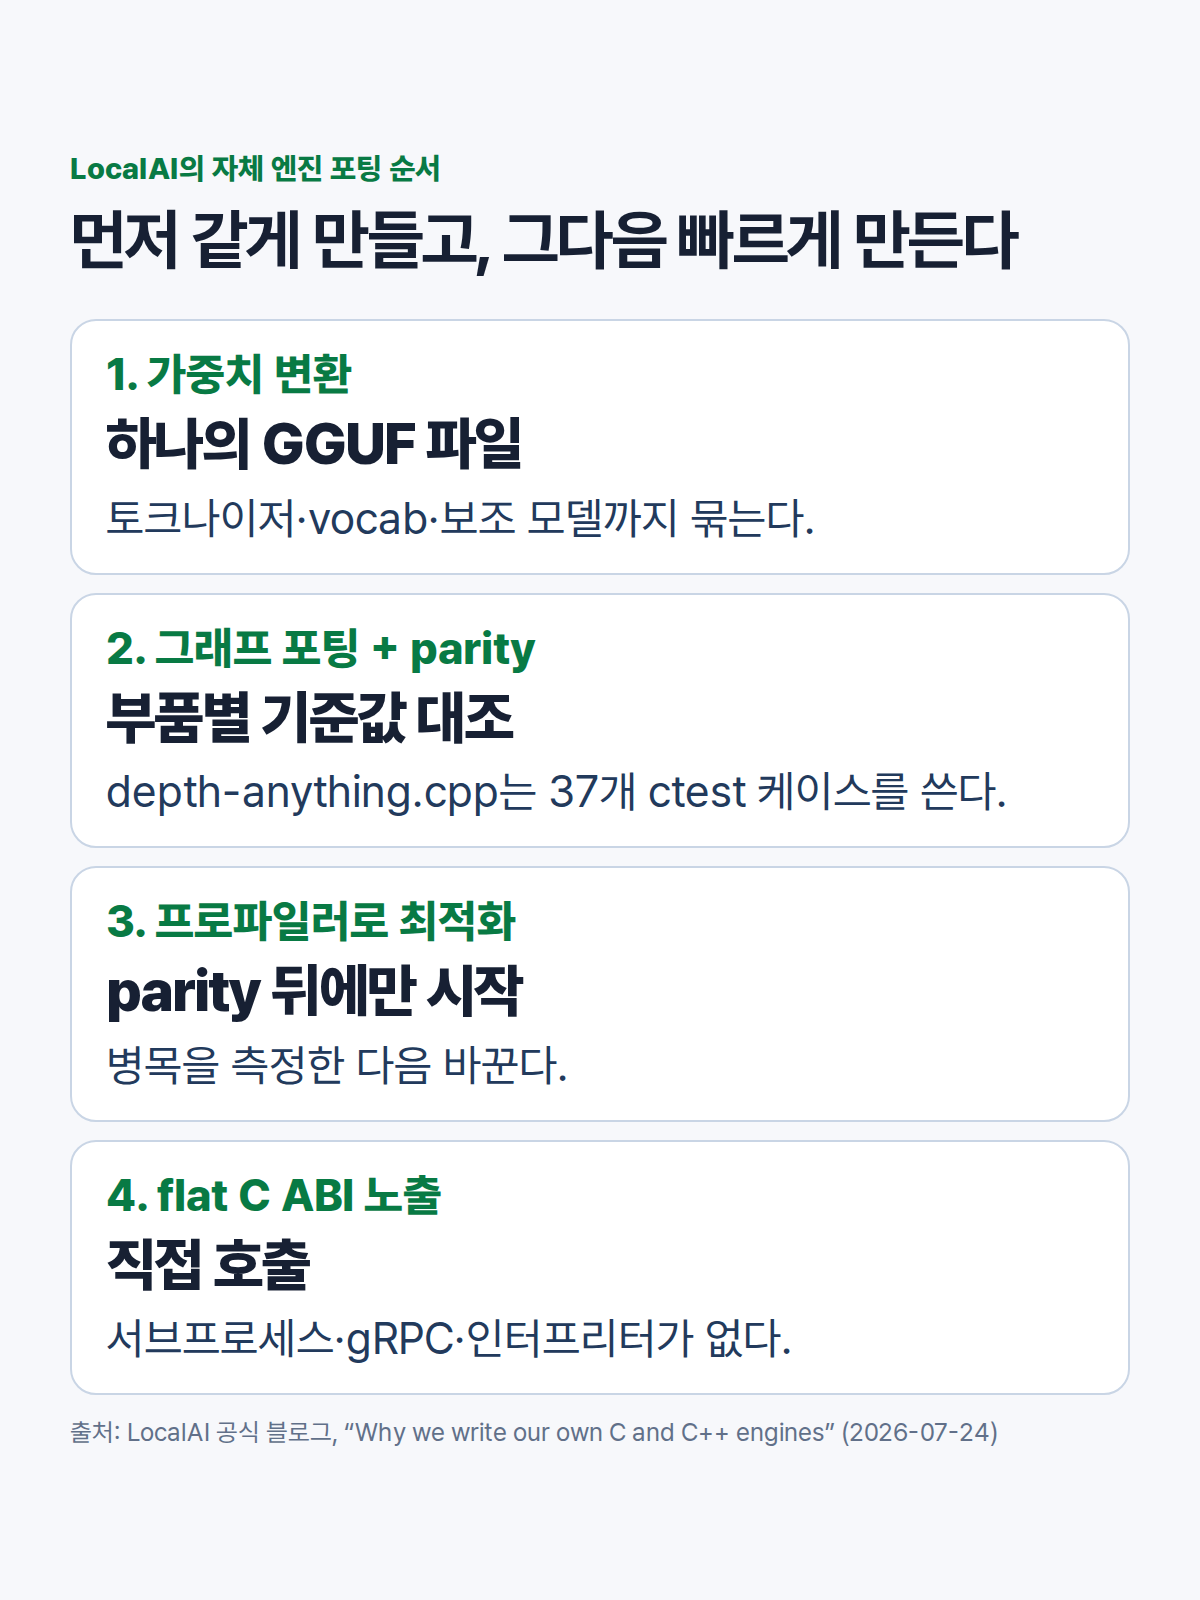
LocalAI가 밝힌 포팅 순서는 항상 같다. 먼저 가중치를 토크나이저·vocab·보조 모델까지 하나의 GGUF 파일로 변환해, 모델 배포를 파일 하나 복사하는 일로 만든다. 그다음 그래프를 포팅하면서 원본 구현에서 뽑은 참조 텐서와 부품 단위로 대조하는 parity 게이트를 통과시킵니다. depth-anything.cpp는 전처리·백본·어텐션·DPT 헤드·깊이·포즈·레이 헤드·솔버·exporter까지 37개 ctest 케이스로 이 게이트를 돌리고, parakeet.cpp는 NeMo와의 전사(transcript) 일치율(WER 0)로, face-detect.cpp는 박스·랜드마크 거리와 임베딩 코사인 값으로 게이트를 통과시킵니다. LocalAI는 빠르지만 틀린 포팅은 무의미하며, 부품 단위 게이트 없이는 몇 달 뒤에야 문제를 알게 된다고 밝혔다. 최적화는 이 parity가 확인된 다음에만, 프로파일러를 붙여 진행한다. parakeet.cpp에서는 전사 디코드 시간의 97%를 차지하던 예측망 LSTM forward pass 캐싱이 결정적이었고, depth-anything.cpp에서는 앞서 설명한 두 위치 임베딩 캐싱이었다. 둘 다 커널을 새로 짠 게 아니라, 작동하는 기준선을 프로파일링해야만 찾아낼 수 있는 종류의 최적화였다고 설명한다. 마지막 단계는 flat C ABI를 노출하는 것으로, LocalAI는 purego로 이 공유 라이브러리를 dlopen해 직접 호출하기 때문에 서브프로세스나 Python 서버로 가는 gRPC 홉, 서빙 경로 안의 인터프리터가 전혀 없다.
대가는 주로 유지보수 부담이다. 엔진마다 별도 CI, 별도 벤치마크 스위트, 별도 GGUF 변환 스크립트, 별도 parity 기준선을 갖는 별개의 저장소가 되고, 업스트림이 새 체크포인트를 낼 때마다 변환기 작업이 새로 필요하다. GPU 커널은 약점으로 남아 있는데, ggml의 범용 CUDA 합성곱·어텐션 커널이 NVIDIA의 튜닝된 cuDNN보다 합성곱이 많은 모델에서 뒤처지기 때문에 face-detect.cpp는 parity를 맞추려고 별도 cuDNN 경로를 둬야 했고, parakeet.cpp의 GPU 우위는 NeMo 대비 중앙값 1.25배에 그치는 반면 CPU 우위는 이보다 넓다. LocalAI는 이런 자체 포팅이 모든 것에 적용될 수 있는 방식은 아니라고도 밝혔다. llama.cpp, vLLM, whisper.cpp, MLX, diffusers는 이미 크고 빠르게 발전하며 그 분야에서 뛰어난 프로젝트라서 그대로 감싸 쓰고, 엔진을 새로 쓰는 건 모델에 C++ 구현이 없거나, Python 의존성이 모델 자체보다 무겁거나, 필요한 기능이 아직 존재하지 않을 때로 한정하고 있다.