
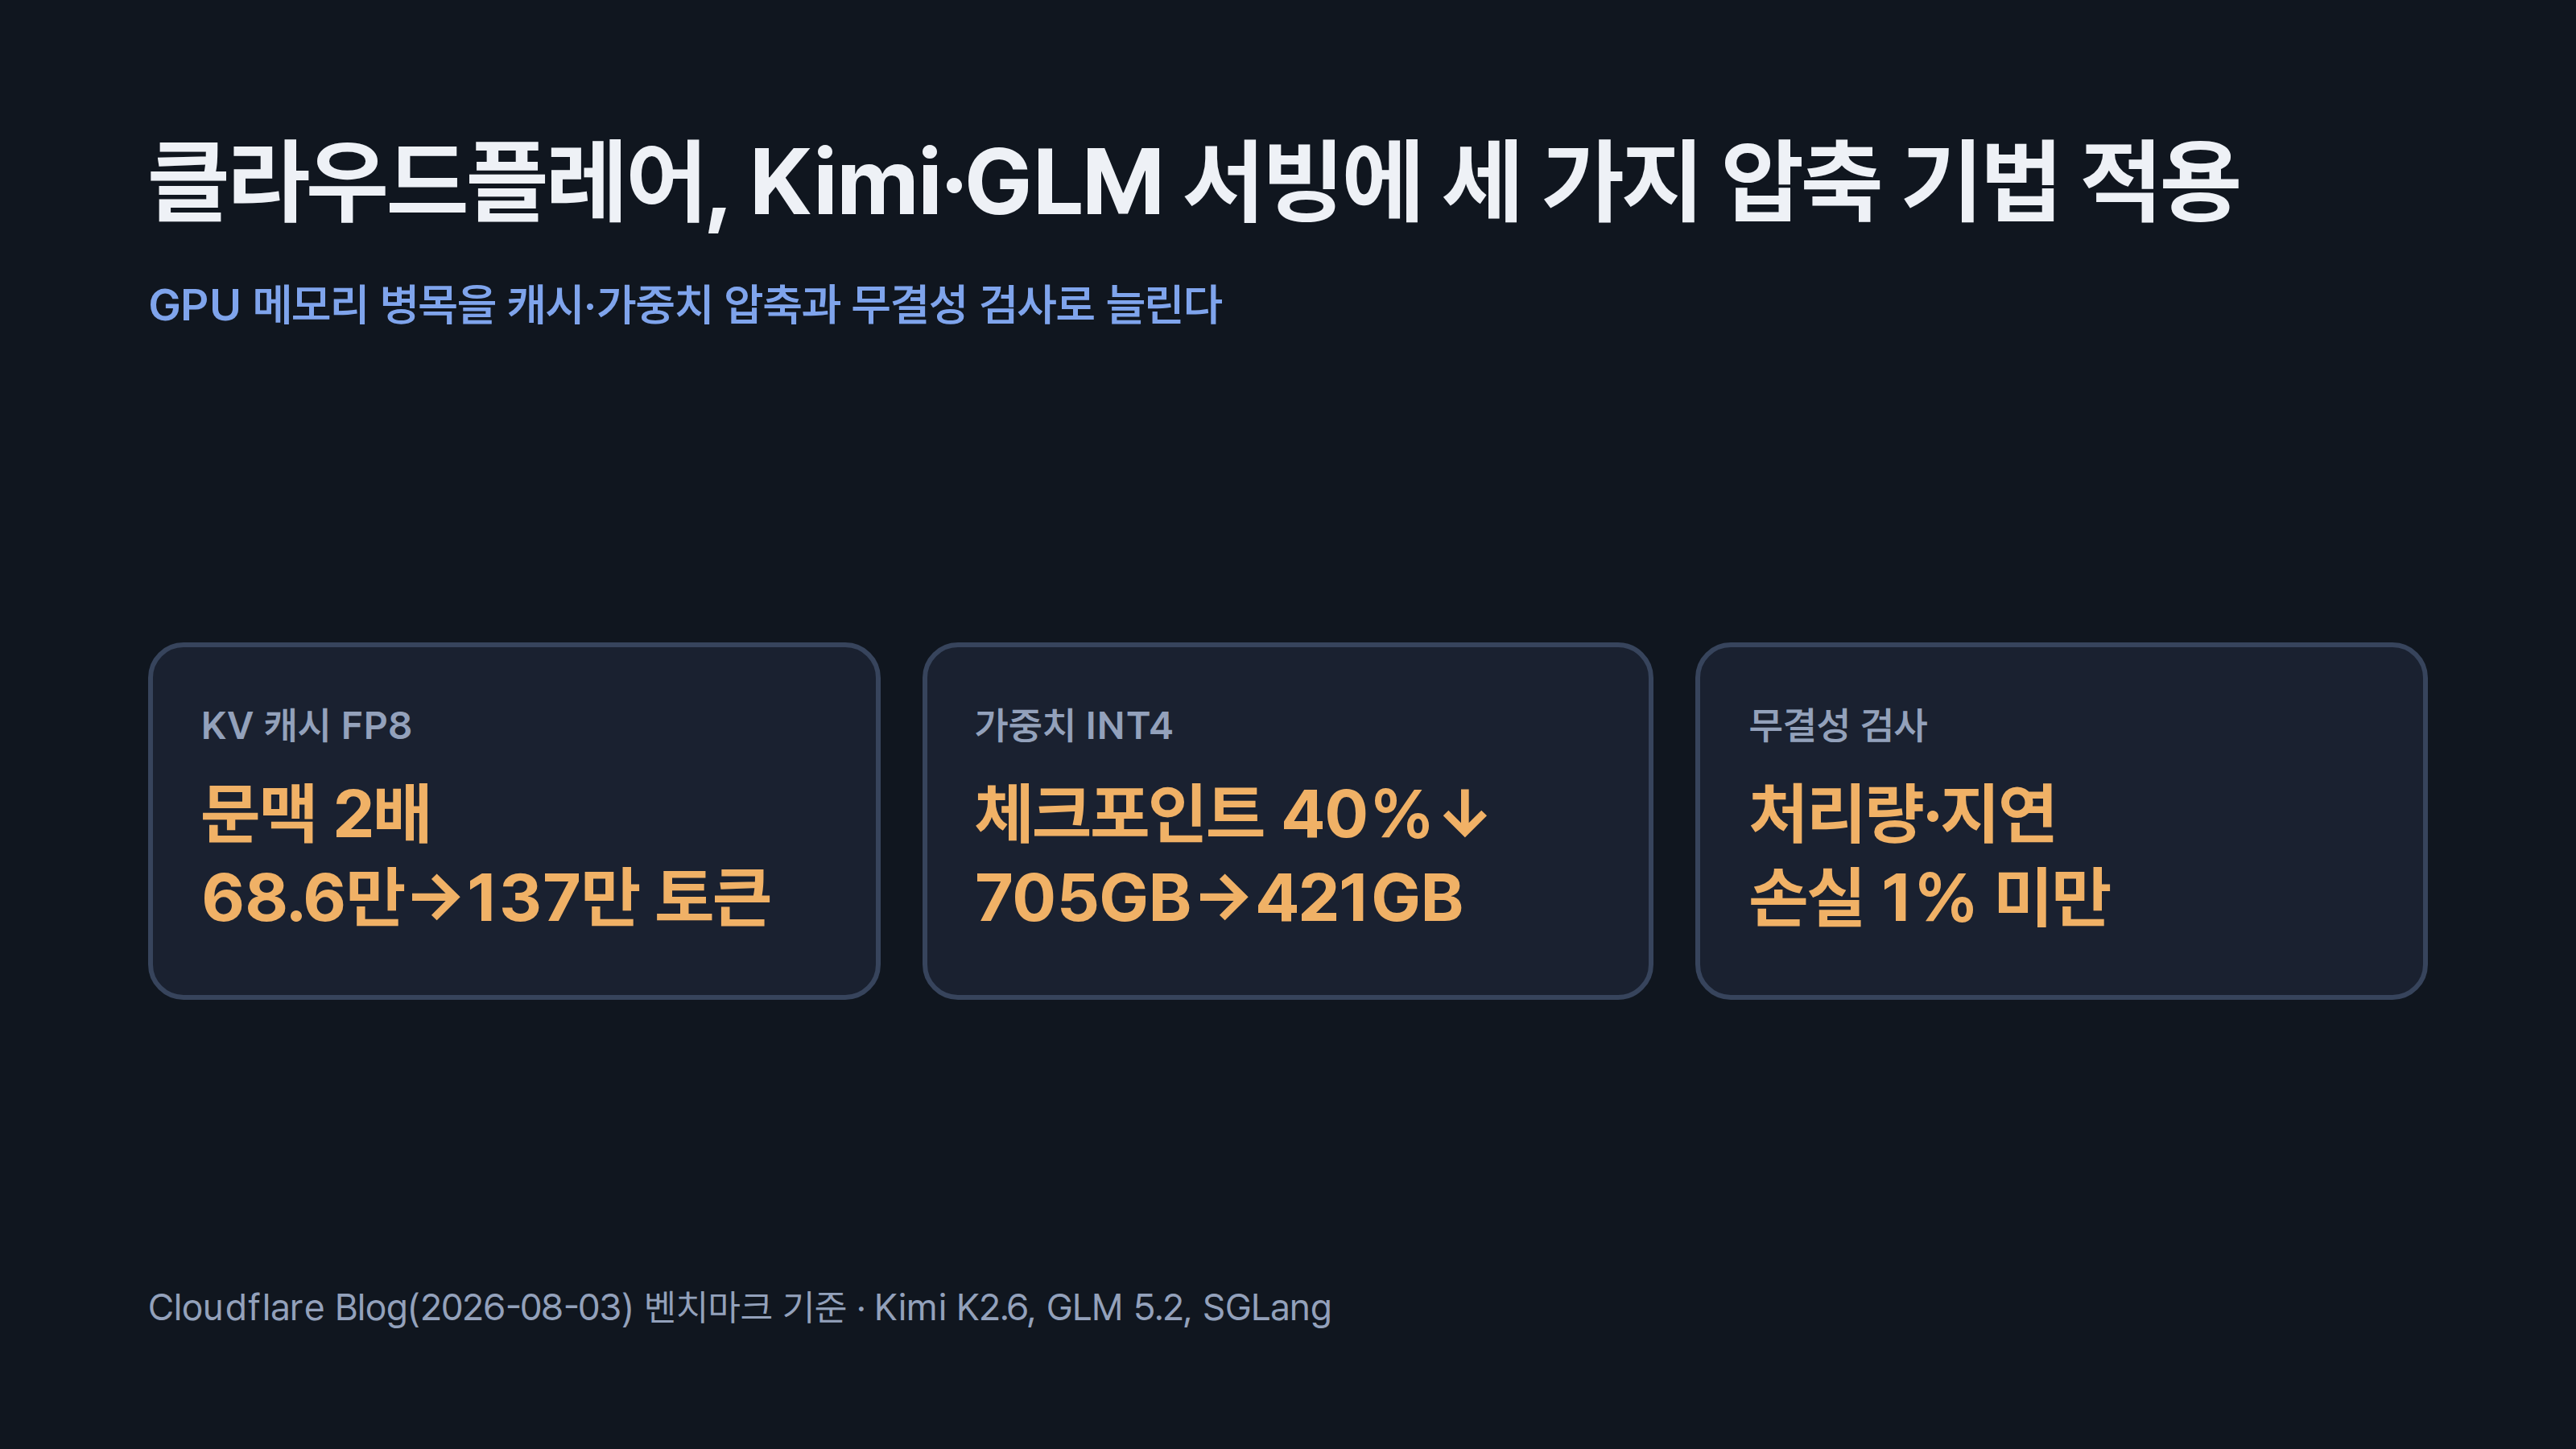
클라우드플레어가 8월 3일 공식 블로그에서, 자사 Workers AI가 모집단 모델 중 가장 다루기 힘든 두 모델, Moonshot의 Kimi K-시리즈와 Z.ai의 GLM을 GPU 한 대에 더 많이 태우면서도 응답 품질을 그대로 유지하는 방법을 실측치와 함께 공개했다. 두 모델 모두 길게 문맥을 유지하는 대형 혼합전문가(MoE) 모델이라, 서빙을 막는 것은 연산 속도가 아니라 GPU 메모리라는 것이 출발점이다. 이번 글에서 다룬 기법은 KV 캐시를 8비트로 줄이는 것, 모델 가중치를 4비트로 압축하는 것, 그리고 그렇게 늘어난 동시 요청이 캐시를 공유할 때 안전을 지키는 무결성 검사, 이렇게 세 가지다. 모든 실험과 실제 트래픽은 오픈소스 추론 프레임워크 SGLang 위에서 벤치마크했다고 밝혔다.
KV 캐시를 FP8로 줄이면 동시 요청이 왜 두 배로 늘어나는가
모델이 텍스트를 생성할 때마다 이미 처리한 토큰의 attention key·value를 KV 캐시에 저장해 두는데, 문맥이 길어질수록 이 캐시가 GPU 메모리에서 모델 가중치보다 먼저 한계에 부딪힌다. 클라우드플레어는 기본값인 16비트(BF16) 대신 8비트 부동소수점(FP8, e4m3)으로 캐시를 저장해 크기를 절반으로 줄였고, Kimi K2.6 기준으로 GPU 한 대가 담을 수 있는 문맥 길이가 약 68만 6천 토큰에서 약 137만 토큰으로 두 배가 됐다고 밝혔다.
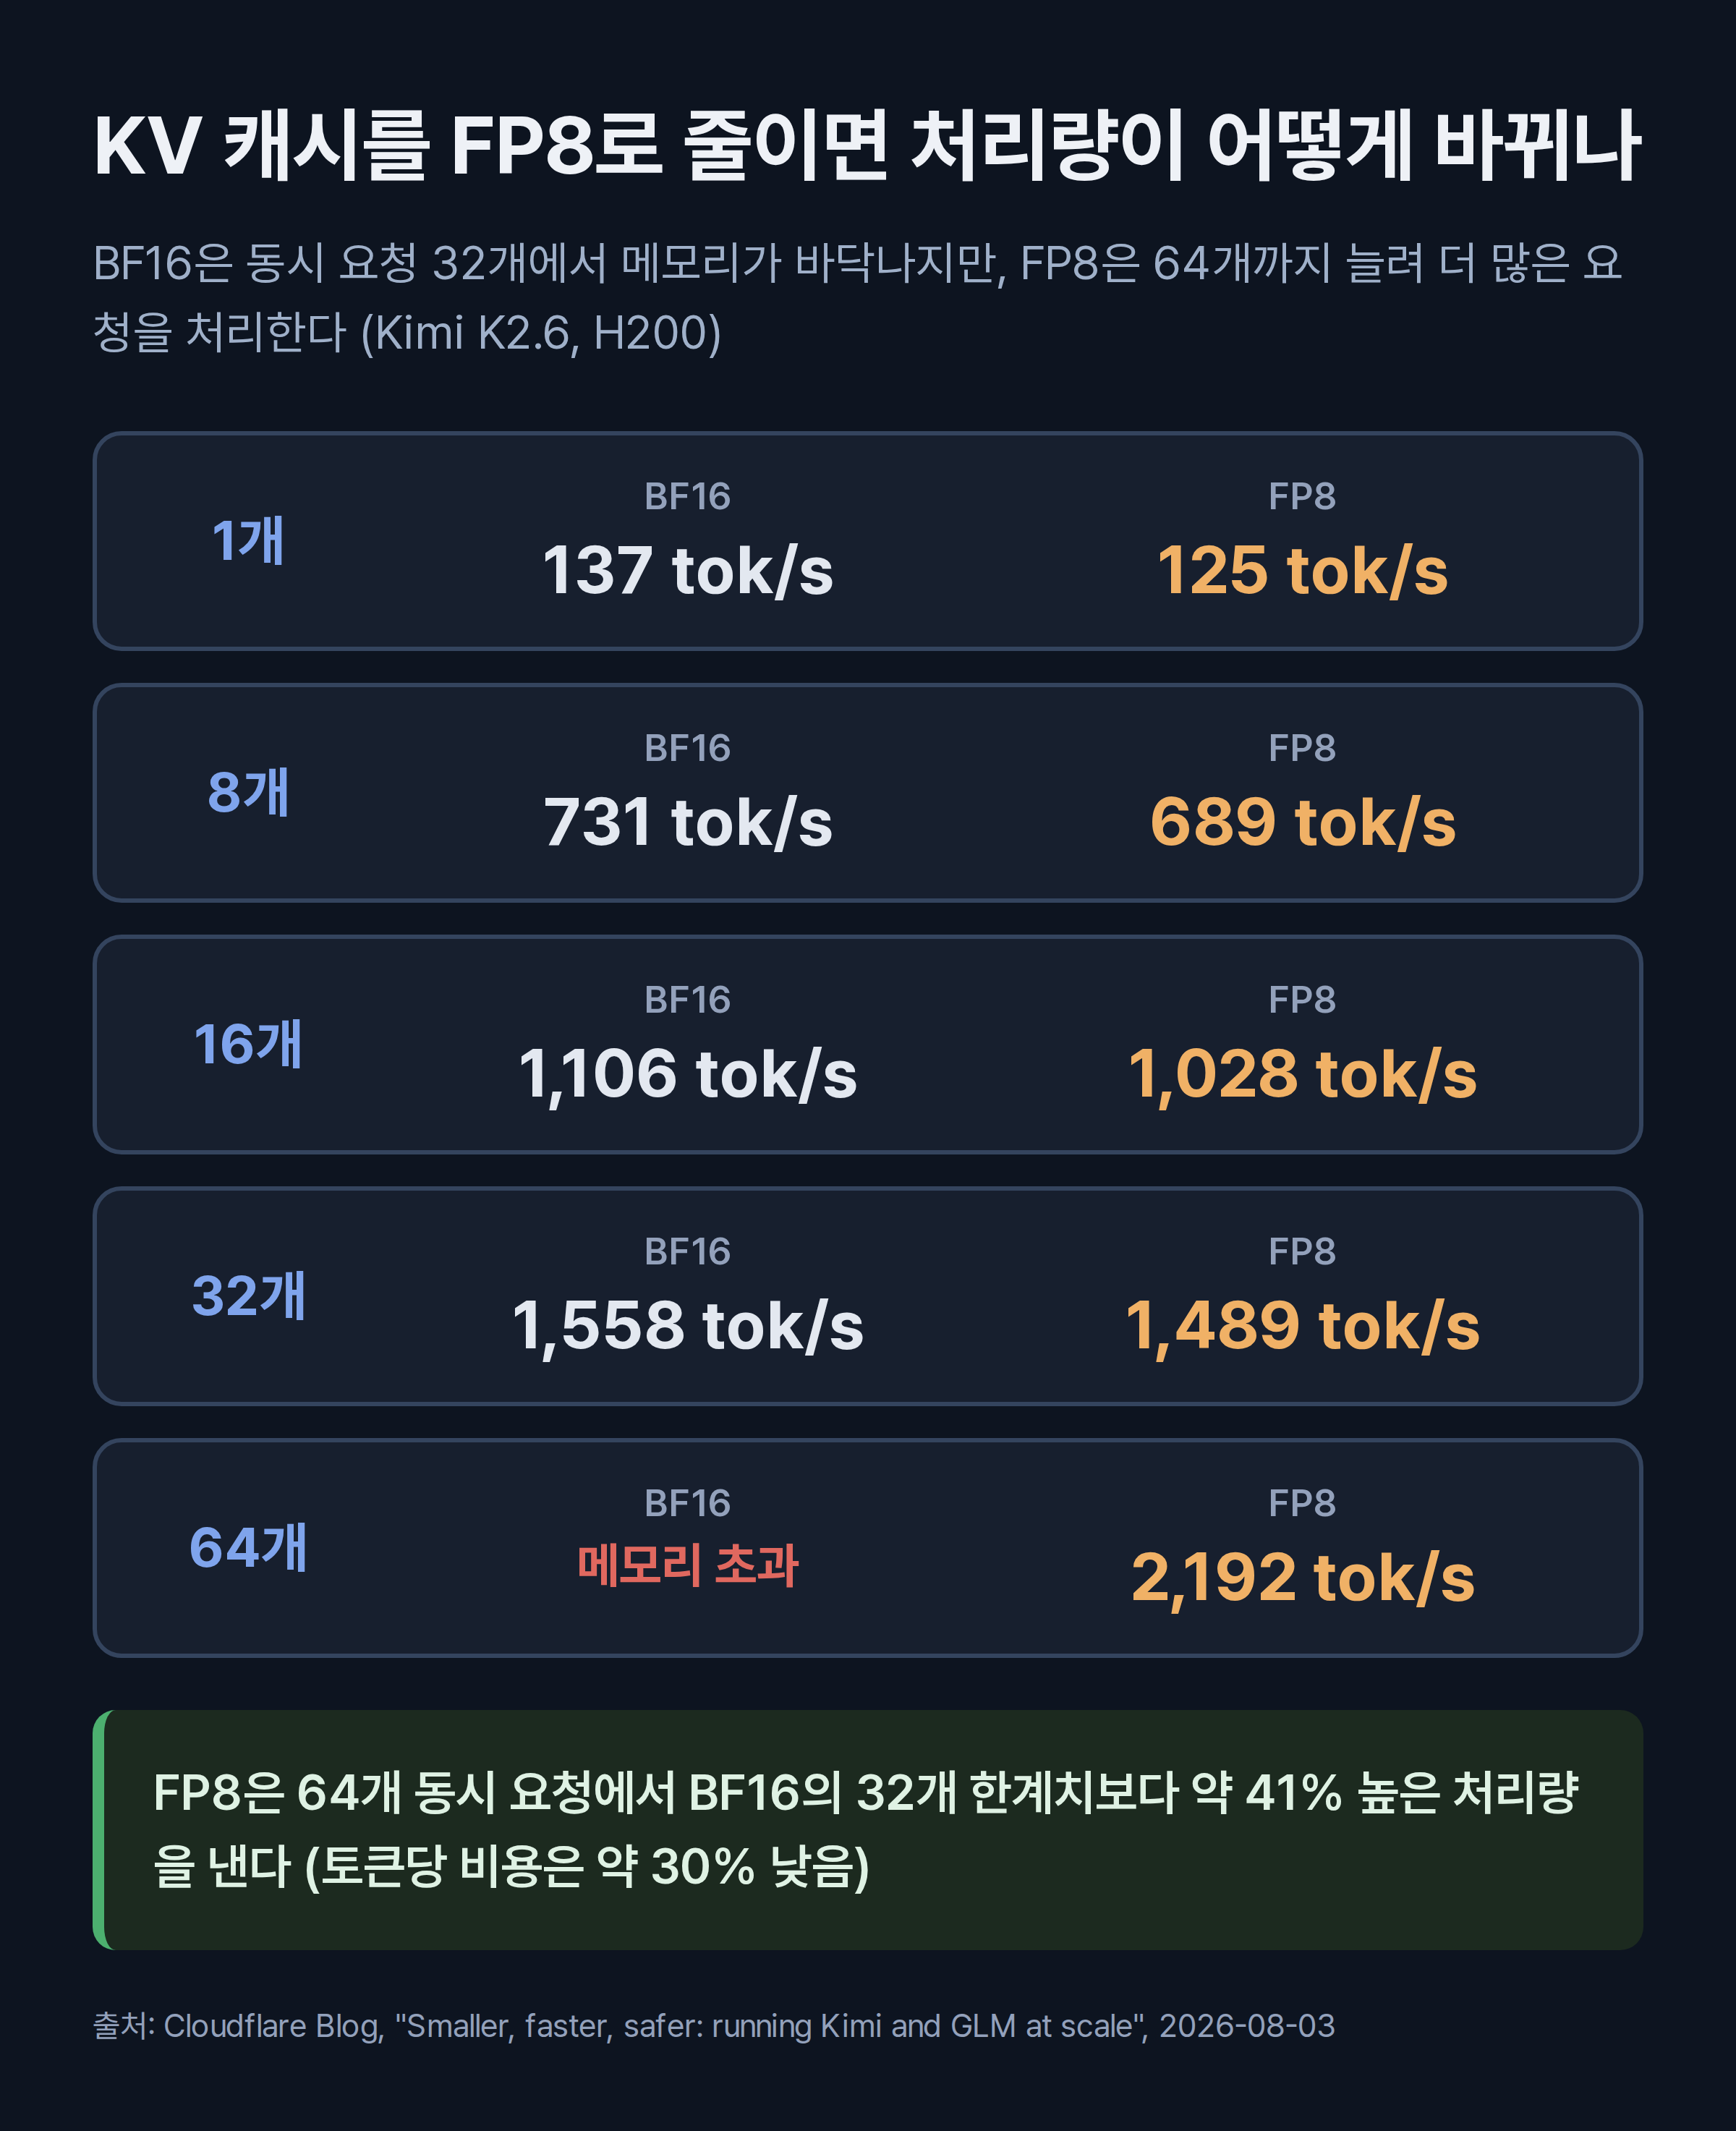
같은 동시 요청 수만 놓고 보면 BF16이 토큰당 몇 퍼센트 더 빠르다. FP8 attention 커널이 값을 읽을 때마다 변환하는 작업이 추가되기 때문이다. 그런데 disaggregated H200 배포에서 Kimi K2.6 디코드를 측정한 결과, BF16은 동시 요청 32개에서 메모리가 바닥나 33번째 요청을 받지 못한 반면 FP8은 64개까지 늘려 초당 2,192토큰을 냈다. 이는 BF16이 32개에서 낸 최고치보다 약 41% 높은 수치이고, 토큰당 비용은 약 30% 낮아진다. 클라우드플레어는 prefill과 decode를 분리된 GPU 풀로 운영하기 때문에 이 이득을 필요한 쪽에만 적용한다. prefill은 메모리가 아니라 연산이 병목이라 여기서는 캐시를 BF16으로 그대로 두고 속도 우위를 유지한다. 정확도도 함께 확인했는데, GSM8K·ARC-Easy·ARC-Challenge·MMLU·MMLU-Pro와 사내 평가셋 mcxams, 툴 호출 유효성까지 FP8과 BF16 사이에 눈에 띄는 차이가 없었다고 밝혔다.
GLM 가중치를 INT4로 압축하면 디코드가 왜 빨라지는가
GPU 메모리를 채우는 또 다른 축은 모델 가중치다. 클라우드플레어는 GLM 5.2의 가중치를 8비트 부동소수점에서 4비트 정수(INT4)로 압축했는데, 정확도 손실 없이 체크포인트 용량이 705GB에서 421GB로 약 40% 줄었고, 8-way 텐서 병렬 배포에서 GPU 한 장당 메모리 사용량이 약 88GB에서 52GB로 내려가 같은 하드웨어에서 약 118만 토큰의 KV 캐시 여유가 추가로 생겼다.
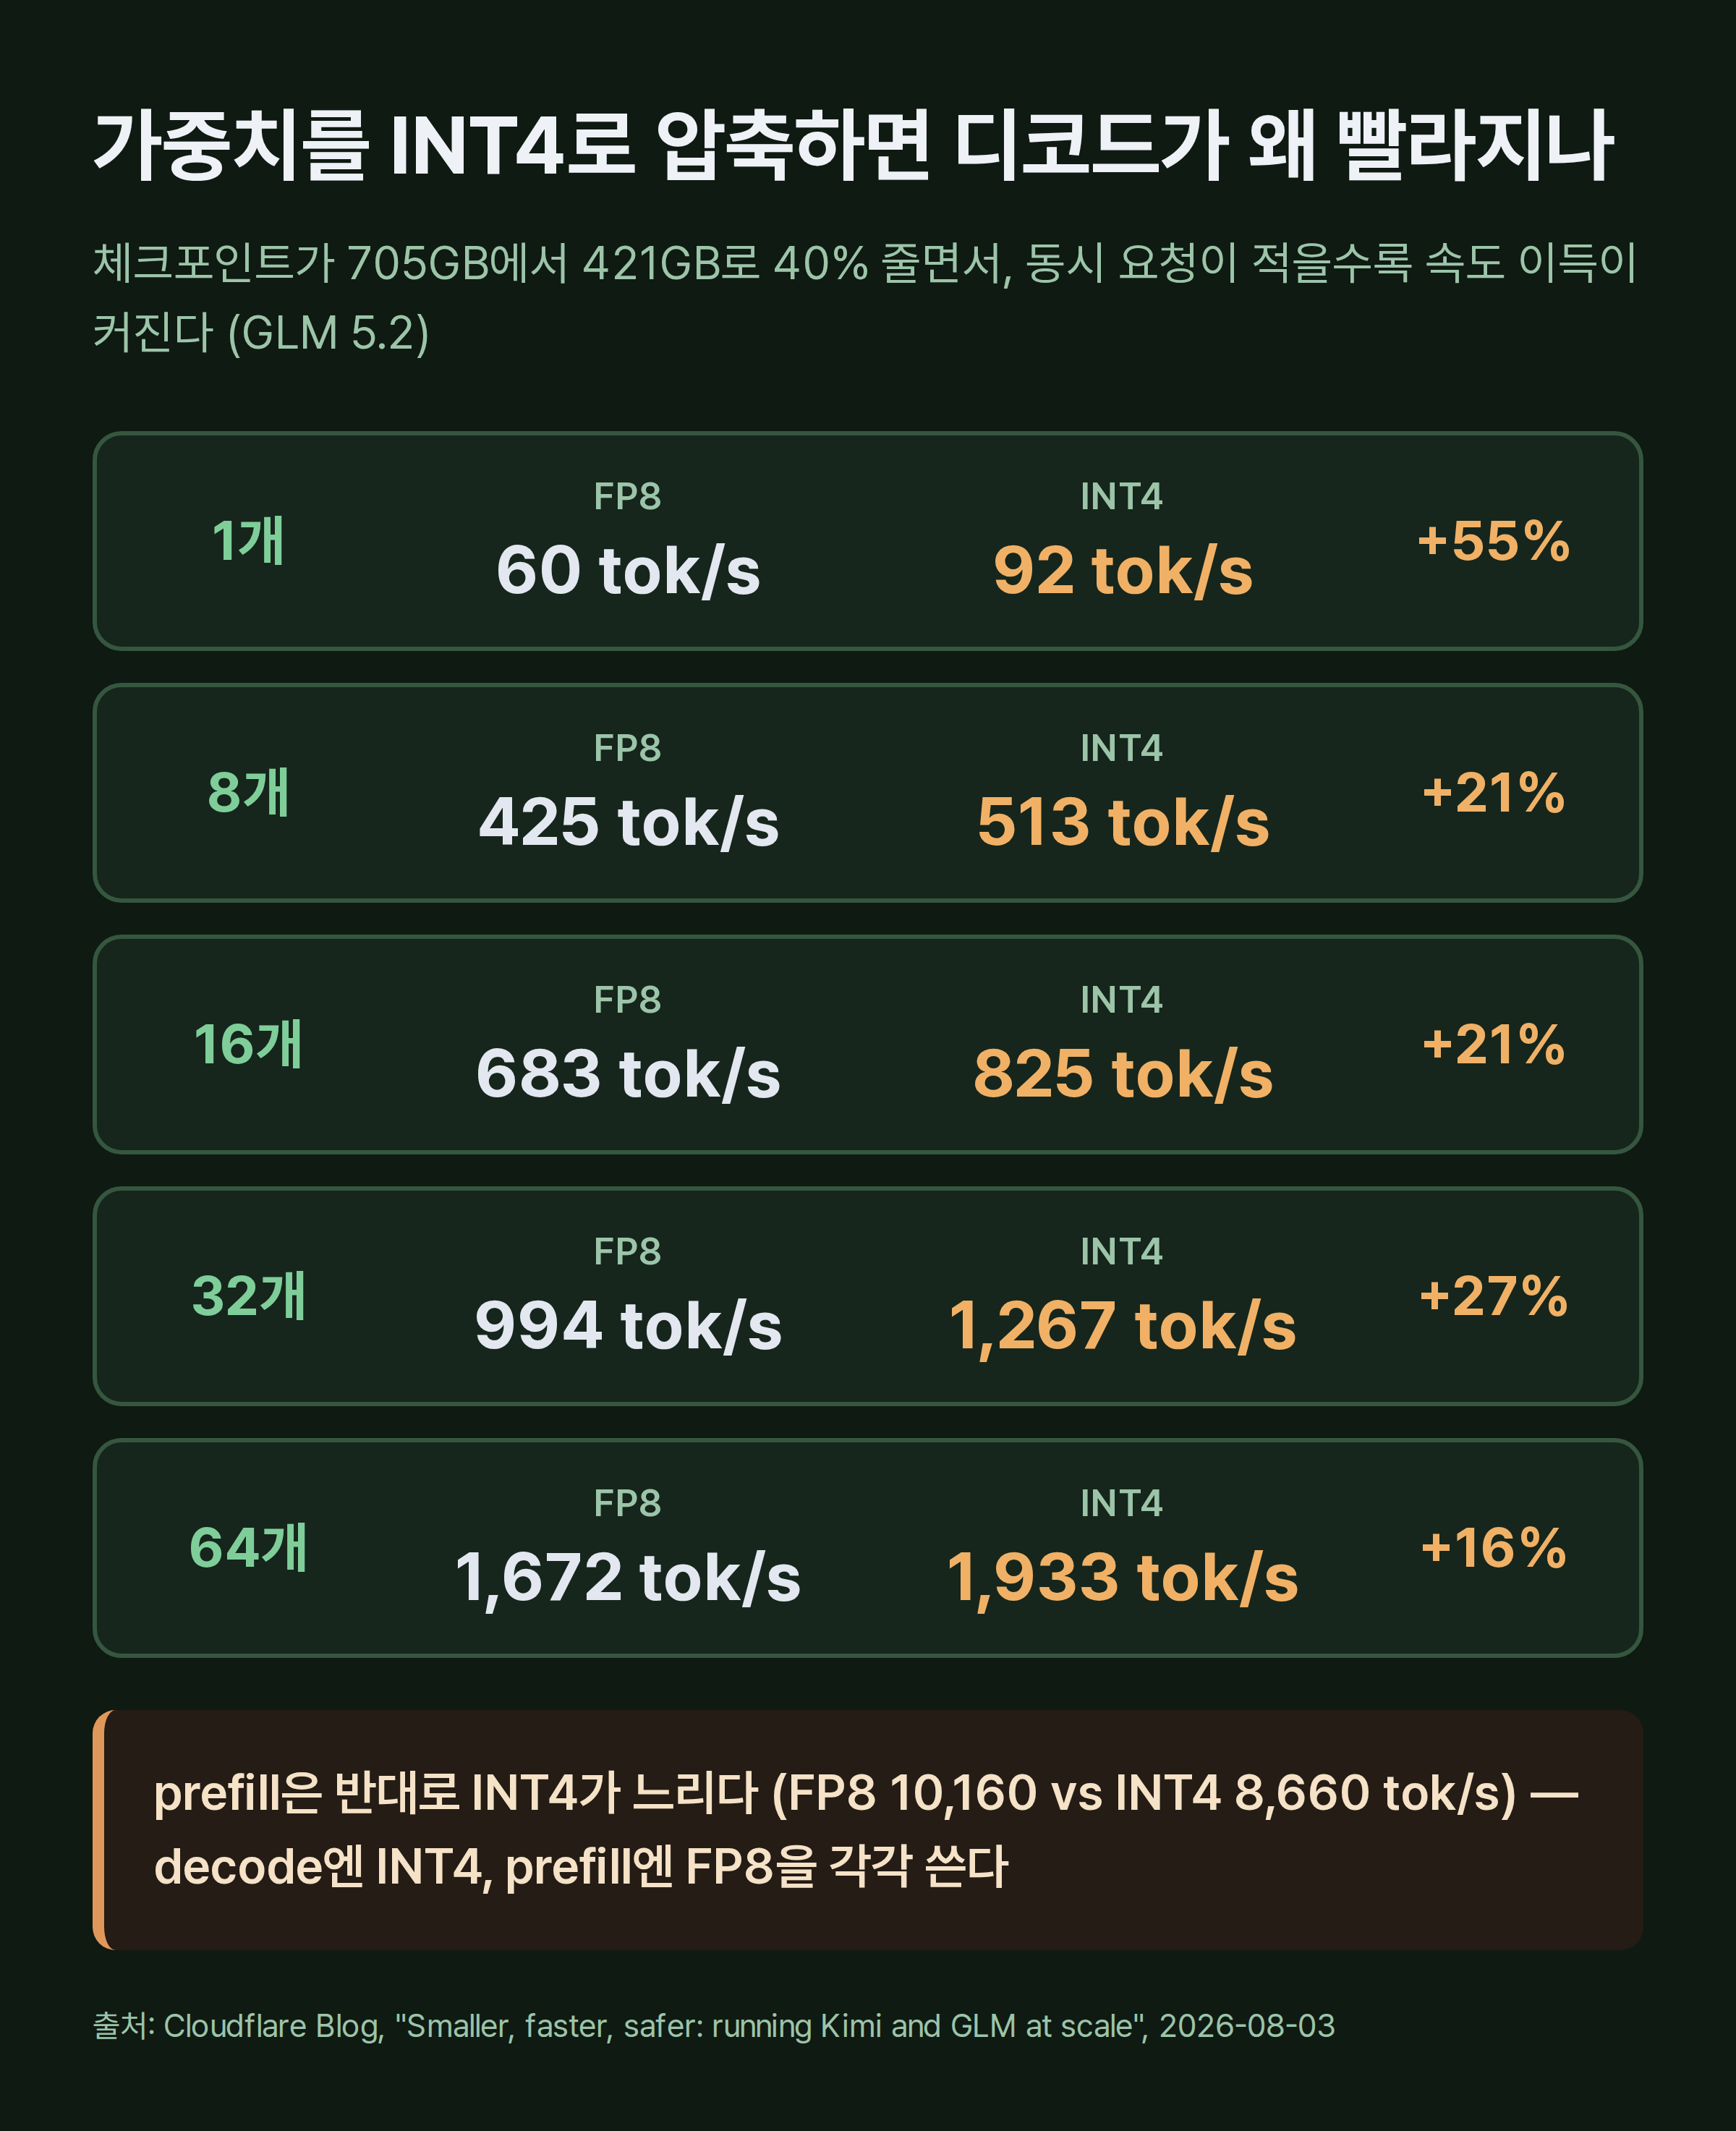
디코드 단계에서 토큰 하나를 만드는 작업은 GPU 메모리에서 가중치를 그만큼 스트리밍해 오는 일과 같아서, 옮기는 데이터가 적을수록 토큰이 더 빨리 도착한다. 그 효과는 요청당 지연이 가장 민감한 낮은 동시성 구간에서 가장 컸는데, 동시 요청 1개에서는 INT4가 FP8보다 초당 60토큰에서 92토큰으로 55% 빨랐고, 8·16·32·64개 구간에서도 16~27% 더 빨랐다. 반대로 prefill은 연산이 병목인 데다 INT4 가중치를 곱하기 전에 다시 펼쳐야 하는 단계가 추가돼 오히려 느려진다. GLM은 prefill에서 FP8일 때 초당 약 1만 160토큰을 내지만 INT4에서는 8,660토큰에 그친다. 여기서도 prefill과 decode를 분리해 둔 구조 덕분에 decode에는 INT4를, prefill에는 FP8을 그대로 쓰는 선택이 가능해졌고, 전체 평가셋에서 INT4 모델의 정확도는 FP8 대비 최대 0.8점 차이 안에 머물러 사실상 구분이 안 된다고 밝혔다.
수백 개 요청이 캐시 한 장을 나눠 쓸 때 안전은 어떻게 지키나
캐시 압축과 가중치 압축 모두 결과적으로 하는 일은 하나다. 더 많은 요청이 GPU 한 대의 메모리를 동시에 나눠 쓰게 만드는 것이다. 그 자체는 효율의 핵심이지만, 이는 곧 수백 개 요청이 같은 물리 KV 캐시의 페이지를 동시에 읽고 쓴다는 뜻이기도 하다. 페이지 단위 attention, 연속 배칭, 캐시 재사용처럼 이걸 빠르게 만드는 장치들은 모두 내부 장부 정리가 정확해야 하는데, 클라우드플레어 수준의 요청량에서는 10억분의 1 확률의 실수도 주기적으로 나타날 수 있다고 설명한다.
그래서 물리 캐시 페이지마다 재할당될 때 바뀌는 태그를 붙이고, 서버가 각 요청이 어떤 페이지·태그를 쓸 것으로 기대하는지 기록해 뒀다가, 디코드가 캐시를 읽기 전에 이 매핑을 대조하는 무결성 검사 계층을 만들었다. 매핑이 어긋나면 잘못된 페이지의 데이터를 반환하는 대신 해당 요청을 중단시킨다.
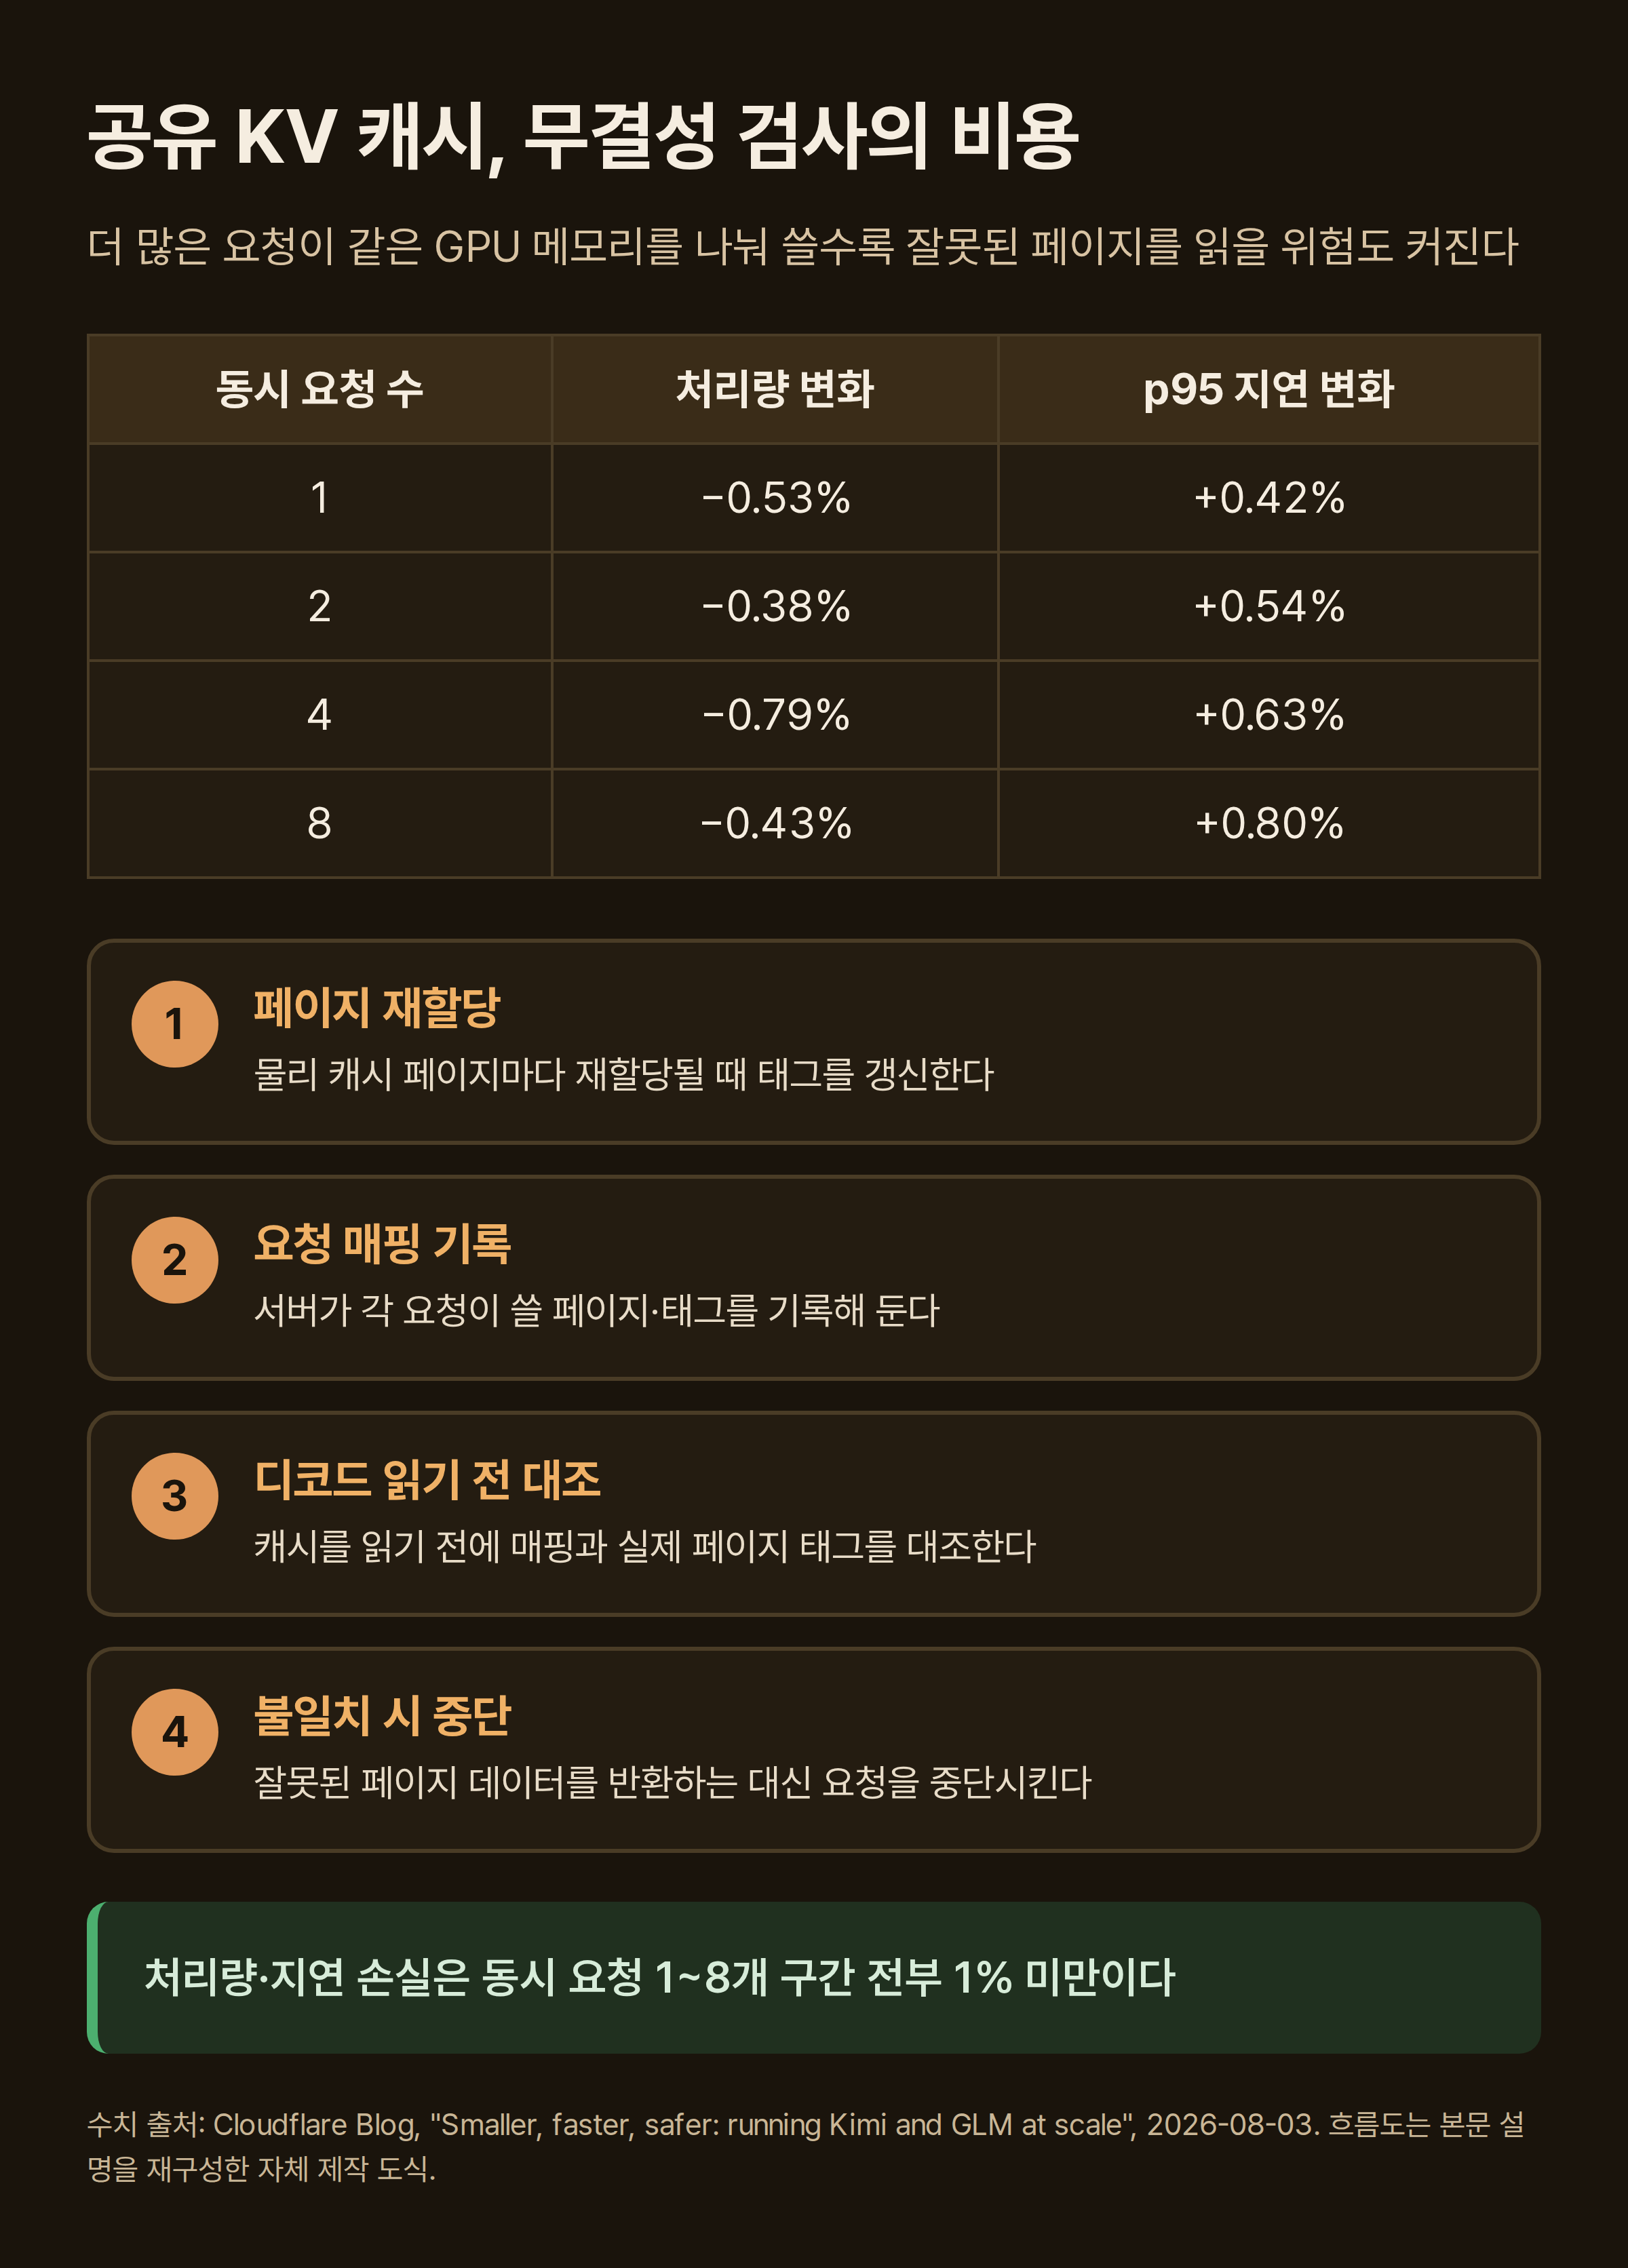
안전장치를 넣을지 말지는 결국 비용 문제인데, 8,192토큰 입력·1,000토큰 출력, prefill 2대·decode 2대 구성의 중형 프로덕션 모델로 측정한 결과 처리량 손실은 동시 요청 1·2·4·8개 전 구간에서 1% 미만이었고 p95 지연 증가도 1% 미만이었다. 이 검사를 attention 커널 안에 합치지 않고 별도 배치 단계로 분리해 GPU 스레드 그룹 사이의 경합을 피했고, 배포 단위로 켜고 끌 수 있으며 기본 경로는 오버헤드가 없는 무동작(no-op) 트래커를 쓴다고 밝혔다.
클라우드플레어는 FP8 KV 캐시를 전체 인프라로 확장하고, NVIDIA의 최신 GPU 아키텍처인 Blackwell에서 NVFP4 가중치를 검증하며, 무결성 검사를 어디서나 거의 비용 없이 켜 둘 수 있도록 만드는 작업을 다음 단계로 이어가고 있다고 밝혔다.
출처: Cloudflare Blog, "Smaller, faster, safer: running Kimi and GLM at scale"