
엔비디아가 2026년 7월 공개한 45쪽짜리 Vera CPU 백서는 자사 Olympus 코어 기반 첫 서버 CPU를 AI 서버의 해답으로 내세운다. 88코어 단일 컴퓨트 다이, 코어당 2MB L2, 164MB 시스템 수준 캐시, 8개 LPDDR5X 인터페이스와 최대 1.2TB/s 대역폭은 서버 CPU로서 분명 눈에 띄는 구성이다. 8월 6일 Chips and Cheese가 이 백서를 해부한 이유도 칩의 존재감이 약해서가 아니라, 성능 근거가 실제 병목을 얼마나 정확히 가리키는지가 별개 문제이기 때문이다.
AI 서버를 고를 때 CPU의 IPC 막대 하나나 코어당 점수 하나는 전체 시스템의 처리량을 설명하지 못한다. 모델 추론은 가속기와 HBM, 도구 실행은 CPU·메모리·스토리지, 에이전트 작업은 네트워크·큐·스케줄러를 함께 지난다. CPU가 강하다는 결론과 특정 백서의 비교 방식이 그 강점을 증명한다는 결론을 분리해야, 다음 서버 세대에서 돈과 전력을 어디에 써야 하는지 판단할 수 있다.
Vera의 설계는 무엇을 빠르게 만들려 하나
원문이 정리한 Olympus는 사이클당 명령어 10개를 디코드하는 Arm v9.2 비순차 실행 코어다. 값 예측은 긴 지연 연산의 결과를 맞히면 그 결과에 의존한 명령을 먼저 진행시키는 방식이고, 그래프 프리페처는 포인터를 따라가는 데이터 접근에서 다음 주소를 미리 가져오려는 장치다. 88개 코어 뒤에는 3.4TB/s 일관성 패브릭과 분산된 164MB 캐시가 놓인다. 코드 해석, 컴파일, 데이터 전처리처럼 분기와 메모리 의존성이 많은 CPU 구간을 겨냥한 설계로 읽힌다.
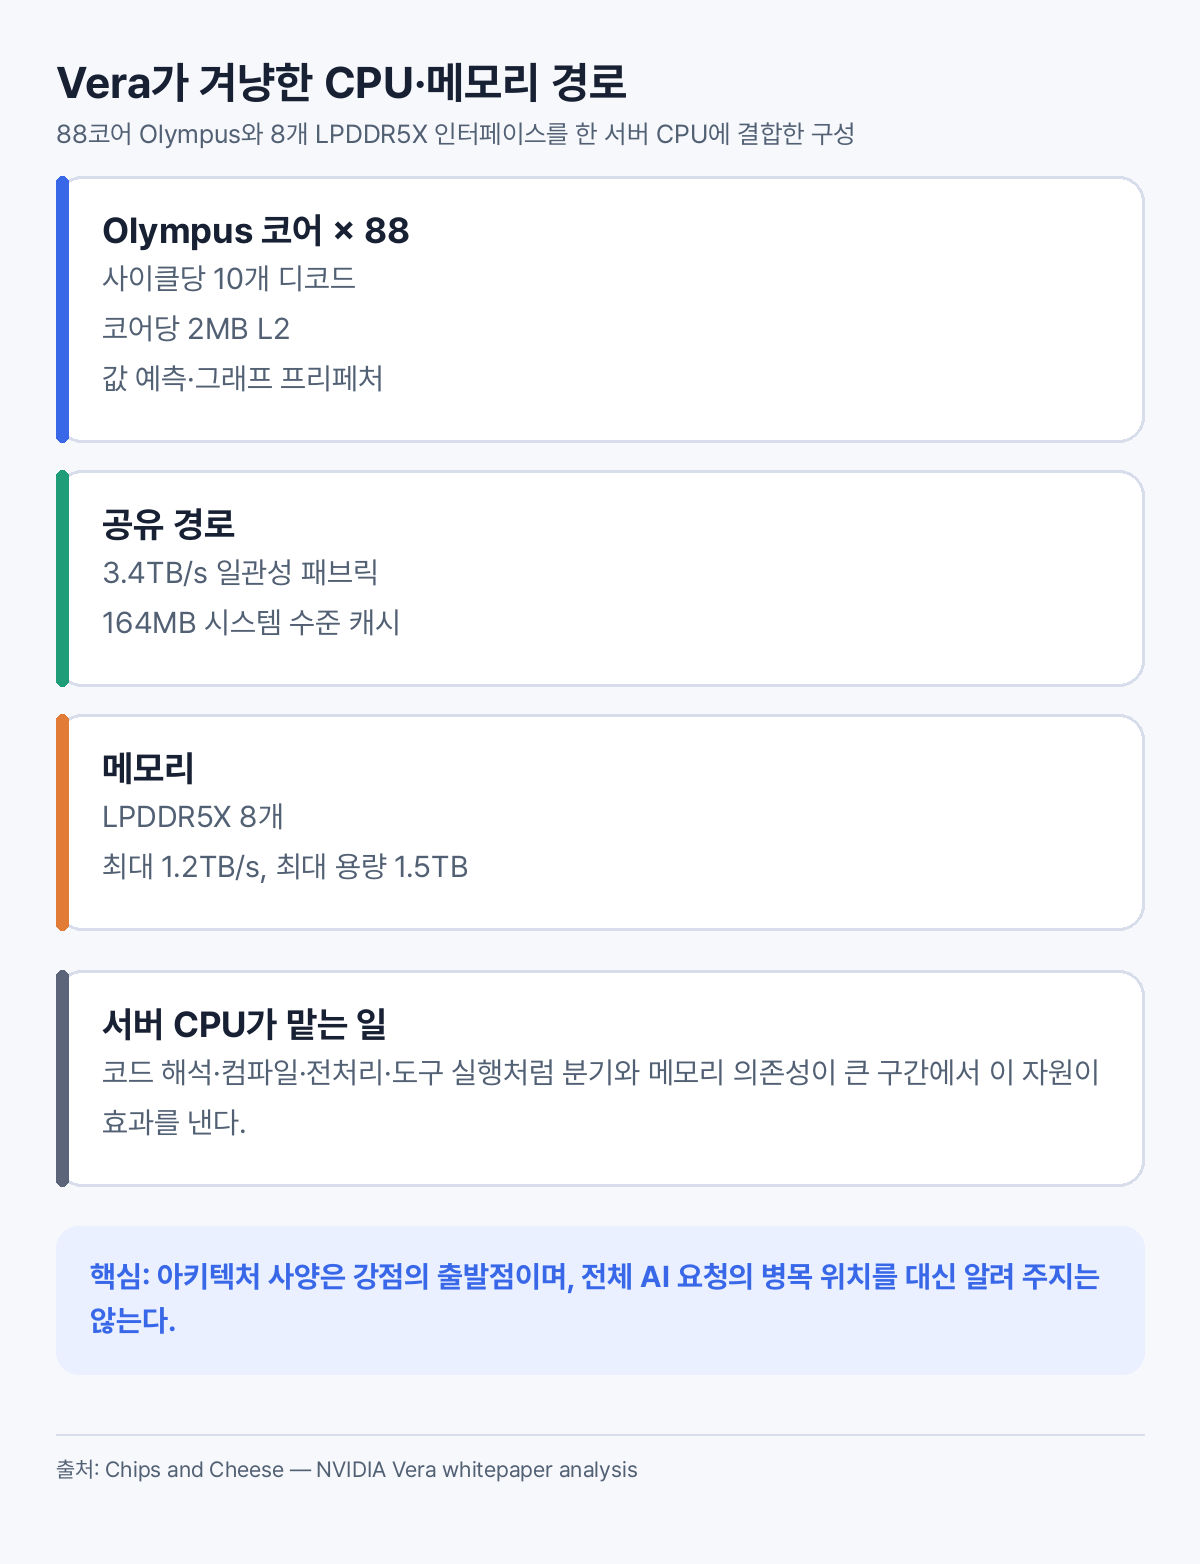
이 구성에서 중요한 것은 ‘Arm 대 x86’이라는 구호보다 자원 배분 방식이다. Vera는 두 하드웨어 스레드 사이의 자원을 나눠 지연시간과 처리량을 일정하게 유지하는 Spatial Multithreading을 강조한다. 원문은 일반 SMT가 매 사이클 스레드를 선택하거나 두 스레드의 마이크로 연산을 함께 실행해 놀고 있는 실행 자원을 활용할 수 있다고 지적한다. Vera의 분할 방식은 간섭을 줄여 서비스 품질을 예측하기 쉽게 만들 수 있지만, 곧바로 평균 처리량이 더 높다는 뜻은 아니다. CPU 병목의 모양은 동시 작업의 꼬리 지연시간인지, 단일 작업의 최대 처리량인지에 따라 달라진다.
1.8배와 3%는 서로 다른 질문에 답한다
백서는 CPython, GCC, LLVM, Cppcheck의 SPEC CPU 2026 구성 요소 네 개를 ‘에이전틱’ 벤치마크로 묶고, 물리 코어당 정규화한 수치에서 Vera가 1.7~1.8배 앞선다고 제시한다. 이 프로그램들은 코드 중심 에이전트가 도구를 호출할 때 실제로 만날 수 있는 인터프리터·컴파일러·정적 분석기다. 다만 모델이 토큰을 생성하고, 런타임이 도구를 고르고, 샌드박스가 입출력을 기다리며, 결과를 평가해 다음 행동으로 되먹이는 전체 루프는 아니다.
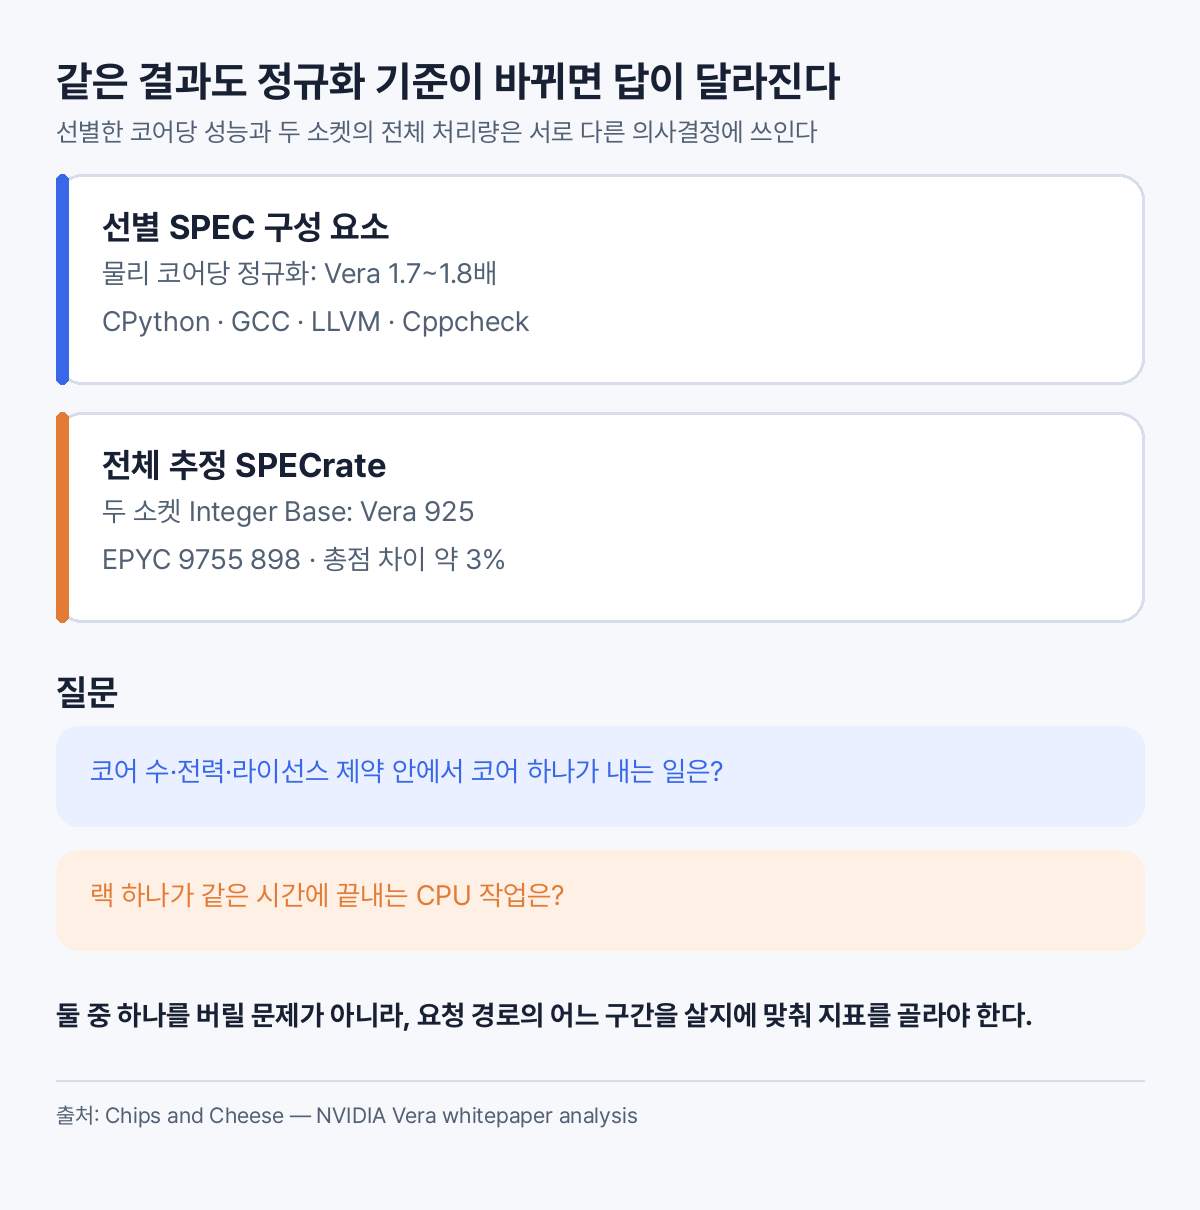
원문이 백서의 구성 페이지를 대조해 든 전체 추정 SPECrate 2026 Integer Base 총점은 두 Vera 소켓 925, 두 EPYC 9755 소켓 898이다. 시스템 전체 처리량 차이는 약 3%다. 반면 Vera는 두 소켓에 물리 코어 176개, EPYC 구성은 256개이므로 코어당 성능을 나누면 Vera의 우위가 커진다. 전자는 랙 하나가 같은 시간에 끝내는 CPU 작업을, 후자는 소프트웨어 라이선스·전력·코어 수 제약 아래 각 코어가 내는 일을 묻는다. 1.8배라는 막대가 틀렸다는 얘기가 아니라, 그 막대만으로 에이전트 서버 전체가 1.8배 빨라진다고 읽을 수 없다는 뜻이다.
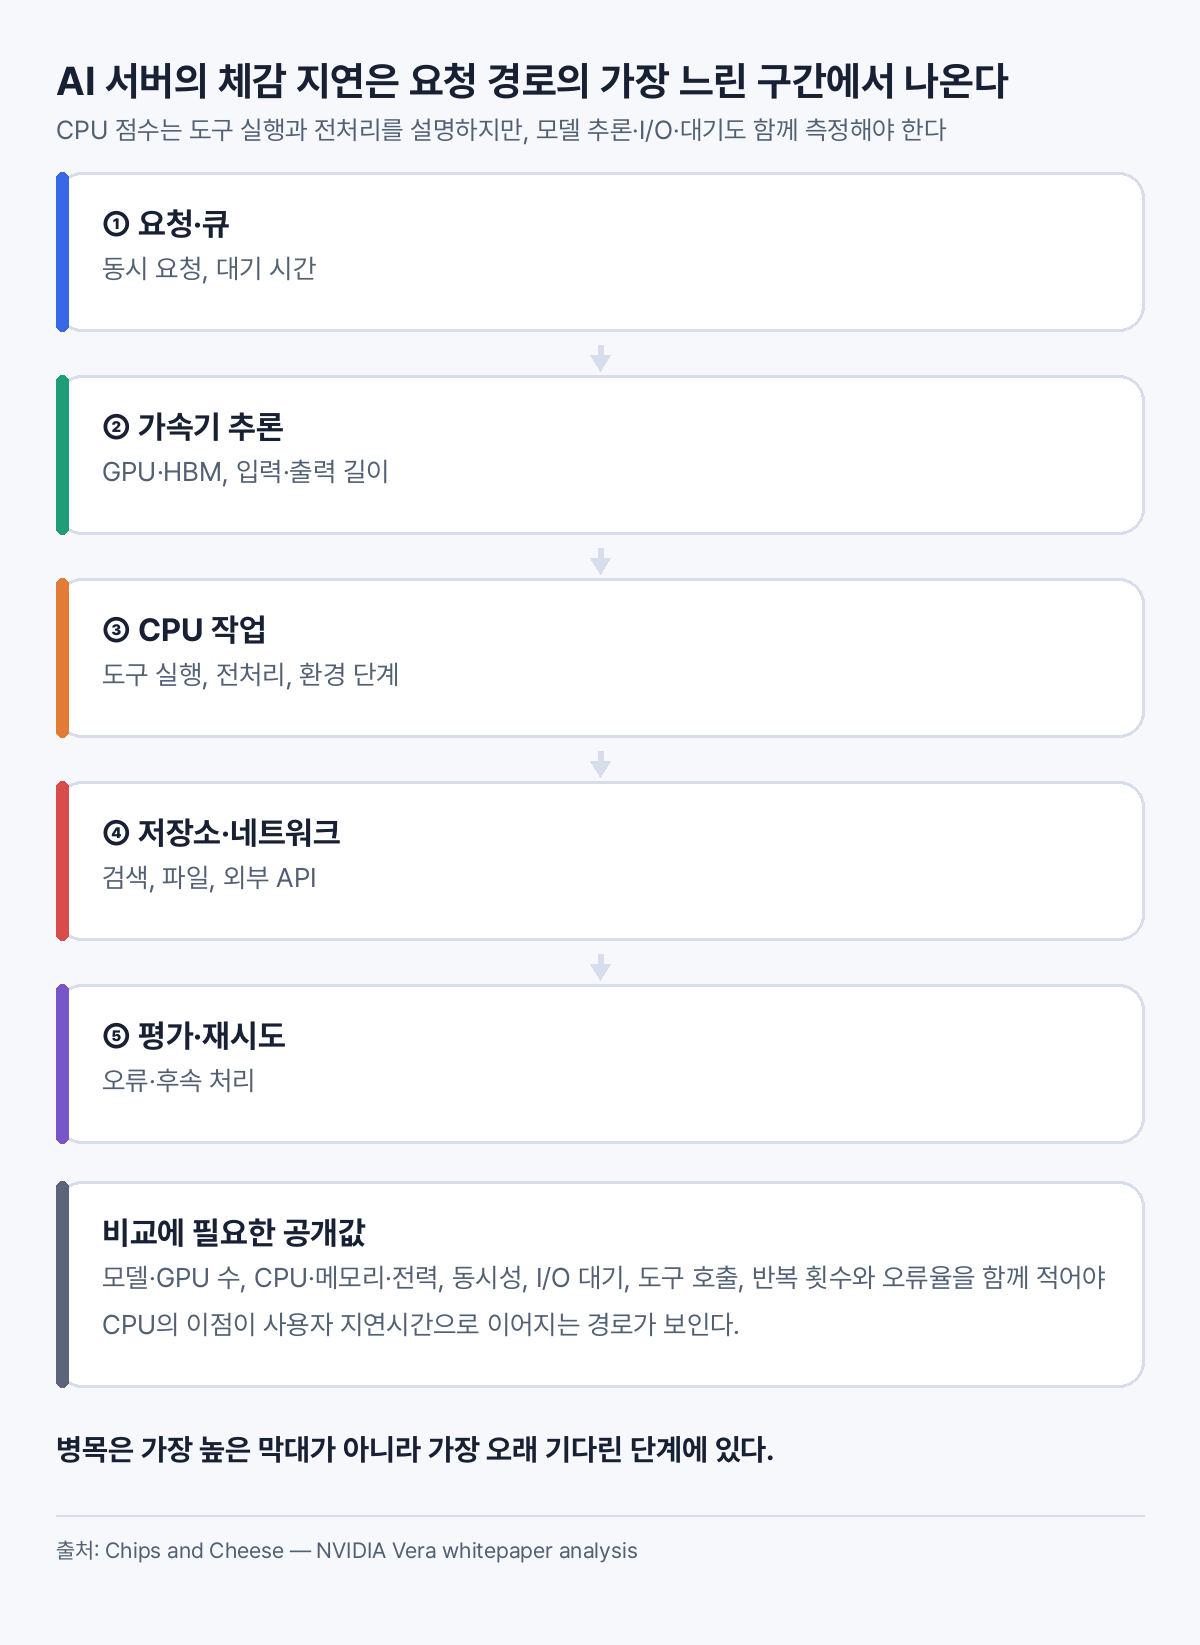
이 차이는 AI 서버에서 더 커진다. GPU가 모델 추론 시간을 지배하는 서비스라면 CPU의 높은 코어당 성능은 토크나이저, 요청 조립, 검색, 도구 실행, 환경 시뮬레이션이 병목일 때 가장 값진다. 반대로 CPU들이 대기하는 배포라면 CPU 교체보다 가속기 메모리, 인터커넥트, 스토리지 I/O, 배치 정책을 먼저 손봐야 한다. ‘에이전틱’이라는 이름이 이 병목 분해를 생략하게 만들면, 벤치마크는 제품의 사용 장면보다 마케팅의 사용 장면에 가까워진다.
메모리 대역폭 우위의 원인은 인터페이스 수다
메모리 그래프도 같은 방식으로 읽어야 한다. 백서의 로드 지연시간 그래프에서 Vera는 약 1.1TB/s, EPYC 9755는 약 400GB/s 부근으로 보인다. Chips and Cheese는 같은 Turin 세대의 12채널 DDR5-6400에서 약 570GB/s를 얻었다고 제시했고, 이 수치로 계산하면 Vera의 전체 대역폭 우위는 약 1.9배다. Vera의 1.2TB/s 이론치 대비 약 1.1TB/s, Turin의 614GB/s 이론치 대비 약 570GB/s라는 비교에서는 두 플랫폼 모두 이론 대역폭의 90%대 초반을 활용한다는 해석이 나온다.
따라서 Vera의 장점은 단일 다이라는 표현보다 8개 LPDDR5X 인터페이스로 제공하는 높은 대역폭과 상대적으로 적은 코어가 그 대역폭을 나눠 쓴다는 데서 먼저 찾는 편이 정확하다. 메모리 집약적 전처리나 그래프 분석에는 이 차이가 실질적일 수 있다. 동시에 메모리 용량, 교체 가능한 DIMM, 서버 구성의 유연성이 더 중요한 환경에서는 EPYC·Xeon 플랫폼의 선택지가 다른 답을 낸다.
AI 서버 벤치마크는 요청 경로를 끝까지 밝혀야 한다
좋은 AI 서버 비교는 ‘CPU가 빠르다’는 결론을 버리지 않는다. 대신 그 결론이 어느 요청 구간에 적용되는지 공개한다. 모델·GPU 수·CPU 코어와 주파수·메모리 구성·전력, 동시 요청 수, 입력과 출력 길이, 도구 호출과 I/O 대기, 재시도와 오류율을 함께 적으면 CPU 성능이 사용자 체감으로 이어지는 경로를 계산할 수 있다. PageRank 같은 그래프 작업이라면 입력 그래프와 실행 변수, RL 학습이라면 모델·환경·CPU/GPU 배분·반복 횟수·오차 범위가 있어야 다른 시스템에서도 결과를 재현할 수 있다.
Vera는 독립 초기 시험에서 강한 Arm 서버 CPU라는 신호를 이미 보였다. 원문이 인용한 Phoronix의 NVIDIA 허용 시험 범위에서 Vera의 기하평균은 5GHz EPYC 9575F보다 10% 높고 Xeon 6980P보다 1.55배 높았다. 다음 비교가 설득력을 얻으려면 이 신호를 넓은 실제 워크로드와 전력·주파수·SMT 설정까지 공개한 측정으로 이어가면 된다. 백서의 빈틈은 Vera가 느리다는 증거가 아니라, AI 서버의 병목을 CPU 아키텍처·메모리·가속기·운영 경로로 나눠 보여 주지 않으면 좋은 칩도 정확히 평가받기 어렵다는 사례다.