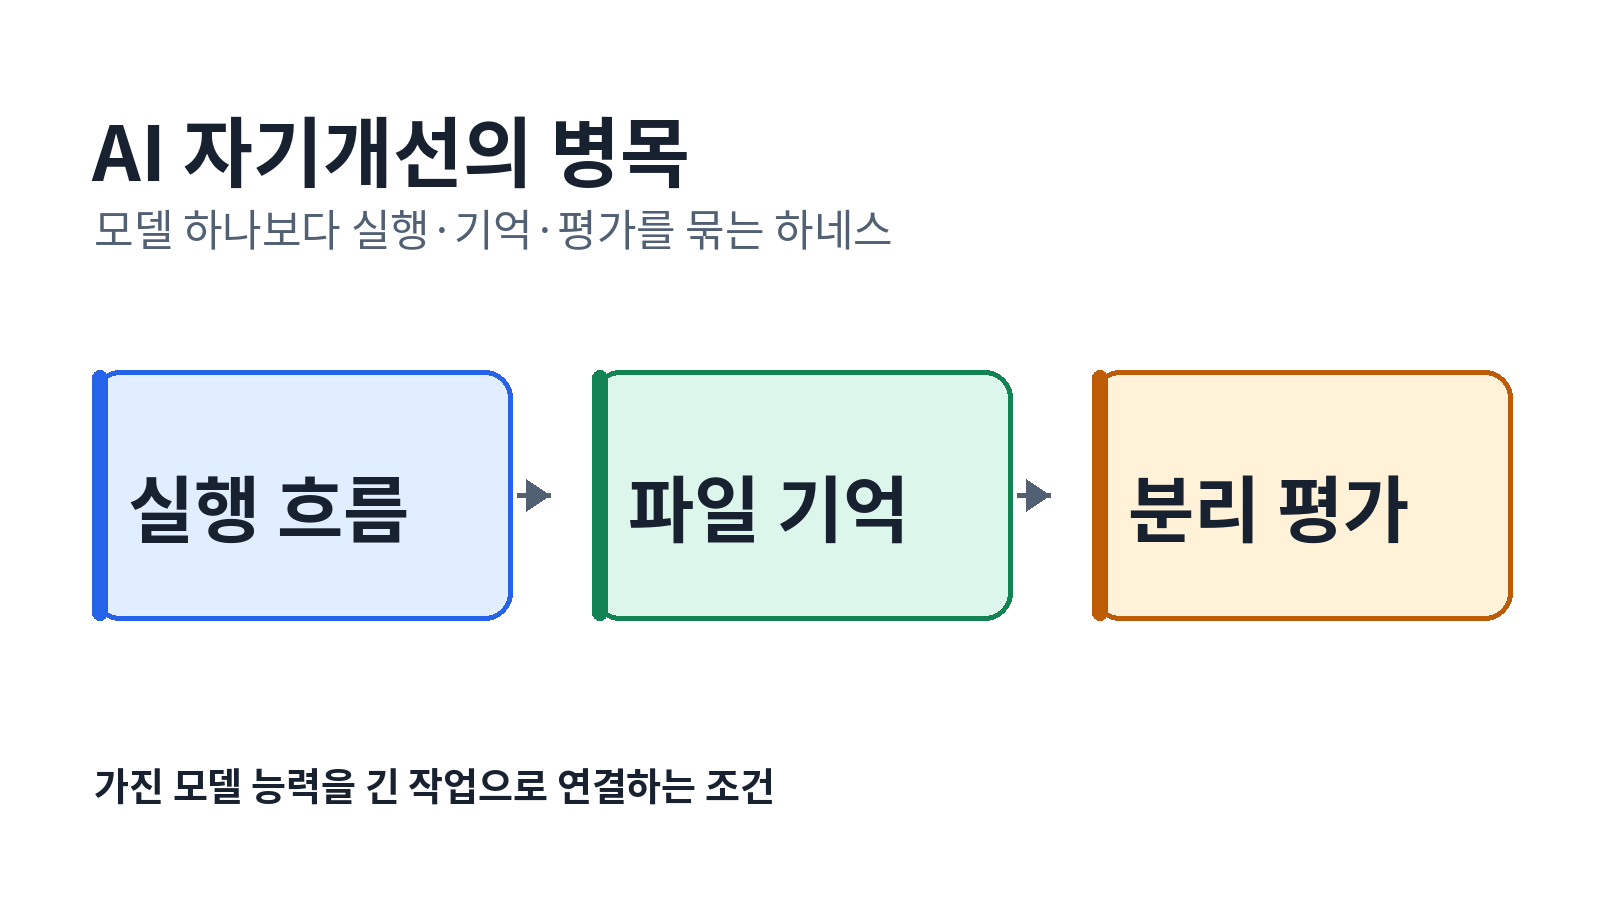
AI 자기개선의 병목은 모델이 아니라 하네스에 있다
AI 자기개선의 가까운 병목은 모델 가중치보다 실행·기억·평가를 조율하는 하네스에 있습니다. 실패 기록과 분리된 검증이 왜 핵심인지 정리했습니다.
 유토모 테크로그새 기술과 제품 이야기
주제
AI 모델 관련 글을 모았습니다. 유토모 테크로그에서 새 기술과 제품이 일과 제품에 만드는 변화를 살펴봅니다.
AI 자기개선의 가까운 병목은 모델 가중치보다 실행·기억·평가를 조율하는 하네스에 있습니다. 실패 기록과 분리된 검증이 왜 핵심인지 정리했습니다.
취미 프로그래밍 공동체가 LLM 생성 결과물에 반발하는 이유를, 결과보다 이해와 신뢰 축적을 중시하는 문화에서 풀어냈습니다.
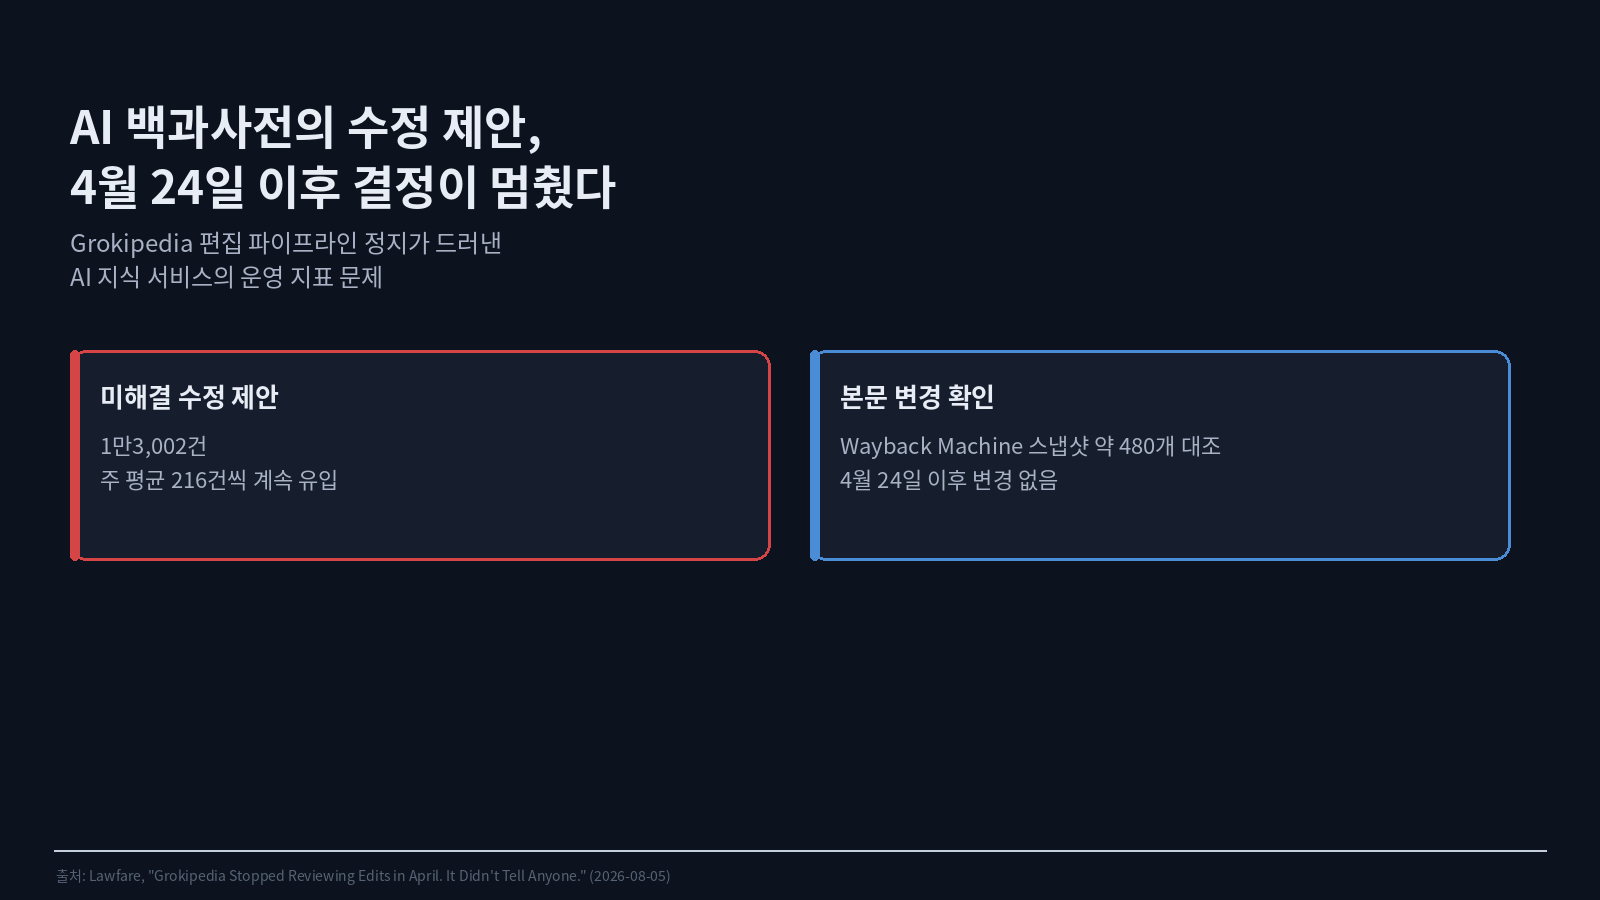
Grokipedia의 공개 편집 파이프라인이 4월 말부터 멈춘 정황이 분석으로 드러났습니다. AI 지식 서비스가 갱신·결정·이력 기록을 함께 운영해야 하는 이유를 짚습니다.
생성형 AI가 개발을 빠르게 만드는 것은 사실이지만, 코드 생성 속도만으로 팀의 전달 속도와 품질을 판단할 수는 없습니다. ACM Queue가 짚은 여덟 통념으로 병목·측정·도입 조건을 다시 봅니다.
프란시스 베이컨의 네 가지 우상으로 AI 사용자의 판단 오류를 다시 읽습니다. 의인화, 개인 경험의 과잉 일반화, 용어의 착시, 그럴듯한 답변에 대한 맹신을 피하는 네 가지 질문을 정리했습니다.
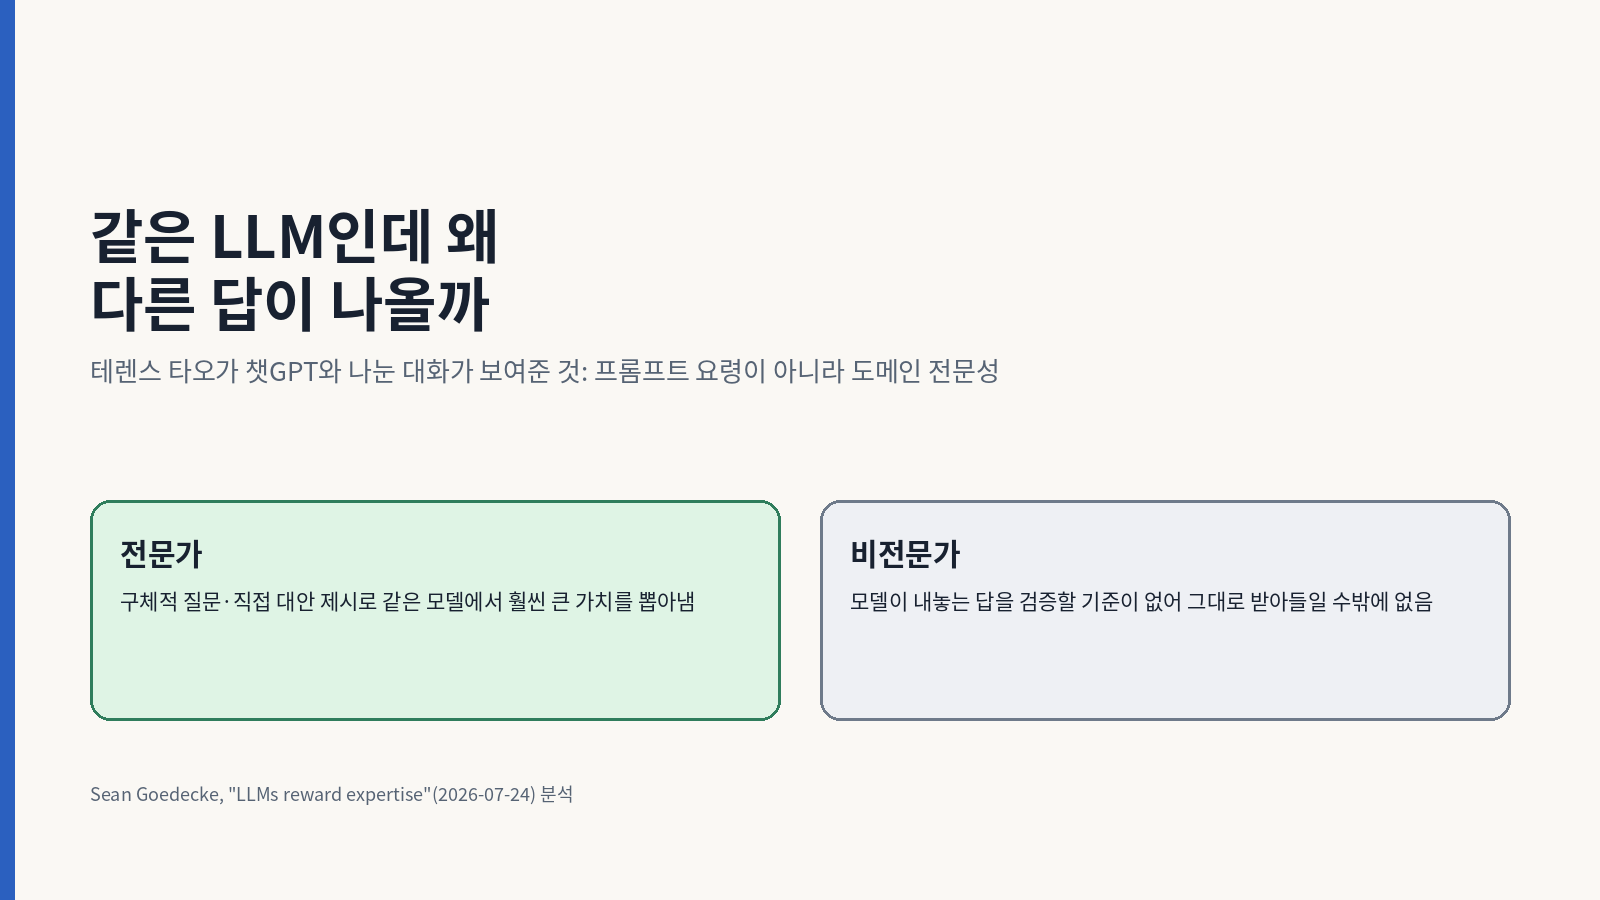
테렌스 타오가 챗GPT와 나눈 대화를 근거로, LLM 프롬프팅의 핵심 기술은 요령이 아니라 그 분야에 대한 실제 전문성이라는 주장을 정리했습니다.
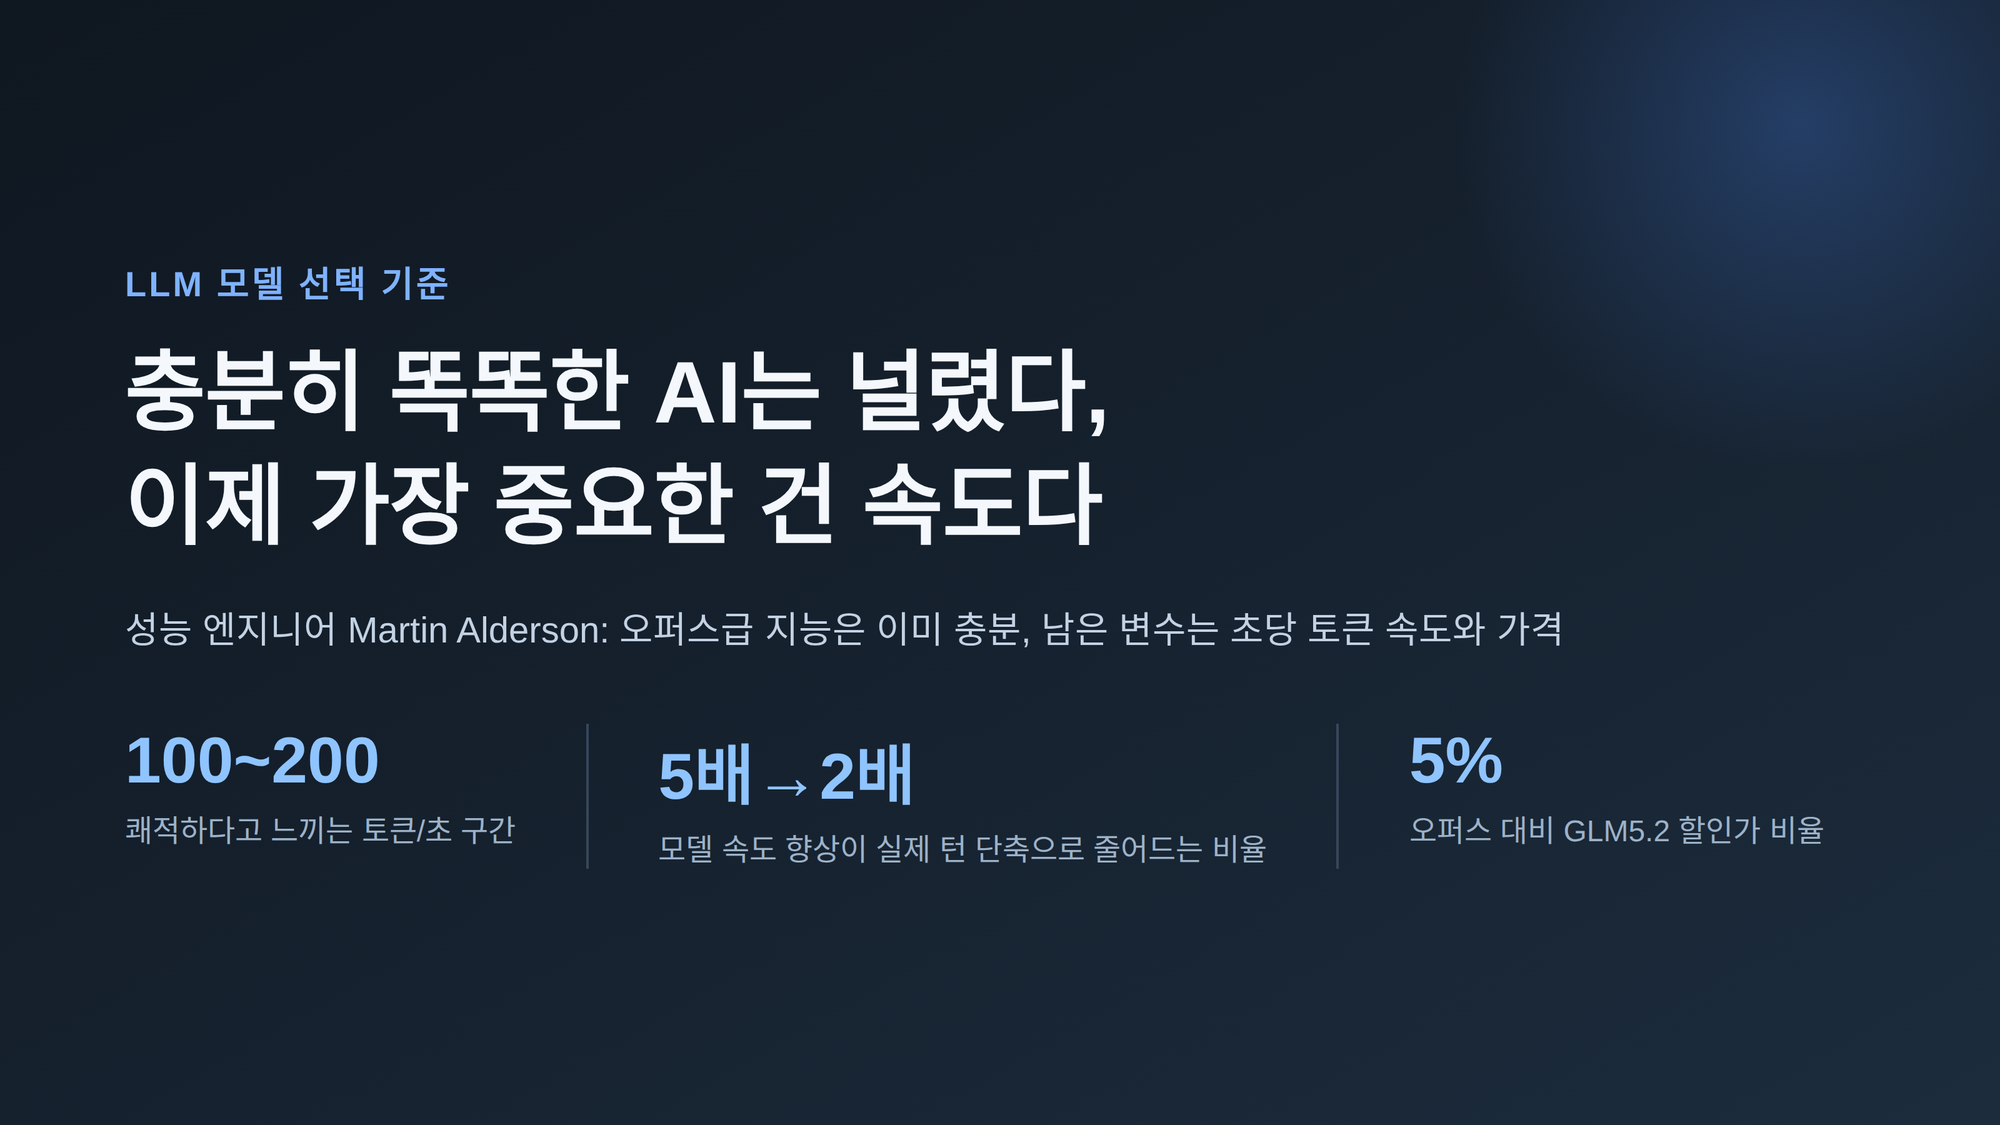
속도 최적화 엔지니어 마틴 알더슨이 처음으로 모델을 지능이 아니라 속도로 고르고 있다며, 초당 토큰 수 체감 기준과 5배 빨라져도 에이전트 턴은 2배만 빨라지는 이유를 정리했습니다.
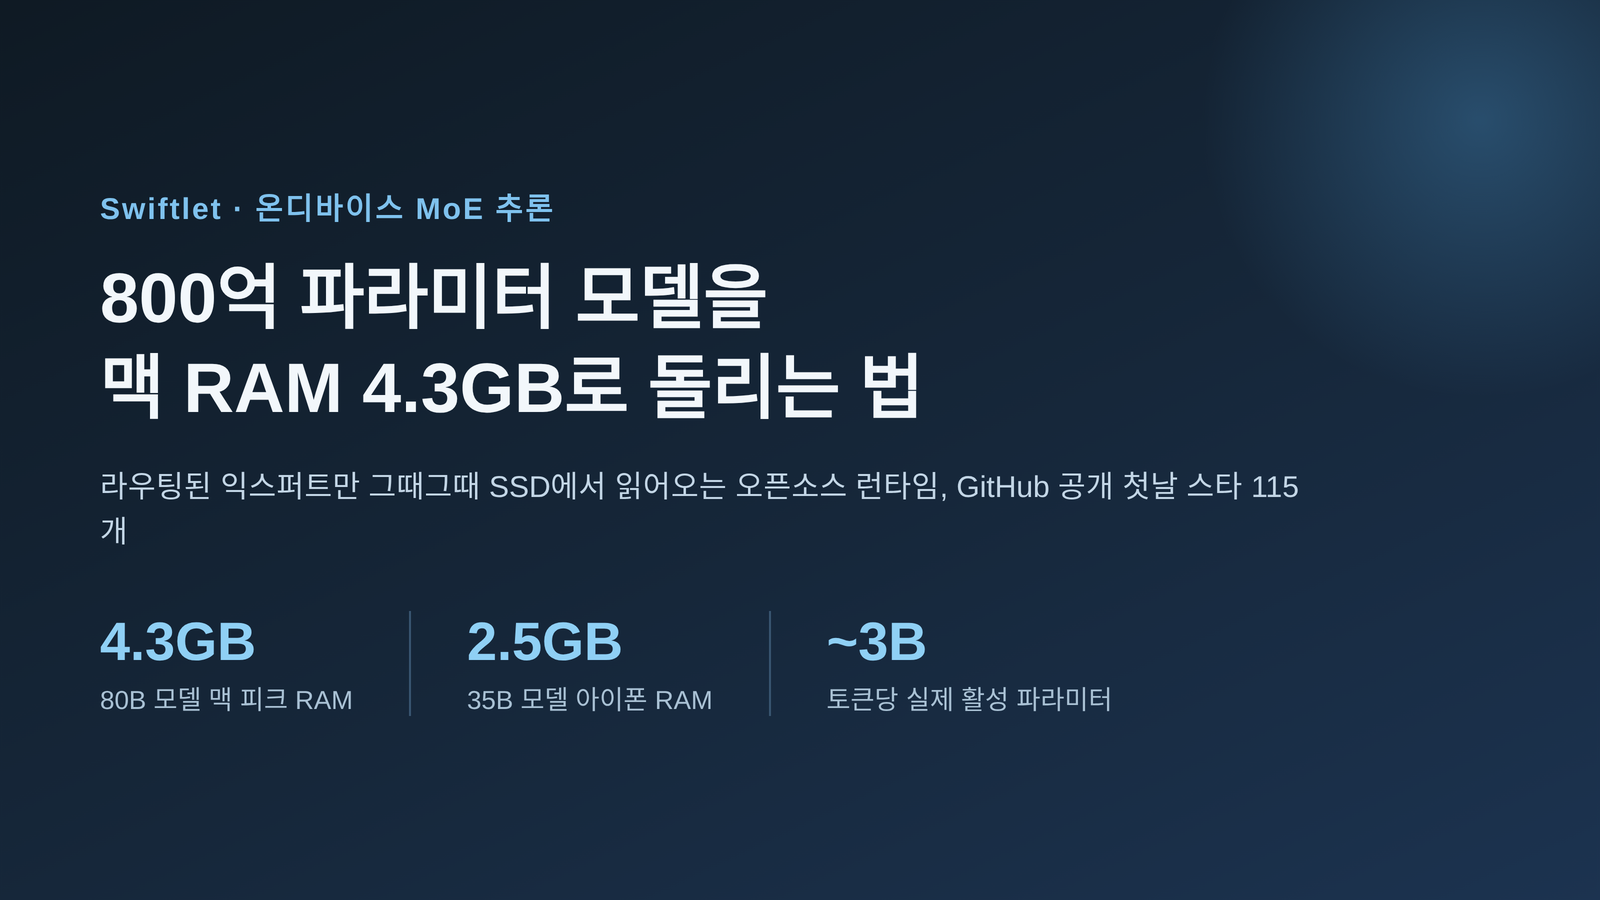
개인 개발자가 만든 오픈소스 런타임 Swiftlet이 800억 파라미터 Qwen을 맥에서 RAM 4.3GB로, 350억 파라미터 모델을 아이폰에서 2.5GB로 돌립니다. 익스퍼트를 SSD에서 그때그때 읽어오는 방식입니다.
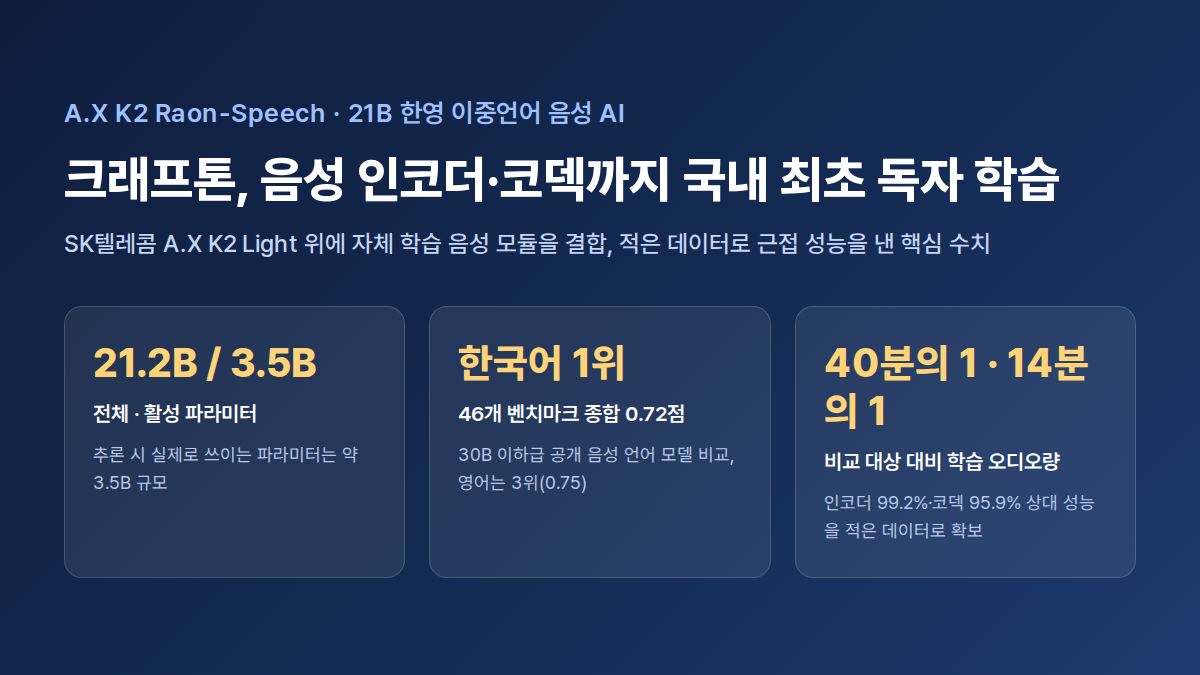
크래프톤이 음성 인코더·코덱을 독자 학습해 SK텔레콤 A.X K2 Light와 결합한 21B 한영 이중언어 음성 AI "A.X K2 Raon-Speech"를 허깅페이스에 공개했습니다.
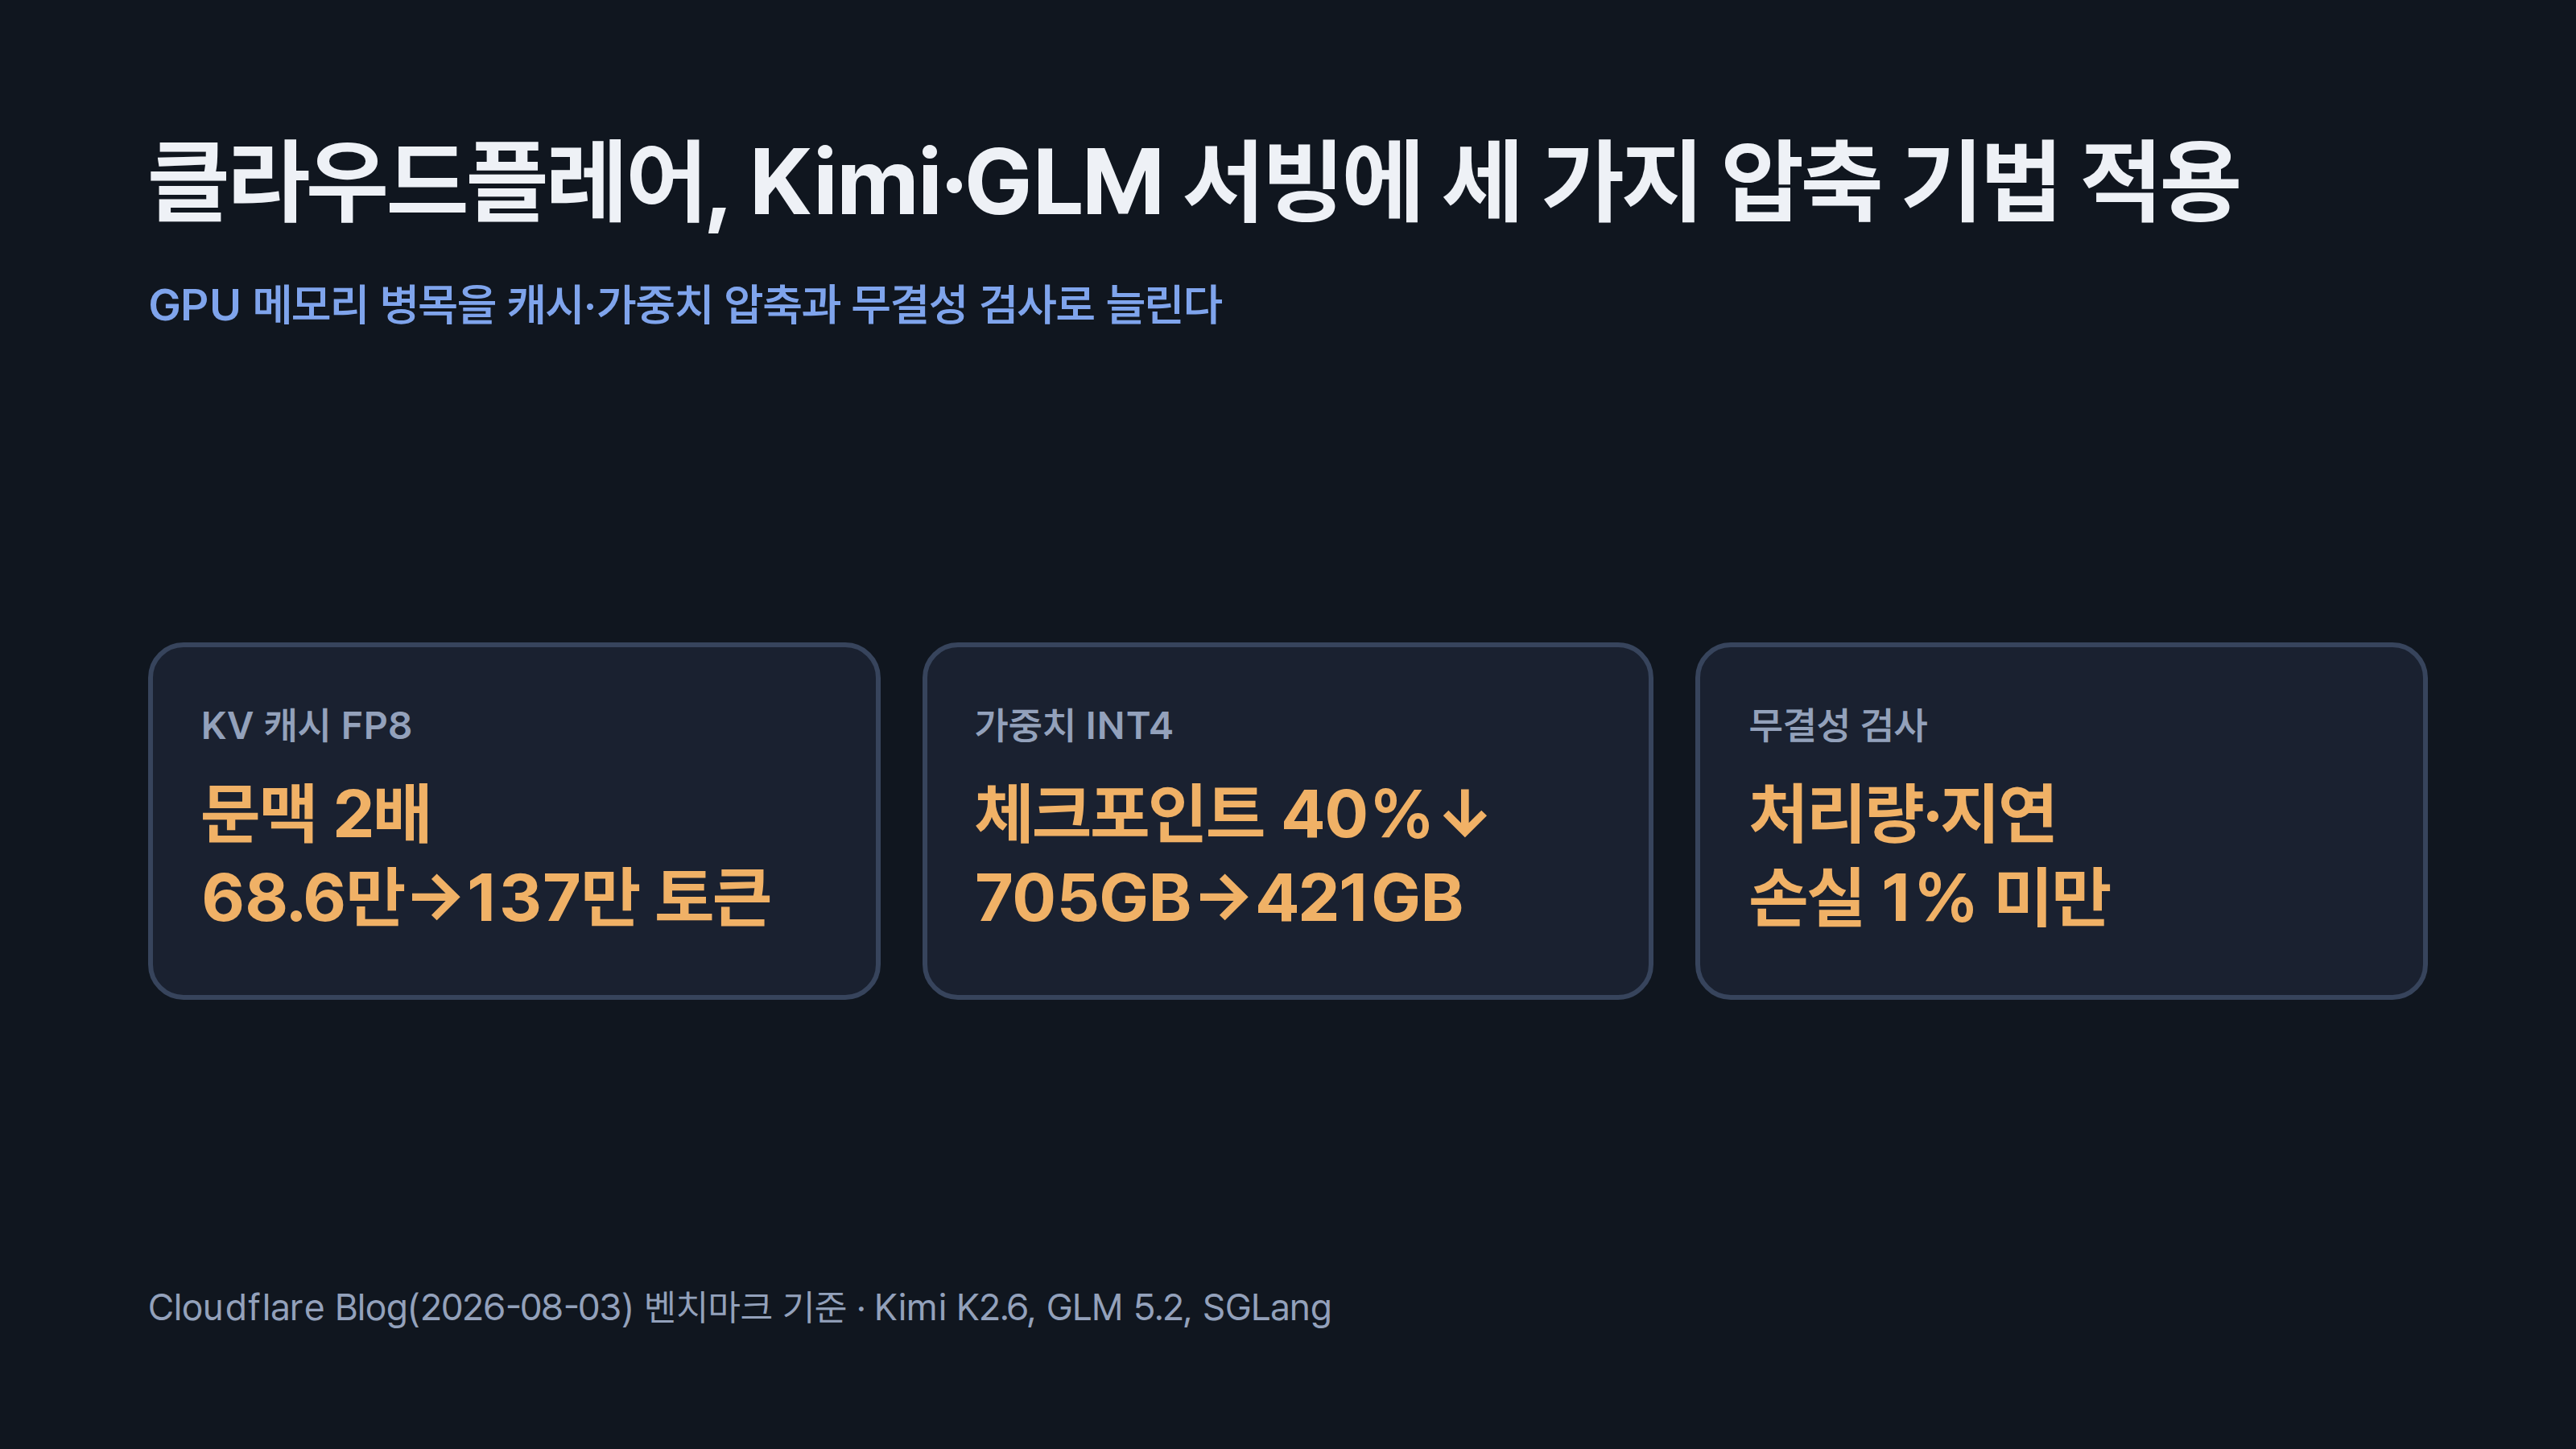
클라우드플레어가 Kimi K2.6과 GLM 5.2를 GPU 한 대에 더 많이 태우는 KV 캐시 FP8·가중치 INT4 압축, 캐시 무결성 검사 기법을 실측치와 함께 공개했습니다.
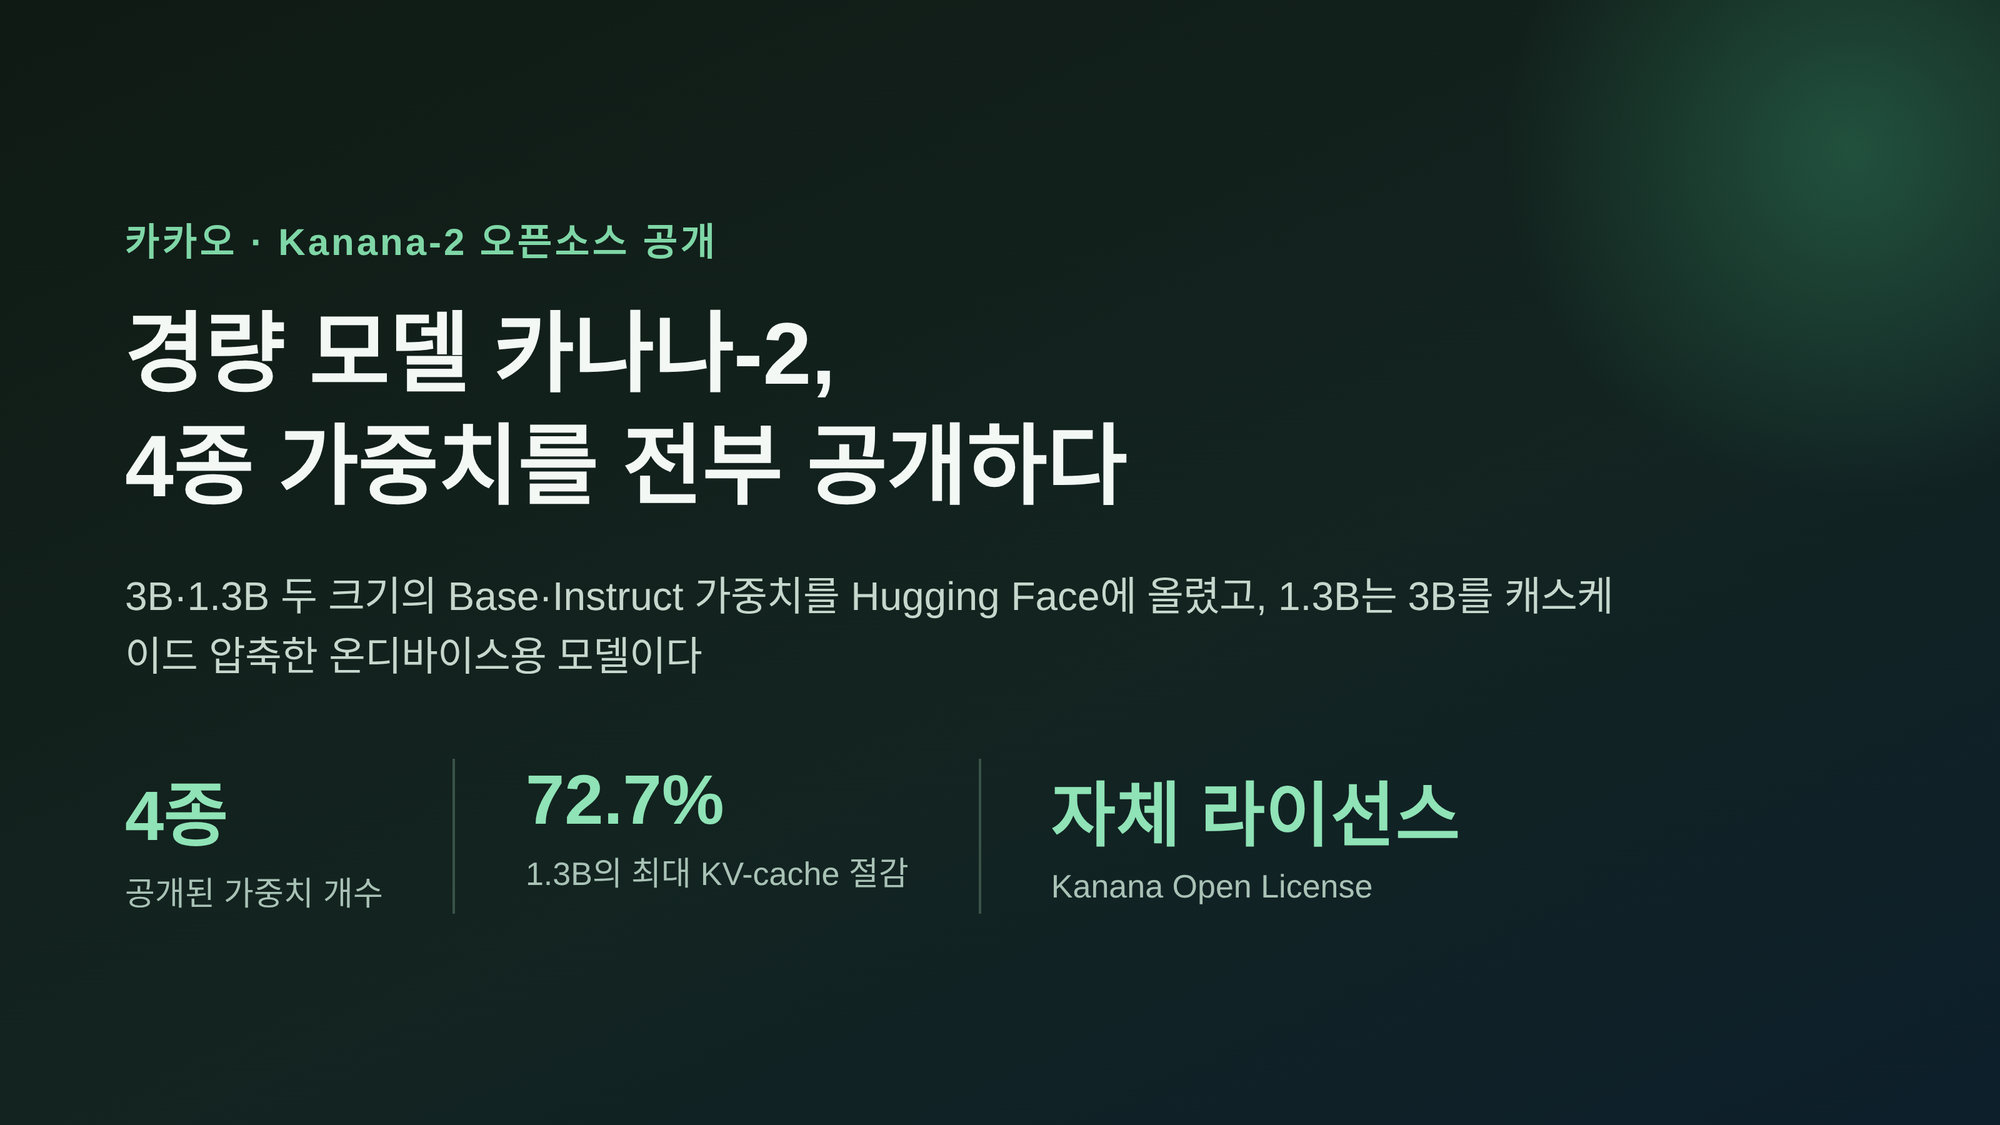
카카오가 Kanana-2 SLM 3B·1.3B 모델의 Base/Instruct 가중치 4종을 Hugging Face에 공개했습니다. 1.3B는 3B를 캐스케이드 압축한 온디바이스용 모델입니다.
알리바바 Qwen 팀이 2.4조 파라미터 규모 Qwen3.8-Max를 공개했습니다. 16일간 자율 운영한 오픈소스 프로젝트, 반도체 회로 재설계 등 장기 과제 사례를 함께 내놨습니다.