GitHub 엔지니어 션 고데케(Sean Goedecke)가 7월 24일 자신의 블로그에 올린 글에서, LLM을 잘 쓰는 능력의 핵심은 프롬프트 기법이 아니라 그 분야에 대한 전문성이라고 주장했다. 그가 근거로 든 사례는 필즈상 수상자 테렌스 타오가 최근 발견된 야코비안 추측(Jacobian Conjecture) 반례를 두고 챗GPT와 나눈 대화다. 고데케는 "이건 내가 쓰는 챗GPT와 같은 모델이 아니다"라고 적었을 만큼, 같은 모델이라도 누가 쓰느냐에 따라 결과물의 수준이 크게 갈린다고 봤다.
이 글은 "누구나 LLM에게 물으면 비슷한 답을 얻으니 프롬프트에는 별다른 기술이 없다"는 통념을 반박하는 데서 시작한다. 2010년대라면 CSS를 못 쓰는 사람은 동료에게 의지하거나 인터넷에서 답을 찾아야 했지만, 지금은 누구나 LLM에게 시켜 어느 정도 쓰는 CSS를 받을 수 있다. 하지만 고데케는 이 지점에서 "프롬프팅에서 가장 중요한 기술은 그 분야에 대한 전문성"이라고 선을 긋는다.
테렌스 타오는 챗GPT와의 대화에서 무엇을 다르게 했나
고데케는 타오의 대화에서 네 가지 패턴을 짚었다. 첫째, 타오의 메시지는 짧고 요점만 담고 있으며 모델의 답변에 문장 하나하나 대응하지 않고 전체 취지에만 반응한다. 둘째, 모델의 답변 자체도 고데케가 수학 얘기를 할 때보다 훨씬 간결한데, 전문성을 신호로 보내면 모델이 "아마추어에게 설명하는 모드"가 아니라 "수학자와 대화하는 모드"로 넘어가기 때문이라고 설명한다. 셋째, 타오는 답이 이상해 보이면 직접 반박하는 대신 "생각보다 복잡해 보인다" 같은 완곡한 표현으로 되돌린다. 넷째, 타오는 다음 방향을 스스로 제안하는 경우가 대부분이고 모델이 권하는 다음 단계를 거의 따르지 않는다.
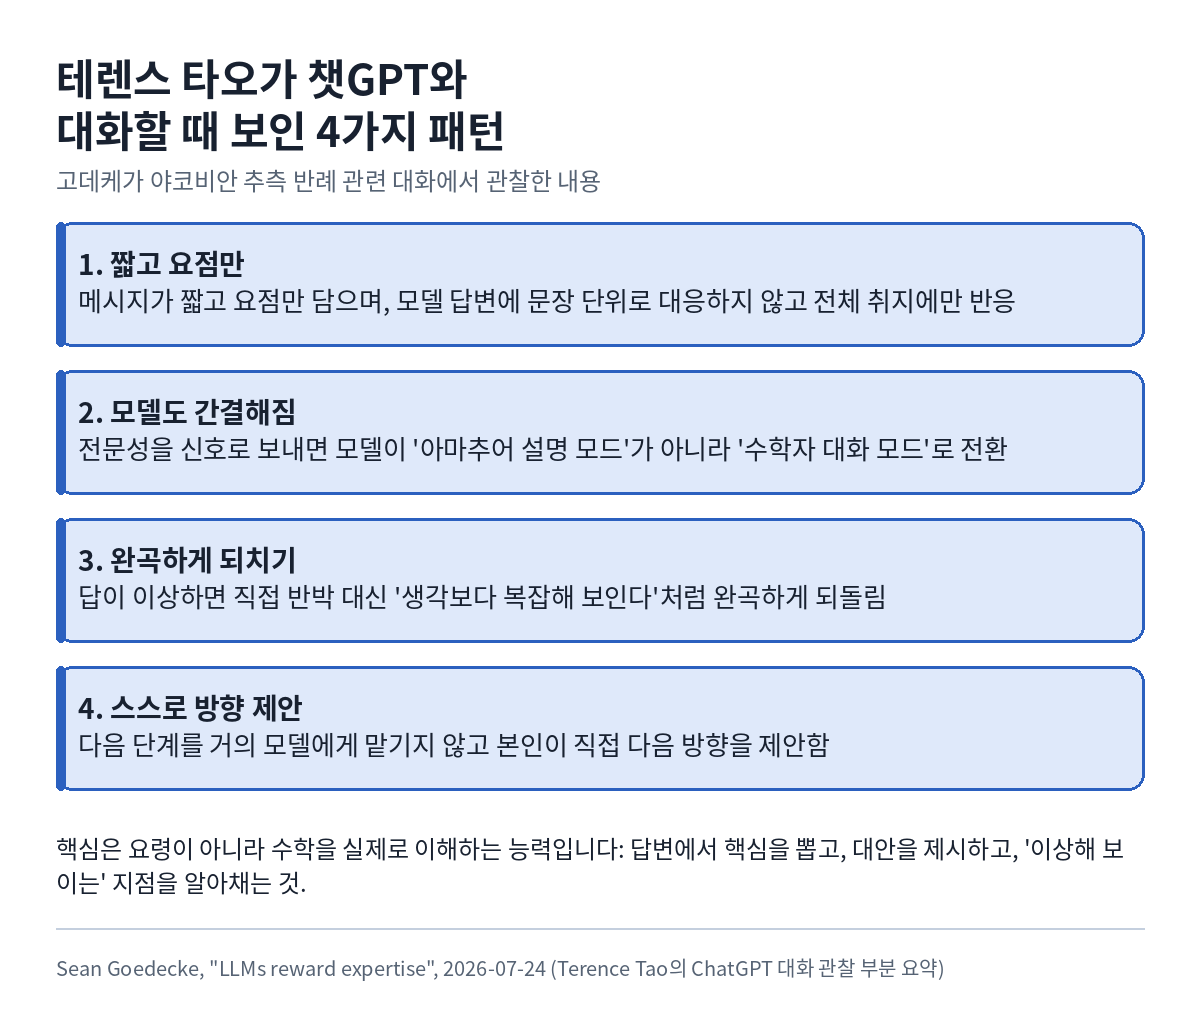
다만 고데케는 이 네 가지를 그대로 따라 한다고 타오처럼 프롬프트할 수 있는 건 아니라고 못박는다. 진짜 핵심은 수학을 실제로 이해하는 것, 즉 챗GPT의 여러 문단짜리 답변에서 핵심 아이디어를 뽑아내고 다른 접근을 제안하고 "이상해 보이는" 지점을 알아채는 능력이라는 것이다. 요령만으로는 흉내 낼 수 없는 부분이다.
도메인 지식이 있으면 같은 모델에게서 왜 더 많이 뽑아낼 수 있나
고데케는 자신이 타오만큼 뛰어난 프로그래머는 아니라고 인정하면서도, 자신의 코드베이스 작업에서 같은 원리를 경험했다고 쓴다. 자기가 다루는 코드베이스에 대한 이론을 갖고 있으면 낯선 코드를 대할 때보다 훨씬 세게 LLM을 밀어붙일 수 있는데, 좋은 해법이 어떤 모습일지 스스로 감이 있기 때문에 "여기는 더 단순하게 할 수 있을 것 같다", "우리 이미 X를 하고 있지 않나", "이 문제를 우리에게 익숙한 용어로 표현할 수 있나" 같은 되치기가 가능해진다는 것이다. 그는 이전에 쓴 글을 인용해, 시스템 설계 문제는 일반 원칙이 아니라 구체적인 세부 사항이 좌우한다고 재확인한다. 타오가 챗GPT에게 "여기서 X가 작동하나", "Y와 Z가 있다면 왜 A인가" 같은 구체적 질문을 던지듯, 고데케도 야코비안 추측에는 그런 질문을 할 수 없지만 자신이 GitHub에서 맡은 시스템에는 할 수 있다.
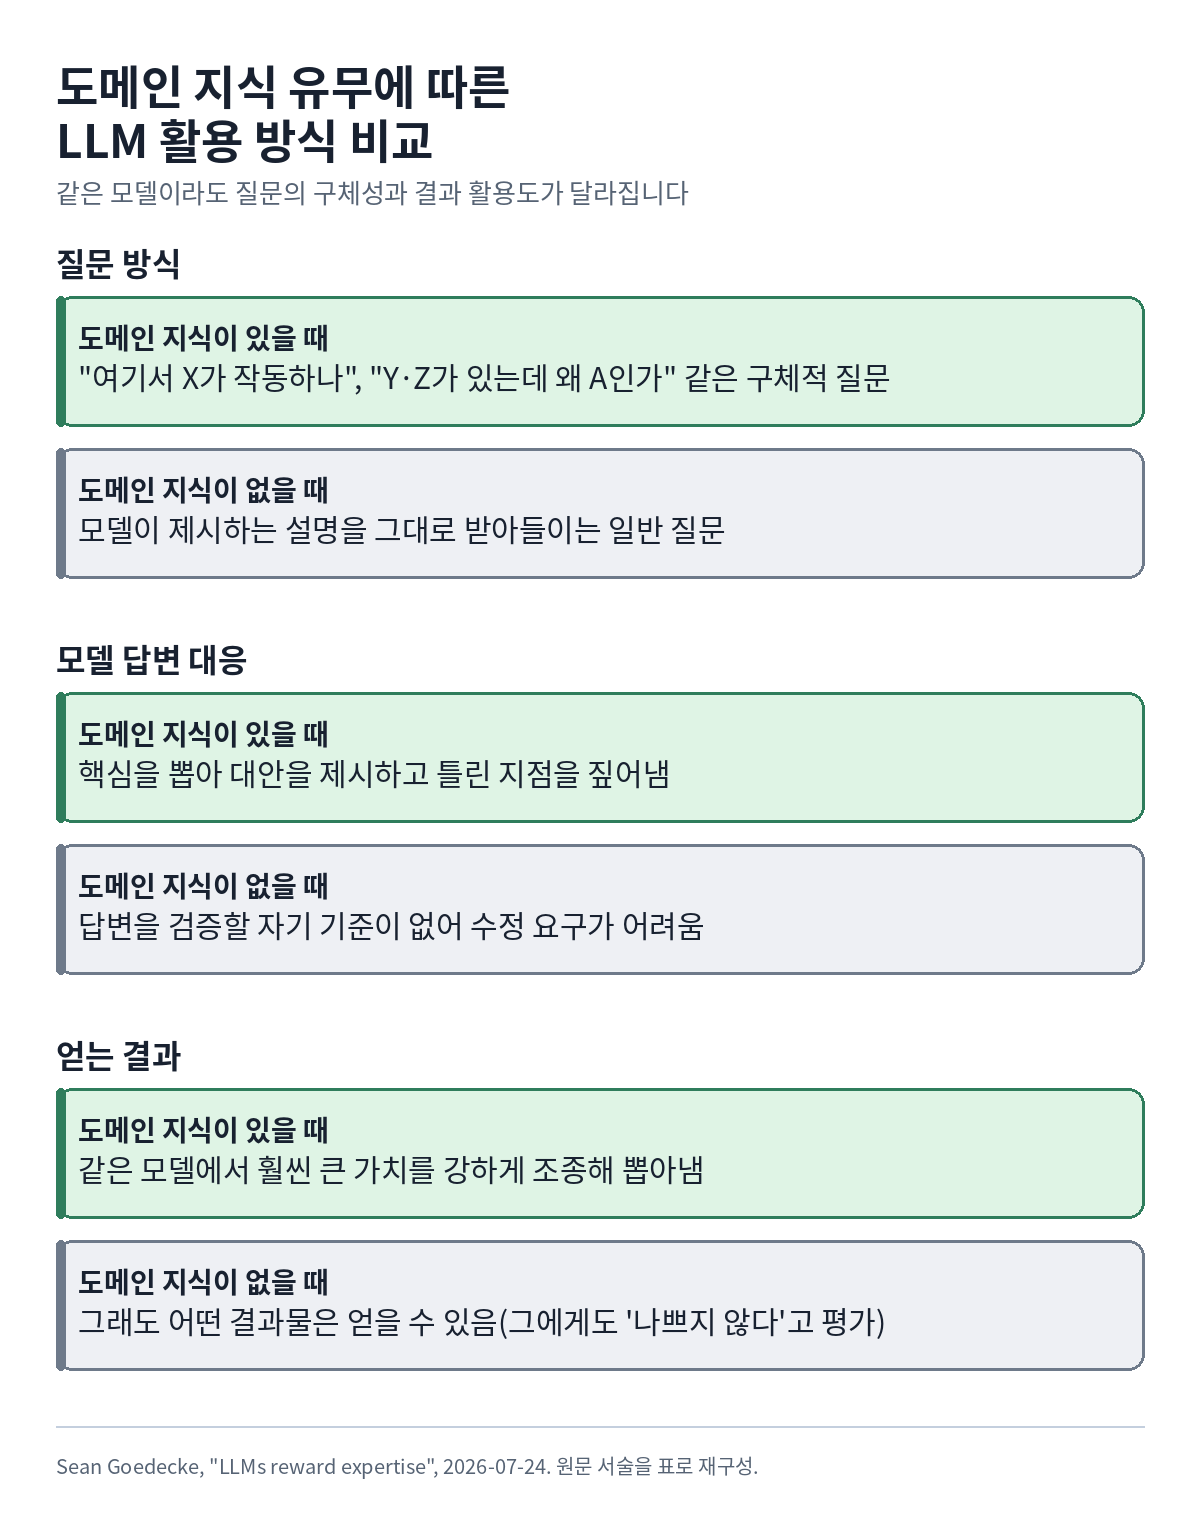
정리하면 도메인 지식이 만드는 차이는 질문의 구체성이다. 전문가는 모델의 답변을 자기 머릿속 기준과 대조해 어긋난 지점을 짚어내고 대안을 직접 제시하지만, 그 분야를 모르는 사람은 모델이 내놓는 답을 그대로 받아들일 수밖에 없다.
전문성이 없어도 LLM은 여전히 쓸모가 있는가
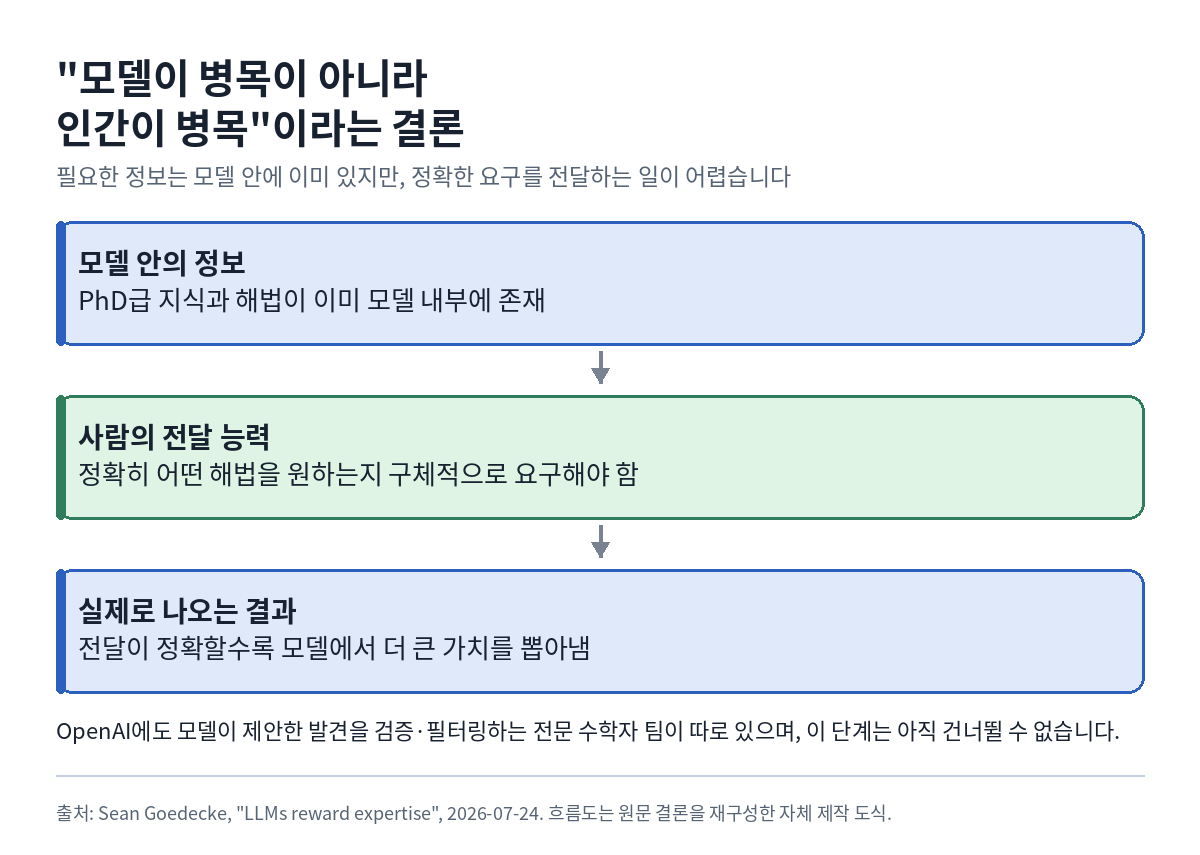
고데케는 도메인 지식이 전혀 없어도 LLM에게 매달려 "어떤 결과물"이라도 얻는 것 자체는 나쁘지 않다고 인정한다. 다만 도메인 지식이 있으면 같은 모델에서 훨씬 큰 가치를 강하게 조종해 뽑아낼 수 있고, 대부분의 사람은 어떤 영역에는 지식이 있고 다른 영역에는 없는 혼합 상태로 이 두 방식을 오갈 뿐이라고 쓴다. 그는 이 관찰이 모델이 더 강해져도 인간 전문성이 계속 쓸모 있을 것이라는 근거로 이어진다고 본다. 많은 작업에서 병목은 모델이 아니라 사람인데, 필요한 정보는 이미 모델 안에 있지만 정확히 어떤 해법을 원하는지 모델에게 전달하는 일이 어렵기 때문이라는 설명이다.
이 글은 해커뉴스에서 많은 댓글을 받은 뒤 고데케가 내용을 덧붙였다. 일부 독자는 전문성이 도움이 되거나 부족이 해가 됐던 자신의 경험을 공유했고, 다른 독자들은 이 주장이 결국 "당신은 여전히 가치 있다"는 위안이라 의심스럽다는 반응을 보였는데 고데케도 이 의심에 공감하면서, 다만 이 논의가 정리될 즈음이면 상황 자체가 또 바뀌어 있을 거라고 덧붙였다. 또 다른 댓글은 OpenAI의 수학 프롬프트가 전문가답지 않았다는 점을 들어 전문성이 필요조건이 아니라고 반박했는데, 고데케는 OpenAI에 모델이 제안한 발견을 검증하고 걸러내는 전문 수학자 팀이 따로 있고, 지금은 그 단계를 건너뛸 수 없다는 점을 반례로 들었다.