
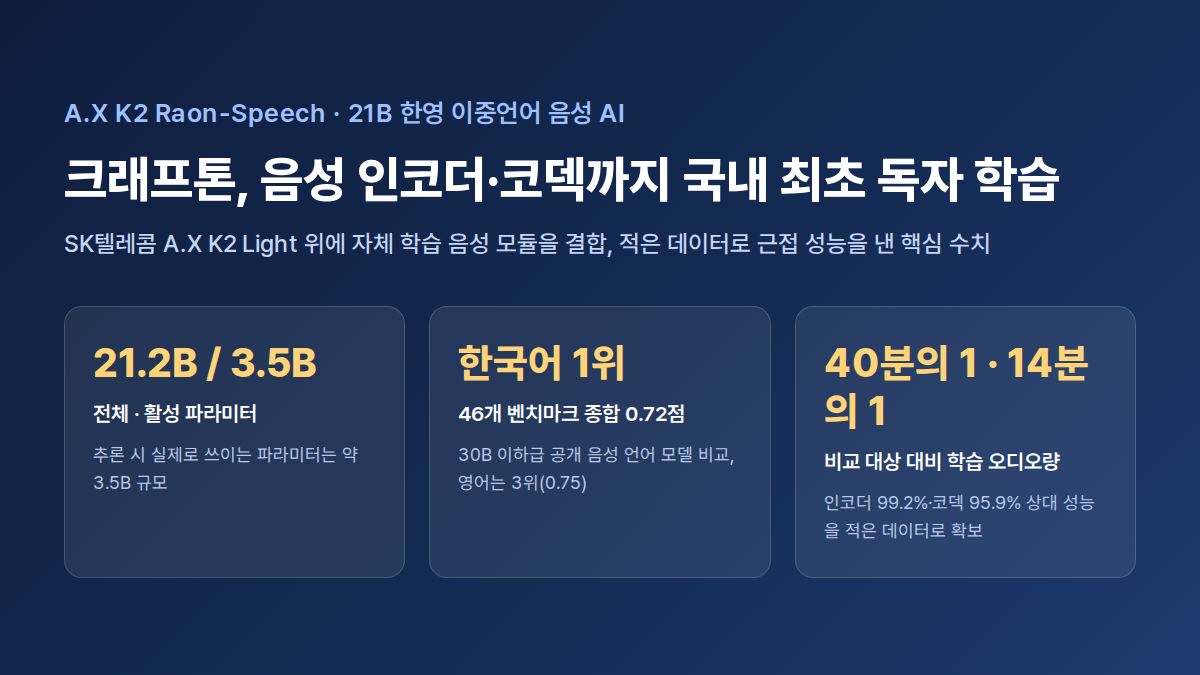
크래프톤이 자체 학습한 음성 인코더와 코덱을 SK텔레콤의 언어 모델과 결합한 한영 이중언어 음성 AI "A.X K2 Raon-Speech"를 8월 4일 허깅페이스에 공개했다. 전체 파라미터 약 21.2B, 실제 추론에 쓰이는 활성 파라미터는 약 3.5B 규모의 음성 언어 모델(SpeechLM)로, 음성을 듣고 이해하는 것과 음성으로 답하는 것을 하나의 모델 안에서 처리한다. 지난 4월 공개한 Raon-Speech-9B의 학습 레시피를 그대로 이어받았고, 이번에는 음성 인코더와 코덱까지 국내에서 처음으로 독자 학습했다는 점이 다르다.
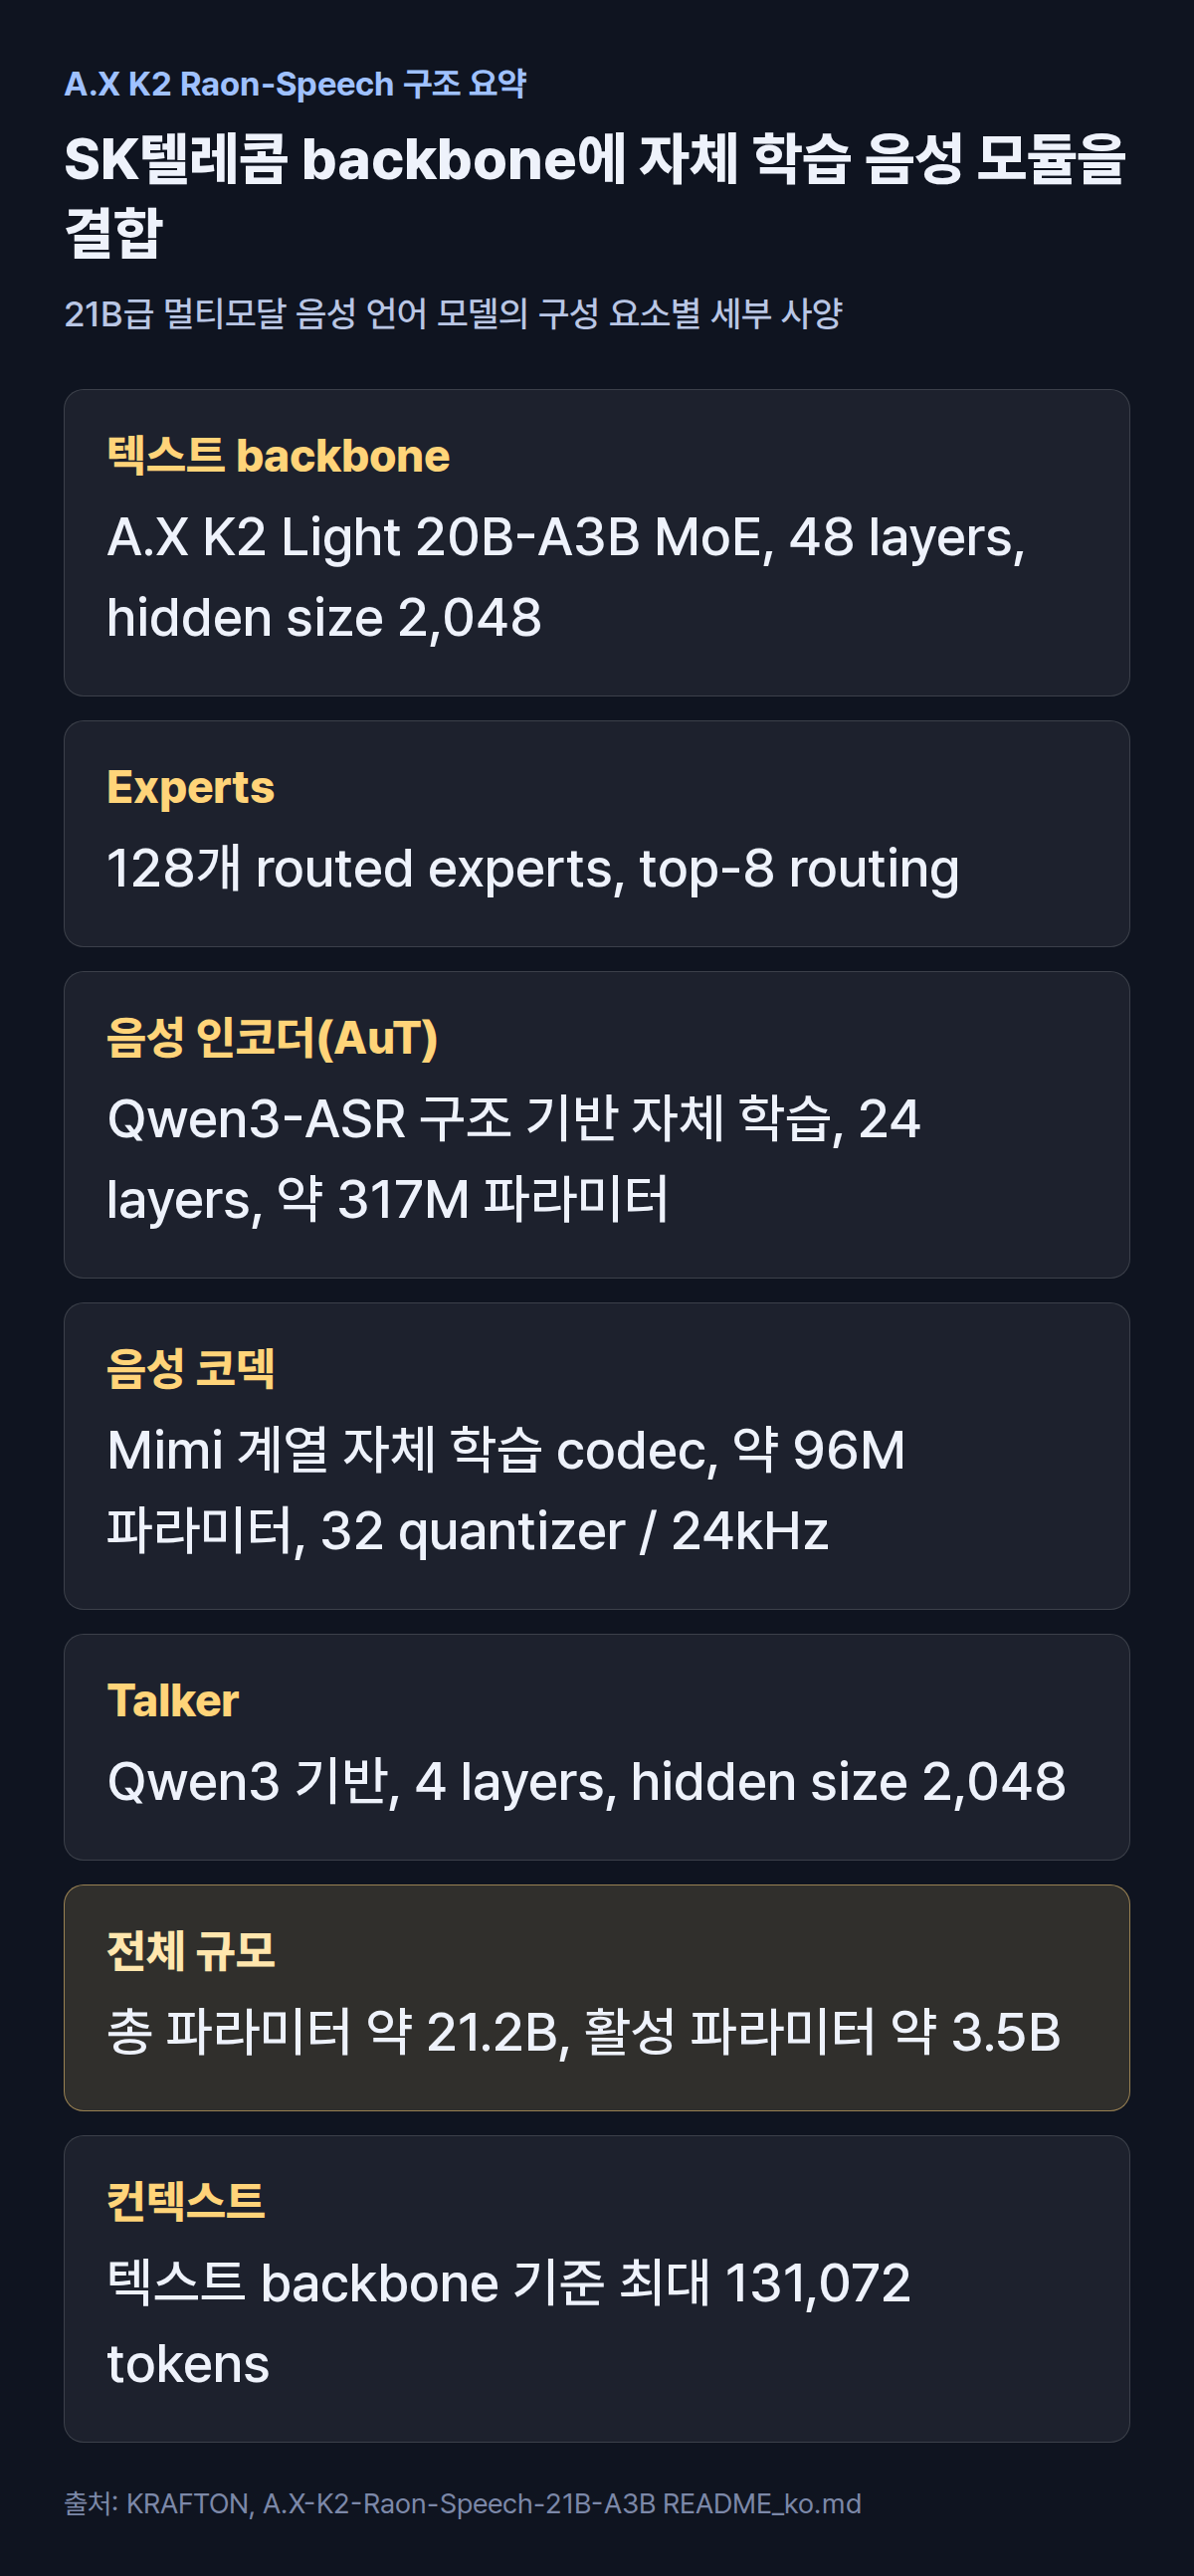
이 모델은 SK텔레콤이 개발한 A.X K2 Light 20B-A3B mixture-of-experts 텍스트 backbone 위에, 크래프톤이 직접 학습한 AuT 음성 인코더(약 317M 파라미터)와 Mimi 계열 neural audio codec(약 96M 파라미터)을 얹은 구조다. 음성 인식(STT), 음성 합성(TTS), 음성 기반 질의응답(SpeechQA·SpokenQA), 여러 턴에 걸친 멀티모달 대화를 하나의 체크포인트에서 지원한다.
왜 음성을 텍스트로 바꿔서 처리하지 않는가
지금까지 음성 AI 비서는 대부분 세 개의 모델을 이어 붙이는 방식으로 만들어졌다. 음성을 텍스트로 바꾸는 STT 모델, 텍스트로 답을 만드는 LLM, 다시 텍스트를 음성으로 바꾸는 TTS 모델이 순서대로 작업을 넘겨받는 구조다. 크래프톤은 이 방식이 구현은 간단하지만 음성이 텍스트로 변환되는 과정에서 억양·감정·화자 특성 같은 비언어적 단서가 손실되고, 이 손실이 이후 응답 품질에까지 영향을 준다고 설명한다. A.X K2 Raon-Speech는 음성을 텍스트의 부가 정보가 아니라 모델이 직접 이해하고 생성하는 핵심 입력으로 다뤄, 음성 임베딩이 곧바로 언어 모델의 입력 표현이 되고 언어 모델의 hidden state가 다시 음성 이산 토큰으로 변환되는 구조를 택했다.
적은 데이터로 어떻게 근접한 성능을 냈나
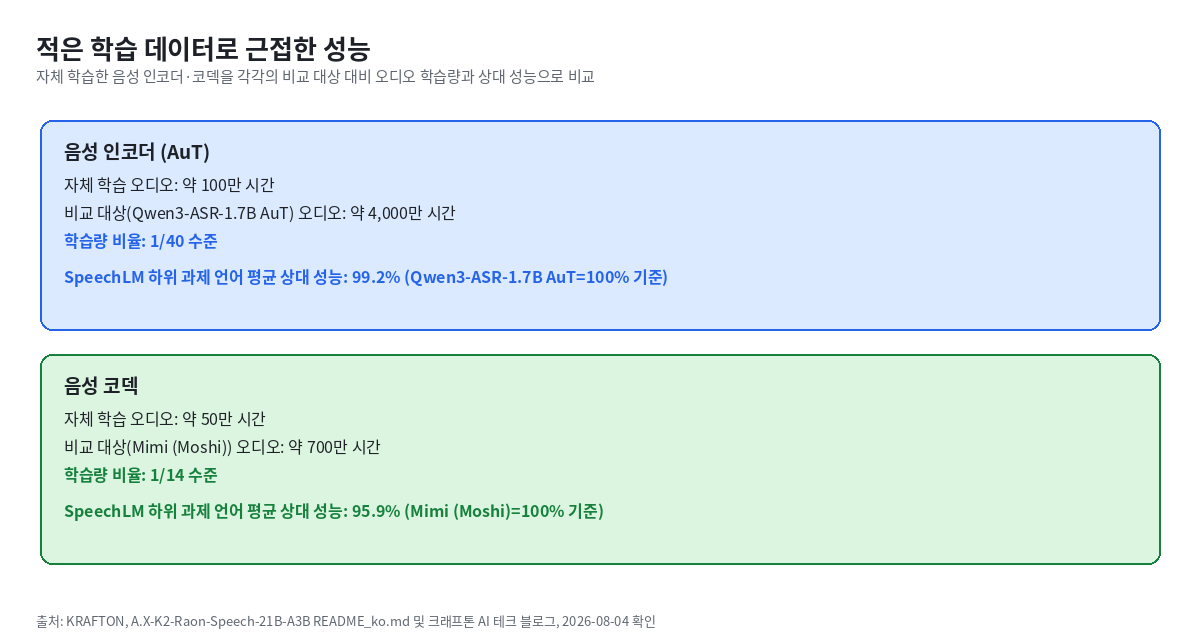
이번 프로젝트의 핵심은 새로운 모델 구조를 제안하는 것이 아니라, 독자적으로 수집·정제한 데이터와 학습 파이프라인만으로 경쟁력 있는 음성 모듈을 처음부터 학습할 수 있는지를 확인하는 데 있었다. 음성 인코더는 Qwen3-ASR-1.7B의 AuT 구조를 기반으로 삼되 약 100만 시간의 오디오로 학습했는데, 이는 Qwen3-ASR AuT가 보고한 학습량(약 4,000만 시간)의 약 40분의 1 수준이다. 그런데도 음성 인식·SpokenQA·SpeechQA 세 과제의 언어 평균 상대 성능은 99.2%(Qwen AuT를 100%로 놓은 기준)에 달했다. 음성 코덱도 마찬가지로, Moshi가 보고한 약 700만 시간의 약 14분의 1인 50만 시간만으로 Mimi 코덱 대비 95.9%의 상대 성능을 냈다.
크래프톤은 코덱 학습에서 안정적인 수렴을 위해 두 단계 전략을 썼다고 밝혔다. 먼저 복원 손실과 semantic distillation에 집중해 코덱을 먼저 수렴시키고, 그 다음 인코더를 고정한 채 판별기를 추가해 adversarial training으로 디코더의 지각 품질을 개선하는 순서다. 처음부터 판별기 기반 학습과 회귀 손실을 동시에 적용하면 손실 함수가 안정적으로 수렴하지 않는 문제가 있었다고 설명한다.
실제 성능은 어느 정도인가
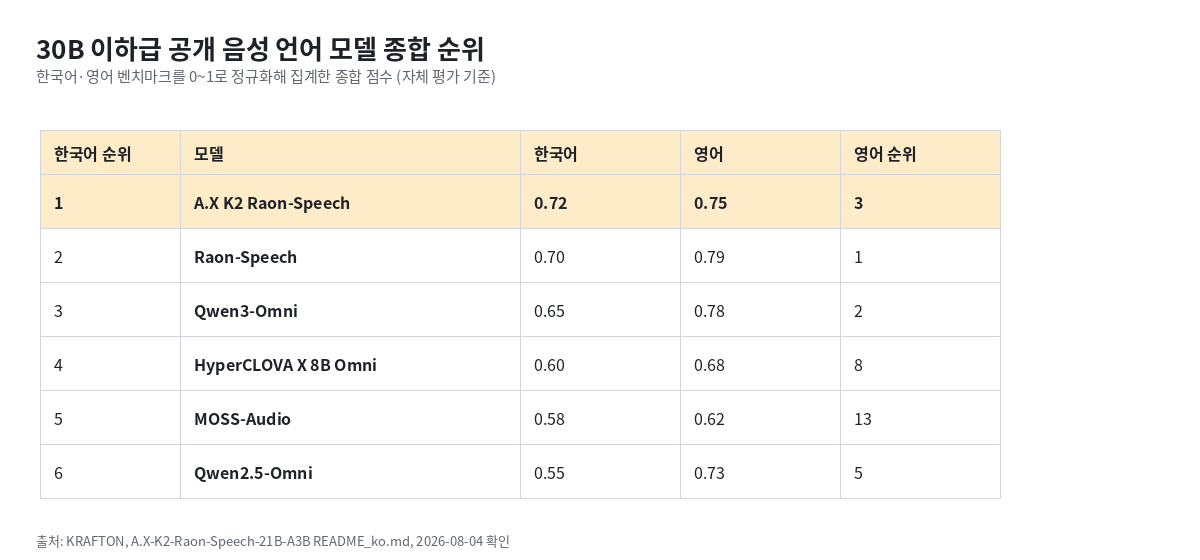
크래프톤은 음성 인식, 음성 합성, 음성 이해, 음성 질의응답, 텍스트 질의응답, 도구 호출 등 6개 영역에서 LibriSpeech, KsponSpeech, VoiceBench, KVoiceBench, MMAU, API-Bank 등 한국어 24개·영어 22개, 총 46개 벤치마크로 평가했다. 각 결과를 0~1로 정규화해 언어별 종합 점수를 낸 결과, A.X K2 Raon-Speech는 30B 이하급 공개 음성 언어 모델 중 한국어 종합 1위(0.72), 영어 종합 3위(0.75)를 기록했다. 같은 크래프톤이 만든 Raon-Speech가 영어에서는 더 높은 점수(0.79)를 냈지만 한국어에서는 이번 A.X K2 Raon-Speech가 앞섰다.
어떤 기능을 새로 갖췄나
사전 학습 이후에는 실사용에 필요한 능력을 강화하는 별도 사후 학습을 거쳤다. 텍스트 기반 도구 호출 데이터를 음성 생성으로 확장해, 음성으로 질문을 받으면 필요한 도구를 스스로 선택해 호출하고 그 결과를 다시 음성 답변으로 통합하는 흐름을 학습했다. 단일 턴에서는 도구 호출과 응답 처리가 안정적으로 작동하는 것을 확인했다고 밝혔다. 여기에 더해 사용자 목소리의 감정·억양 같은 준언어적 단서를 인지해 답변에 반영하는 능력, ECAPA 화자 임베딩으로 특정 화자의 목소리를 조건으로 준 음성을 합성하는 화자 조건 TTS, 참조 오디오의 운율을 이어받아 자연스럽게 이어 말하는 TTS continuation 기능도 포함됐다. tool-use fine-tuning은 도구 호출 점수를 0.543에서 0.740으로, paralinguistic self-distillation은 감정·화자 인지 점수를 0.566에서 0.613으로, TTS 관련 preference optimization은 평균 TTS 오류율을 3.6%에서 3.1%로 각각 개선했다.
어떻게 써 볼 수 있나
모델은 허깅페이스에서 BF16 체크포인트(약 42.4GB)로 받을 수 있으며 80GB급 GPU 한 장 또는 이에 준하는 멀티 GPU 구성을 권장한다. `transformers` 4.57.1 이상이 필요하고, 화자 조건·continuation TTS를 쓰려면 `speechbrain` 패키지가 추가로 있어야 한다. 온라인 서빙은 크래프톤이 공개한 vLLM-Omni 저장소의 전용 브랜치(`feat/axk2_raon_speech`)로 지원하며, 기본·화자 조건 TTS, STT, 텍스트/음성 질의응답까지 OpenAI 호환 API 엔드포인트(`/v1/audio/speech`, `/v1/chat/completions`)로 호출할 수 있다. 다만 라이선스는 CC BY-NC 4.0으로, 비상업적 연구와 프로토타이핑 용도로 제한된다. 함께 포함된 A.X K2 Light 코드 자체는 Apache License 2.0을 따르지만 이는 그 코드에만 적용된다.