
카카오가 자체 개발한 경량 언어모델 시리즈 "Kanana-2 SLM"의 가중치를 Hugging Face에 공개했다. 이번에 풀린 것은 3B(30억) 파라미터 모델과 이를 압축한 1.3B(13억) 파라미터 모델 각각의 Base·Instruct 버전으로, 총 4종이다. 카카오는 사전학습부터 압축, 배포까지 전 과정을 Hugging Face 모델 카드와 기술 블로그에 구체적인 수치와 함께 공개했다.
어떤 모델이 몇 종 나왔나
공개된 4종은 Kanana-2-3B-Base(3B 사전학습 베이스), Kanana-2-3B-Instruct(3B 지시학습), Kanana-2-1.3B-Base(1.3B 압축 베이스), Kanana-2-1.3B-Instruct(온디바이스 배포용 1.3B 지시학습)다. 카카오는 원래 3B·1.3B·0.9B 세 크기로 시리즈를 설계했지만, 이번 공개 범위는 3B와 1.3B 두 크기로 한정했다. 3B 모델은 TPU 클러스터에서 처음부터 사전학습한 뒤 지도 미세조정(SFT)과 강화학습(RL) 단계를 거쳤고, 모델 카드는 사전학습·후속학습 어느 단계에도 카카오 이용자 데이터를 쓰지 않았다고 명시했다.
1.3B 모델은 어떻게 3B에서 압축됐나
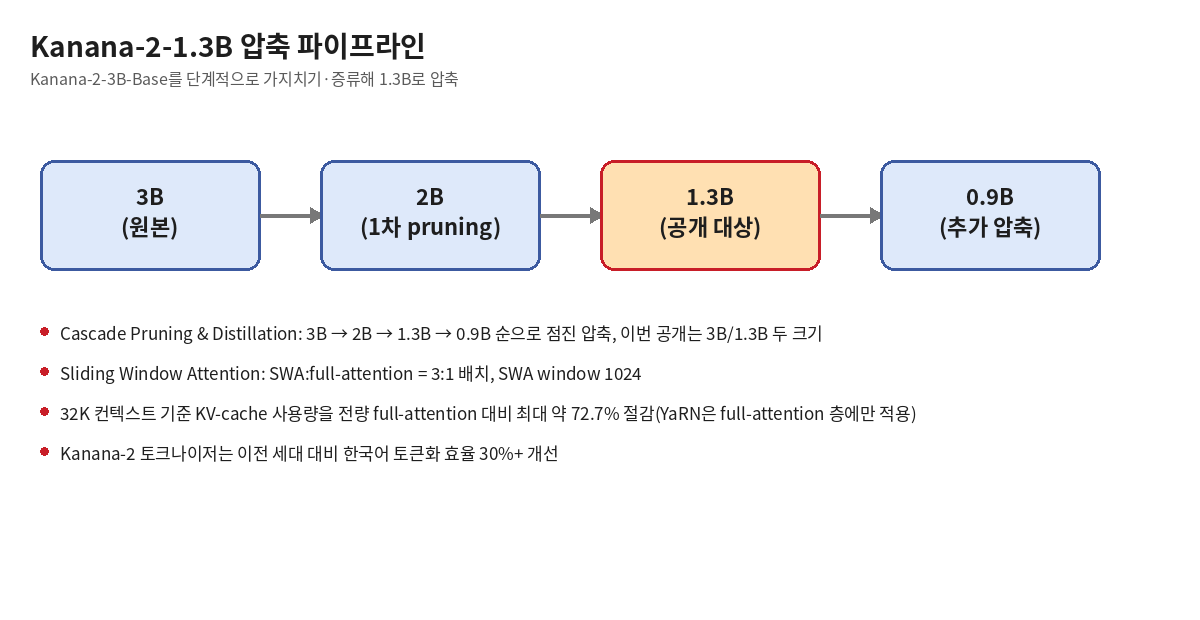
Kanana-2-1.3B는 3B 모델을 처음부터 새로 학습한 게 아니라, 3B-Base를 단계적으로 가지치기(pruning)하고 지식 증류(distillation)하는 파이프라인으로 만들었다. 카카오가 설계한 경로는 3B → 2B → 1.3B → 0.9B 순의 캐스케이드 구조이며, 이번에 공개된 것은 이 경로 중간 산물인 1.3B다. 압축된 모델은 슬라이딩 윈도우 어텐션(SWA)을 도입해 슬라이딩 윈도우 층과 풀 어텐션 층을 3:1 비율로 섞고, 윈도우 크기는 1024로 설정했다. 이 구조 덕분에 32K 토큰 컨텍스트 기준으로 풀 어텐션만 쓰는 모델 대비 KV 캐시 사용량을 최대 약 72.7%까지 줄였다고 밝혔다. 풀 어텐션 층에는 장문 확장 기법인 YaRN을 적용하고, SWA 층은 RoPE를 그대로 유지해 지역 어텐션 효율과 긴 컨텍스트 대응을 함께 잡았다는 설명이다.
벤치마크 점수는 어느 정도인가
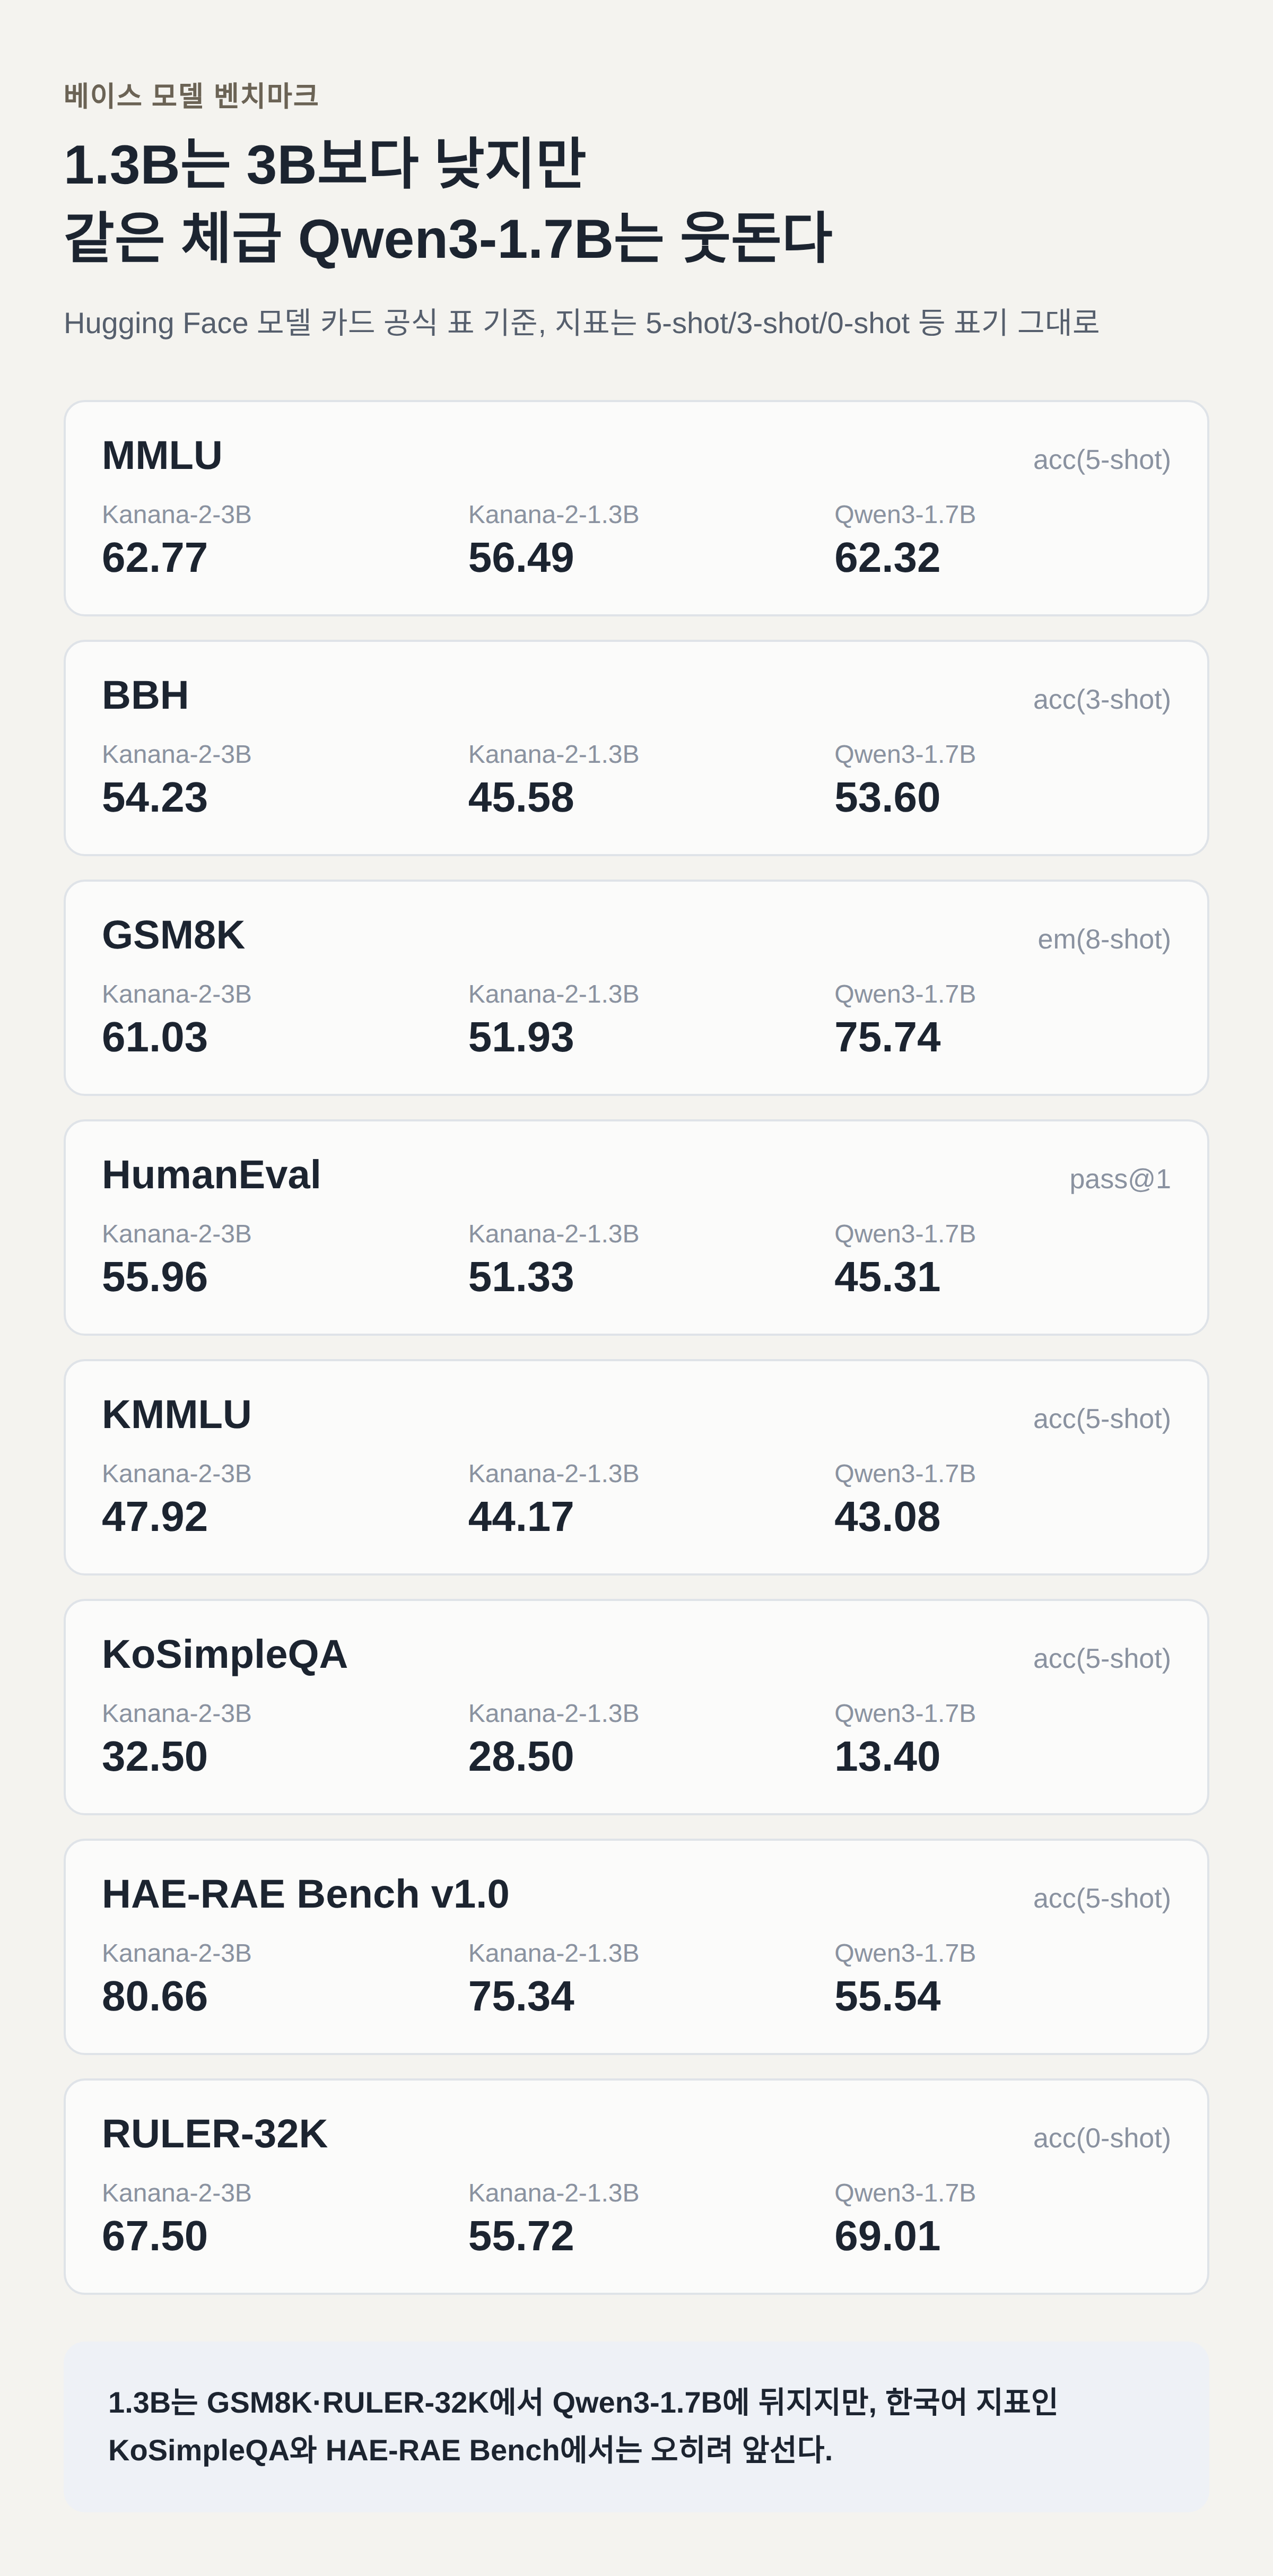
모델 카드는 두 베이스 모델과 인스트럭트 모델 각각에 대해 Qwen 계열과 나란히 비교한 벤치마크 표를 실었다. 베이스 모델 기준으로 Kanana-2-3B-Base는 MMLU 62.77, HAE-RAE Bench(v1.0) 80.66, KoSimpleQA 32.50을 기록했고, 압축판인 Kanana-2-1.3B-Base는 각각 56.49, 75.34, 28.50으로 3B보다는 낮지만 비슷한 크기의 Qwen3-1.7B-Base(HAE-RAE Bench 55.54, KoSimpleQA 13.40)보다 한국어 관련 지표에서 크게 앞섰다. 다만 GSM8K(수학 문제풀이)에서는 Kanana-2-1.3B-Base가 51.93으로 Qwen3-1.7B-Base의 75.74에 미치지 못했다.
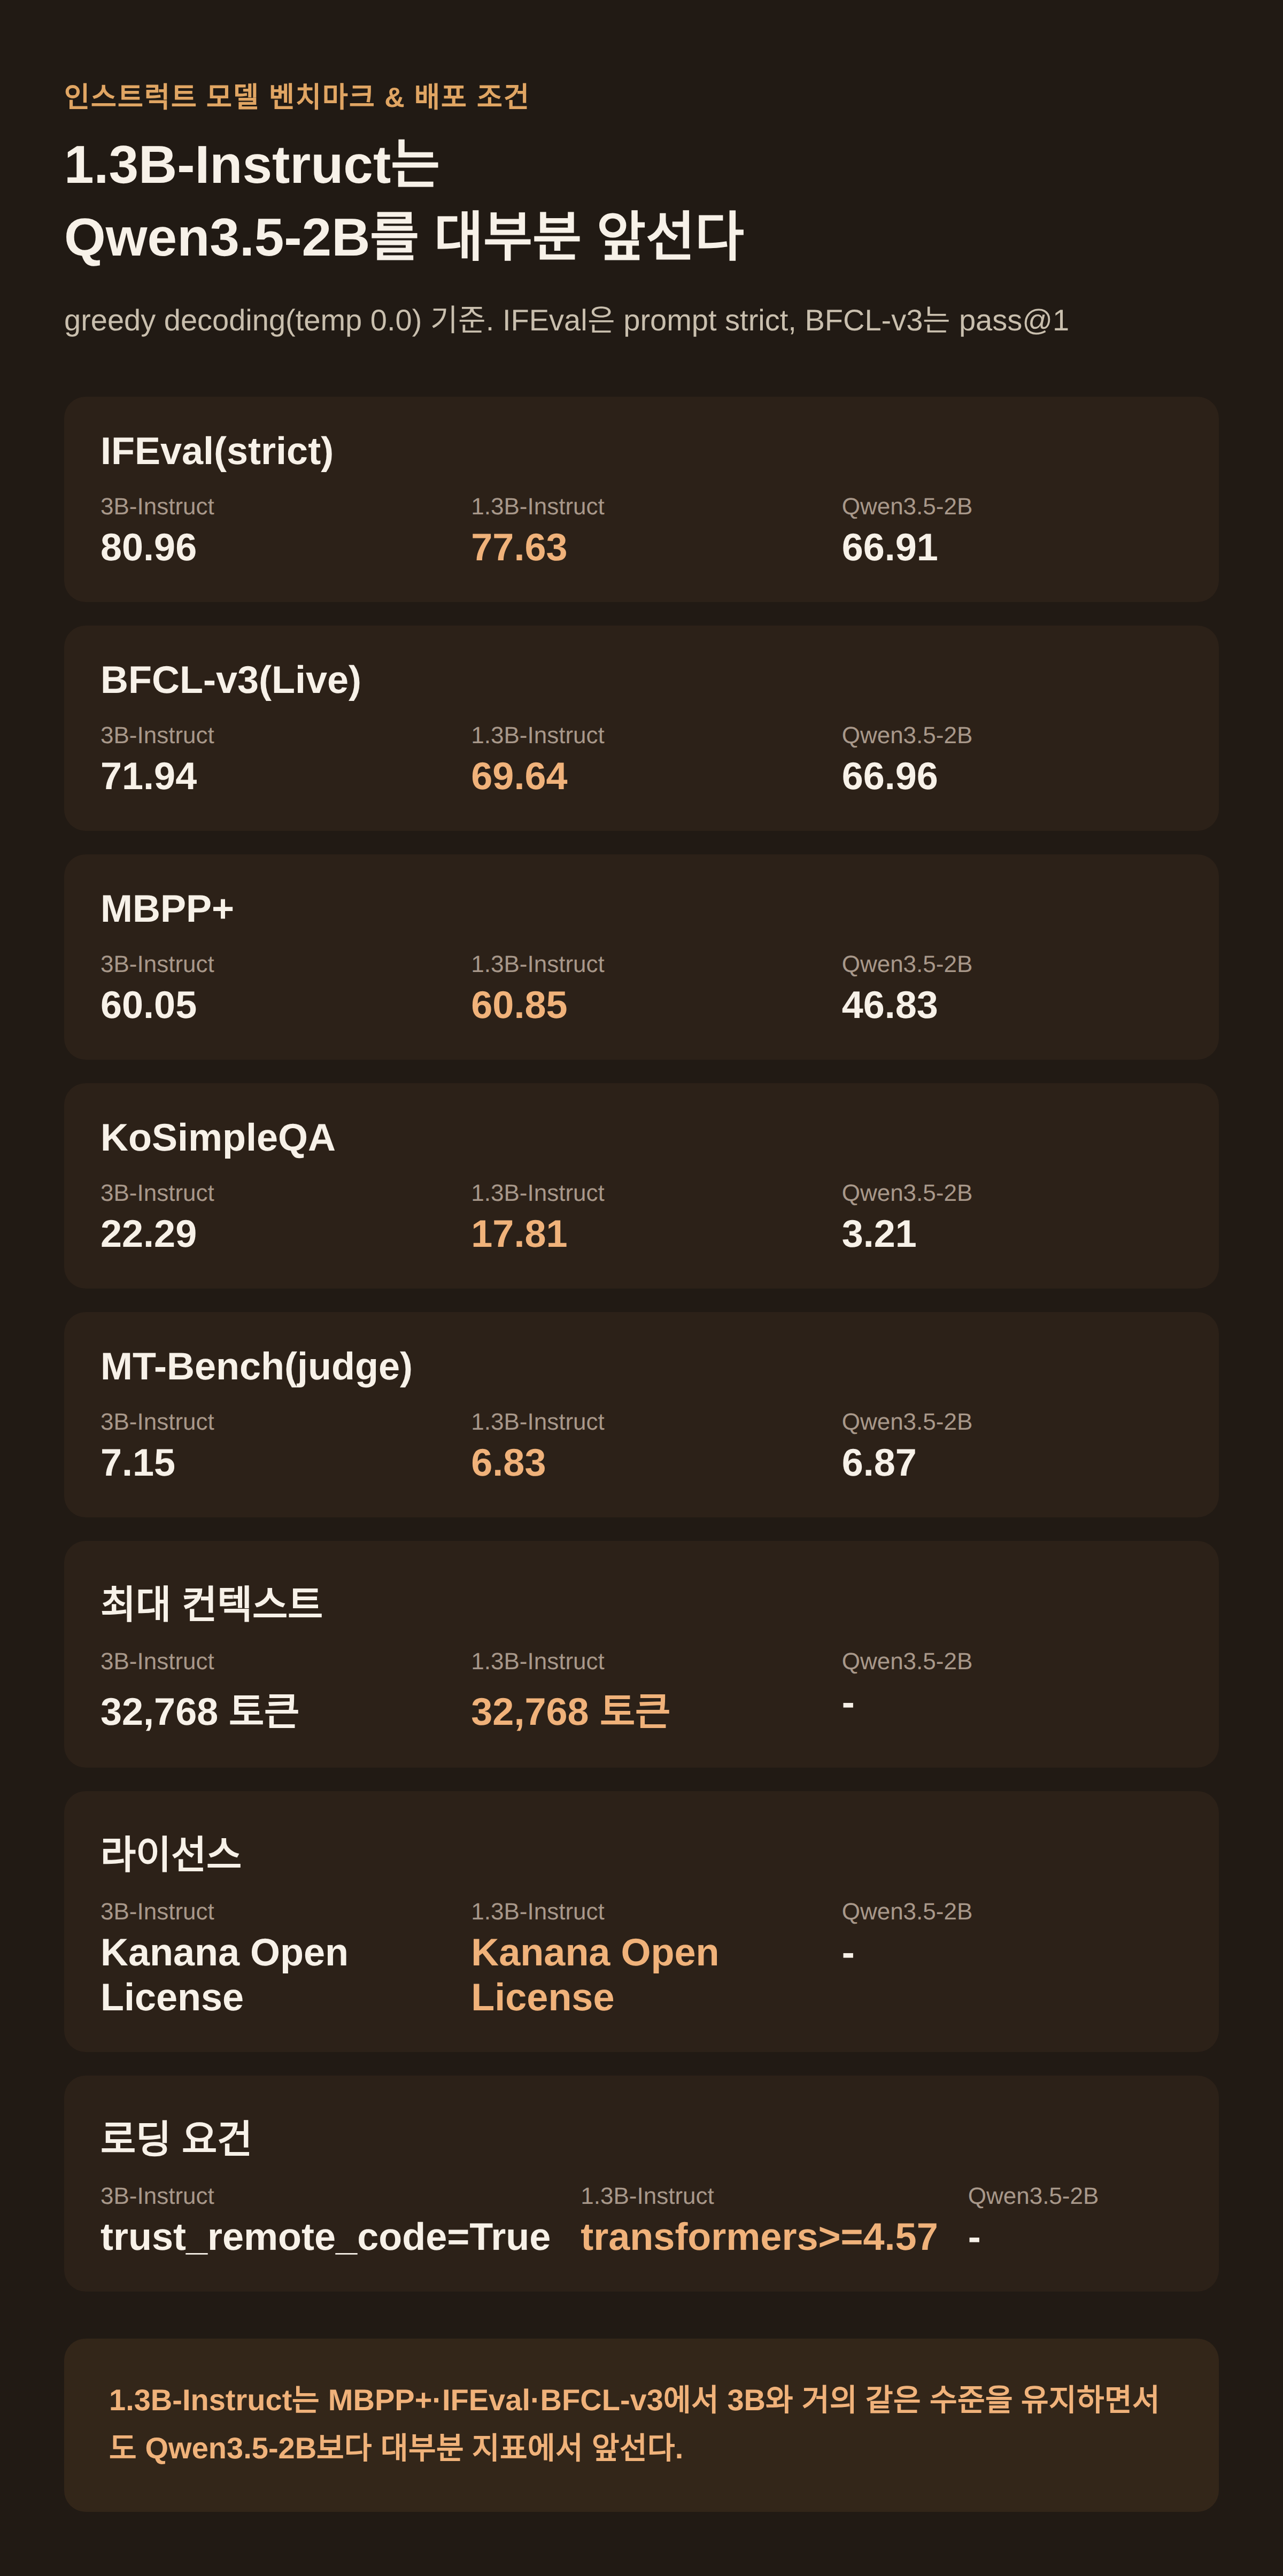
인스트럭트 모델 비교에서도 흐름은 비슷하다. Kanana-2-1.3B-Instruct는 IFEval(지시 따르기, prompt strict 기준) 77.63점으로 Qwen3.5-2B의 66.91점보다 높고, 도구 호출 능력을 보는 BFCL-v3(Live) 벤치마크에서도 69.64 대 66.96으로 앞섰다. 반면 수학 벤치마크인 MATH-500에서는 61.40으로 Qwen3.5-2B(67.80)보다 낮았다. 카카오는 인스트럭트 벤치마크를 온도 0.0의 그리디 디코딩, 최대 토큰 4096 조건으로 통일해 측정했다고 밝혔다.
실제로 어떻게 불러 쓰나
Kanana-2-1.3B-Base는 Qwen3 백본에 3:1 SWA/풀 어텐션 배치와 레이어별 RoPE를 결합한 커스텀 하이브리드 구조(Kanana2TinyForCausalLM)를 remote code 형태로 배포한다. 그래서 Hugging Face `transformers` 라이브러리로 불러올 때는 `trust_remote_code=True` 옵션과 `transformers 4.57` 이상 버전이 필요하다고 모델 카드에 명시돼 있다. 토크나이저 역시 이전 Kanana 세대 대비 한국어 토큰화 효율을 30% 이상 개선했다고 밝혔으며, 두 모델 모두 최대 32,768 토큰까지 네이티브로 지원한다.
라이선스는 어떻게 되나
가중치는 카카오가 자체적으로 만든 "Kanana Open License" 아래 배포된다. 아파치나 MIT 같은 범용 오픈소스 라이선스가 아니라 카카오가 별도로 작성한 이용 약관이며, 모델과 코드를 사용·복제·수정·배포·공개하는 모든 행위에 이 약관 동의가 적용된다고 명시돼 있다. 기술 지원 문의는 카나나 LLM 팀 이메일로, 사업 제휴 문의는 별도 창구로 분리해 뒀다.