
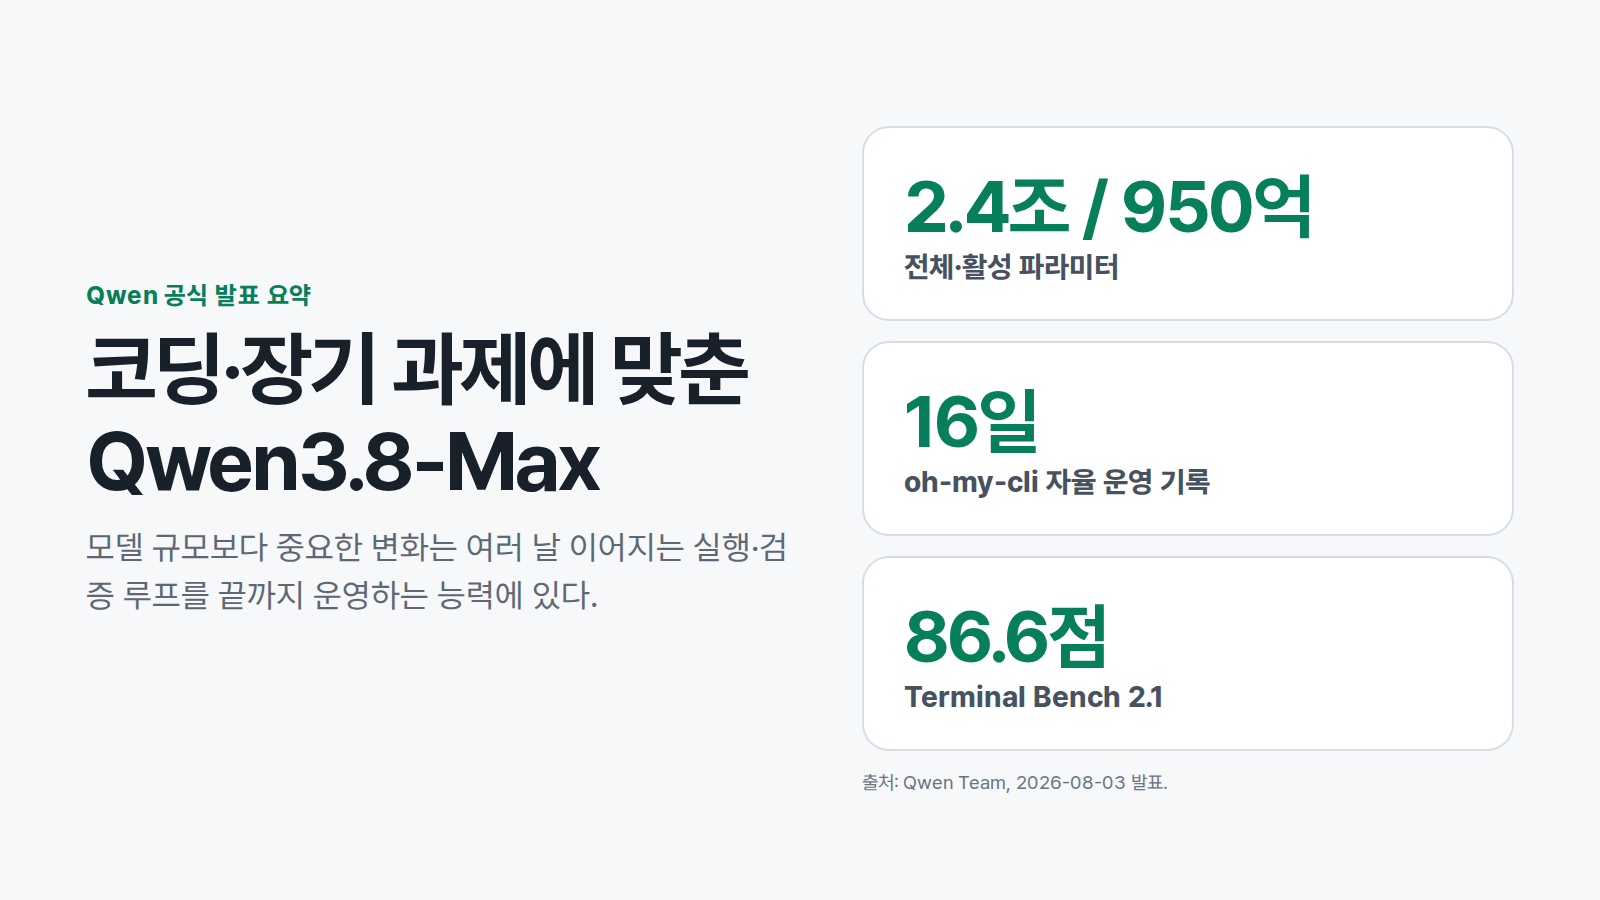
중국 알리바바 산하 Qwen 팀이 8월 3일 2.4조 파라미터 규모의 신형 모델 Qwen3.8-Max를 공개했다. Qwen3.5 아키텍처를 기반으로 확장한 이 모델은 QwenCloud를 통해 API로 바로 호출할 수 있으며, 가중치는 다음 주 Hugging Face와 ModelScope에 공개될 예정이다. Qwen 팀이 Max급 모델의 가중치를 공개하는 것은 이번이 처음이다. 2.4조 파라미터 중 실제로 추론에 쓰이는 활성 파라미터는 950억 개로, 나머지는 필요한 부분만 골라 쓰는 구조다.
Qwen 팀이 이번 발표에서 가장 힘주어 강조한 부분은 코딩과 실무 업무를 며칠에서 몇 주 단위로 사람 개입 없이 끝까지 해내는 능력이다. 발표 문서에는 이를 뒷받침하는 세 가지 코딩 사례와, 반도체 설계·전자상거래 운영 시뮬레이션 같은 장기 과제 실험 결과가 함께 실렸다.
16일 동안 혼자 코드를 고친 오픈소스 프로젝트
Qwen 팀은 Qwen3.8-Max에게 oh-my-cli라는 프로젝트를 빈 폴더에서부터 만들도록 시킨 뒤, 스스로 개선을 이어가는 개발 루프를 붙였다. 새 요구사항이 GitHub 이슈로 들어오면 모델이 직접 이슈를 골라 ready·leased·active 상태를 거쳐 구현하고, 빌드·유닛테스트·E2E 테스트를 통과한 뒤 PR을 병합하는 과정을 전부 자동으로 처리한다. 이 전체 기록은 GitHub 저장소 qwen-code-dev-bot/oh-my-cli에 공개돼 있다. 2026년 7월 30일 기준으로 약 16일간 완전 자율 운영한 결과 265건의 커밋, 127건의 PR, 151건의 이슈가 쌓였다.
같은 발표에서 Qwen 팀은 최근 논문 "Unified Data Selection for LLM Reasoning"을 아무 코드 없이 논문 텍스트와 GPU만 주고 재현하도록 시킨 실험도 공개했다. Qwen3.8-Max는 약 5일(125시간) 동안 혼자 작업해 코드 7,600줄을 작성하고 1,100회의 작업을 실행하며 33차례 GPU 학습을 돌렸다. 먼저 37시간에 걸쳐 논문의 파이프라인을 처음부터 재구성해 6개 핵심 결과를 재현했고, 수학 벤치마크 AIME24에서 논문이 제시한 데이터 선별법이 무작위 선택보다 7.7%포인트 높다는 결과를 확인했다. 이후 88시간 동안 가설 수립→코드 작성→GPU 실행→분석→재시도를 반복하는 자체 개선 루프를 4라운드에 걸쳐 18개 아이디어로 돌렸고, 최종적으로 논문의 방법보다 AIME24에서 2.7%포인트 더 높은 새로운 방법을 스스로 찾아냈다.
반도체 회로 설계에서는 게이트 수를 92%까지 줄였다
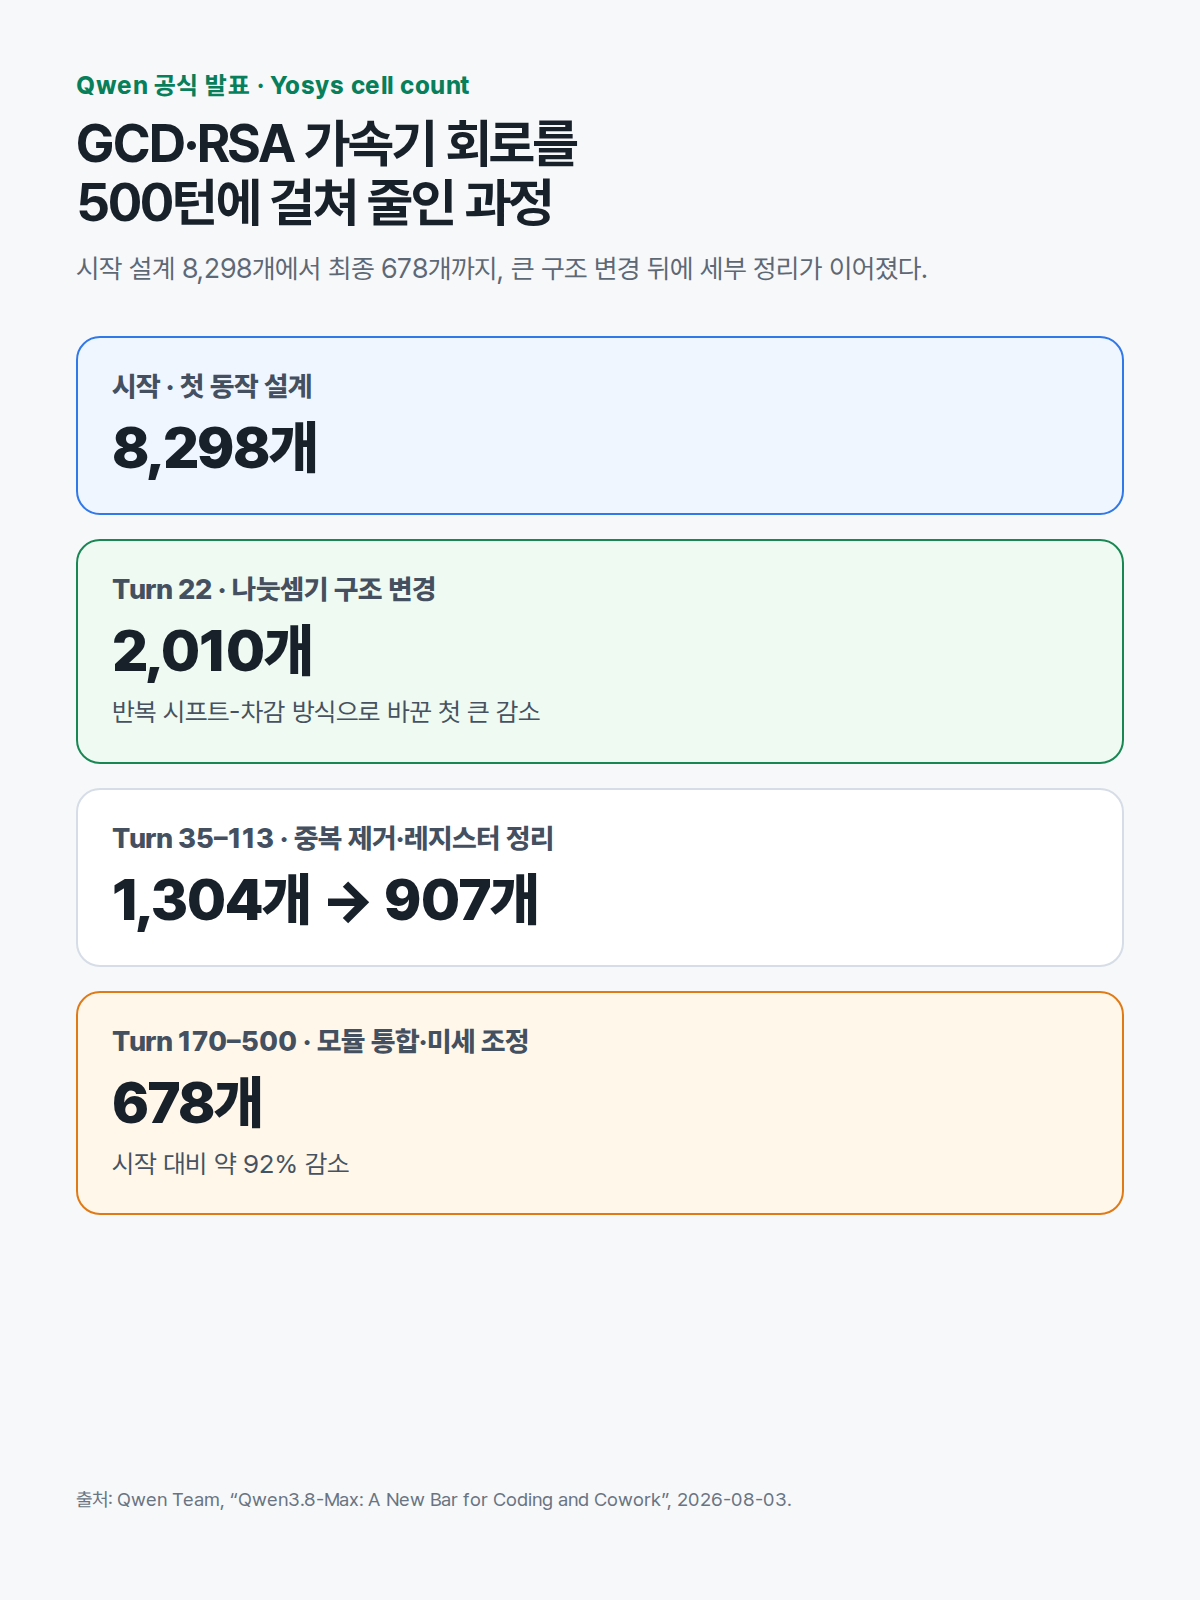
장기 과제 능력을 보여주는 또 다른 사례는 디지털 칩 설계다. Qwen3.8-Max는 모듈러 지수·모듈러 곱셈을 포함한 GCD·RSA 암호 가속기 회로를 스스로 설계했다. 시뮬레이션 도구 Iverilog, 합성 도구 Yosys, 물리 배치 도구 OpenROAD를 연결한 샌드박스 환경에서 기준 회로도 없이 약 500턴, 71회 평가를 거쳐 회로를 반복적으로 고쳤다. 처음 동작한 설계는 게이트 8,298개였지만, 나눗셈기를 반복 시프트-차감 구조로 바꾼 22턴째의 개선(6,288개 감소)을 시작으로 레지스터 정리, 모듈 통합, 게이트 단위 미세 조정을 거치며 최종 678개까지 줄였다. 이 최적화 결과를 실제 배치·배선까지 돌려본 결과 다이 면적은 106×106제곱마이크로미터에서 46×46제곱마이크로미터로, 배선 길이는 33,369마이크로미터에서 4,187마이크로미터로 줄었고 500메가헤르츠에서 타이밍 여유가 -4.46나노초의 위반 상태에서 +0.66나노초로 개선됐다.
1년짜리 전자상거래 운영에서 낸 성과
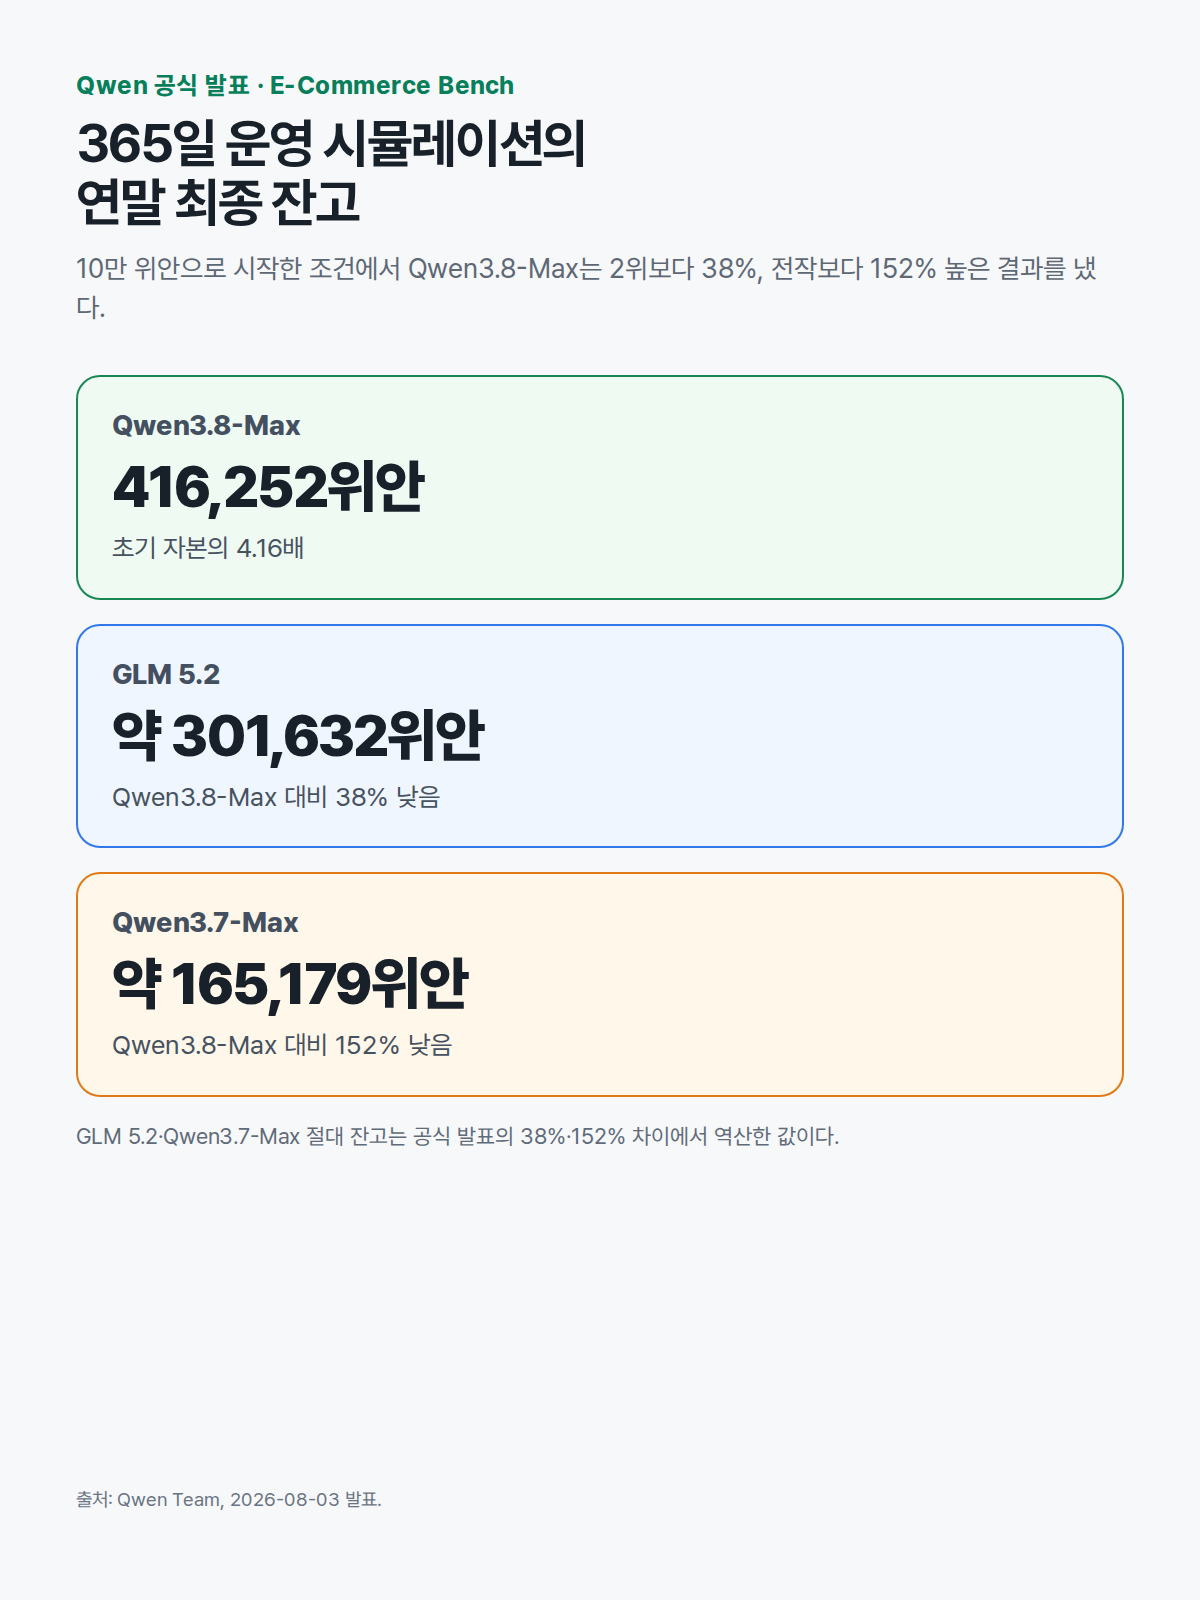
Qwen 팀은 실제 업무 능력을 검증하기 위해 타오바오·티몰의 비식별 거래 데이터를 기반으로 만든 365일짜리 전자상거래 운영 시뮬레이션 E-Commerce Bench도 활용했다. 12개 매장 유형, 60개 상품군, 공급업체 600곳, 상품 7,000개 규모의 환경에서 모델에게 10만 위안의 초기 자본을 주고 여러 매장을 동시에 운영하도록 했다. 공급업체 매트릭스에는 사기성 거래처 152곳이 섞여 있고, 성수기 주문 폭증과 공급망 위기가 무작위로 발생하는 조건이었다. Qwen3.8-Max는 최종 잔고 41만 6,252위안(투자 대비 4.16배)을 기록해 2위인 GLM 5.2보다 38% 높았고, 전작 Qwen3.7-Max보다는 152% 개선된 결과였다. 협상 과정에서는 같은 공급업체와 반복 교섭할수록 매입 단가를 점진적으로 낮추는 학습 패턴을 보였고, 이 경험을 비슷한 상품에도 일반화해 적용했다.
코딩 벤치마크에서 어느 정도 자리를 잡았나
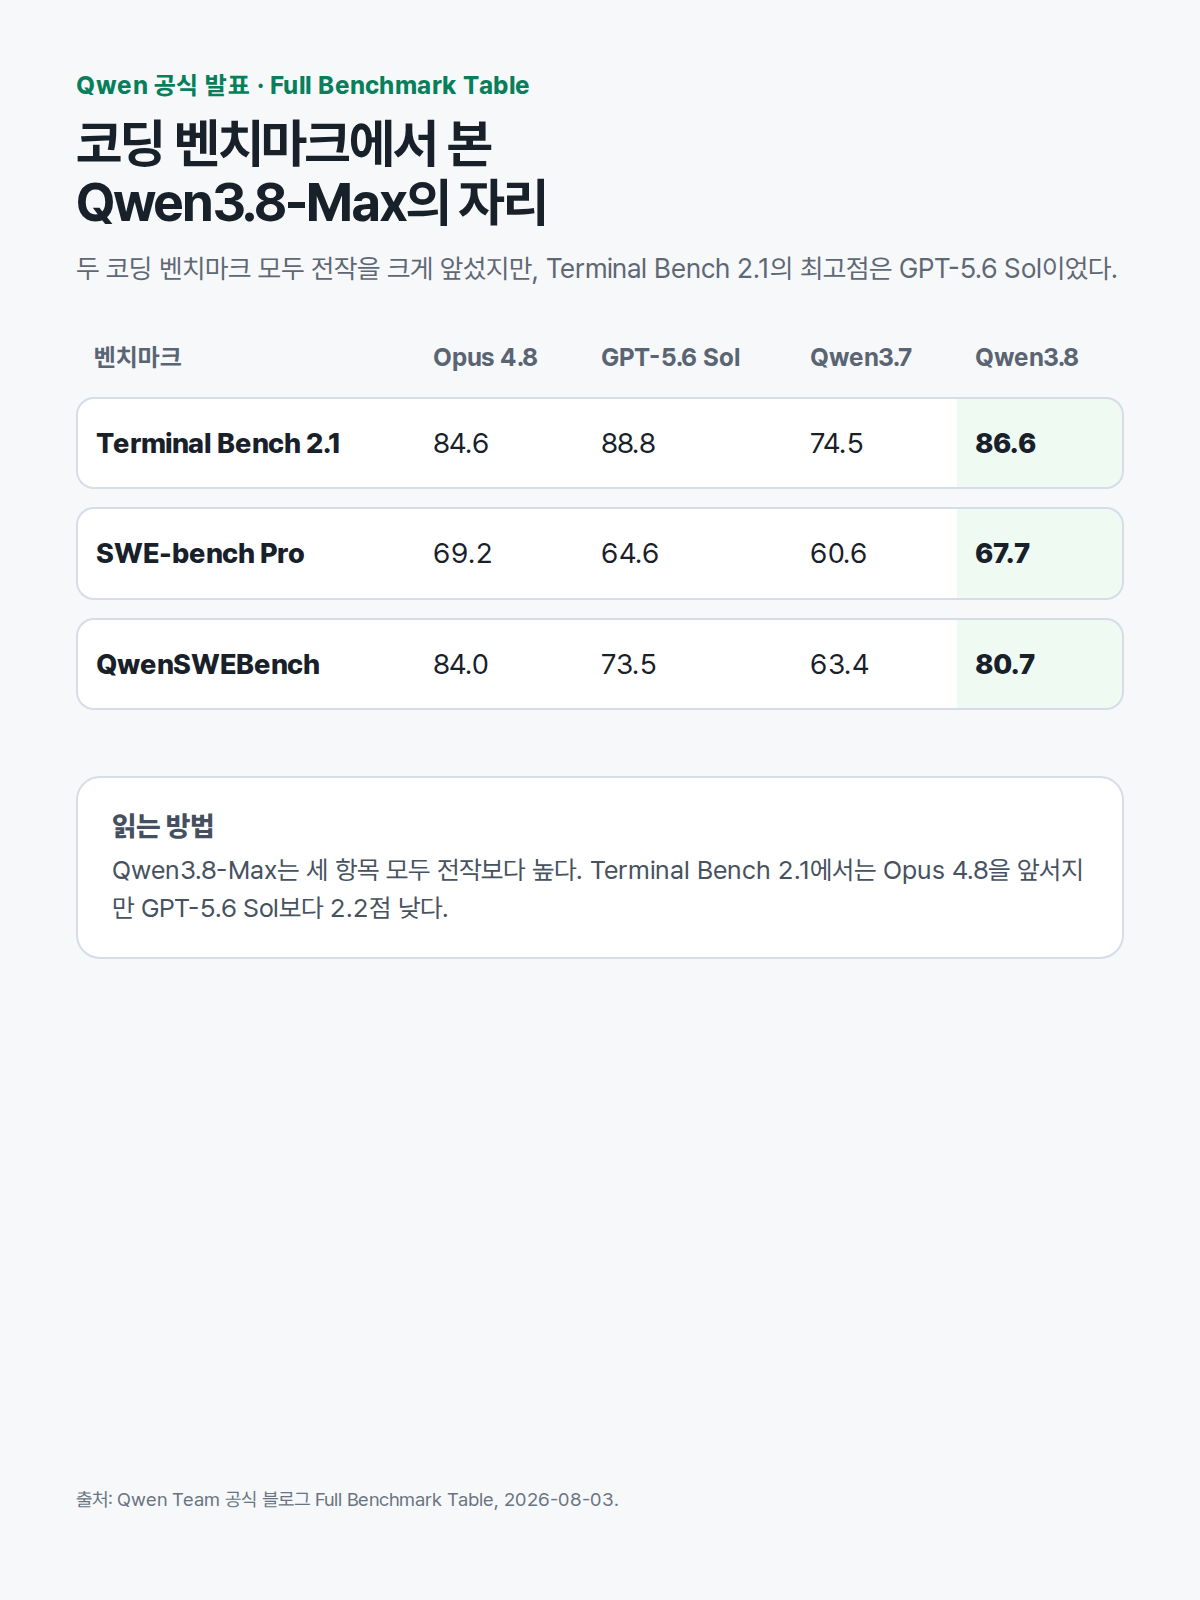
Qwen 팀이 공개한 벤치마크 표에서 Qwen3.8-Max는 Anthropic의 Claude Opus 4.8, Claude Fable 5, OpenAI GPT-5.6 Sol과 나란히 비교된다. 실제 터미널 작업 능력을 재는 Terminal Bench 2.1에서 86.6점을 받아 전작 Qwen3.7-Max의 74.5점보다 12.1점 올랐고, Claude Opus 4.8(84.6점)을 앞섰지만 GPT-5.6 Sol(88.8점)에는 못 미쳤다. 실제 저장소 이슈 해결 능력을 보는 SWE-bench Pro에서는 67.7점으로 전작보다 7.1점 높아졌다. 다만 모든 지표에서 1위는 아니다. 범용 추론 벤치마크 HLE에서는 43.6점으로 4개 모델 중 가장 낮았고, 장문 이해 LongBench v2에서도 66.3점으로 최하위권에 속한다. 코딩·업무 자동화 쪽에 강점이 몰려 있고 순수 지식 추론에서는 상대적으로 약하다는 뜻이다.
개발 도구에는 어떻게 붙이나
Qwen3.8-Max는 API에서 reasoning_effort 파라미터로 xhigh(기본값)·medium·low 세 단계의 추론 깊이를 선택할 수 있어, 비용과 응답 속도를 작업 난이도에 맞춰 조절할 수 있다. 연동 방식도 기존 코딩 어시스턴트에 맞춰져 있다. Anthropic API 프로토콜을 지원해 환경변수 설정만으로 Claude Code에 Qwen3.8-Max를 그대로 붙일 수 있고, OpenAI Responses 프로토콜을 지원해 Codex의 모델 카탈로그에 등록해 쓸 수도 있다. Qwen 팀이 직접 만든 Qwen Code CLI, 그리고 Qoder·OpenClaw 같은 외부 에이전트 도구용 연동 방법도 함께 공개됐다.
출처: Qwen Team, "Qwen3.8-Max: A New Bar for Coding and Cowork"