
개인 개발자 leonickson이 8월 3일 GitHub에 공개한 오픈소스 런타임 Swiftlet은 800억 파라미터급 Qwen3-Next-80B-A3B 모델을 맥에서 피크 RAM 4.3GB로, 350억 파라미터급 Qwen3.6-35B-A3B 모델을 아이폰에서 약 2.5GB RAM으로 돌린다. Swift와 Metal로 짠 이 런타임은 두 모델 모두 4비트로 양자화해 자체 컨테이너 포맷 `.qpack`에 담고, 실제 추론에 쓰이는 라우팅된 익스퍼트(전문가 서브네트워크)만 그때그때 SSD에서 읽어오는 방식으로 이 수치를 만들었다.
Hacker News의 "Show HN" 게시물로 처음 알려진 이 프로젝트는 공개 첫날 포인트 123점, 댓글 8건을 받았고, GitHub 저장소는 스타 115개가 붙었다. 두 모델의 4비트 양자화 가중치는 Hugging Face에 leonickson 계정으로 이미 올라와 있고, 아이폰에서는 leonickson이 직접 만든 오픈소스 앱 Priv AI(App Store 출시, 소스코드는 별도 저장소 localLLM에 공개)를 통해 다운로드해 쓸 수 있다.
같은 모델을 왜 이렇게 적은 메모리로 돌릴 수 있나
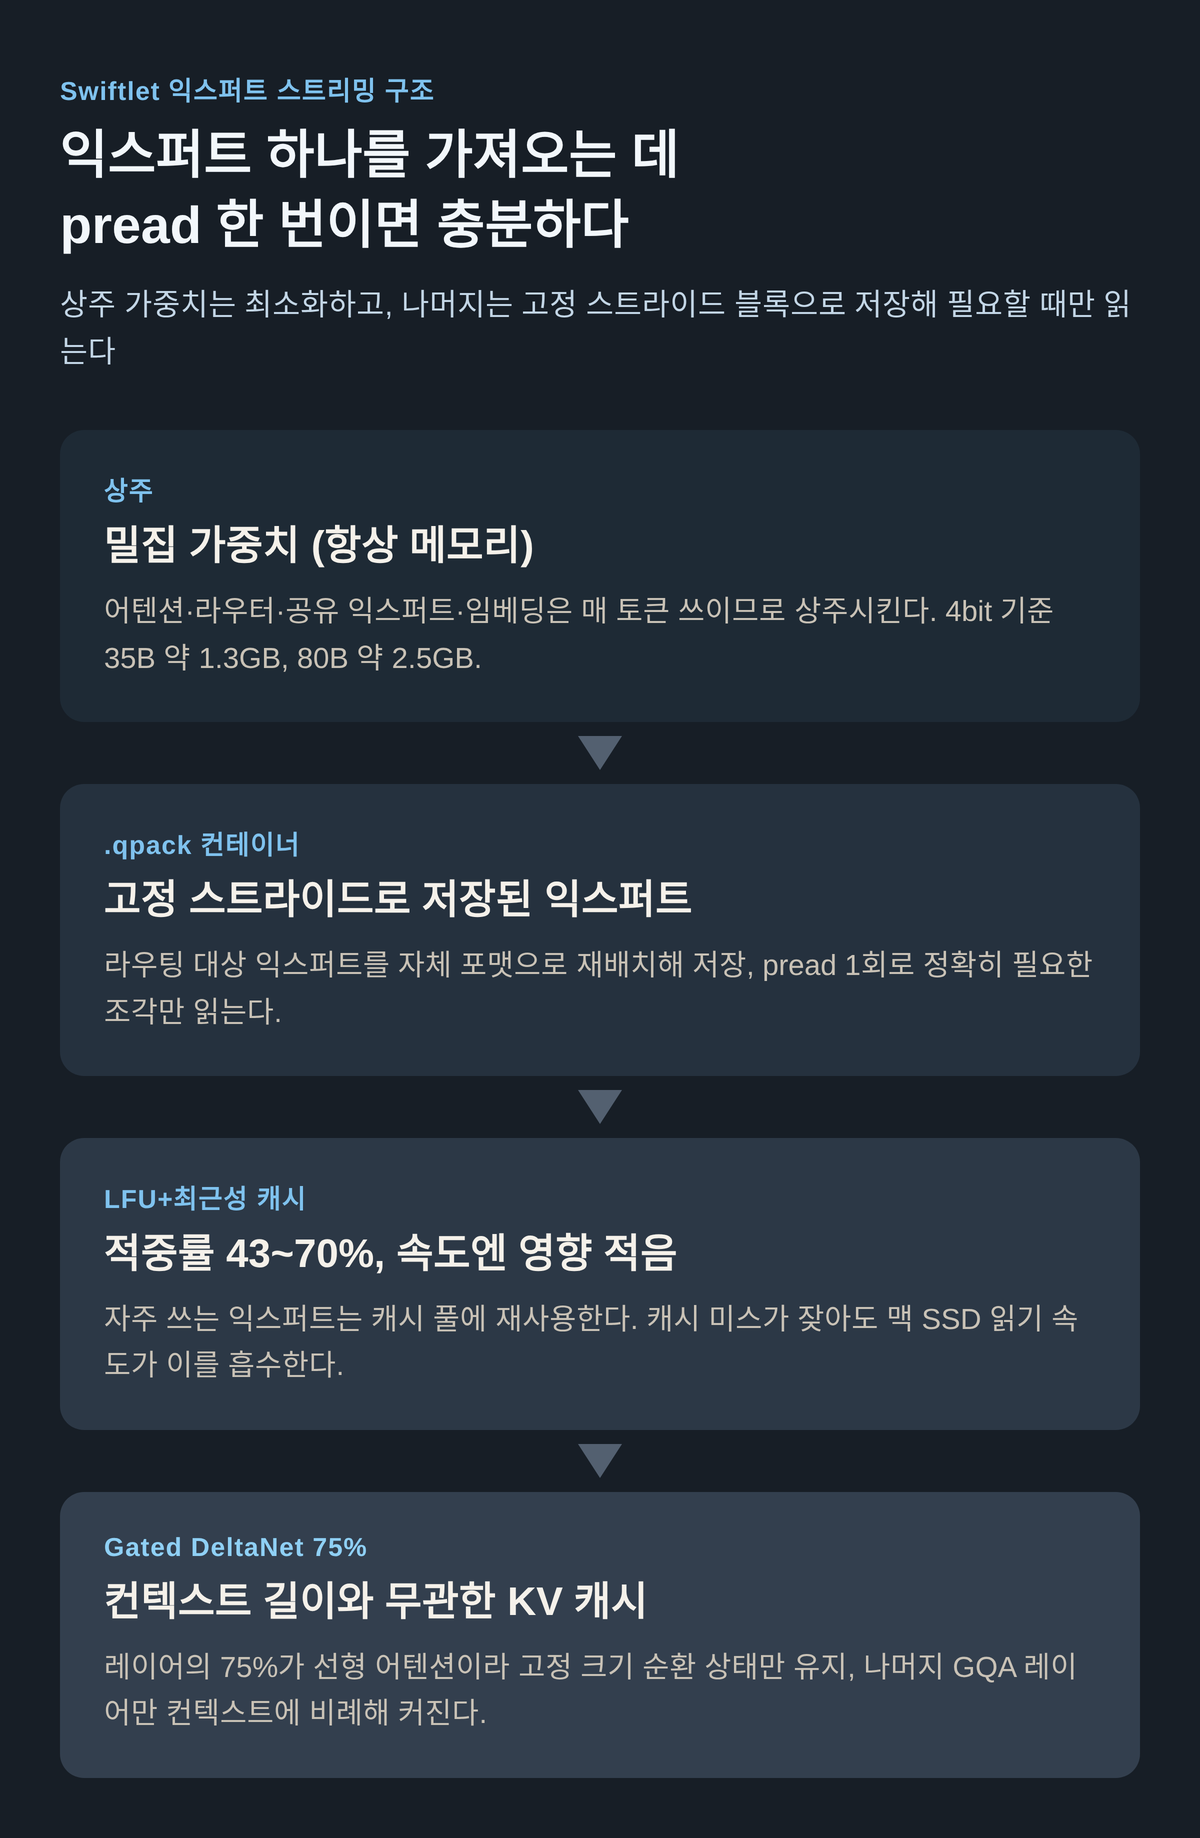
Qwen3-Next-80B-A3B와 Qwen3.6-35B-A3B는 이름의 A3B가 뜻하는 대로 토큰 하나를 처리할 때 실제로 계산에 관여하는 파라미터가 약 30억 개뿐인 MoE(Mixture-of-Experts) 구조다. 80B 모델은 레이어마다 512개 익스퍼트 중 10개를, 35B 모델은 256개 중 8개를 선택해 계산한다. Swiftlet은 어텐션, 라우터, 공유 익스퍼트, 임베딩처럼 매 토큰 항상 쓰이는 밀집(dense) 가중치만 메모리에 상주시키고(4비트 기준 35B는 약 1.3GB, 80B는 약 2.5GB), 수만 개에 달하는 라우팅 대상 익스퍼트는 `.qpack`이라는 자체 컨테이너 포맷으로 고정 스트라이드(간격) 블록에 재배치해 저장해 둔다. 이렇게 하면 익스퍼트 하나를 가져오는 작업이 정확히 `pread` 시스템 콜 한 번으로 끝나, mmap을 매개로 한 페이지 캐시 스래싱(빈번한 페이지 교체로 인한 성능 저하) 없이 필요한 조각만 디스크에서 곧바로 읽어올 수 있다.
여기에 더해 레이어의 75%는 Gated DeltaNet이라는 선형 어텐션 구조를 쓴다. 일반적인 트랜스포머의 어텐션은 컨텍스트가 길어질수록 KV 캐시가 계속 커지지만, DeltaNet 레이어는 고정 크기의 순환 상태만 유지하므로 컨텍스트 길이와 무관하게 메모리 사용량이 늘지 않는다. 나머지 GQA(Grouped-Query Attention) 레이어에서만 컨텍스트 길이에 비례하는 KV 캐시가 필요하다. 자주 쓰는 익스퍼트는 LFU(최소 사용 빈도)와 최근성을 함께 반영하는 캐시 풀에 담아 재사용하는데, 저장소 README에 실린 측정치로는 이 캐시의 적중률이 43~70% 사이에서 움직이는데도 처리 속도 자체는 크게 달라지지 않았다고 한다. 그만큼 애플 실리콘 맥의 SSD 읽기 속도가 캐시 미스를 흡수할 만큼 빠르다는 뜻이다.
실제 속도는 어느 정도이고, 어디가 느린가
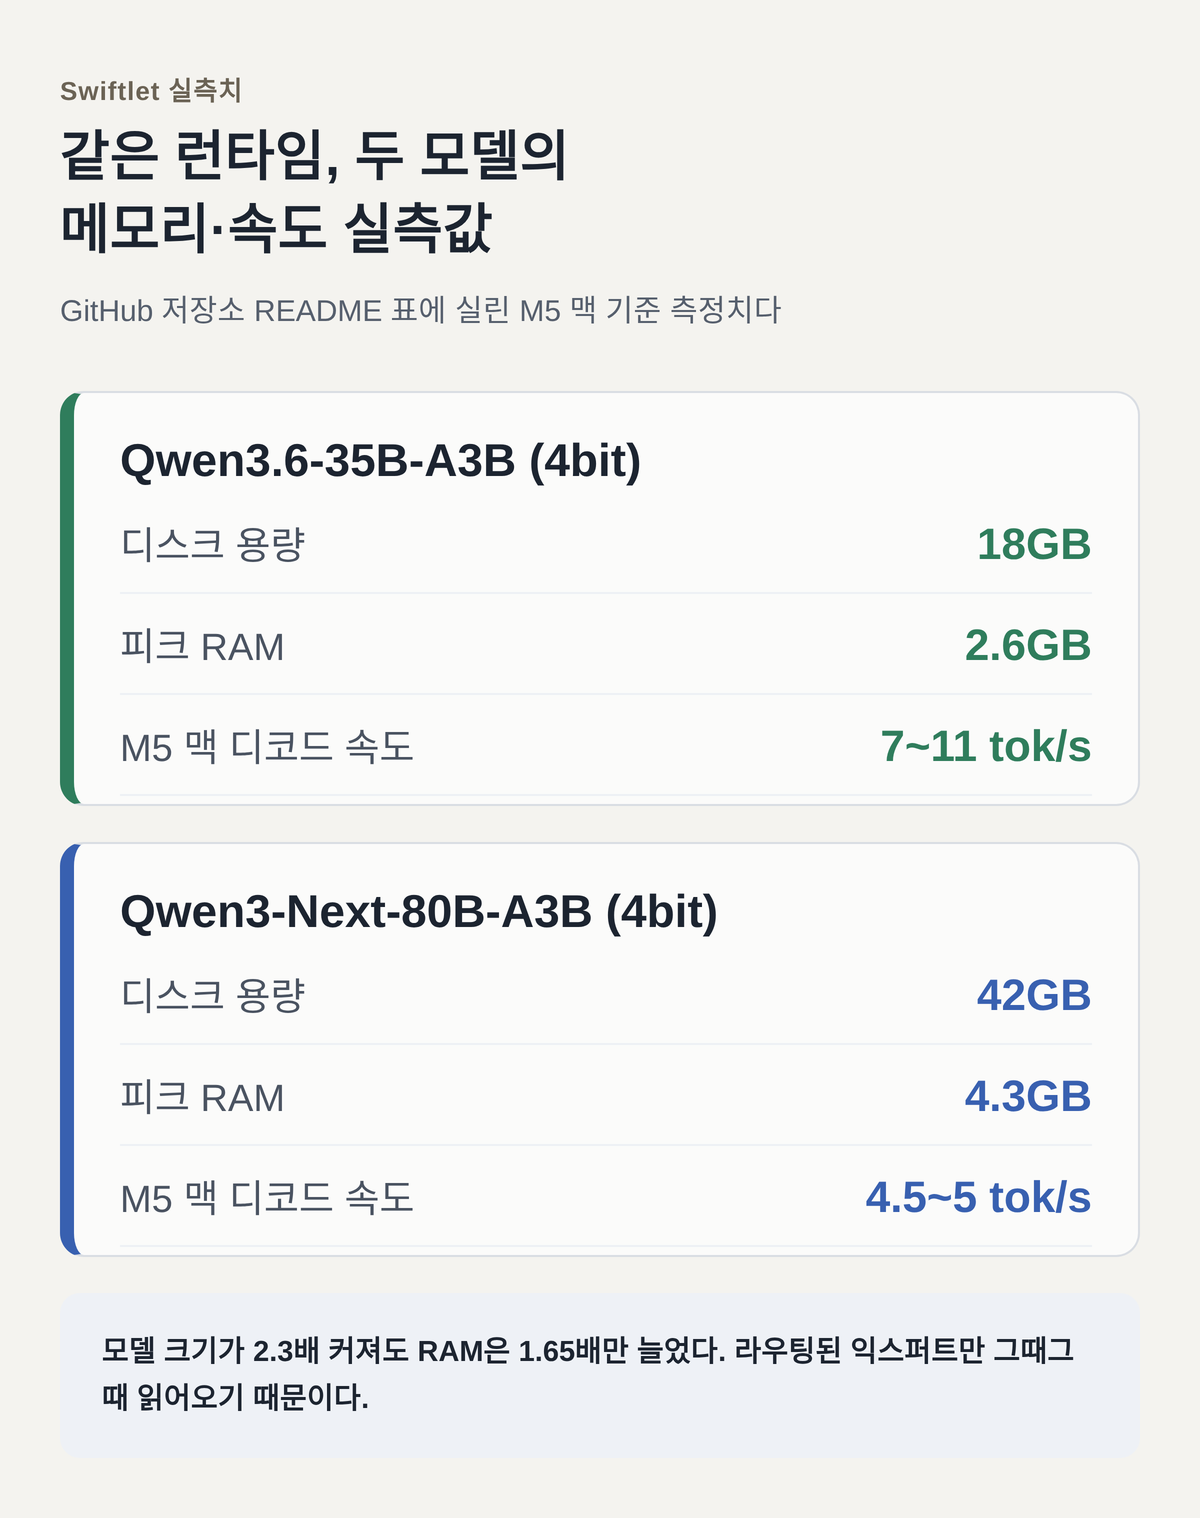
GitHub README에 실린 M5 맥 기준 실측치는 Qwen3.6-35B-A3B가 초당 7~11토큰, Qwen3-Next-80B-A3B가 초당 4.5~5토큰이다. 디스크에는 각각 18GB, 42GB짜리 컨테이너가 필요하고, 두 모델 모두 4비트 양자화 상태로 이 속도가 나온다. 저장소는 이 결과를 두고 현재 병목은 저장소 I/O가 아니라 디코드 루프의 디스패치(GPU에 작업을 내려보내는 오버헤드) 쪽이라고 밝히며, 이 부분에 아직 개선 여지가 있다고 설명한다. 활성 파라미터가 토큰당 약 30억 개뿐이라는 것은 이 모델들이 대형 모델처럼 말하고 쓰지만, 사실 회상 능력은 그보다 작은 모델 수준이라는 뜻이기도 하다고 저장소는 미리 밝히고 있다.
Hacker News 댓글에서는 이 접근의 실용성을 둘러싼 반응이 갈렸다. 한 댓글은 "디코드 시간이 전체를 말해주지 않는다. 프리필(초기 문맥 처리)이 병목이 되기 때문"이라며 M5에서 1만 토큰을 처리하는 데 30분이 걸리는 건 좋지 않다고 지적했다. 반면 다른 댓글은 "이런 시도들이 하드드라이브를 마모시키고 느리다는 단점을 갖고 있지만, 이런 식으로 계속 파고들다 보면 결국 진전이 나온다"며 "1조 파라미터 모델이 5만 달러짜리 GPU 랙 대신 200달러짜리 SSD로 돌아가는 날을 기다린다"고 답했다.
이 프로젝트가 참고한 앞선 작업과, Swiftlet이 새로 만든 부분
Swiftlet의 저장소는 이 익스퍼트 스트리밍 아이디어 자체를 처음 증명한 것은 Gemma 계열 모델을 대상으로 한 TurboFieldfare 프로젝트라고 밝히고, `pread` 기반 스트리밍, LFU+최근성 캐시 교체, 고정 스트라이드 패킹, 런타임 셰이더 컴파일 같은 설계 아이디어를 이어받았다고 명시했다. 그 위에 Swiftlet이 새로 만든 부분은 Qwen 하이브리드 아키텍처(Gated DeltaNet 선형 어텐션과 게이트 GQA, 고희소성 MoE) 지원, MLX 방식의 int4/int8 그룹 양자화 연산을 Metal로 직접 구현한 부분, mlx-lm 참조 구현과 레이어 단위로 대조하는 검증 체계, `.qpack` 컨테이너와 리패커, Hugging Face에서 재개 가능한 스트리밍 다운로드, 그리고 아이폰 지원 전체다. 약 1만 줄의 Swift·Metal 코드로 이 부분을 새로 작성했다고 밝혔으며, README는 이 프로젝트가 Claude Code와 협업해 만들어졌다고도 적었다. TurboFieldfare 저장소 관리자도 해당 Hacker News 스레드에 직접 댓글을 달아 "이 프로젝트가 시작점으로 TurboFieldfare를 써 줘서 고맙다"고 답했다.
아이폰에서는 어떻게 2.5GB로 35B 모델이 돌아가나
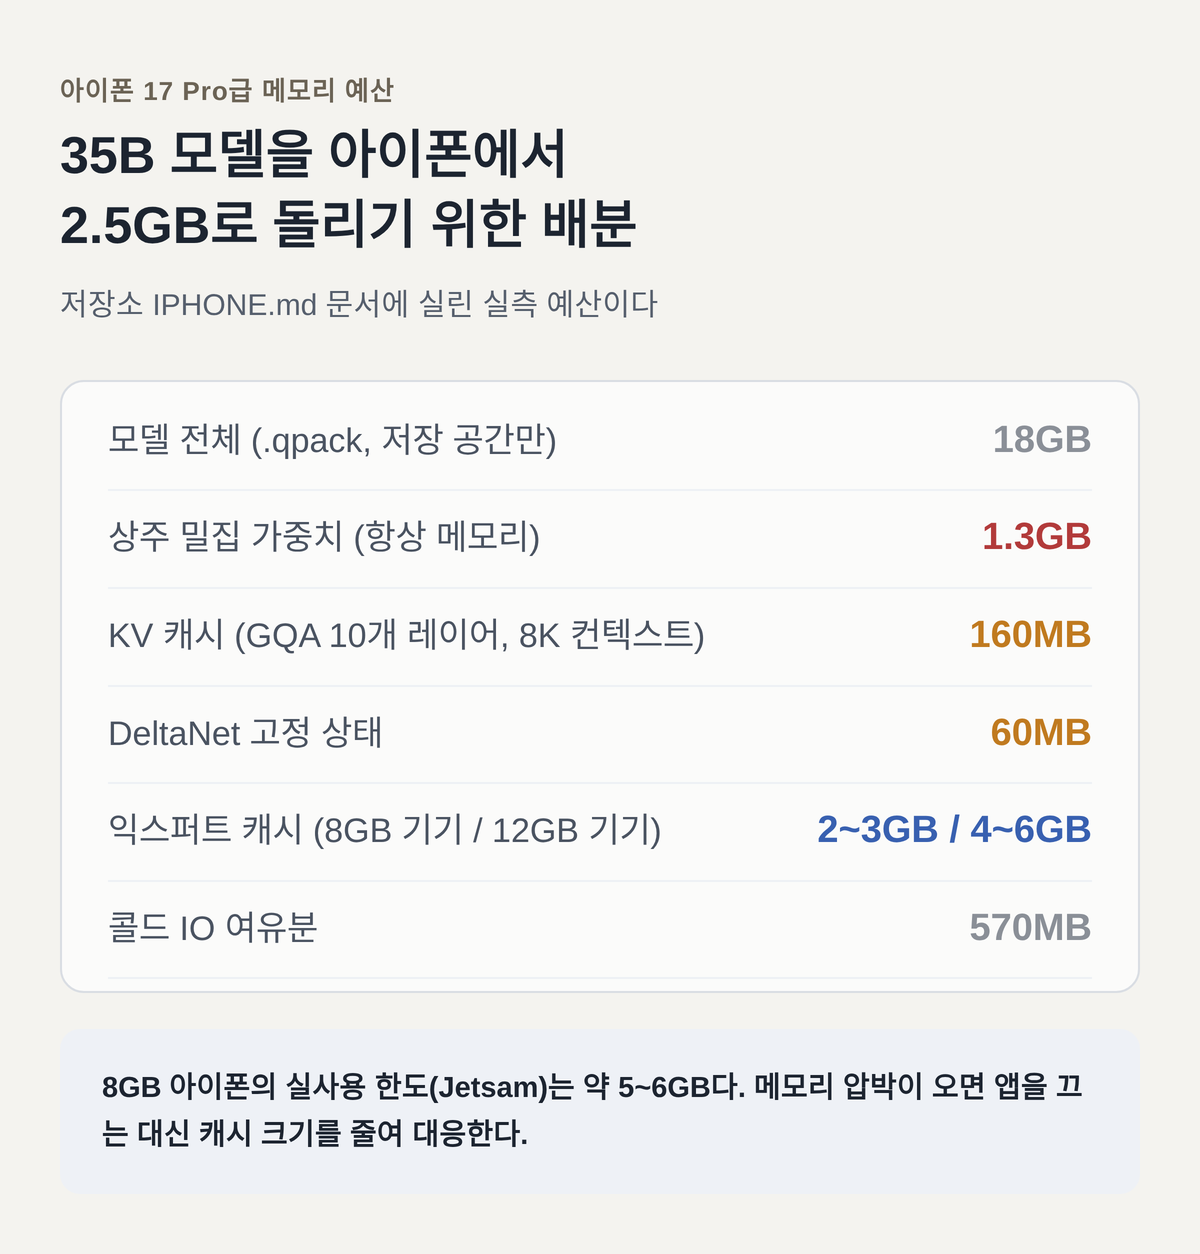
저장소의 IPHONE.md 문서에 실린 아이폰 17 프로급 기기 기준 메모리 예산을 보면, 18GB 용량의 `.qpack` 컨테이너는 저장 공간에만 있고, 상주해야 하는 밀집 가중치는 약 1.3GB, 컨텍스트 8K 기준 GQA 레이어 10개의 KV 캐시가 약 160MB, DeltaNet 고정 상태가 약 60MB다. 여기에 익스퍼트 캐시로 8GB 기기는 2~3GB, 12GB 기기는 4~6GB를 배정한다. 아이폰은 앱마다 커널이 강제하는 메모리 상한(Jetsam)이 있어 8GB 기기 기준 실사용 가능한 한도가 약 5~6GB인데, Swiftlet은 이 상한에 걸리지 않도록 메모리 압박 알림을 받으면 프로세스를 종료시키는 대신 캐시 크기를 줄이도록 설계했다고 문서는 설명한다.
이 기능은 App Store에 출시된 Priv AI 앱의 "Experimental Models" 메뉴에서 다운로드해 쓸 수 있다. 다만 이 기능이 담긴 최신 버전은 README 작성 시점에 App Store 심사 중이라 실제 반영까지 며칠 걸릴 수 있다고 안내하고 있어, 지금 당장 아이폰에서 써 보려면 오픈소스로 공개된 localLLM 앱 저장소를 직접 받아 Xcode로 빌드하는 방법도 함께 제시했다. Priv AI 자체는 온디바이스 LLM 채팅 외에도 HealthKit 기반 건강 인사이트, PDF 명세서 기반 가계부 추적 기능을 포함한 프라이버시 중심 iOS 앱이다.