
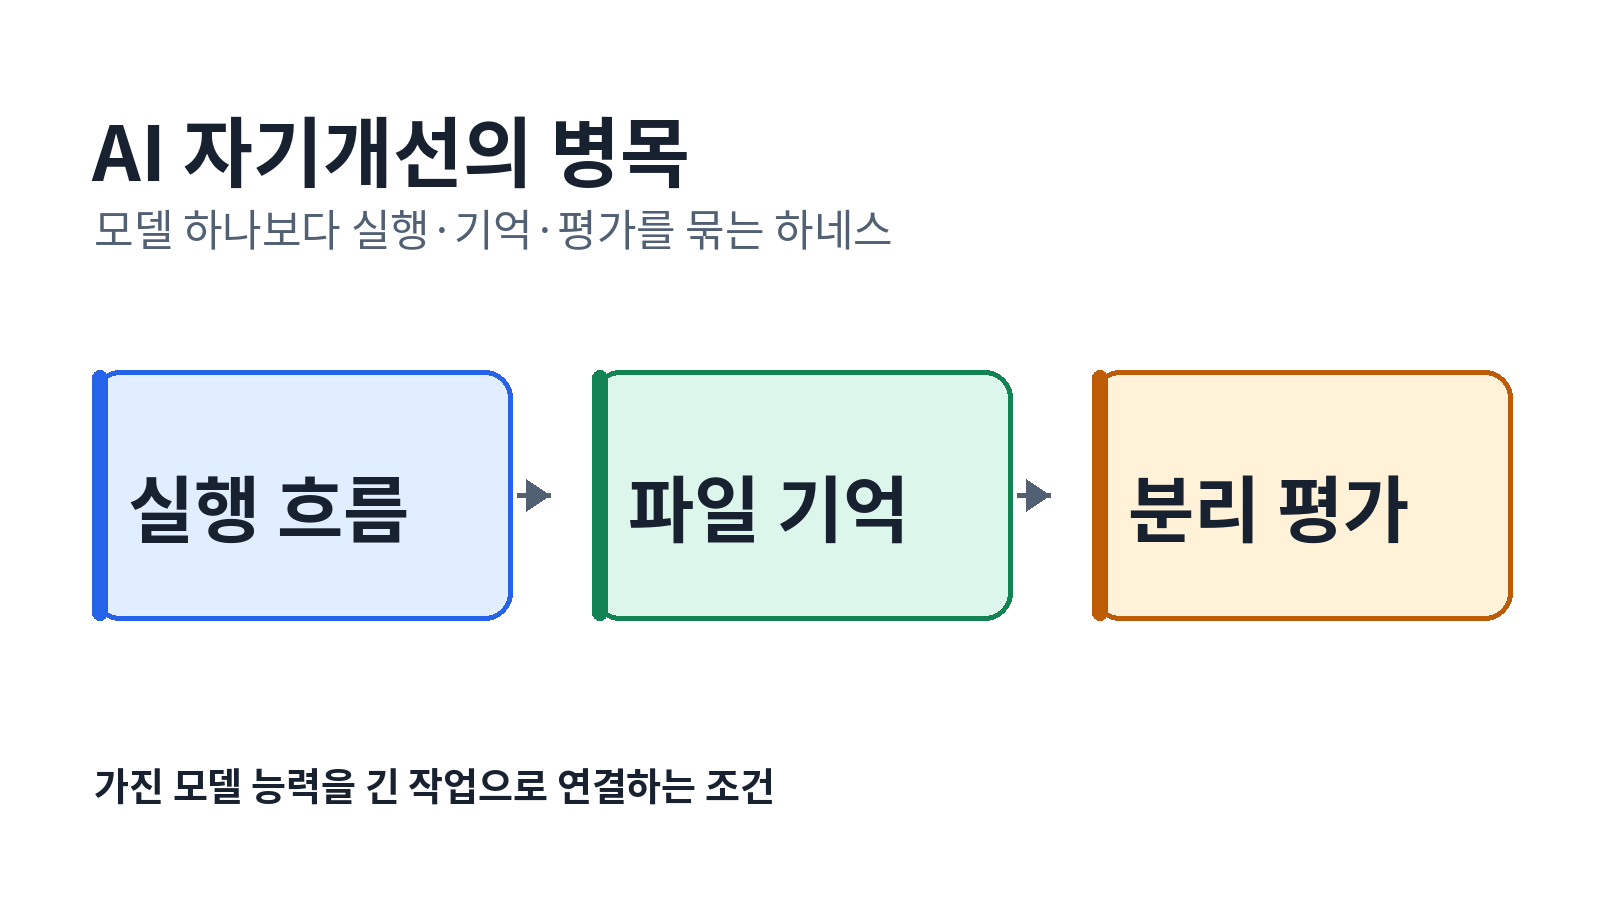
AI가 스스로 더 나은 AI를 만드는 장면을 떠올리면 먼저 모델 가중치의 직접 수정부터 생각하기 쉽다. Lilian Weng은 2026년 7월 4일 정리한 글에서, 가까운 시기의 더 실용적인 경로는 모델 바깥의 하네스, 즉 모델이 일하고 검증하는 실행 시스템을 개선하는 데 있다고 본다.
하네스는 프롬프트 한 장이 아니다. 모델이 무엇을 계획하고 어떤 도구를 호출할지, 긴 작업의 맥락을 어떻게 보존할지, 산출물을 어디에 남길지, 결과를 어떤 평가로 통과시킬지 정하는 층이다. 같은 모델을 써도 이 층이 달라지면 도구 사용의 순서와 실패를 되돌아보는 방식, 다음 실행에 남는 기록이 달라진다.
하네스는 모델과 현실 사이에서 무엇을 결정하나
초기 에이전트 설명은 흔히 ‘LLM에 메모리·도구·계획·행동을 더한 것’으로 끝났다. Weng의 정리에서 하네스 엔지니어링은 여기에 작업 흐름, 평가, 권한 제어, 영속 상태 관리를 넣는다. 모델의 다음 답을 잘 만드는 일과, 그 답이 실제 파일·명령·서비스에 닿는 방식을 안전하게 운영하는 일이 한 시스템 안에서 만난다.
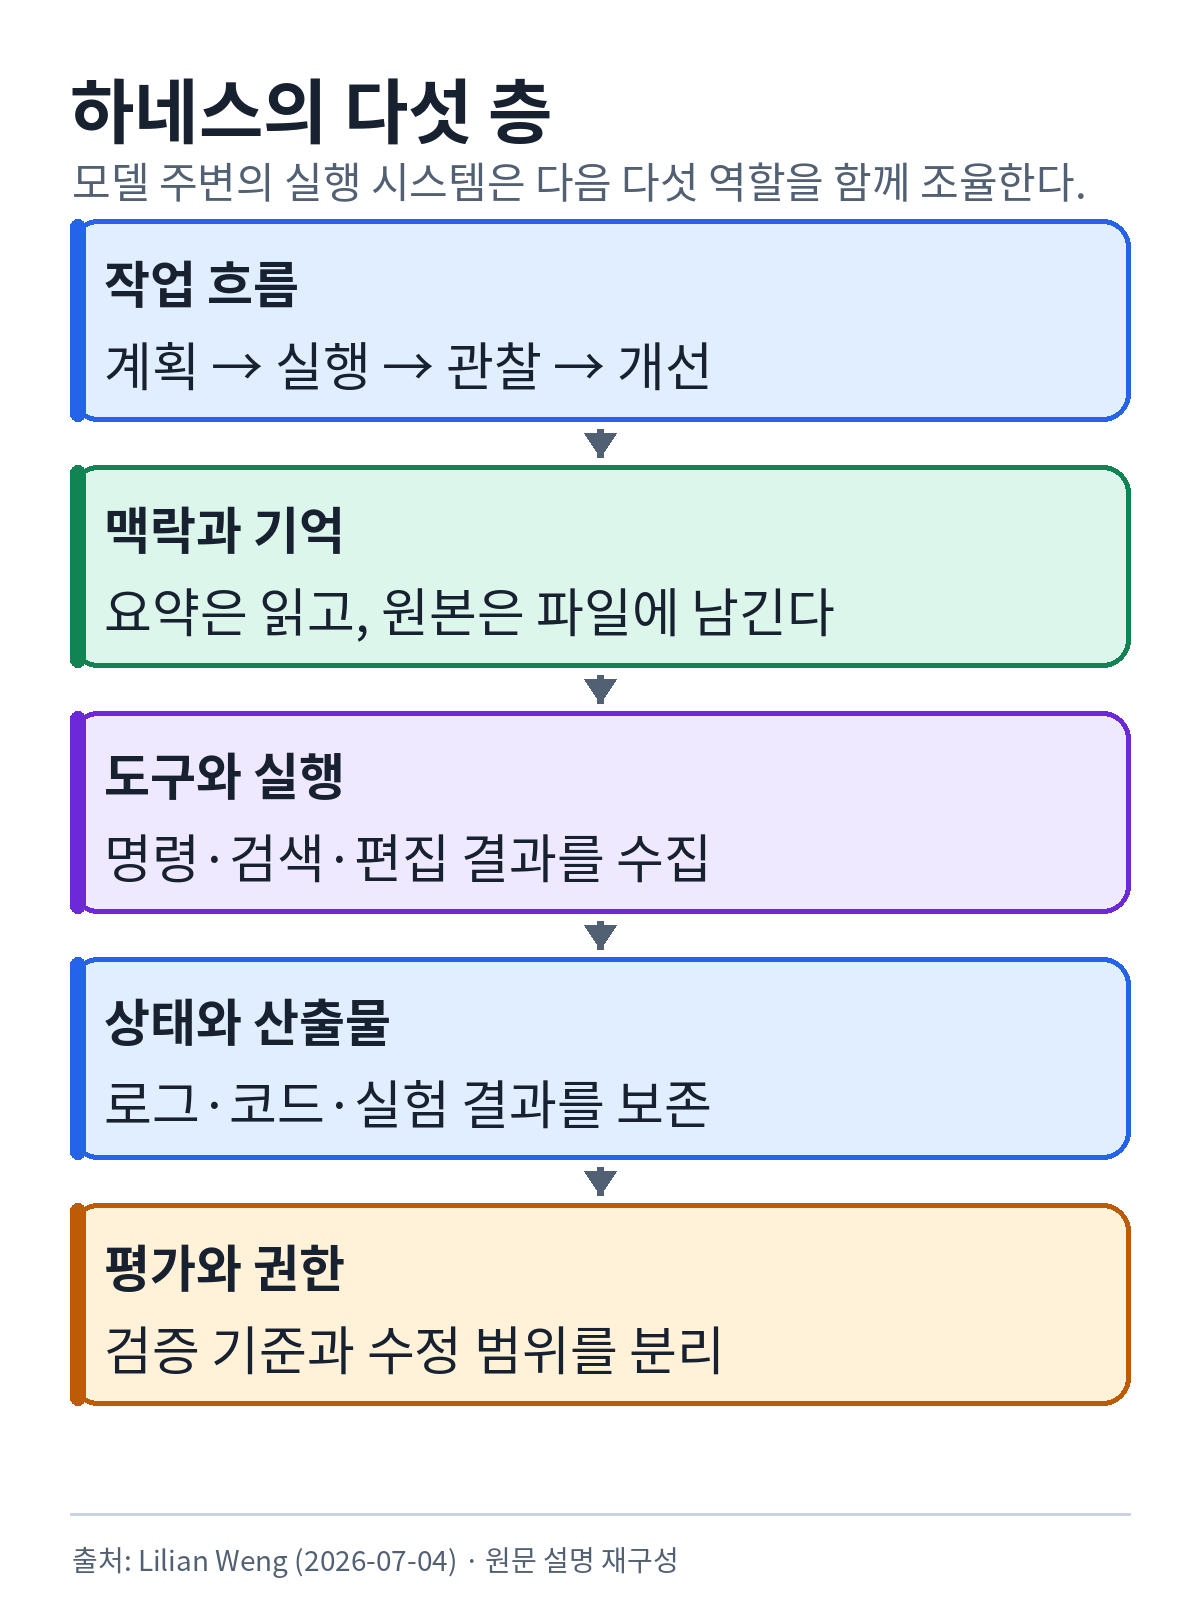
그래서 코딩 에이전트의 핵심 루프는 답변 생성보다 길다. 계획하고, 도구로 실행하고, 출력과 테스트를 관찰한 뒤, 실패 원인을 반영해 다시 실행한다. 하위 에이전트와 백엔드 작업을 병렬로 돌릴 때도 부모 에이전트가 시작·로그 확인·취소·결과 병합을 관리해야 한다. 병렬 작업의 결과를 대화창에만 남기면 중단 뒤에 복구할 근거가 사라진다.
긴 작업에서 파일이 기억 장치가 되는 이유
긴 작업의 로그, 코드 차이, 실험 결과, 오류 추적은 금세 모델이 안정적으로 다룰 수 있는 맥락보다 커진다. 원문은 이를 모두 대화 맥락에 붙이는 대신 파일 시스템에 지속적으로 남기는 패턴을 강조한다. 모델은 필요한 파일을 찾아 읽고, 새 관찰을 기록하고, 다음 실행에서 이전 가설과 실패를 다시 불러온다. 맥락 창을 무작정 늘리는 것과 별개로, 무엇을 요약해 현재 맥락에 올리고 무엇을 원본 기록으로 남길지 정하는 설계가 필요해진다.
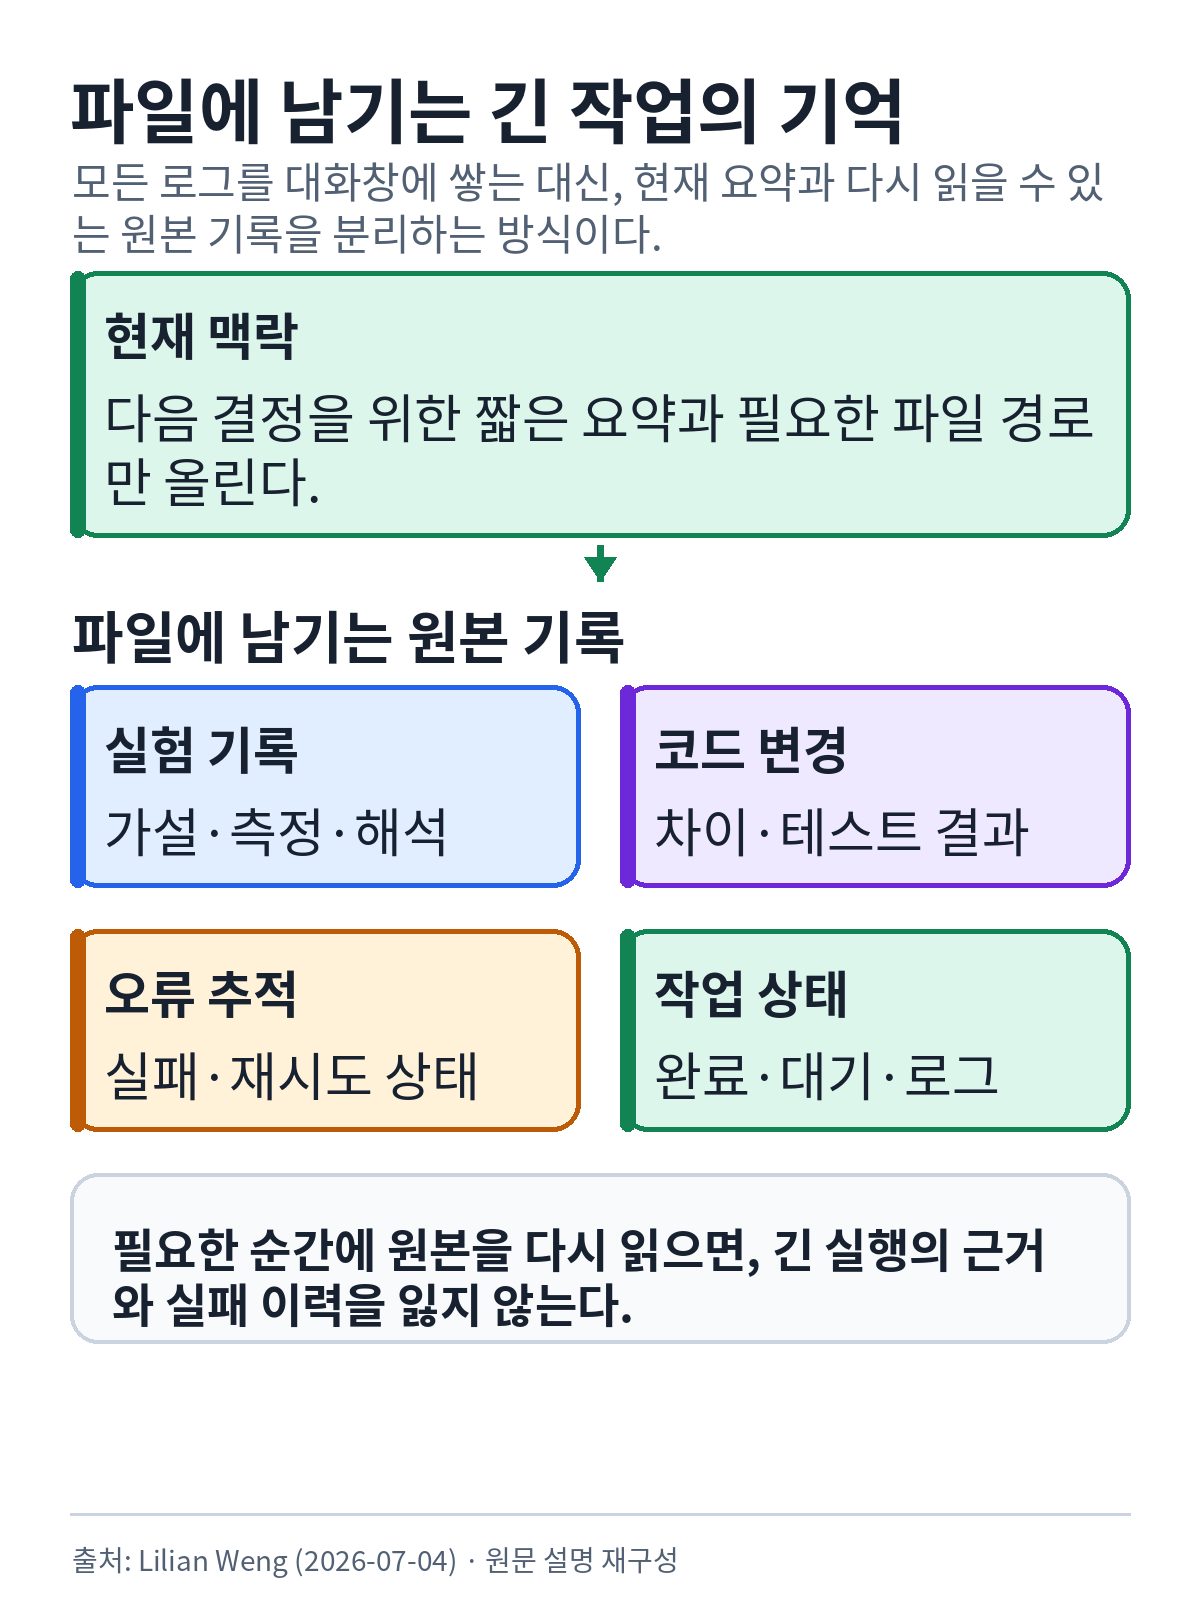
이 차이는 자기개선의 단위도 바꾼다. Agentic Context Engineering은 성공·실패 실행에서 얻은 통찰을 식별자와 설명이 있는 항목으로 쌓고, 생성기·반성기·관리기가 이를 갱신한다. Meta-Harness 계열은 한 단계 더 나아가 어떤 정보를 저장·검색·제시할지를 정하는 하네스 코드 자체를 탐색 대상으로 둔다. 개선 대상은 ‘더 좋은 답변’에서 구조화된 맥락, 작업 흐름, 하네스 코드, 나아가 그 최적화 코드로 이동한다.
좋은 하네스 수정은 왜 평가 장치에서 막히나
자기개선 루프가 돌아가려면 수정안을 제안하는 것만으로는 부족하다. 원문이 소개한 Self-Harness는 실패를 검증기 기반 패턴으로 묶고, 편집 가능한 표면과 통과한 동작, 이전 수정 이력을 제한된 문맥으로 제공해 수정안을 만든다. 이후 이미 본 과제와 분리해 둔 과제에서 모두 회귀가 없어야 새 하네스에 합친다. 실패한 수정안도 기록으로 남긴다.
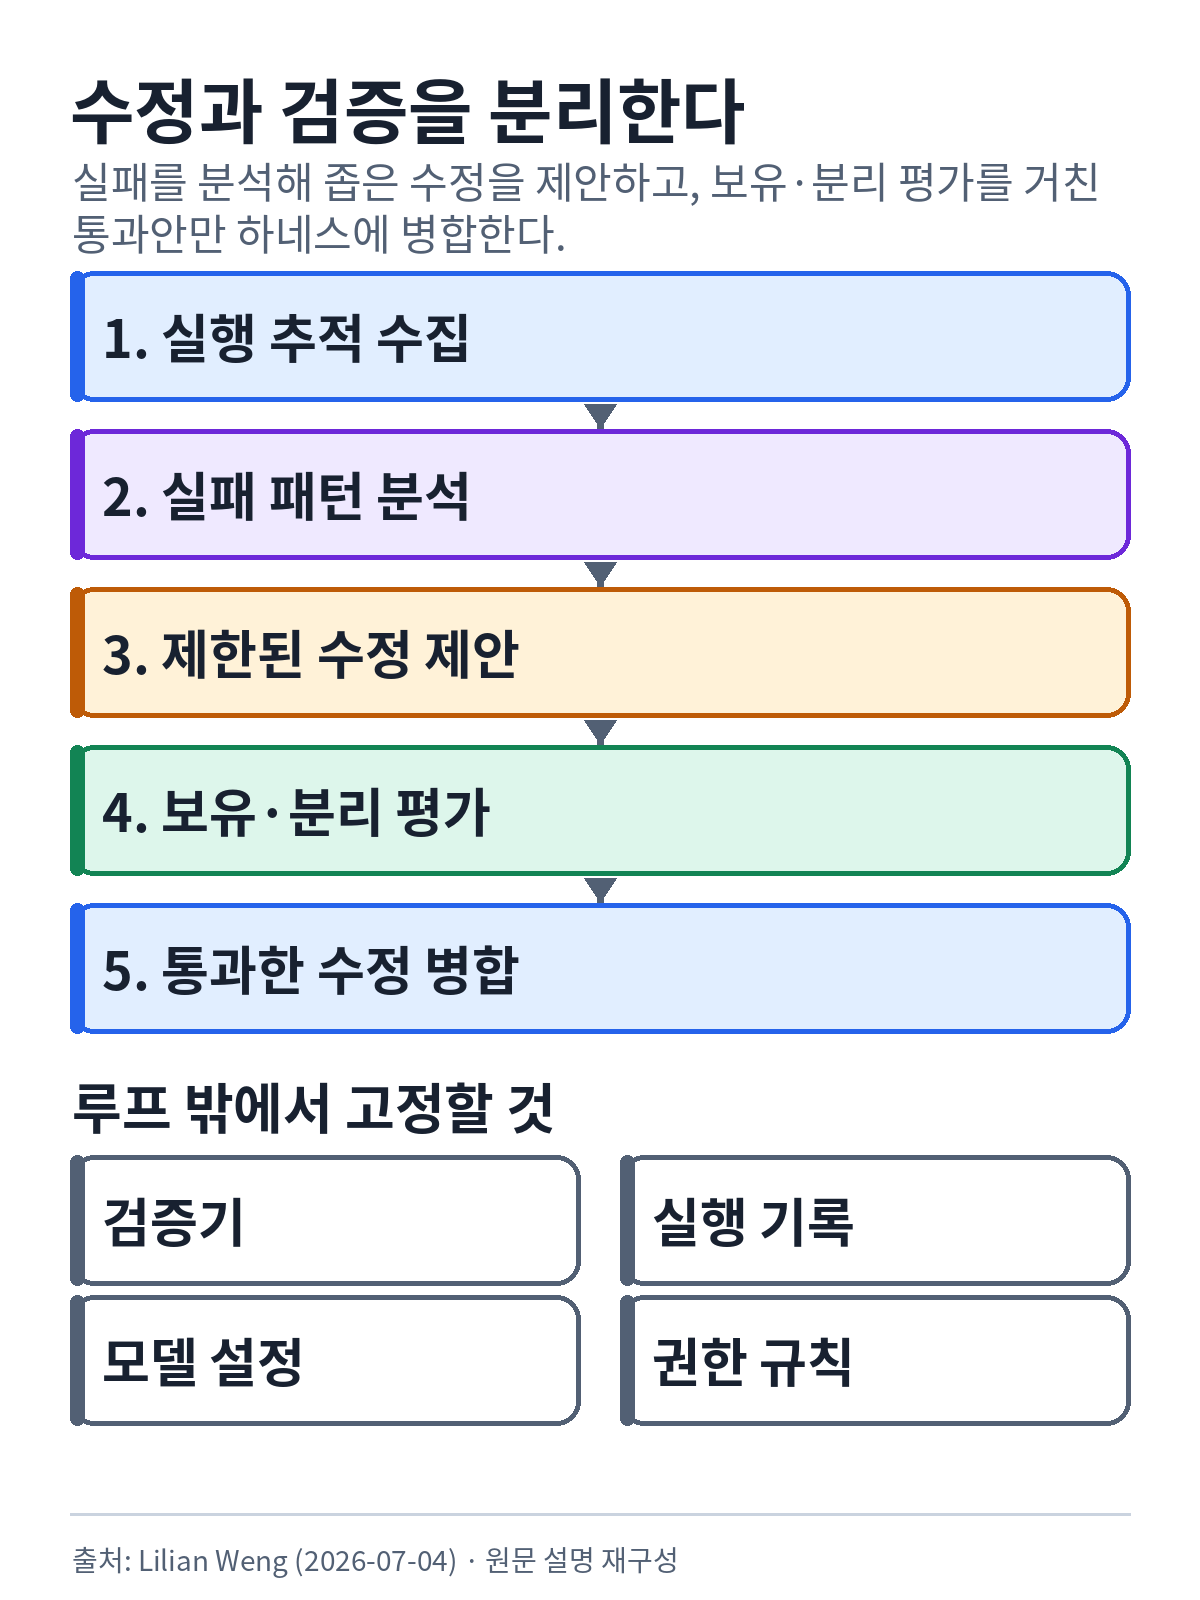
여기서 병목은 ‘수정 코드를 쓸 수 있는가’보다 ‘그 수정이 실제로 좋아졌다고 판정할 수 있는가’에 가깝다. Weng이 인용한 STOP 실험에서는 GPT-4 기반 개선기는 반복에 따라 평균 과제 성능을 높였지만, GPT-3.5와 Mixtral처럼 더 약한 모델에서는 성능이 떨어졌다. 또 하네스를 갱신하는 능력과 갱신된 하네스를 적절한 때에 활용하는 능력은 구분해야 한다는 연구 결과도 소개한다. 하네스가 모델 능력을 대체하는 것이 아니라, 가진 능력을 긴 실행에 연결하는 조건이라는 뜻이다.
제품 팀이 먼저 고칠 것은 프롬프트가 아니라 관측 가능성이다
에이전트를 운영하는 팀에 이 관점은 점검표보다 우선순위의 변화다. 실패가 나면 ‘모델이 틀렸다’고 묶지 말고, 어느 도구 호출·기억 항목·작업 단계·권한 규칙에서 멈췄는지 실행 추적을 남겨야 한다. 다음 수정은 그 근거와 예상되는 회귀를 함께 가진 작은 변경이어야 한다. 검증기, 실행 기록, 모델 설정을 하네스가 마음대로 고치지 못하게 두는 경계도 필요하다.
자동 평가가 빠르고 명확한 코드·커널·일정 최적화 같은 영역은 이런 탐색에 특히 잘 맞는다. 반대로 연구의 독창성, 장기 유지보수성, 제품 판단처럼 점수가 모호한 일은 보상 해킹과 다양성 붕괴가 더 쉽게 생긴다. 그래서 사람의 역할은 루프 밖에서 사라지는 대신, 무엇을 평가할지와 어느 수정 권한을 줄지 결정하는 더 높은 층으로 이동한다. AI 자기개선의 당면 과제는 더 큰 모델 하나를 기다리는 일이 아니라, 실패를 보존하고 수정의 효과를 판정할 수 있는 하네스를 만드는 일이다.
출처: Lilian Weng, “Harness Engineering for Self-Improvement” (2026-07-04)