
소프트웨어 성능 최적화를 오래 다뤄온 엔지니어 마틴 알더슨이 8월 2일 자신의 블로그에, 처음으로 매일 쓰는 모델을 지능이 아니라 속도로 고르고 있다고 썼다. 미국 정부 셧다운 기간 동안 다들 다시 오퍼스에 익숙해져 있었던 참에, 화제였던 신모델 페이블(Fable)이 추가 가드레일을 달고 복귀하자 가장 먼저 눈에 띈 건 속도가 느려졌다는 점이었고, 그는 곧바로 오퍼스로 돌아갔다고 설명한다. 오퍼스 4.6 정도의 모델이면 코드 작성, 자료 취합, 슬라이드 구성, 여러 데이터베이스를 오가는 분석 작업 같은 일상 업무에는 이미 충분히 똑똑하다는 게 그의 판단이다.
큰 모델 몇 개만 지능 기준을 넘던 시절에는 속도를 더 얻겠다고 그보다 못한 모델을 쓸 이유가 없었다. 결과가 부실해서 다시 시켜야 하면 아낀 시간이 그대로 사라지기 때문이다. 지금은 GLM5.2, 딥시크 V4 플래시 GA처럼 그 기준을 넘어서면서도 더 작고 가벼운 오픈 웨이트 모델이 여럿 나오면서, 같은 지능 구간 안에서 속도로 고를 수 있는 폭이 생겼다는 것이 그의 핵심 주장이다.
사람이 따라 읽을 수 있는 속도는 초당 몇 토큰인가
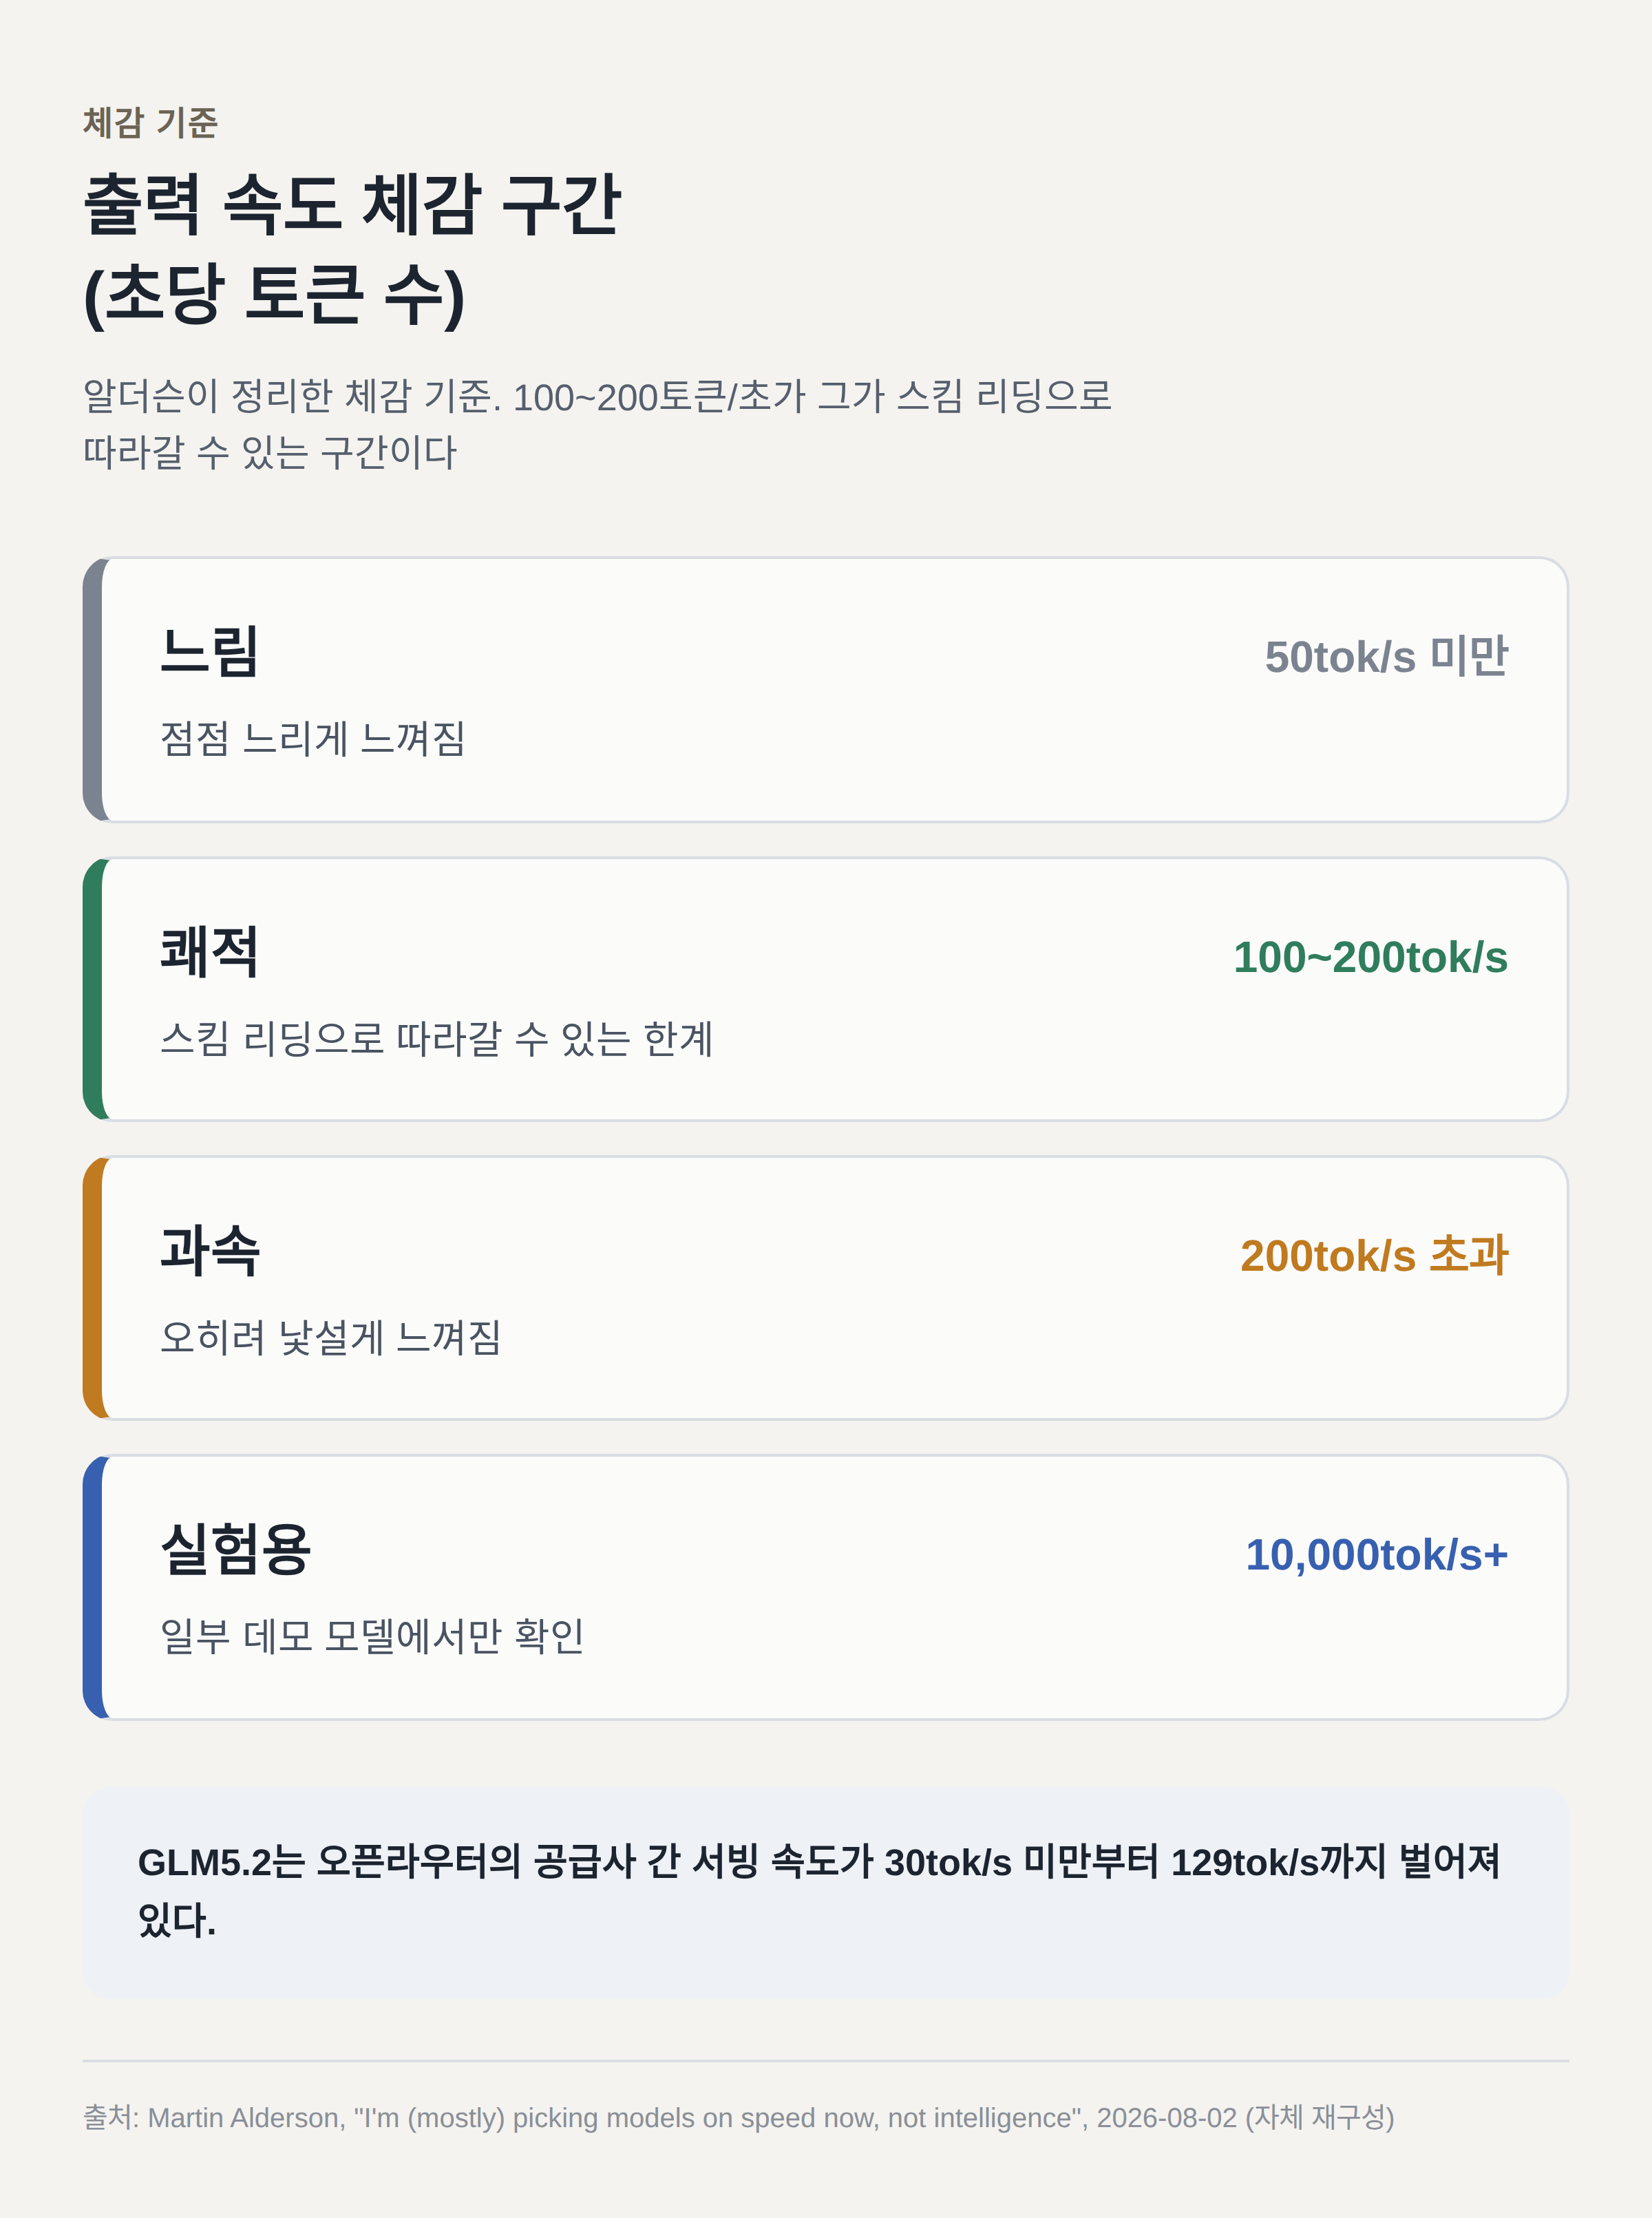
알더슨은 이전 글에서 초당 30~60토큰으로 기어가던 시절의 에이전트를 다이얼업 모뎀에 비유한 적이 있는데, 그 속도가 예상보다 빨리 바뀌었다고 말한다. 그가 잡은 감각적인 기준은 응답 시간 100밀리초가 사람에게 '즉각적'으로 느껴지는 것과 비슷하게, 출력 속도 초당 100토큰 정도가 자신이 스킴 리딩으로 따라갈 수 있는 한계라는 것이다. 이 기준은 정확한 경계선이 아니라고 그는 덧붙인다. 최근 모델은 시간 대부분을 추론에 쓰고 실제 출력 토큰을 보여주는 데는 상대적으로 적게 쓰기 때문이고, 코드는 프로즈보다 글자당 토큰 수가 적어 체감 속도가 문서 종류에 따라 크게 달라지기 때문이다.
그가 체감으로 정리한 구간은 초당 50토큰 아래는 점점 느리게 느껴지고, 100~200토큰 구간이 꽤 빠르게 느껴지며, 200토큰을 넘어서면 오히려 낯설게 느껴진다는 것이다. 실제로 초당 1만 토큰 이상을 내는 모델도 테스트해 볼 수 있는 곳이 있다고 언급한다. GLM5.2를 두고 오픈라우터에 올라온 여러 공급사의 서빙 속도를 보면 느린 쪽은 초당 30토큰 밑이고 가장 빠른 쪽은 초당 129토큰까지 벌어져 있는데, 오픈 웨이트 모델을 여러 회사가 동시에 서빙하면서 속도로도 서로 경쟁하게 됐다는 게 그가 주목하는 부분이다.
모델이 5배 빨라지면 에이전트 턴도 5배 빨라지는가
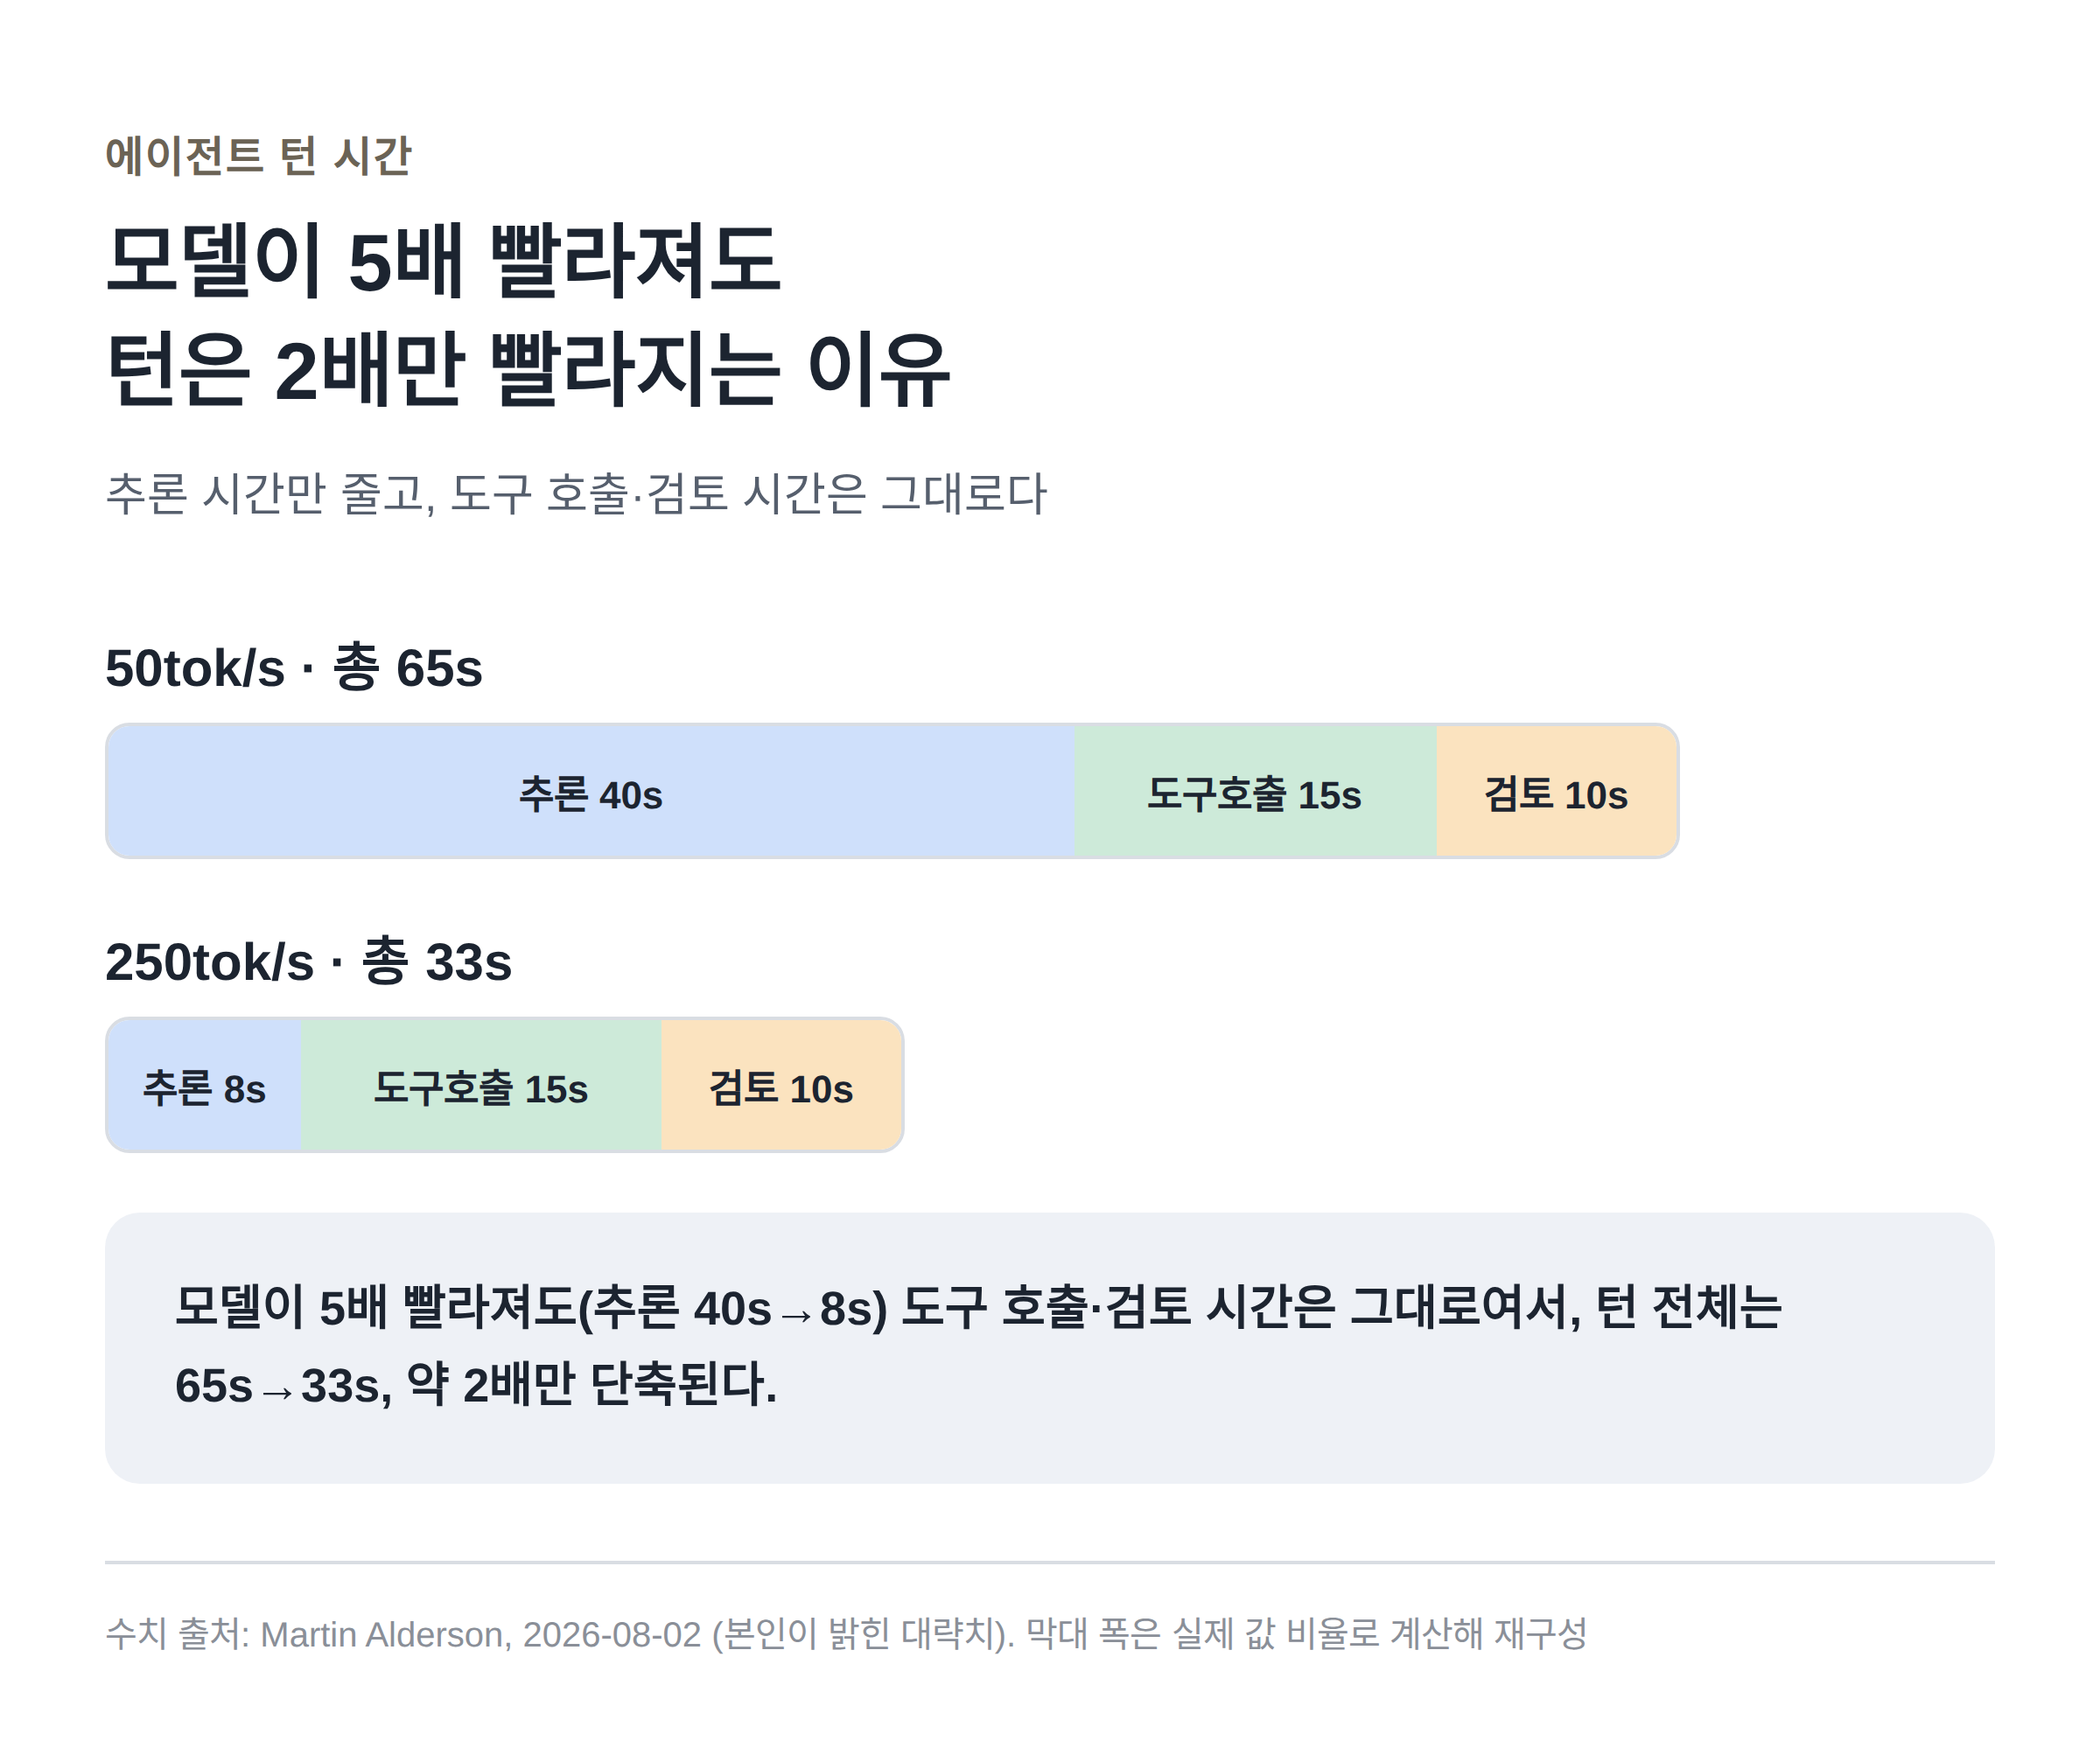
알더슨은 파레토 법칙과 암달의 법칙을 끌어와 이 흐름에 한계가 있다고 짚는다. '충분히 똑똑한' 모델이 계속 더 빨라진다고 가정하면, 그 속도 이득은 점점 도구 호출 대기 시간과 사람이 결과를 검토하는 시간에 흡수되어 버린다. 그가 든 예시는 초당 50토큰짜리 모델로 처리하는 에이전트 턴 하나가 추론 40초, 도구 호출 15초, 사람 검토 10초로 총 65초가 걸린다면, 같은 턴을 초당 250토큰(5배)으로 처리해도 추론은 8초로 줄지만 도구 호출 15초와 검토 10초는 그대로여서 총 33초, 즉 2배 정도만 빨라진다는 것이다.
여기에 더해 로컬 장비에서 도구 호출을 더 빠르게 만드는 것도 쉽지 않은데, AI 수요로 하드웨어 가격 자체가 가파르게 오르고 있기 때문이다. 그는 그래서 속도에 대한 수요도 어느 지점부터는 한계에 부딪힐 것으로 보며, 수학 연구처럼 추론량 자체가 큰 도움이 되는 몇몇 영역을 빼면 대부분의 에이전트는 로컬·내부 하드웨어, 데이터베이스 호출 같은 다른 지연 요소에 막힐 것으로 예상한다.
모델 가격은 왜 지금 이렇게 떨어지고 있나
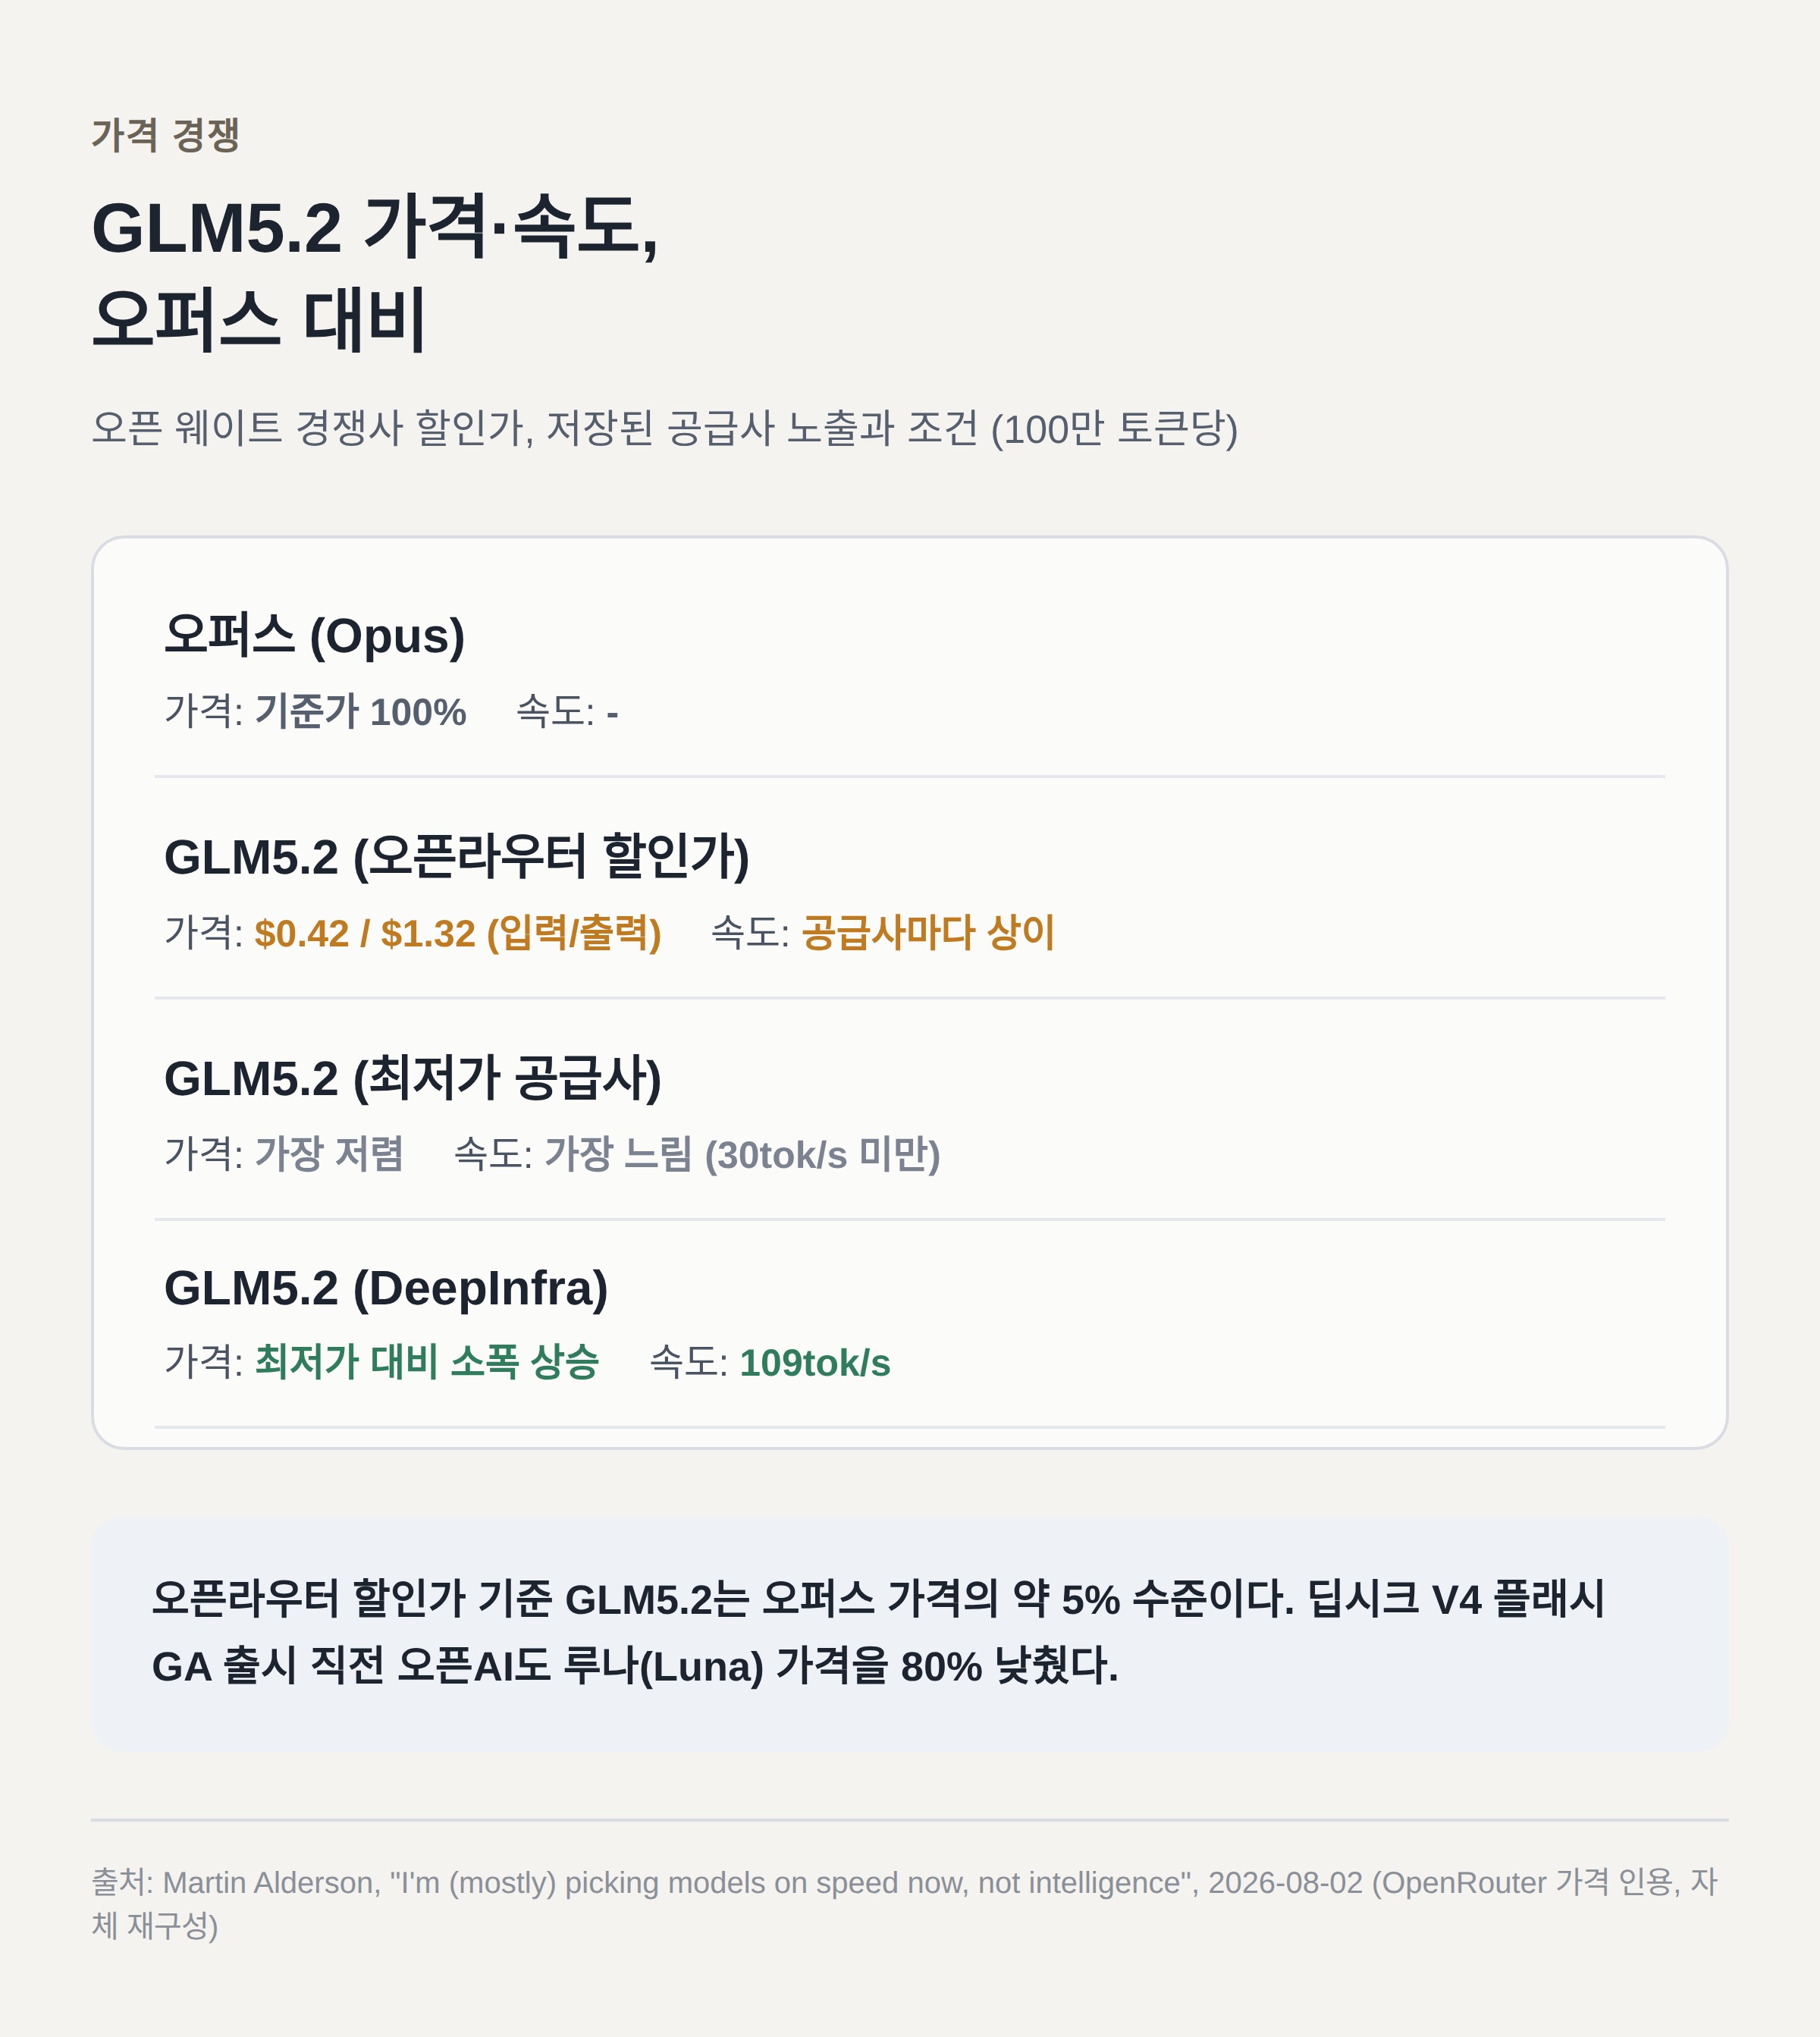
오픈AI는 딥시크 V4 플래시 GA 출시 직전에 자사 루나(Luna) 모델 가격을 80% 낮췄다. GLM5.2보다 결과물이 낫다는 인상은 못 받았다고 알더슨은 적었지만, 이 가격 인하 자체가 이 구간 시장에서 벌어질 가격 경쟁을 예고한다고 본다. 오픈라우터에서 GLM5.2에 걸린 할인은 이미 100만 토큰당 입력 0.42달러, 출력 1.32달러까지 내려왔는데, 이는 오퍼스 가격의 5%다. 가장 싼 공급사는 느리지만, 조금만 더 내면 디인프라(DeepInfra)에서 초당 109토큰을 받을 수 있다고 그는 덧붙인다.
그가 다음 변수로 꼽는 건 하드웨어다. 엔비디아의 베라 루빈 시리즈, AMD의 MI400 계열 등 다음 세대 GPU가 도입되면 여기 들어가는 HBM4 메모리만으로도 메모리 대역폭에서 나오는 출력 토큰 속도가 2배 이상 늘어나고, 여기에 연산과 인터커넥트 개선분이 더해질 것으로 본다. 2027년쯴에는 품질 좋은 모델을 합리적인 가격에 초당 500토큰 이상으로 돌릴 수 있을 것이고, 높은 추론 강도로 설정해 두고 한참을 기다리는 지금의 경험이 옛일이 될 수 있다는 게 그의 전망이다. 다만 그는 파라미터 수가 2~3조를 넘는 초대형 모델이 일상 작업에서도 실제로 큰 차이를 낼지는 아직 지켜봐야 할 변수로 남겨 뒀다.
출처: Martin Alderson, "I'm (mostly) picking models on speed now, not intelligence"