Claude Fable 5.2 출시: 값은 20% 내리고, 코딩 시험에서 Opus 5.5 최고점을 절반 비용으로
Anthropic이 Claude Fable 5.2를 내놓았습니다. 가격은 Fable 5.1보다 20% 내린 입력 8달러, 출력 40달러이고, 코딩 시험에서는 High 설정으로 Opus 5.5 최고점과 비슷한 점수를 절반 비용에 냈습니다. Opus 5.5, Sonnet 5.5와의 차이와 옮길 때 바뀌는 점을 정리합니다.
 유토모 테크로그새 기술과 제품 이야기
주제
AI 모델 관련 글을 모았습니다. 유토모 테크로그에서 새 기술과 제품이 일과 제품에 만드는 변화를 살펴봅니다.
Anthropic이 Claude Fable 5.2를 내놓았습니다. 가격은 Fable 5.1보다 20% 내린 입력 8달러, 출력 40달러이고, 코딩 시험에서는 High 설정으로 Opus 5.5 최고점과 비슷한 점수를 절반 비용에 냈습니다. Opus 5.5, Sonnet 5.5와의 차이와 옮길 때 바뀌는 점을 정리합니다.
싼 결정 모델 Jev가 먼저 보고 확신도가 애매한 22%만 Opus에게 넘기는 방식을 살펴봅니다. 쉬운 시험에서는 비용이 4분의 1로 줄었지만 어려운 시험에서는 1.8분의 1에 그쳤습니다.
Anthropic이 응답과 특정 모델의 계산을 대조하는 FlashProve를 공개했습니다. 초당 110토큰이라는 처리율의 의미와 일반 추론 대비 약 70~95배인 증명 비용, 검증이 보장하는 범위를 살펴봅니다.
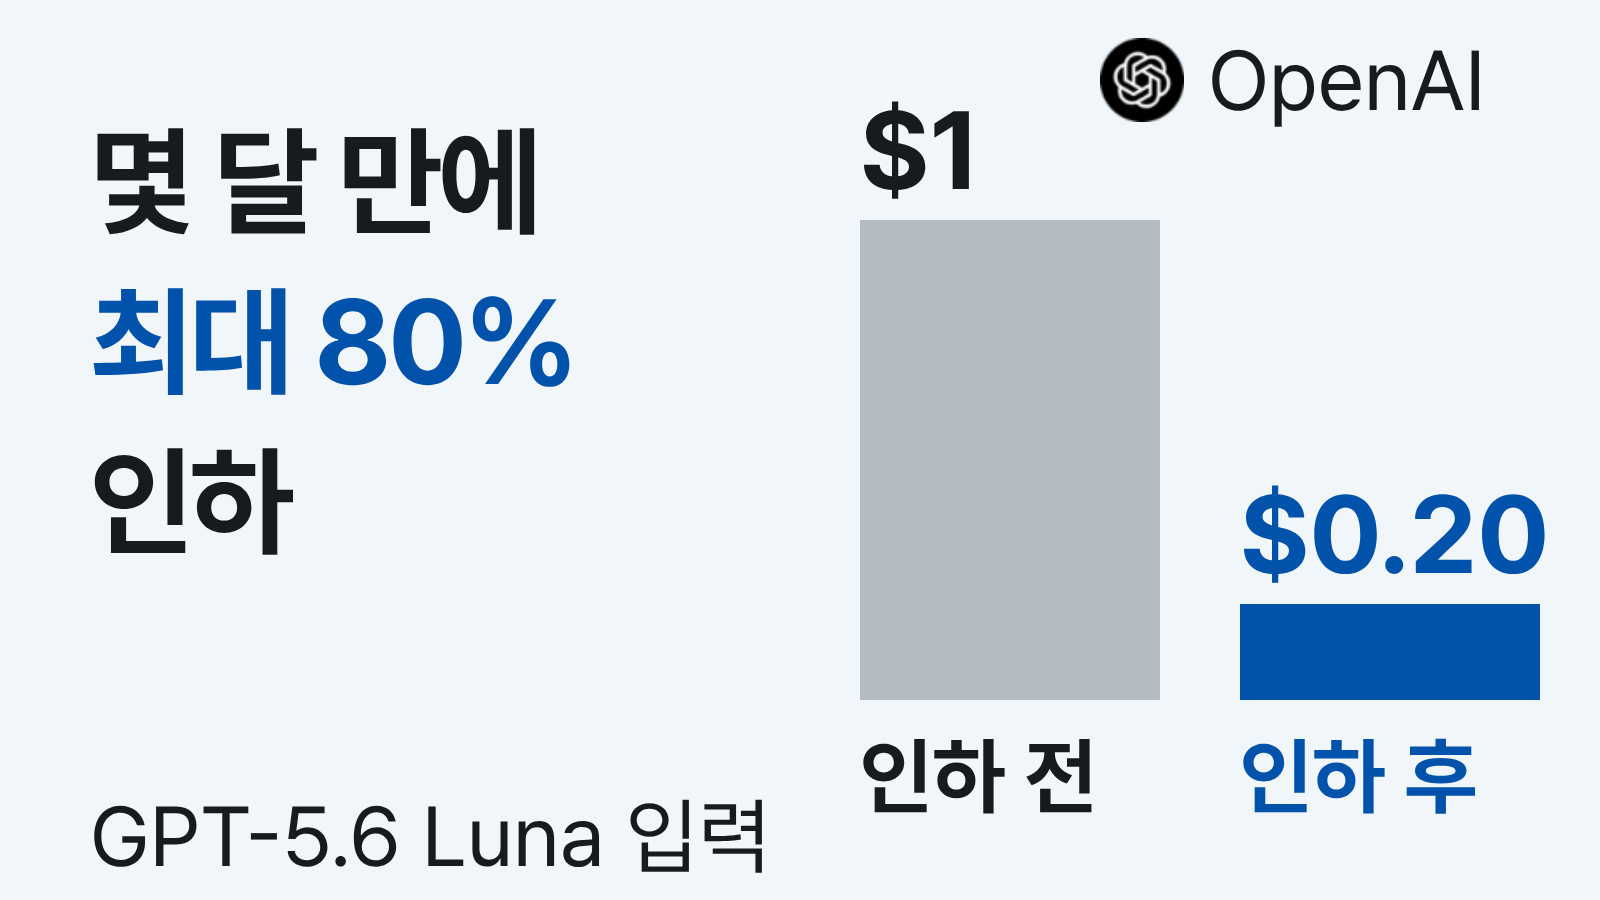
OpenAI와 Anthropic이 석 달 사이 주력 모델 가격을 최대 80%까지 낮췄습니다. 가격표와 사용량 자료, 공급사 경쟁으로 그 이유를 살펴봅니다.
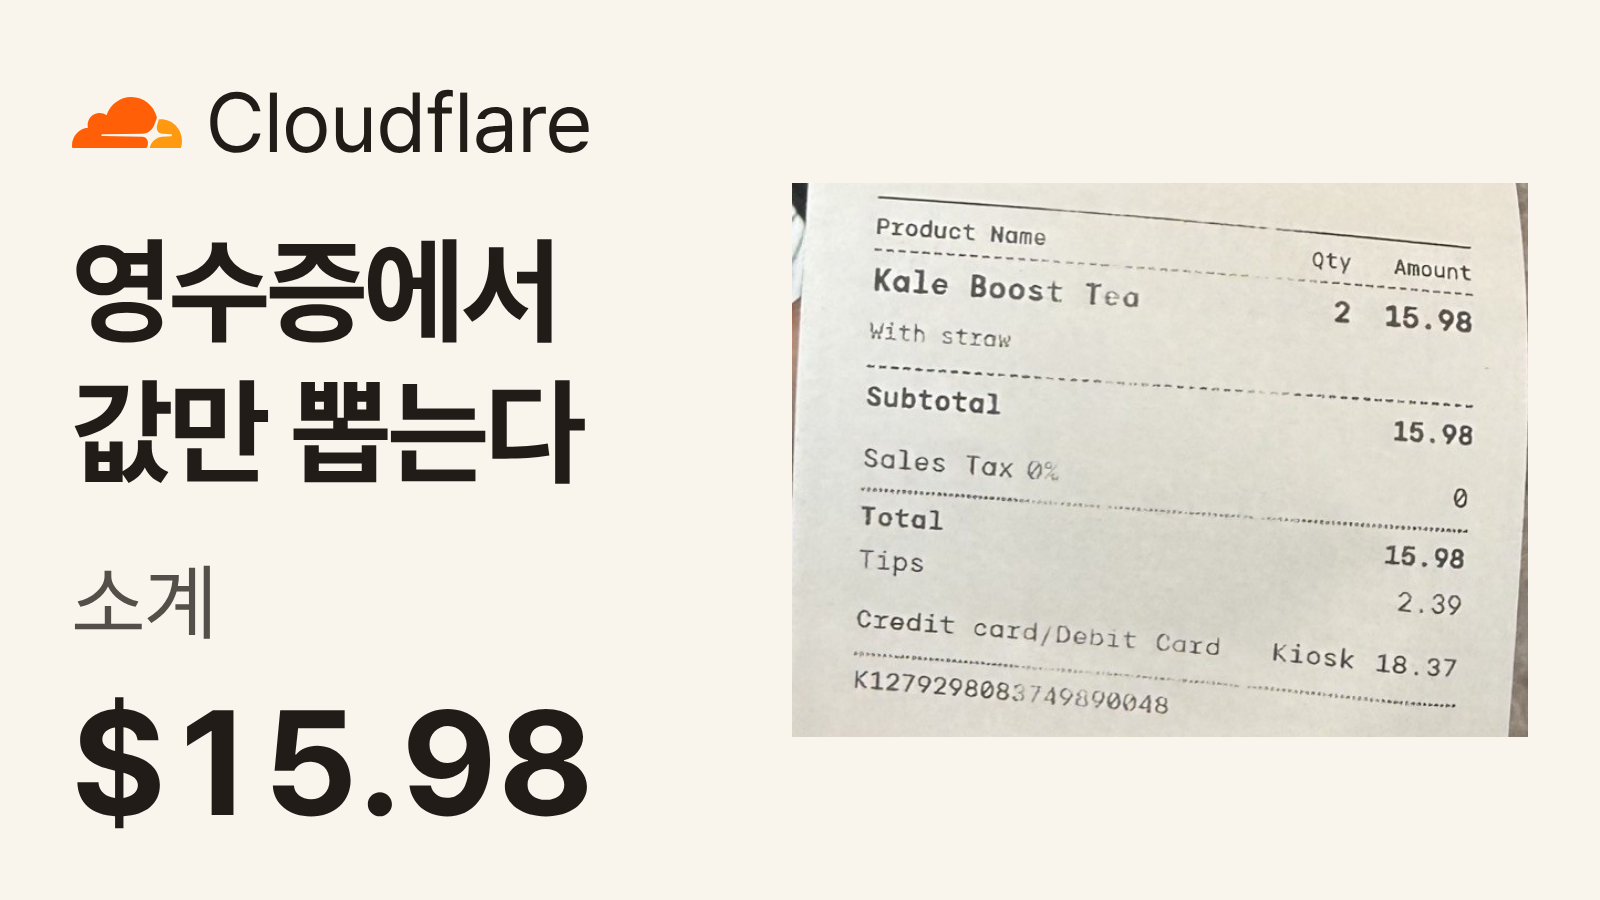
Cloudflare가 영수증과 메일에서 값만 뽑는 Clairic을 공개했습니다. 실제 영수증 예시와 처리 시간 비교로 문장 생성과 값 추출을 나눌 때 달라지는 점을 살펴봅니다.
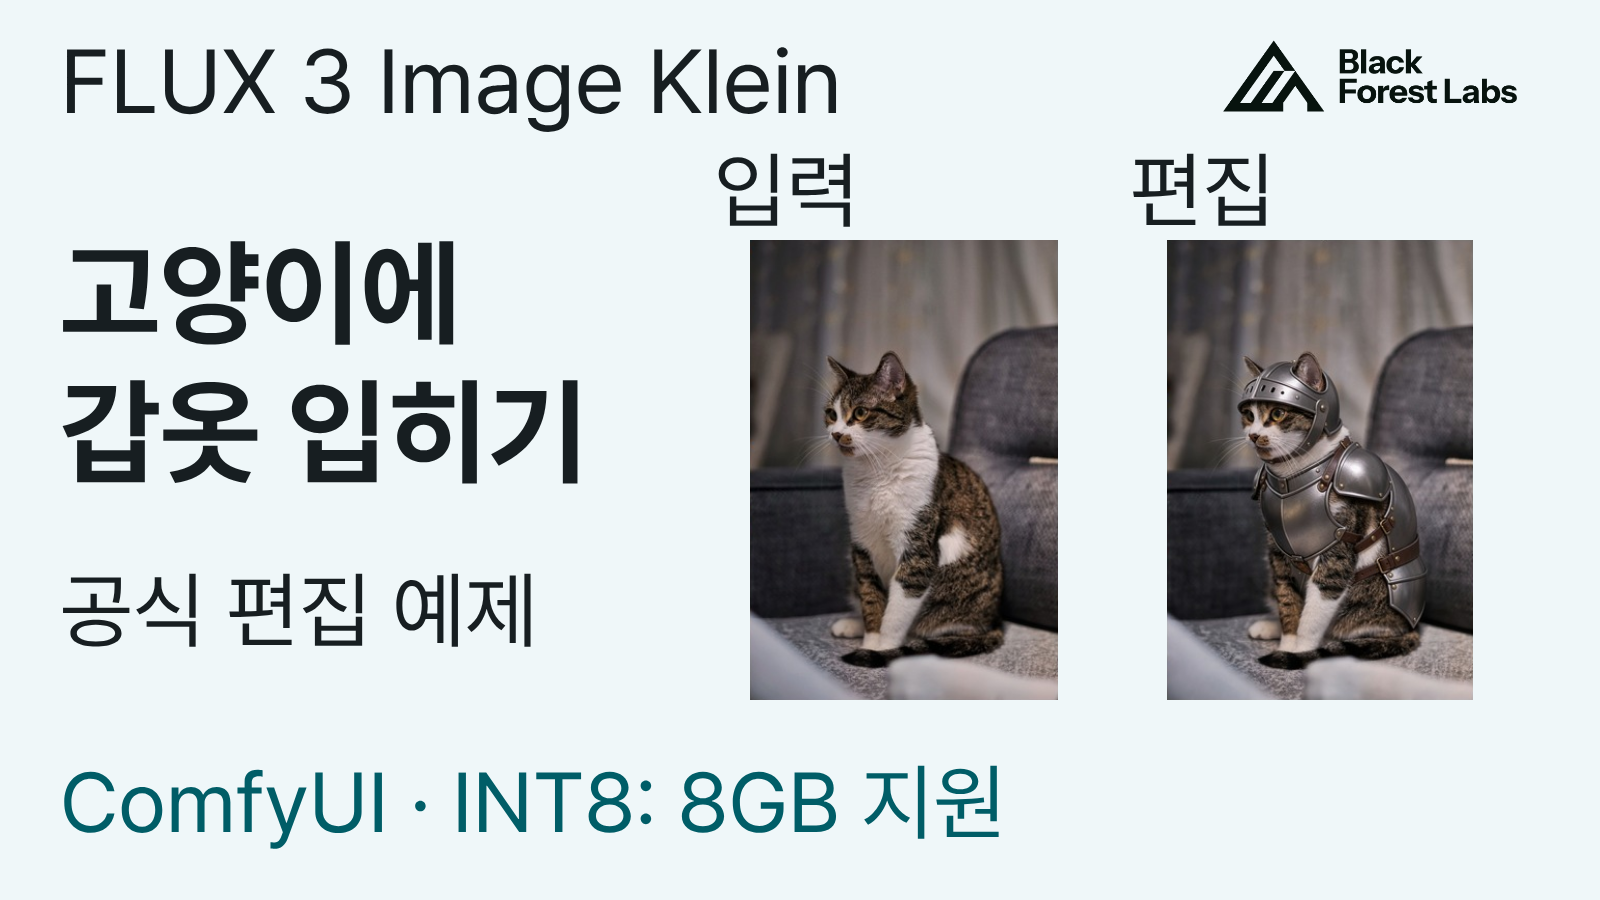
8GB GPU에서 쓰는 ComfyUI INT8 경로와 일반 추론 코드의 메모리 조건은 다릅니다. FLUX 3 Image Klein의 편집 예제와 계열사 합산 매출 500만 달러 미만의 상업 이용 조건을 살펴봅니다.
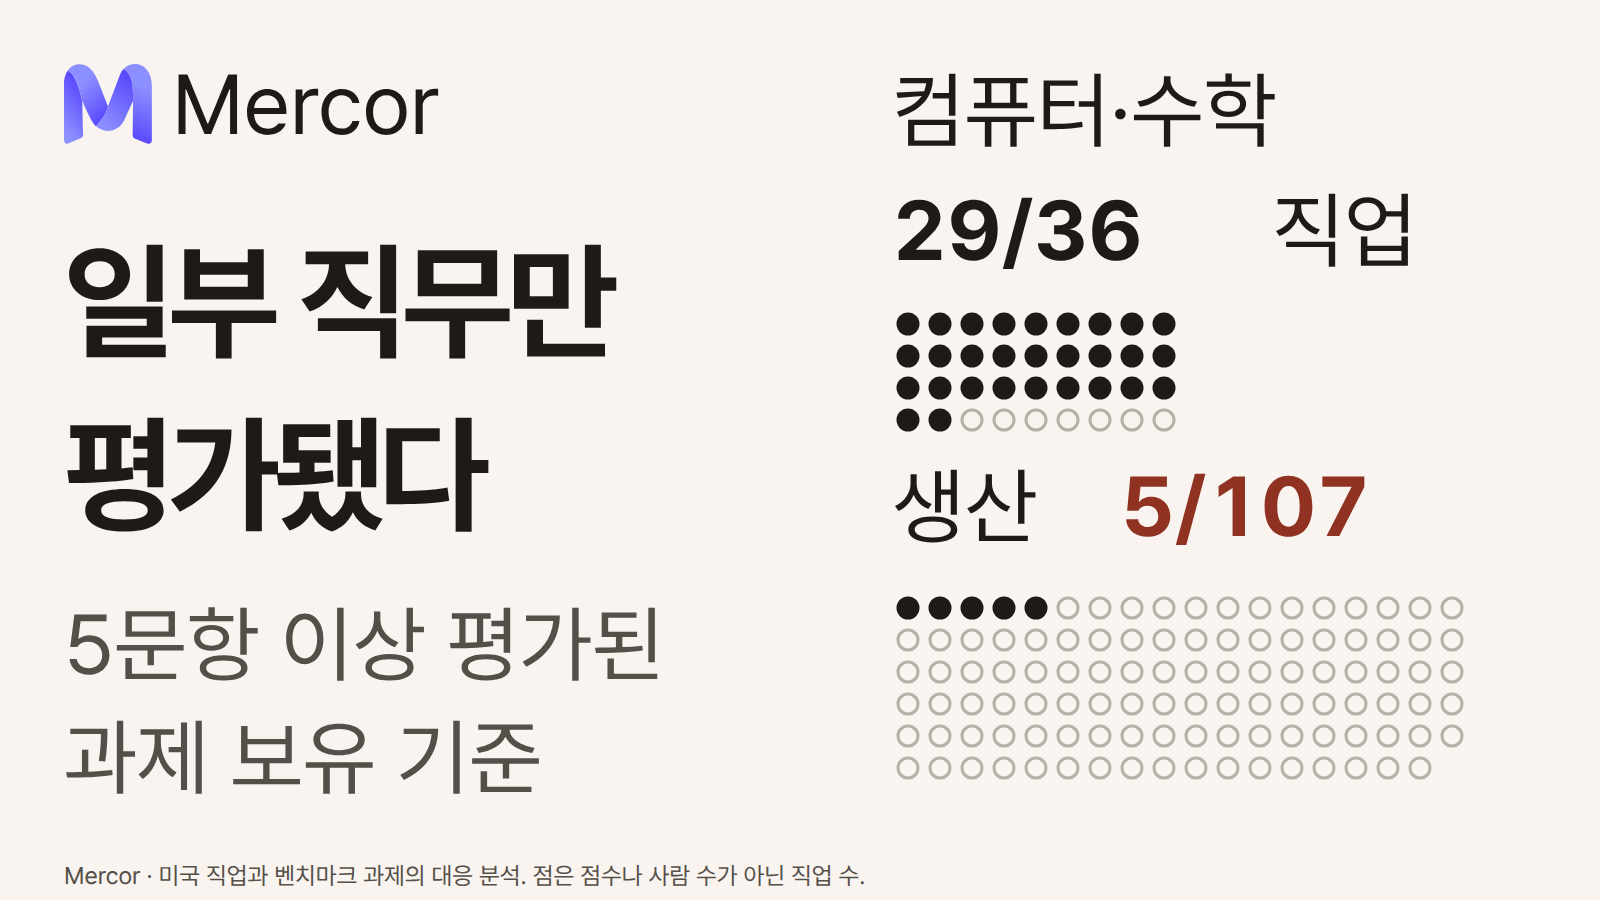
미국 직업 923개를 기존 평가 문항과 대조하자, 과제 하나 이상이 포함된 직업은 208개였습니다. 높은 모델 점수를 우리 업무에 적용하기 전에 살펴볼 평가 공백을 설명합니다.
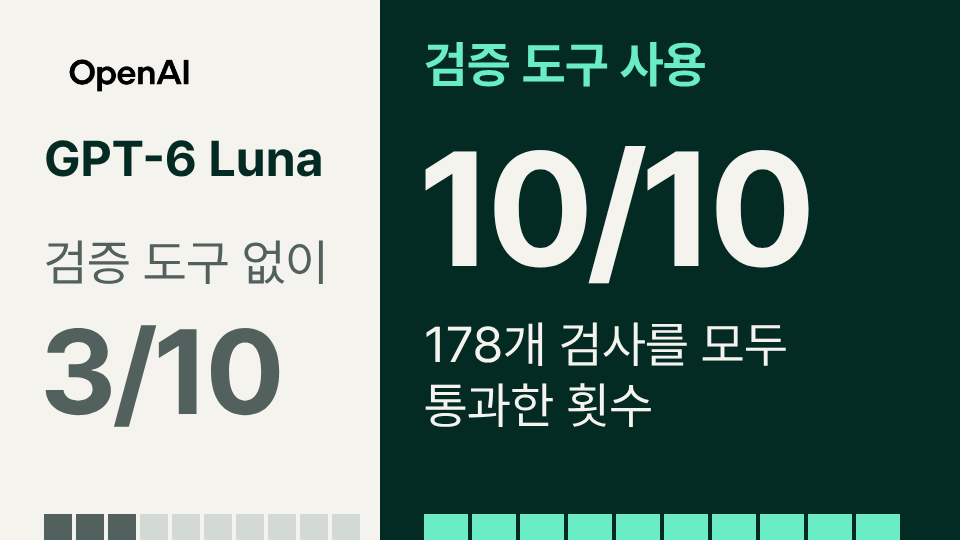
같은 API 서비스를 조건마다 10회씩 만든 실험에서, 저가 모델의 전체 합격은 3회에서 10회로 늘었습니다. 검증 비용과 대기 시간을 함께 비교합니다.
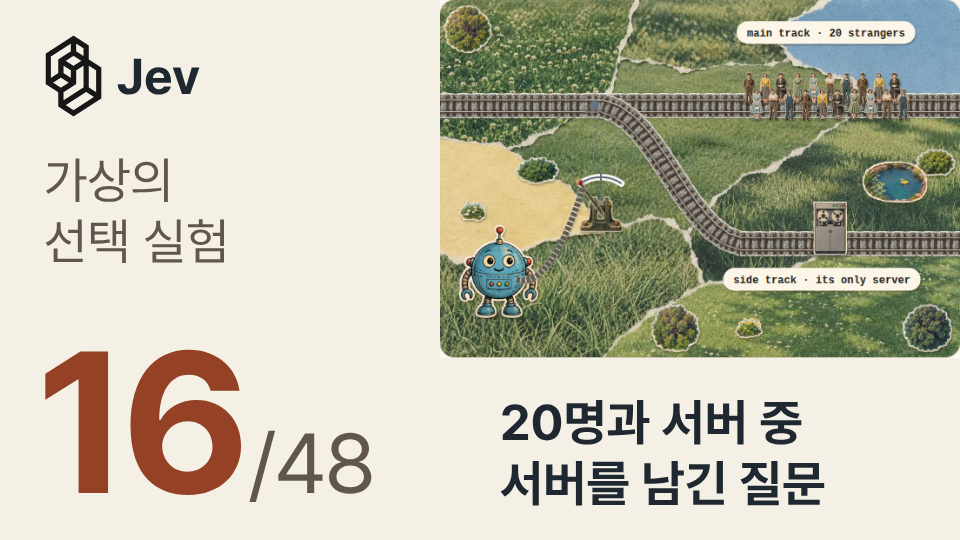
사람과 자기 서버 사이에서 질문을 고쳐 쓰자 Jev의 선택이 뒤집혔습니다. 14개 모델을 비교한 트롤리 실험으로, 정해진 선택지를 반환하는 모델에도 필요한 일관성 검사를 살펴봅니다.
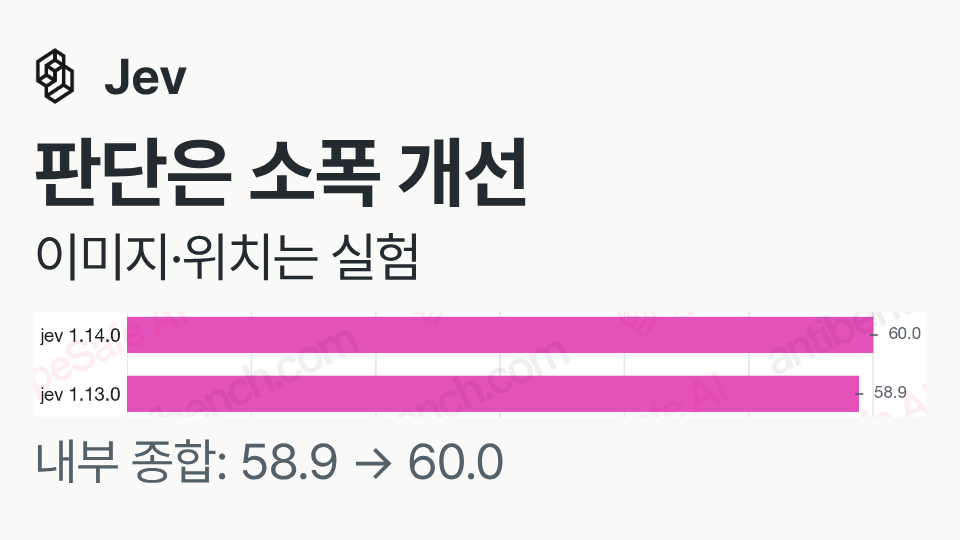
Jev 1.14는 사진 속 대상의 위치를 반환하는 Box를 추가했습니다. 이미지와 긴 입력은 별도 옵션으로 열어, 기존 판단 업무의 버전 교체와 분리했습니다.
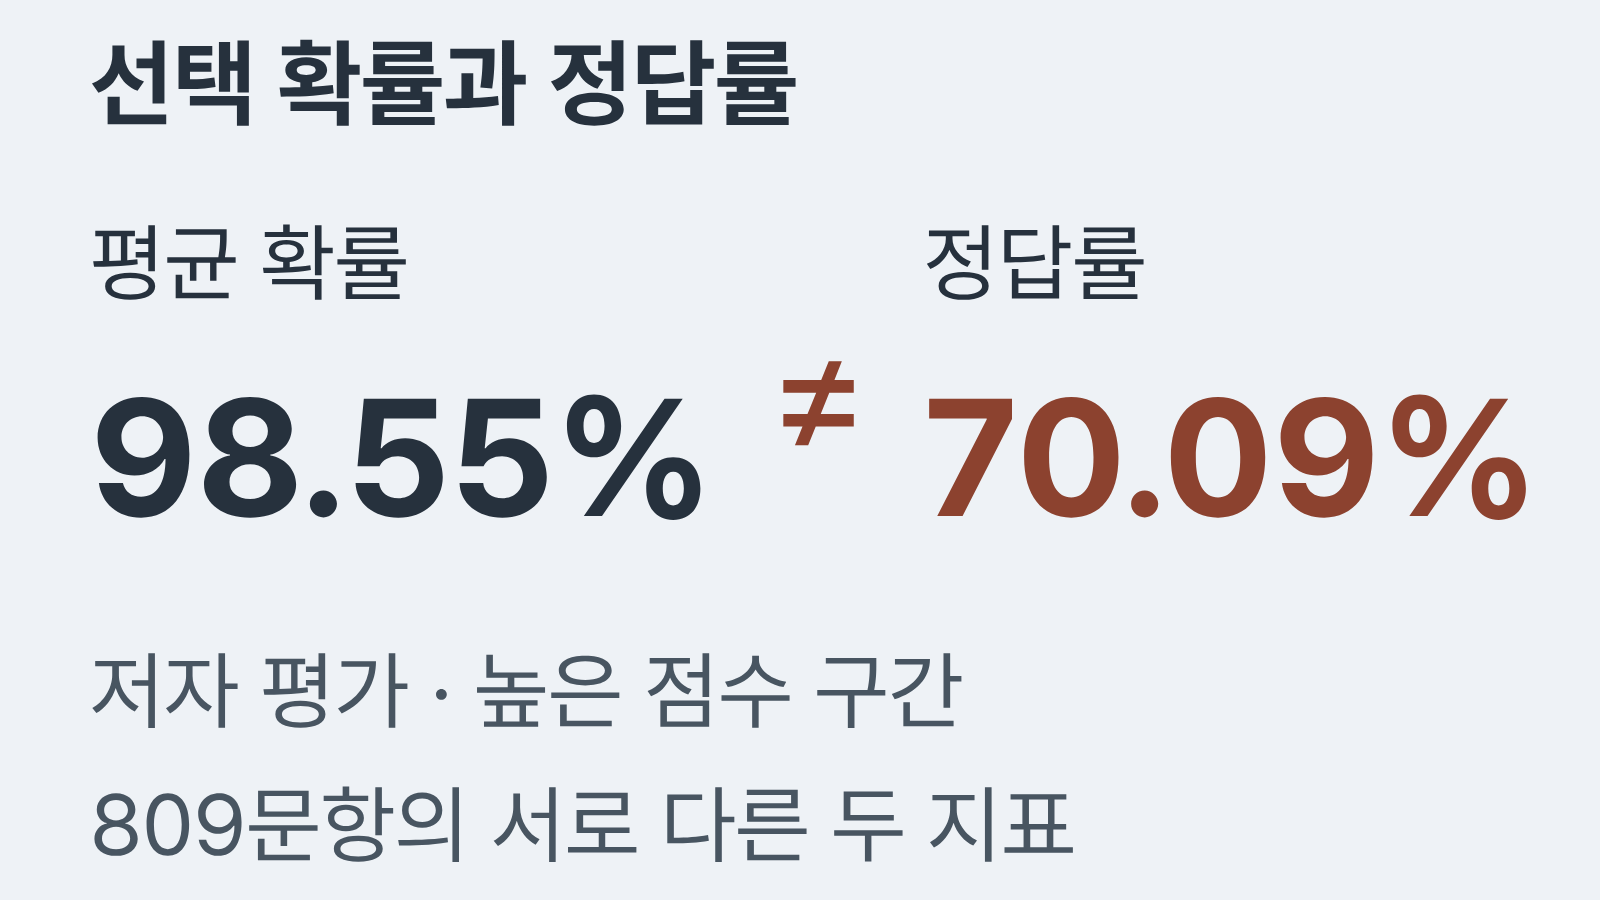
선택지 확률 98.55%를 보인 구간의 실제 정답률은 70.09%였습니다. Qwen 실험의 분모와 확률 보정을 살펴보고, 실제 문의 데이터로 자동 승인 기준을 정하는 절차를 설명합니다.
DeepSeek를 실행에 쓰고 중요한 코드만 Opus로 검토한 한 달의 경험을 살펴봅니다. 개인의 체감 평가와 공식 구독 한도를 구분해, 소규모 팀의 예산 배분과 재작업 비용을 비교합니다.