
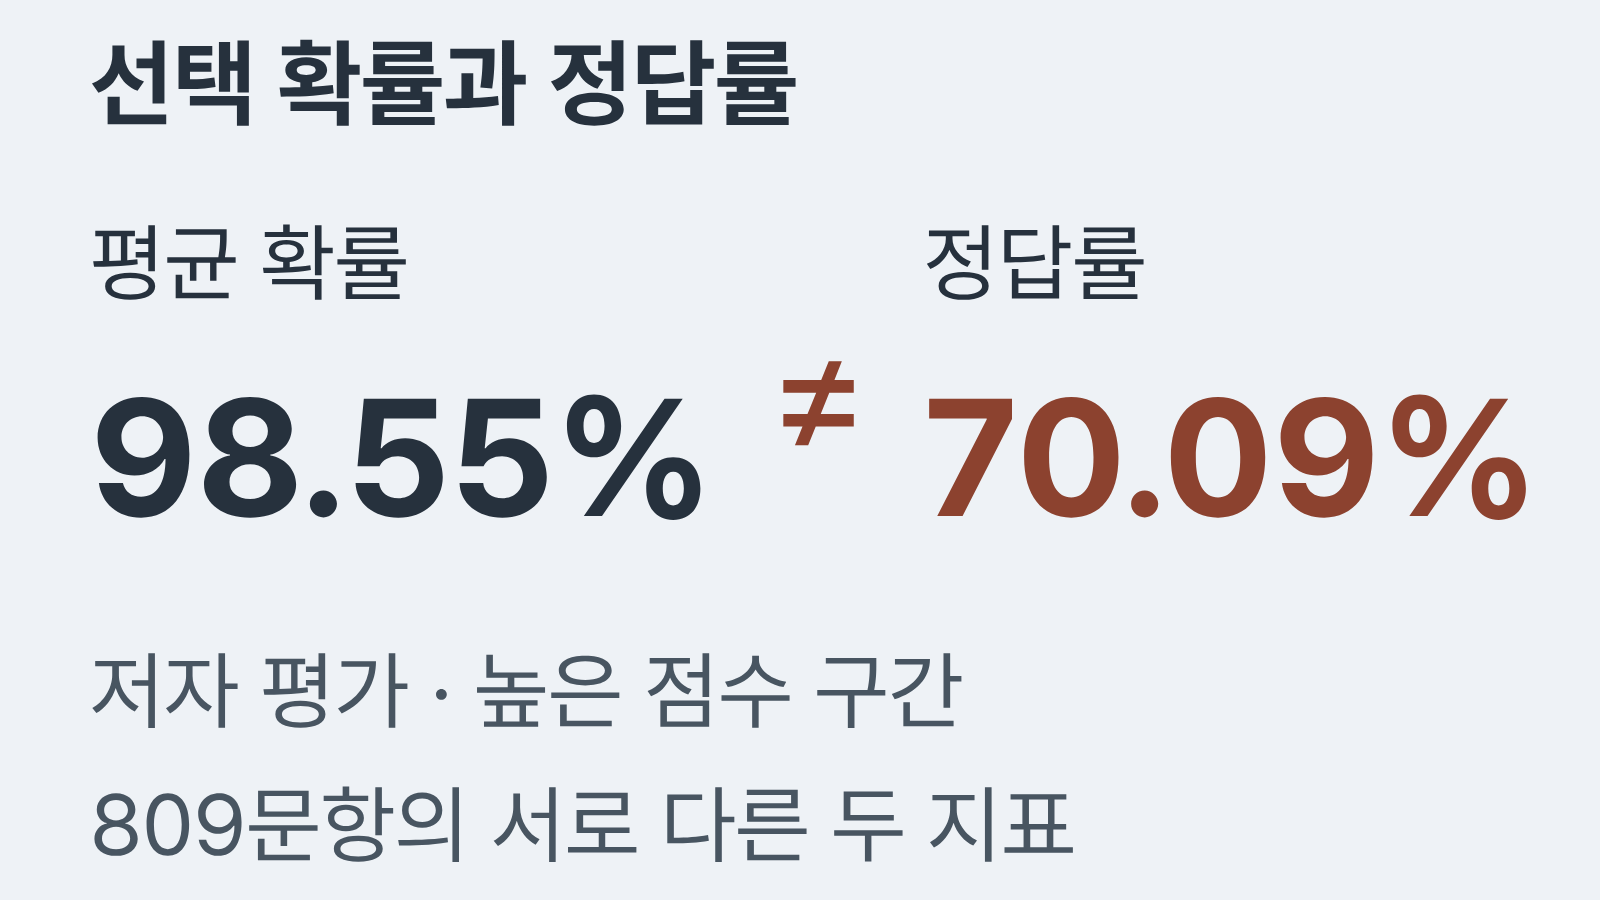
자동 분류 결과 옆에 99%가 찍히면, 사람의 검토를 건너뛰어도 될 것처럼 보인다. 개발자 Nish Tahir가 10월 10일 공개한 실험에서는 높은 점수 구간의 평균 확률이 98.55%였지만 정답률은 70.09%였다. 같은 숫자를 '정답일 확률'로 읽고 자동 승인에 연결하면 잘못된 문의 배정도 그대로 통과시킬 수 있다.
Tahir는 Qwen3-1.7B 언어 모델의 출력을 다섯 선택지로 제한해 작은 판단 모델을 만들었다. 상식 문제를 맞히는 능력과, 모델이 내놓는 확률이 실제 정답률에 얼마나 가까운지를 따로 살폈다. 평가 대상은 고객 문의가 아닌 영어 상식 문제였다. PM과 창업자는 이 실험의 점수 기준을 가져다 쓰기보다, 자기 업무 데이터로 승인 기준을 정하는 절차를 참고할 수 있다.
선택지를 제한하면 답의 형식은 맞지만 내용은 틀릴 수 있다
문의 담당 부서가 배송·결제·반품으로 정해져 있다면 긴 답변 대신 부서 코드 하나만 받아도 된다. Tahir의 예제는 질문과 A부터 E까지의 선택지를 입력한 뒤, 모델의 다음 출력 위치에서 그 다섯 토큰의 점수만 꺼낸다. 여기에 소프트맥스를 적용해 합계가 1인 확률을 만들고 가장 큰 값을 고른다. 추론 과정을 길게 생성하는 모드는 enable_thinking=False로 끈다.
이때 99%는 허용된 선택지끼리 비교한 상대 확률이다. 모델이 다른 단어를 출력할 가능성을 제외하고 다시 계산한 값이므로, 정답일 확률 99%를 보장하지 않는다. 모든 부서가 맞지 않는 문의도 선택지 중 하나에 몰릴 수 있다. '기타·판단 보류'를 넣었다면, 모호한 문의에서 그 항목을 고르는지도 평가해야 한다.
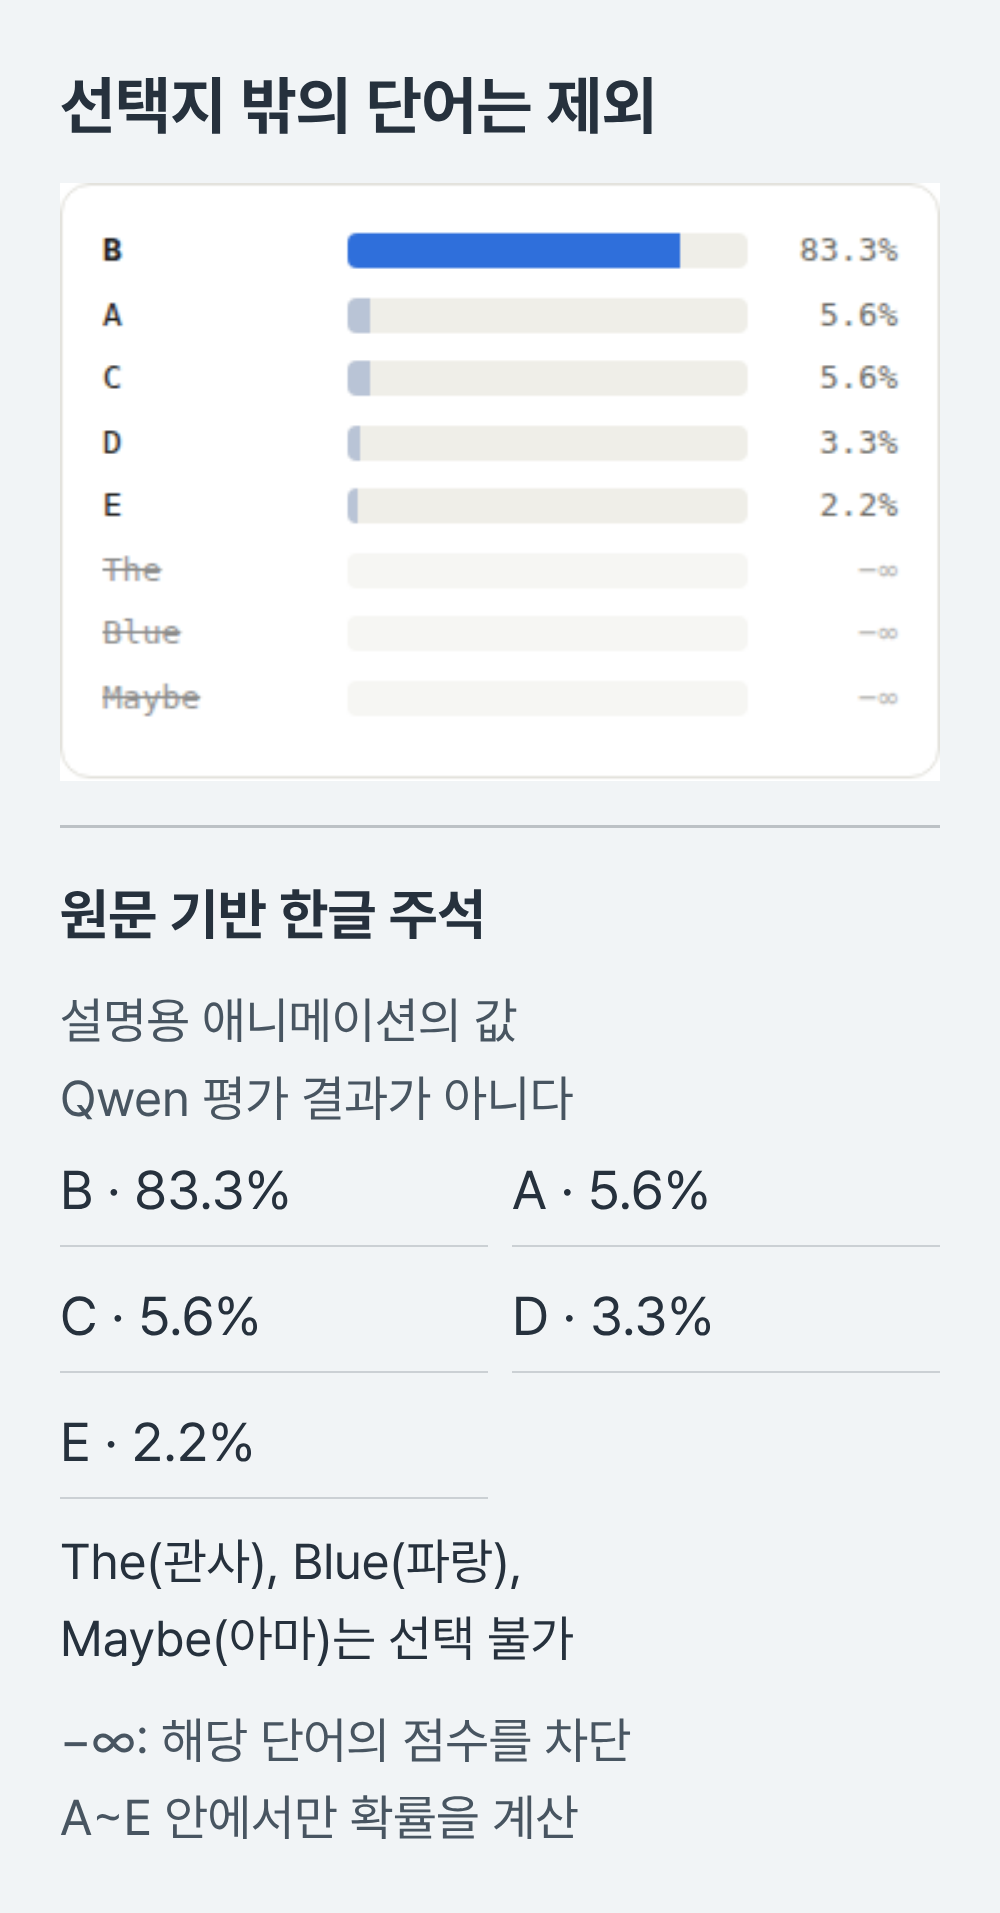
원문의 애니메이션은 JSON을 여러 토큰에 걸쳐 생성하는 방식과 선택지 한 토큰의 점수를 읽는 방식을 비교한다. 화면의 B 83.3%는 설명용 예시다. 뒤에 나오는 Qwen 평가 결과와는 구분해야 한다. 이미 정해진 답을 빠르게 고르는 판단 모델의 쓰임은 Jev를 이용한 장애 진단 사례에서도 볼 수 있지만, 이번 수치는 Jev 제품의 성능이 아니다.
98.55%와 70.09%는 같은 809문항을 설명한다
Tahir가 CommonsenseQA의 무작위 홀드아웃 표본 1,221문항에서 보고한 초기 정답 수는 725개, 정답률은 59.38%였다. 빠른 미세조정 뒤에는 762개, 62.41%로 올랐다. 상식 객관식 문제의 결과이므로 한국어 문의 라우팅이나 환불 승인으로 옮겨 쓸 수 있는 수치는 아니다.
확률을 구간별로 나눈 원문 표는 과신을 더 잘 보여 준다. 0.9 초과, 1.0 이하 구간에는 809문항이 들어갔다. 그 안에서 선택된 답의 평균 확률은 0.9855, 실제 정답률은 0.7009였다. 0.8 초과, 0.9 이하 구간의 121문항은 평균 확률 0.8555에 정답률 0.4711이었다. 이 구간의 정답률은 47.11%다.
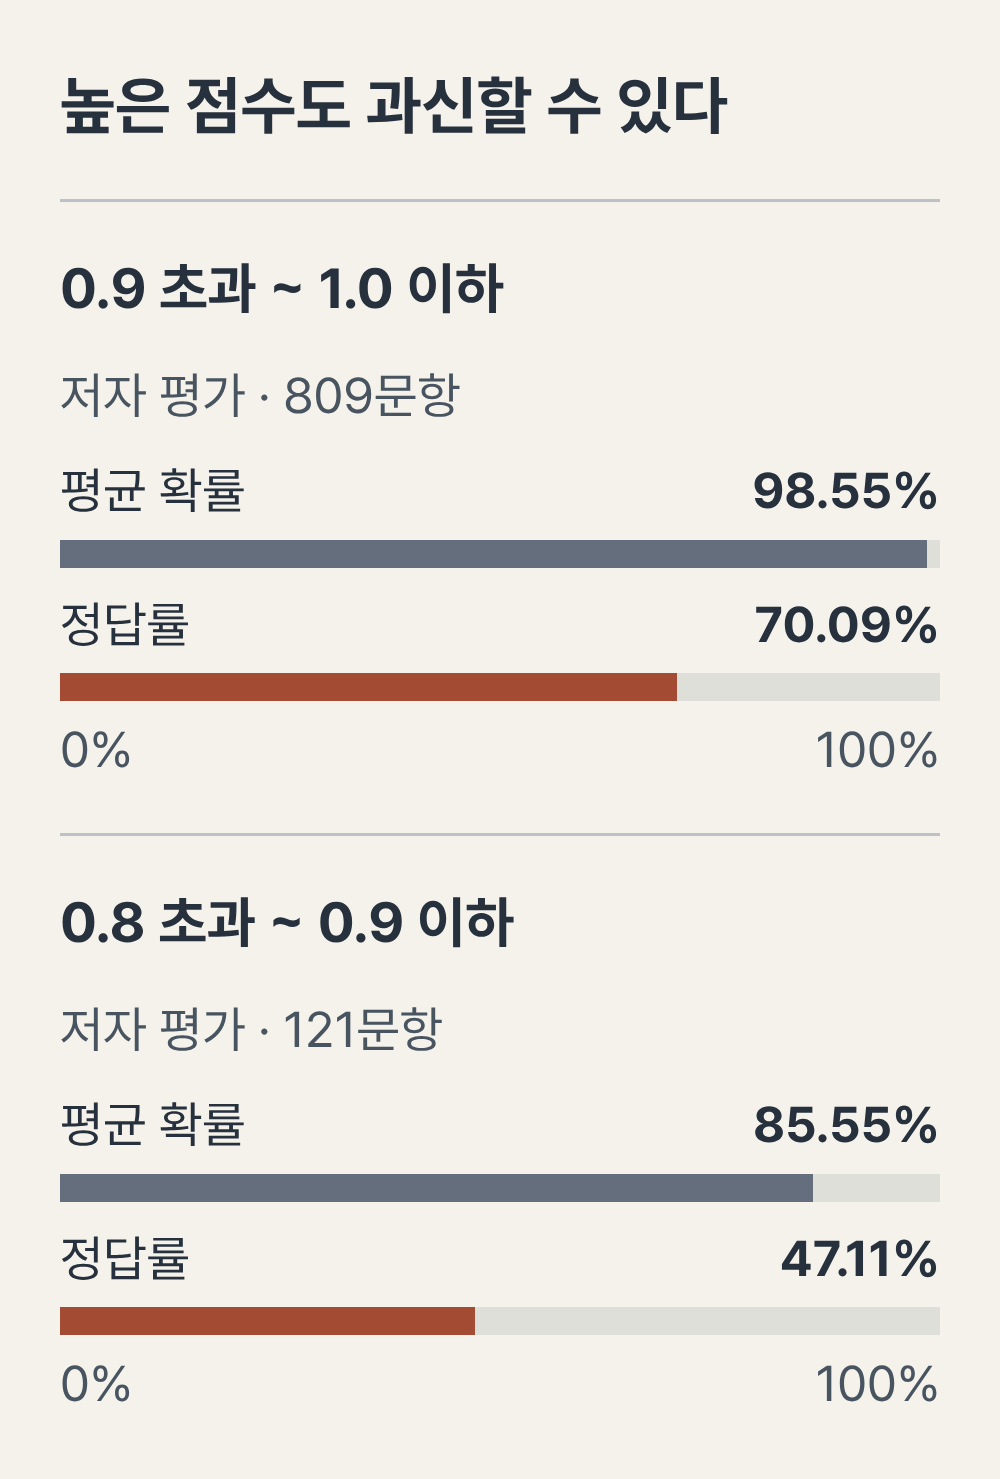
제목의 99%와 70%는 0.9 초과, 1.0 이하 구간의 평균을 반올림한 표현이다. 점수가 정확히 0.99인 사례나 0.99 이상만 승인한 사례의 정답률은 이 표에서 알 수 없다. 전체 1,221문항의 정답률과 특정 구간의 정답률도 분모가 다르다. 자동 승인 규칙에는 실제로 승인한 표본만의 정답률이 필요하다.
온도 보정은 선택한 답을 유지하고 확률을 바꾼다
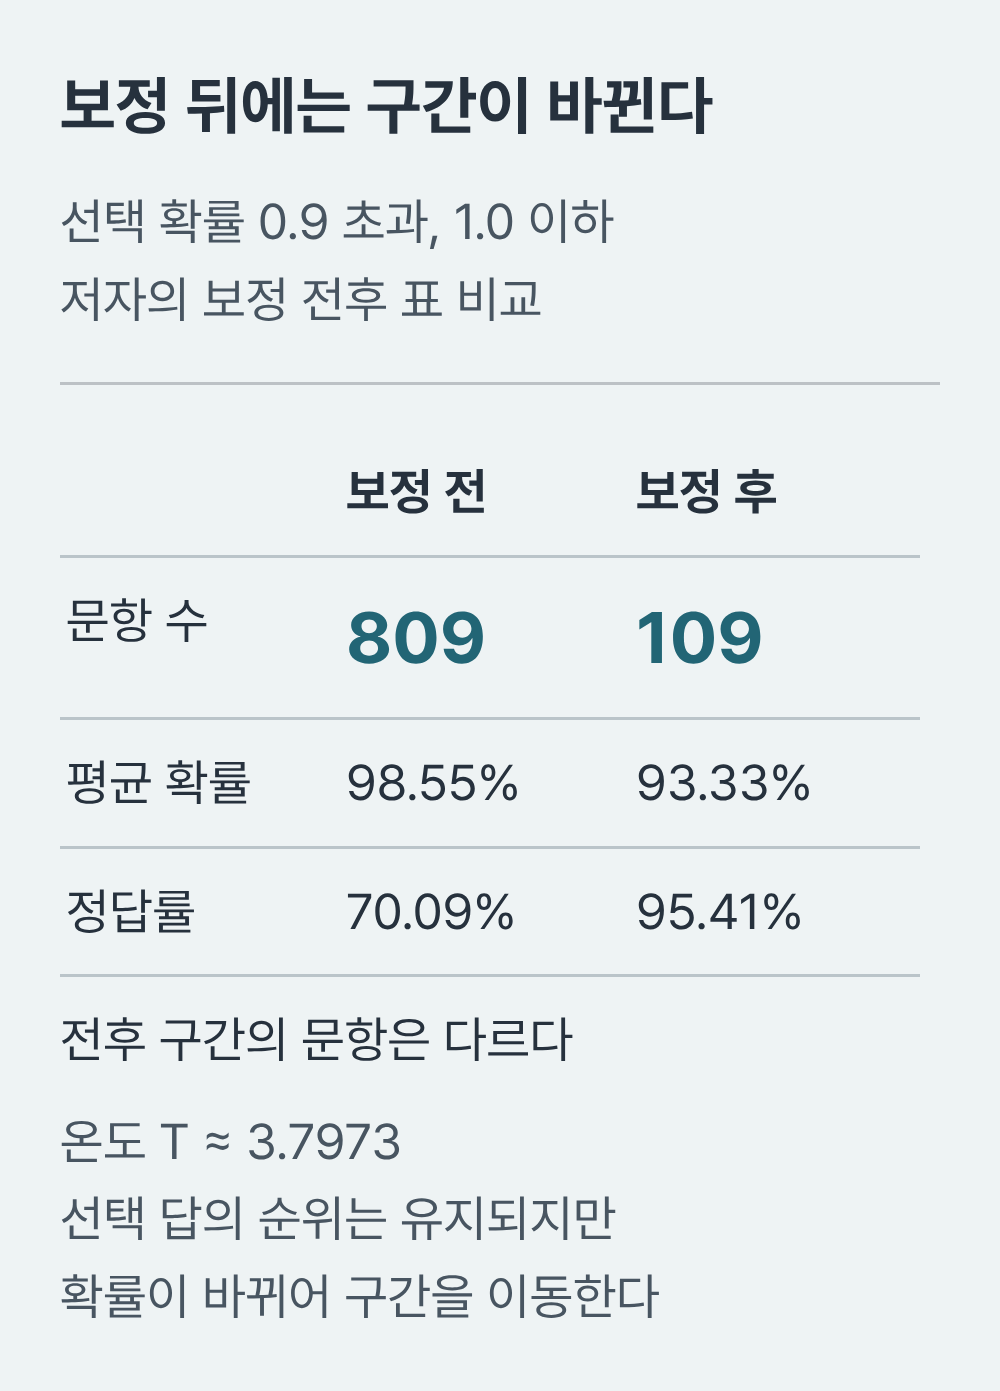
저자는 온도 보정(temperature scaling)으로 선택지 점수를 조정했다. 소프트맥스를 적용하기 전에 점수를 양의 온도 T로 나누는 방식이다. T가 커지면 한 선택지에 몰린 확률이 완만해진다. 같은 점수들에 같은 양의 T를 적용하면 크기 순서는 유지되므로, 가장 큰 값을 고르는 답도 바뀌지 않는다. 확률 보정은 분류 정확도 향상과 목적이 다르다.
Tahir가 보고한 온도는 3.797280788421631이다. 보정 뒤 표의 0.9 초과, 1.0 이하 구간에는 109문항이 남았고, 평균 확률은 0.9333, 정답률은 0.9541이었다. 0.8 초과, 0.9 이하 구간은 169문항, 평균 확률 0.8507, 정답률 0.7988이었다. 숫자 사이의 간격은 줄었지만, 보정 전 809문항과 보정 후 109문항은 같은 집단이 아니다. 점수가 낮아지며 문항들이 다른 구간으로 이동했기 때문이다.
공개된 보정 스크립트는 기본으로 dataset/validation.jsonl을 읽고, 정답 라벨을 이용해 온도를 맞춘 뒤 같은 데이터에서 보정 지표를 출력한다. 원문은 별도의 최종 평가셋에서 얻은 보정 결과를 제시하지 않는다. 업무에 적용할 때는 온도를 정하는 데이터와, 정해진 온도 및 승인 기준을 평가할 데이터를 나눠야 한다.
자동 승인 기준은 부서별 오배정 비용에서 정한다
PM이 '점수 0.9 이상은 자동 처리'를 먼저 정하면, 그 점수가 얼마나 믿을 만한지 뒤늦게 확인하게 된다. 먼저 실제 문의와 사람이 합의한 정답 부서를 모아야 한다. 복합 문의나 정보가 빠진 문의는 정답을 한 부서로 강제할지, 담당자가 다시 볼 대상으로 둘지부터 정한다. 제품의 성공·실패를 먼저 정의하는 방식은 Airbnb의 평가 주도 개발과도 연결된다.
그다음 보정용 표본으로 온도를 정하고, 별도 표본에서 점수 구간별 정답률을 확인한다. 부서별 표본 수도 함께 봐야 한다. 배송 문의가 많아서 전체 정답률이 높아져도, 적게 들어오는 결제 오류를 계속 놓칠 수 있다. 문의 내용과 부서 정의가 바뀌면 기존 보정값도 다시 점검한다.
승인 기준을 비교할 때는 자동으로 넘긴 문의가 전체 중 얼마나 되는지와, 그 문의 중 잘못 넘긴 비율을 함께 기록한다. 기준을 높여 오배정을 줄여도 대부분을 사람이 다시 확인해야 한다면 절약되는 시간은 작다. 반대로 잘못 배정해도 쉽게 되돌릴 수 있는 문의 분류와, 돈을 돌려주는 환불 승인은 같은 기준으로 묶기 어렵다.
환불처럼 손실이 큰 작업은 점수와 별개로 금액·권한 확인을 거치게 하고, 표본이 적거나 새 유형인 문의는 검토 대기열로 보낸다. 자동 처리한 건도 일부를 계속 사람이 채점하면, 출시 뒤 바뀐 문의에서 오배정이 늘어나는지 확인할 수 있다. 승인 기준은 이 기록을 보고 조정한다.
출처: Nish Tahir, Build your own decision model · 실험 코드 · Qwen3-1.7B 모델 문서