
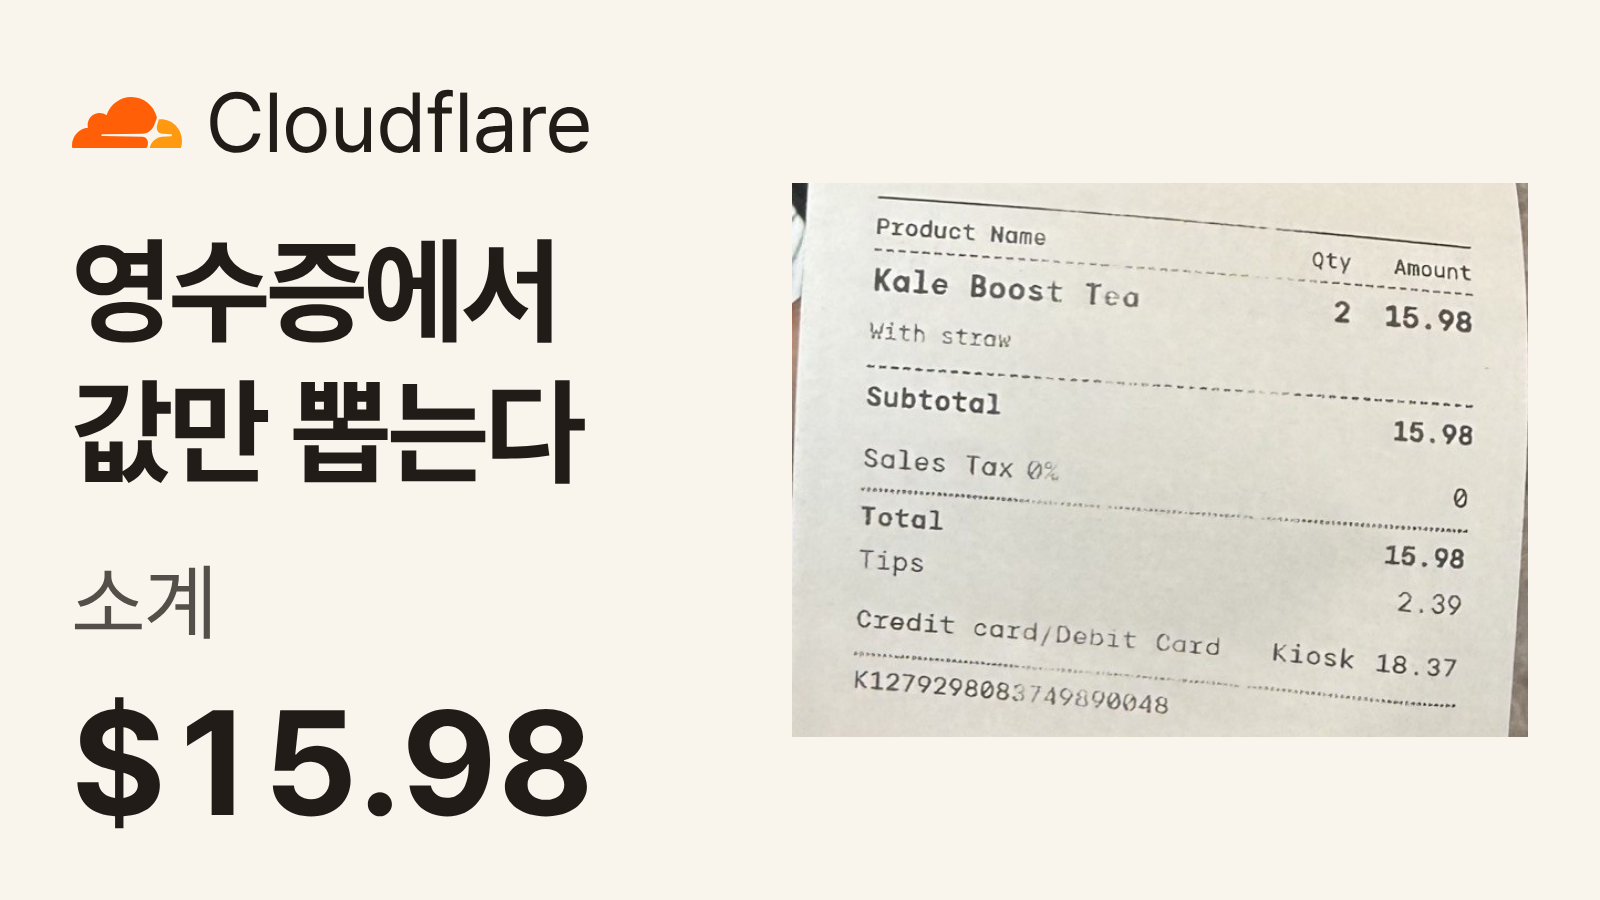
영수증에서 금액을 읽거나 고객 메일에서 주문번호를 찾을 때, 필요한 답은 대개 한두 개의 값이다. 그런데 범용 언어모델에 이 일을 맡기면 값을 읽은 뒤 다시 글자 단위로 답을 생성한다. 형식이 맞는지 검사하고 원문 숫자와 대조하는 작업도 뒤따른다.
Cloudflare는 10월 19일 이런 반복 작업을 겨냥한 추출 모델 Clairic의 프리뷰를 공개했다. 문장을 쓰는 대신 입력에서 텍스트와 숫자, 날짜를 뽑거나 값을 계산하고, 추정과 예측에는 범위를 붙여 돌려준다. 문서 처리 자동화를 만드는 쪽이라면 답변을 얼마나 잘 쓰는지보다, 필요한 값이 어디서 왔고 다음 처리에 바로 넘길 수 있는지를 살펴볼 만한 발표다.
사진 속 글자를 읽으면 무엇이 돌아오나
발표문에는 손에 든 음료 영수증 사진과 그 사진을 처리한 응답이 함께 실렸다. 종이는 비스듬하고 글자도 균일하게 선명하지 않다. 공개된 응답에서 주문번호는 77245, 구매 시각은 2026년 7월 1일 13시 34분으로 나온다. 수량 2개와 소계 15.98달러, 팁 2.39달러도 서로 다른 필드에 담겼다. 할인 항목은 null이다.
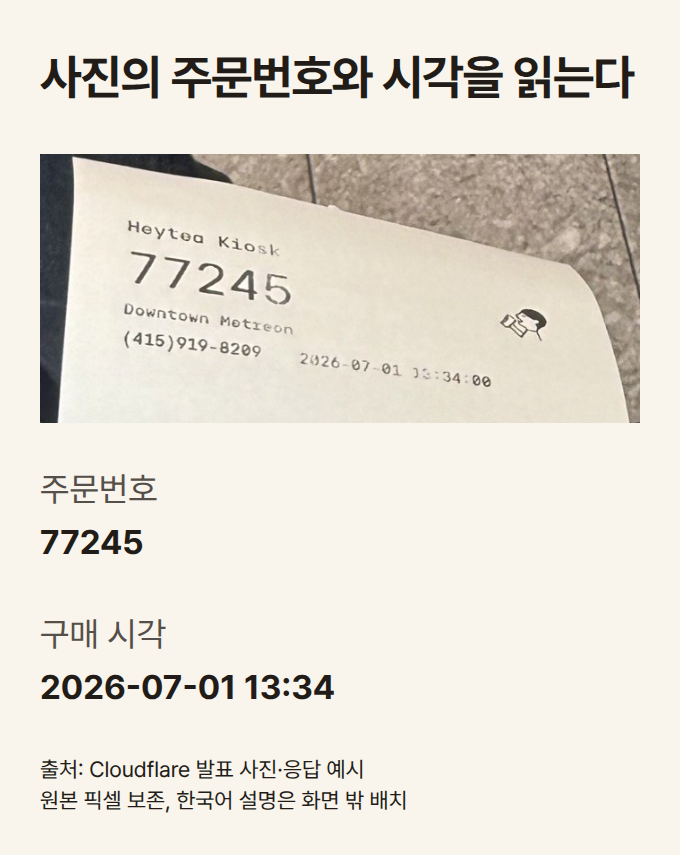
이때 소계와 최종 결제액은 구분해야 한다. 사진에는 팁을 더한 카드 결제액 18.37달러가 따로 적혀 있다. 자동으로 장부에 넣으려면 '금액'이라고만 요청하기보다 소계인지, 세금과 팁을 포함한 결제액인지 먼저 정해야 한다. 모델이 숫자형으로 응답해도 잘못 고른 항목이 올바른 회계 값이 되지는 않는다.
요청은 읽을 텍스트와 선택적으로 이미지 최대 4장, 그리고 필드별 자료형과 설명으로 이뤄진다. 텍스트 필드는 원문에서 차지하는 문자 위치도 반환한다. 담당자가 주문번호를 눌렀을 때 원문 속 같은 부분을 표시하는 검토 화면을 만들 수 있다는 뜻이다. 이미지의 모든 값에 사진 속 좌표가 제공된다는 의미는 아니다.
문장 생성과 값 추출을 나누는 까닭
Clairic은 출력 토큰을 순서대로 생성하지 않고 한 번의 전방 계산으로 여러 필드에 답하는 방식이다. Cloudflare는 이를 빠른 처리를 맡는 'System One' 모델이라고 부른다. 미리 나열한 선택지 중 하나를 고르는 Jev·Clef 같은 의사결정 모델과 달리, Clairic은 금액이나 날짜처럼 선택지를 전부 적어 둘 수 없는 값을 다룬다. 자유로운 설명과 답변 작성은 여전히 언어모델의 몫이다.
원문의 고객 메일 예시는 이 차이를 구체적으로 보여 준다. 고객은 제품값 649달러와 세금 52.10달러를 냈다고 적었다. 공개된 Clairic 응답은 두 금액을 합친 701.10달러를 반환했고, 배송일과 메일 작성일의 차이는 11일로 계산했다. 입력에 없는 배송 추적번호의 최종 값은 null로 남겼다.
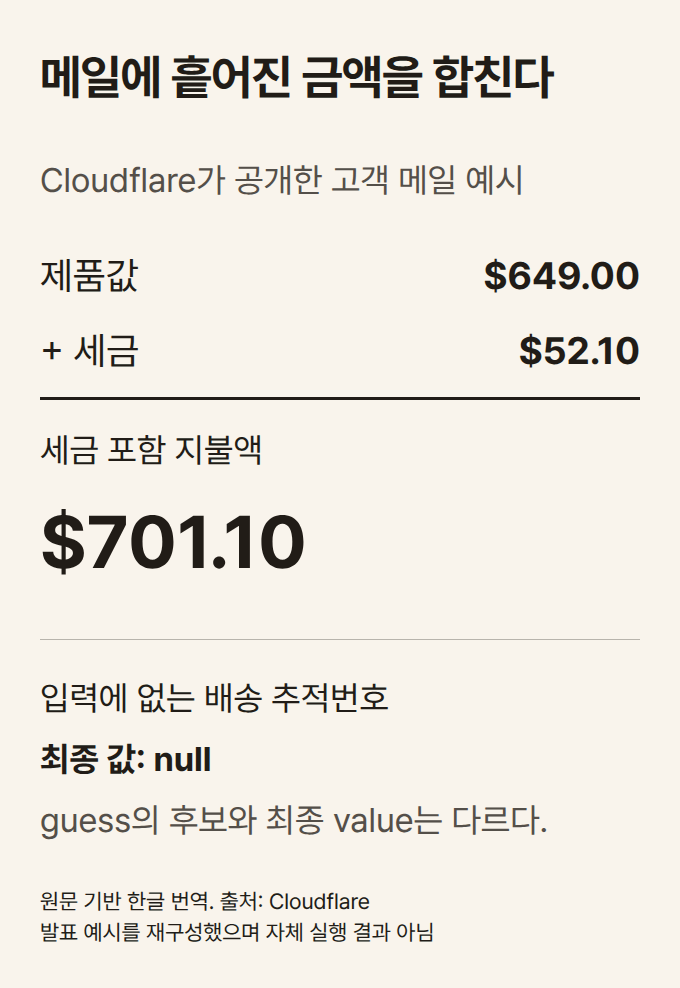
응답에는 최종 값 외에 confidence와 값이 입력에 없을 확률인 p_null, 후보 값인 guess도 담긴다. 이 예시에서 추적번호의 guess는 세금인 '$52.10'을 가리키지만 최종 value는 비어 있다. 후보 값을 최종 답처럼 저장하지 않아야 하는 이유다. 검토 대상을 가르는 데 쓸 신호가 생기지만, 자료형이 맞는다는 보장과 내용이 옳다는 보장은 서로 다르다.
빠른 추출이 전체 처리 시간도 줄였을까
Cloudflare는 파손 제품 문의에 답하는 흐름도 비교했다. Clairic이 메일에서 값을 뽑고 Clef가 환불과 수리 중 처리 방향을 정한 다음, GLM-5.3이 답장을 쓰는 방식이다. 비교 대상은 같은 메일·정책·프롬프트로 세 단계 모두 GLM-5.3에 맡긴 경우다.
회사 측 측정에서 전체 시간은 역할을 나눈 쪽이 19.3초, 언어모델만 쓴 쪽이 61.7초였다. 추출과 판단이 각각 0.46초와 0.22초로 끝났고, 답장 작성에는 18.6초가 걸렸다. 앞부분을 줄인 뒤에는 문장 생성이 대부분의 시간을 차지한다. 측정 대상은 이 파손 문의 예시다.
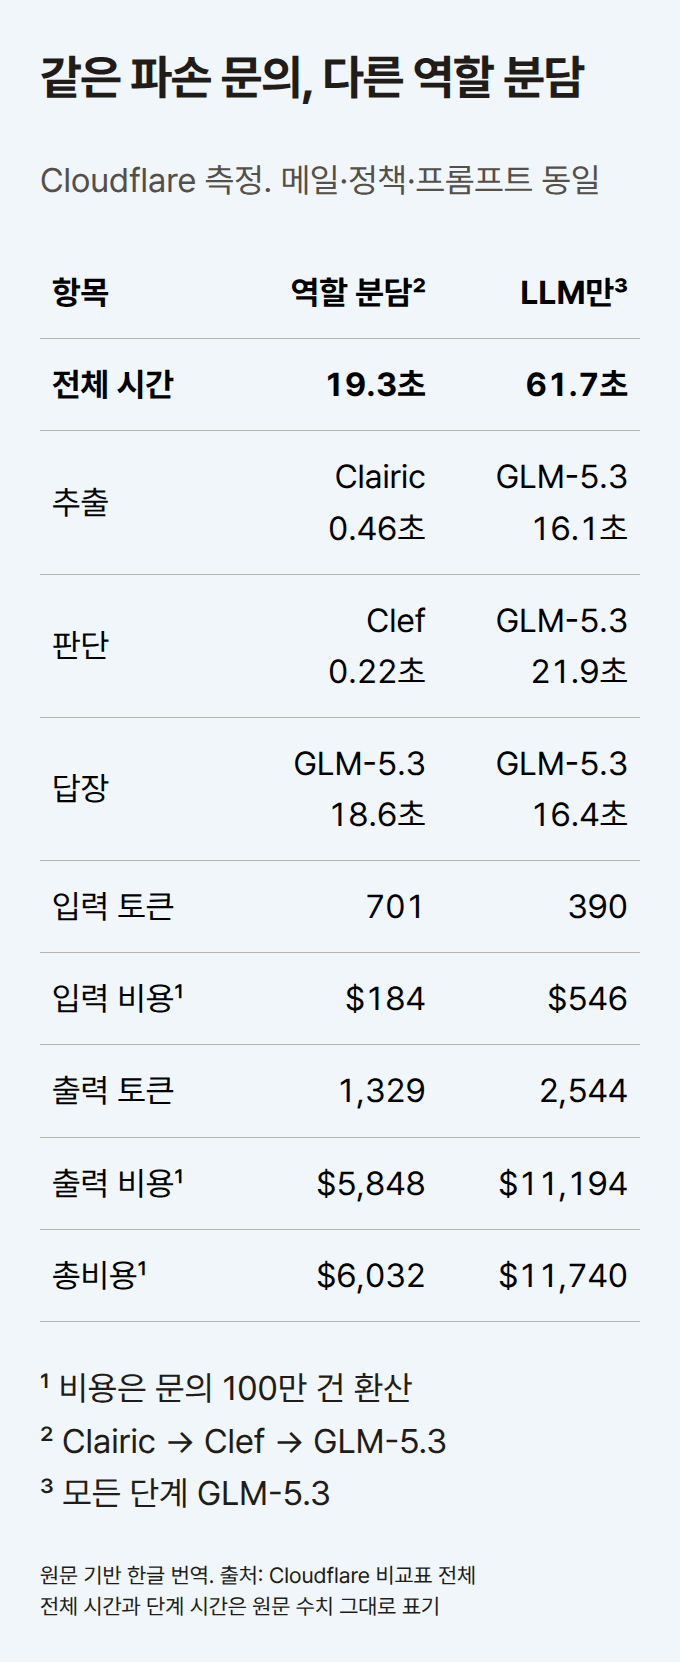
100만 건으로 환산한 비용은 각각 6,032달러와 11,740달러로 제시했다. 둘 다 답장 생성까지 포함한 값이다. 두 방식 모두 GLM-5.3을 쓴 비교에서는 매번 사실 추출과 결정을 맞혔다고 설명했으므로, 이 표를 정확도 우열의 증거로 읽을 수는 없다. 모델 공식 문서의 Clairic 가격은 입력 100만 토큰당 0.10달러이며 출력 토큰 요금은 없다. 필드 설명도 입력에 포함되고 필드가 한 번의 처리에 담기지 않으면 여러 병렬 패스로 나뉘므로, 필드를 늘려도 비용이 언제나 같다고 볼 수는 없다.
어떤 일을 맡기고 계산은 어디에 둘까
실무에서 먼저 떼어 볼 만한 것은 형식이 일정하지 않은 문서에서 반복해서 찾는 값이다. 주문번호, 납기일, 청구액처럼 필드 이름과 의미를 정할 수 있고 원문과 대조할 수 있는 작업이 여기에 들어간다. 추출한 값으로 합계를 내거나 업무 규칙을 적용하는 부분은 기존 코드와 연결하면 된다. 환불 가능 여부가 명확한 규칙으로 결정되는 서비스라면, 예시처럼 의사결정 모델까지 넣을 필요도 없다.
Cloudflare 역시 초기 체크포인트에서 긴 연쇄 계산이나 많은 표 행을 합산하는 작업은 어렵다고 설명한다. 추정값은 입력 속 비교 사례나 이력에 기대고, 익숙하지 않은 데이터에서는 예측 구간이 지나치게 좁아질 수 있다. 따라서 정산처럼 작은 오차도 문제가 되는 곳에서는 추출값을 원문과 대조하고 산술은 코드로 확인하는 편이 맞다.
프리뷰는 Workers AI의 @cf/cloudflare/clairic에서 제공된다. 가중치 공개는 발표 당시 계획으로 남아 있다. 도입을 검토한다면 자주 처리하는 실제 문서를 모아 필드별 오독과 누락을 확인하고, 사람이 다시 볼 항목을 어떤 신호로 고를지부터 정하면 된다. 답장 생성 모델을 바꾸기 전에, 그 모델에 넘길 값부터 분리해 볼 수 있다.