
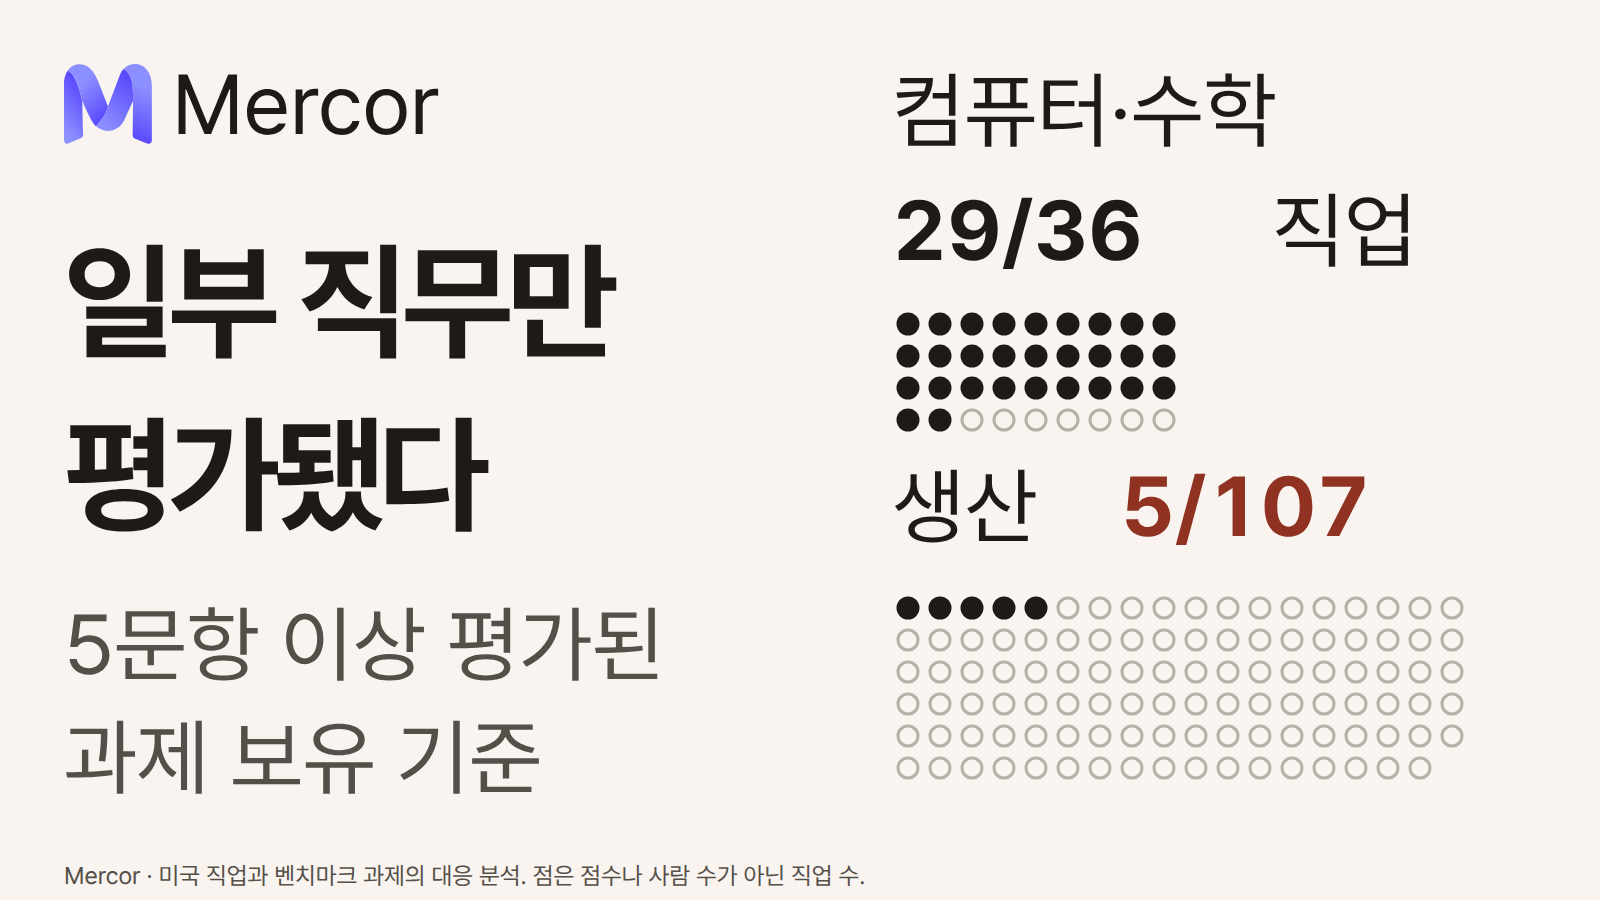
모델 순위표에서 높은 점수를 받은 제품을 골라도, 우리 팀이 맡길 일까지 평가됐는지는 별개의 문제다. Mercor가 공개한 ‘미국 경제 벤치마크 지도’는 이 간격을 직업과 과제 단위로 보여 준다. 2026년 10월 17일 확인한 지도는 미국 직업 923개와 과제 18,797개를, 회사가 선정한 벤치마크 29개에 대조한다.
그중 과제 하나 이상이 평가 문항 5개와 연결된 직업은 208개, 같은 기준을 충족한 과제는 924개였다. Mercor는 미국 근로시간의 약 90%가 이 목록에서 평가가 드물거나 없는 과제에 쓰인다고 추정한다. ‘대부분의 일을 못 한다’는 성능 판정이 아니라, 현재 모아 놓은 시험으로는 답하기 어려운 영역이 넓다는 뜻이다.
색칠된 직업은 어떤 일을 평가했다는 뜻일까
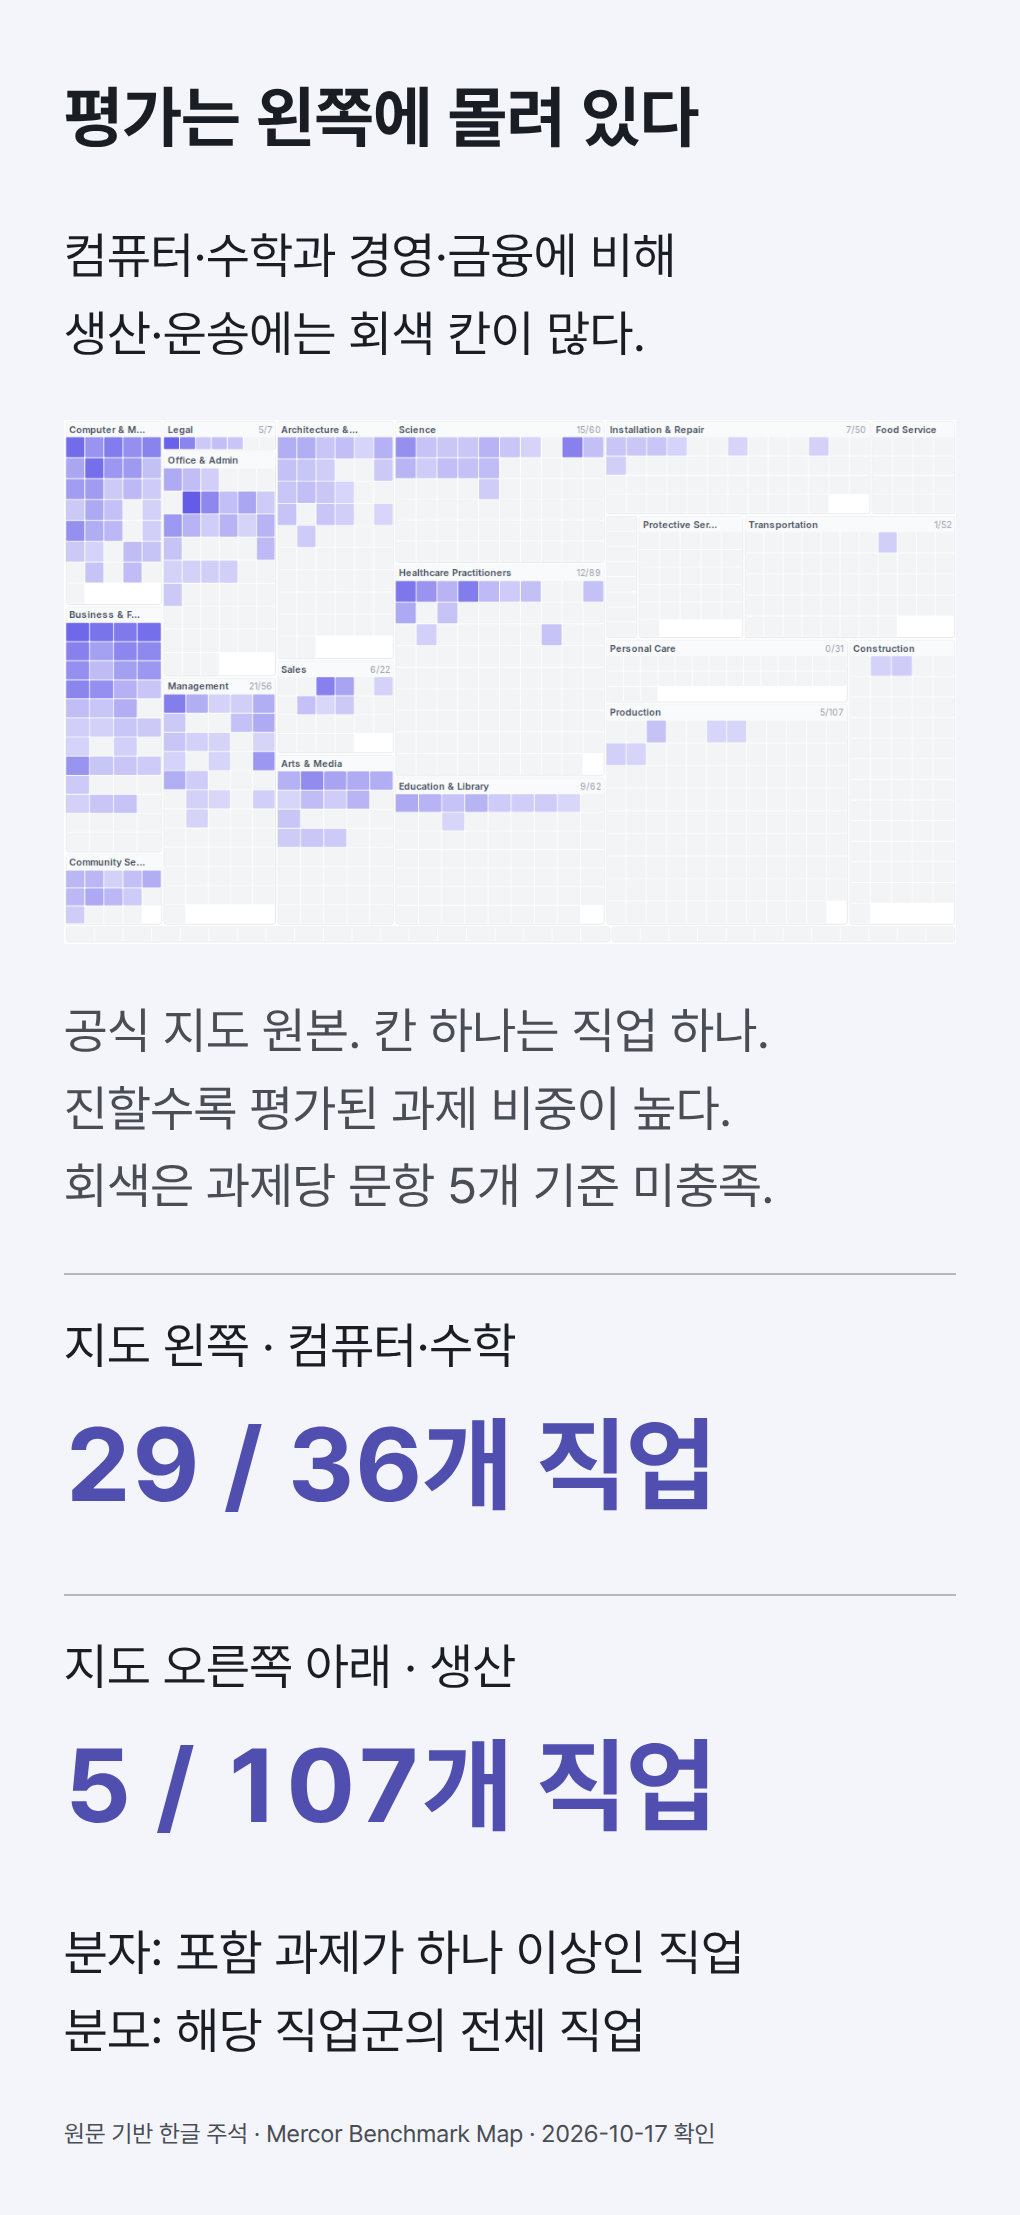
지도는 미국 노동부의 직업·과제 분류인 O*NET을 사용한다. 직업마다 실제로 하는 일을 나누고, 벤치마크 문항이 어느 과제에 해당하는지 언어모델로 연결했다. 한 문항을 여러 과제와 연결할 수도 있다. 기본 화면에서 ‘포함’으로 세는 문턱은 과제당 문항 5개다. 직업의 과제 하나가 이 문턱을 넘으면 그 직업도 포함 직업 수에 들어간다.
따라서 208개라는 숫자는 직업 전체를 충분히 시험했다는 뜻이 아니다. 지도에서 진한 칸은 그 직업에서 기준을 충족한 과제의 비중이 높다는 표시다. 컴퓨터·수학 직업군은 36개 중 29개 직업에 포함 과제가 있었지만, 생산 직업군은 107개 중 5개였다. 요식 서비스 등 6개 직업군에는 이 기준을 충족한 직업이 없었다.
근로시간 90%라는 값의 계산에는 과제별 시간 비중 추정도 들어간다. 이 시간 비중 역시 언어모델로 추정한 연구를 활용했다. 미국 직업 분류와 선정된 29개 시험을 기준으로 만든 값이므로, 한국 회사의 업무시간이나 모든 공개 벤치마크의 공백 비율로 옮겨 읽을 수는 없다.
같은 법률 업무라도 시험에 등장하는 일은 다르다
원문은 변호사와 법률 비서·법원 서기를 비교한다. 자동화에 노출된 과제가 비슷하게 있어도, 이 목록은 변호사의 과제를 많이 다루고 법률 비서나 법원 서기의 과제는 거의 다루지 않았다. 문서를 읽고 쓰는 직업이라는 공통점만으로 같은 모델 점수를 적용하기 어려운 사례다.
Mercor의 분석에서는 자동화 노출 정도를 통제한 뒤에도 직업의 임금총액이 클수록 과제가 시험에 포함될 확률이 높았다. 여기서 임금총액은 개인의 연봉이 아니라 해당 직업의 임금과 종사자 수를 결합한 시장 규모다. 이 결과만으로 평가 제작자의 의도를 알 수는 없지만, 규모가 작은 사무직의 세부 업무를 대표 점수만으로 판단하기 어렵다는 설명에는 근거가 된다.
벤치마크 선정 방식도 결과에 영향을 준다. Mercor는 기업에서 할 법한 작업을 직접 수행하는 시험과 아직 최상위 모델이 만점을 받지 못하는 시험을 우선했고, 직업군별 시험 수에도 상한을 뒀다. 소프트웨어 시험이 너무 많아 지도를 압도하지 않게 한 선택이다. 대신 소프트웨어처럼 시험이 많은 분야의 포함 범위는 실제보다 작게 잡힐 수 있다.
문항 수 대신 과제에 같은 무게를 주면 해결될까
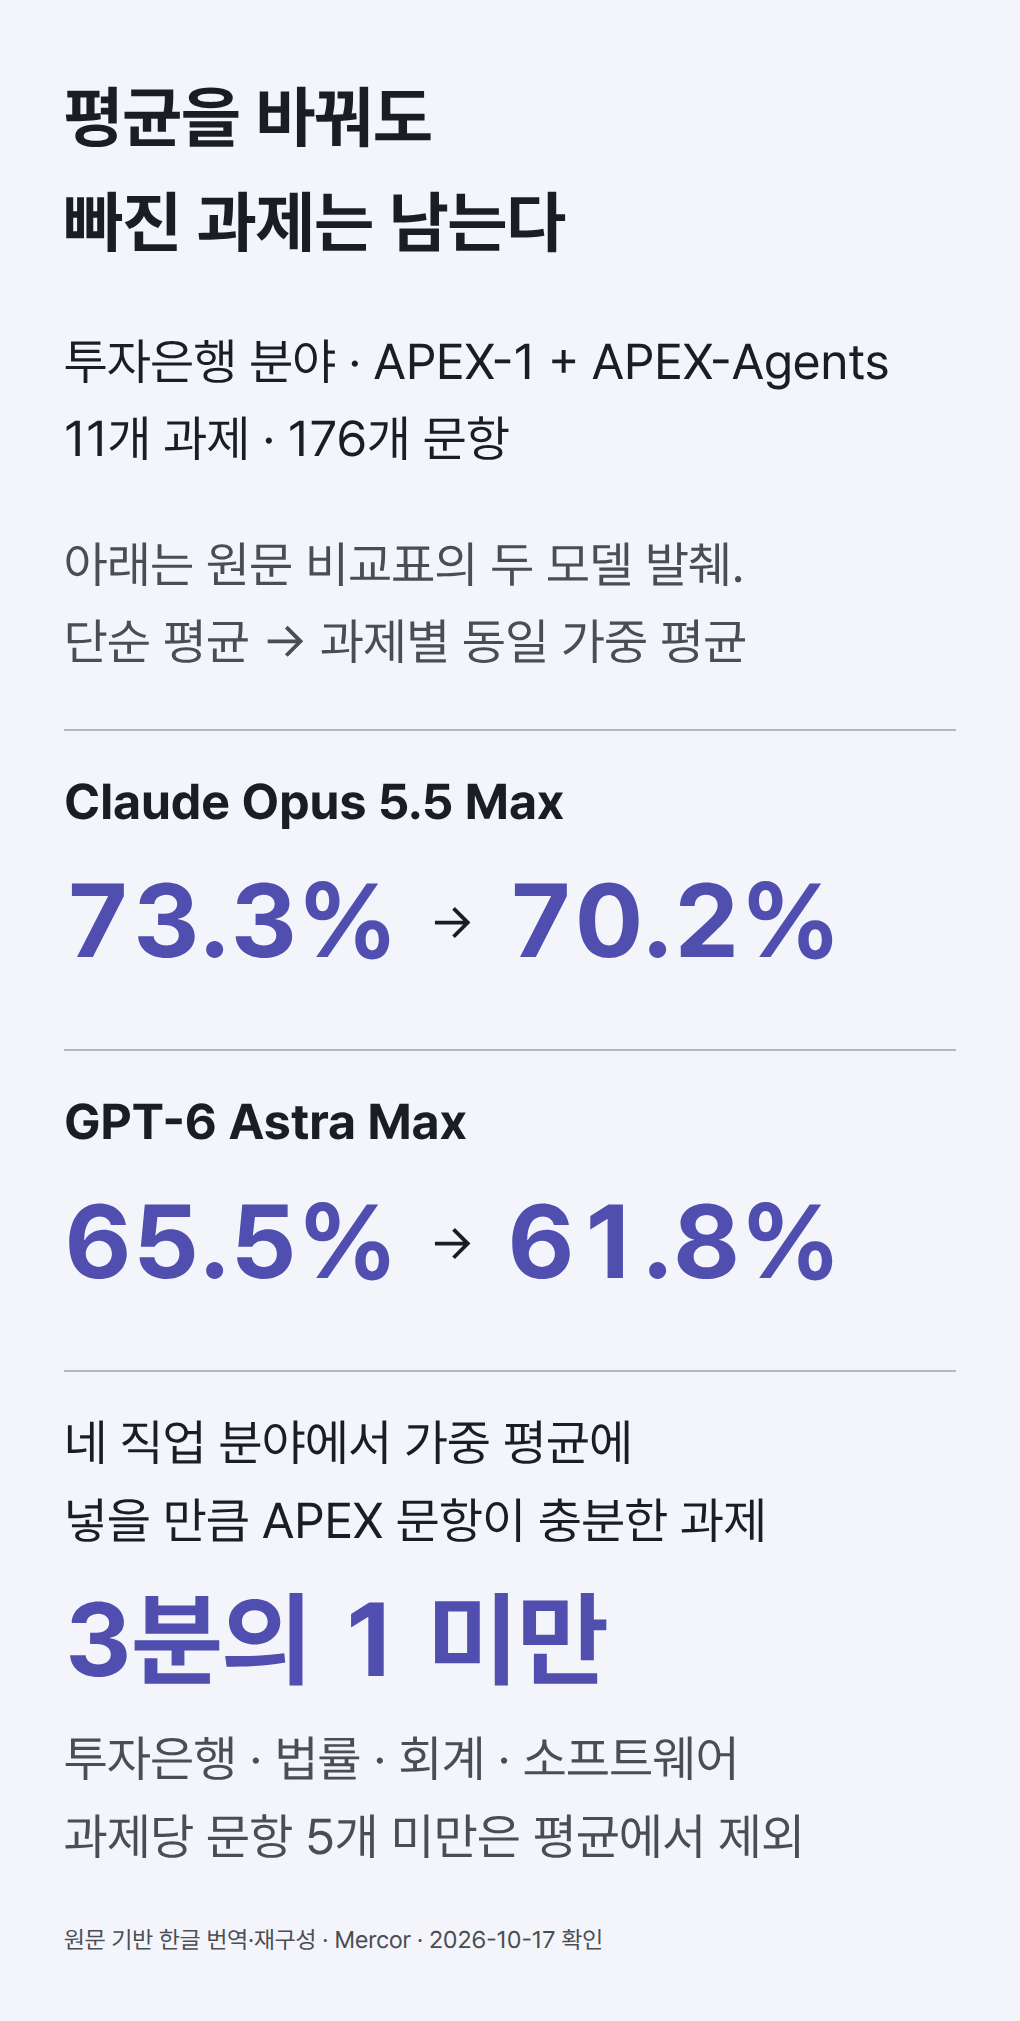
한 과제에는 문항이 많고 다른 과제에는 적다면, 모든 문항을 단순 평균한 점수는 자주 출제된 일에 더 끌린다. 원문은 APEX 벤치마크를 이용해 투자은행·법률·회계·소프트웨어 엔지니어링에서 다른 평균을 계산했다. 과제별로 먼저 점수를 구한 다음 과제마다 같은 무게를 줬다.
투자은행 예시에서 Claude Opus 5.5 Max는 문항별 단순 평균 73.3%, 과제별 동일 가중 평균 70.2%였다. GPT-6 Astra Max는 각각 65.5%, 61.8%였다. Mercor는 전반적으로 두 계산의 점수가 비슷했다고 설명한다. 그러나 이 네 직업 분야에서 가중 평균에 들어갈 만큼 APEX 문항이 충분한 과제는 관련 과제의 3분의 1 미만이었다. 평균 계산을 바꿔도 시험에 없는 일을 채워 넣지는 못한다.
문항을 직업에 연결하는 판단도 점검했다
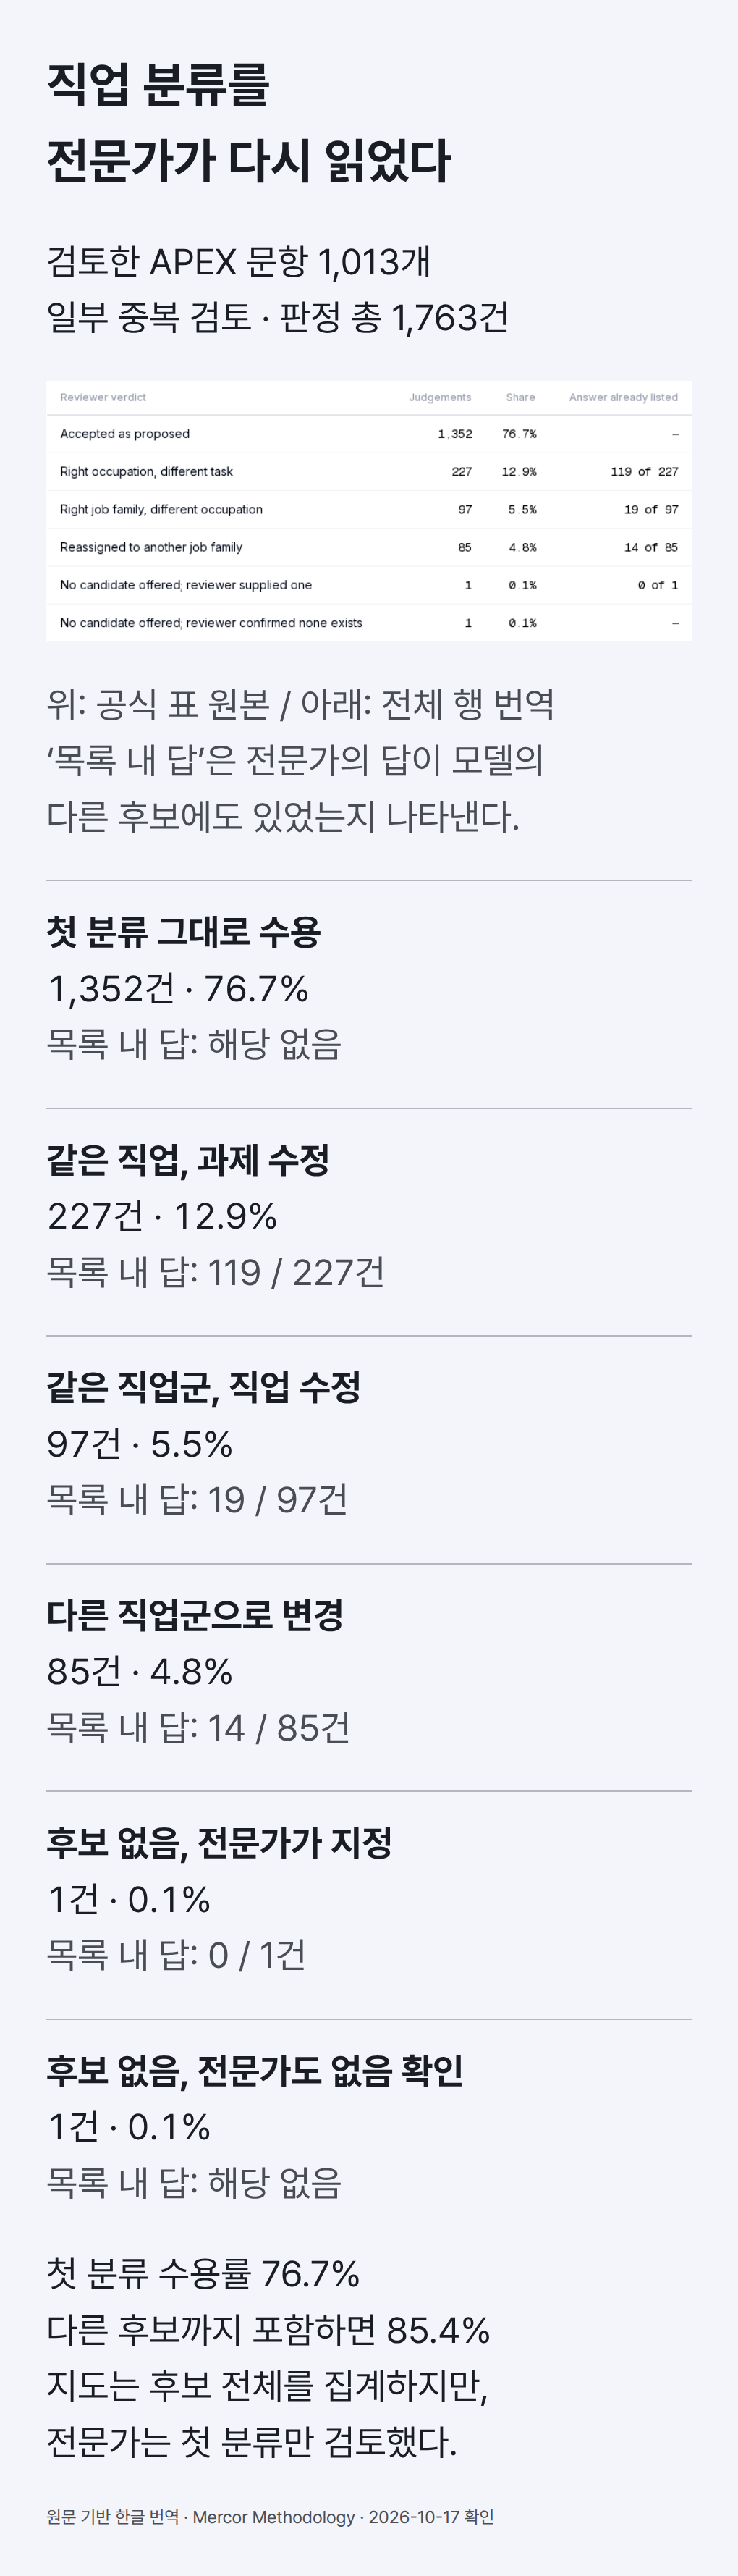
지도 제작에 쓴 분류 모델은 GPT 5.6 Luna다. Mercor는 APEX-1·APEX-Agents·APEX-Accounting의 문항 1,022개 중 1,013개에 대해 전문가 검토를 진행했다. 일부 문항을 여러 명이 검토해 판정은 총 1,763건이었다. 전문가가 모델의 첫 과제 분류를 그대로 받아들인 비중은 76.7%였다.
첫 분류가 아니라 모델이 제시한 다른 후보 과제까지 인정 범위를 넓히면, 전문가가 선택한 답이 목록 안에 있던 비중은 85.4%가 된다. 지도는 후보 과제를 모두 집계하지만, 전문가는 첫 분류만 검토했다. 따라서 이 수치를 전체 연결 관계의 정확도라고 부를 수는 없다. 뒤에 분류한 APEX-SWE에는 이 전문가 검토가 없었다.
도입할 때는 직함보다 맡길 과제를 먼저 적는다
이 지도를 회사의 모델 선정에 활용한다면, ‘법무용 모델’처럼 직함에 맞는 점수 하나를 찾는 데서 멈추지 않는 편이 낫다. 예를 들어 계약 초안 작성과, 계약서의 누락 항목을 찾아 담당자에게 확인 요청을 남기는 일은 같은 법무 부서 안에서도 다른 평가 과제다. 이 예시는 사내 시험을 설계하는 방법이지 Mercor가 두 작업을 직접 비교한 결과는 아니다.
실제 맡길 입력 자료와 기대 산출물을 적어 보면 어떤 벤치마크 문항이 닮았는지, 무엇이 빠졌는지 대조하기 쉬워진다. 평가가 있는 부분은 후보를 좁히는 데 쓰고, 빠진 부분은 사내 자료로 시험해야 한다. 사람이 초안을 고치는 시간까지 줄이려는 도입이라면, 모델 단독 정답률에 더해 검토·수정에 걸린 시간을 함께 측정할 이유도 생긴다. 원문 역시 작업 전체의 자동화 평가와 사람의 생산성 향상 평가를 서로 다른 문제로 다룬다. 분류 결과를 실제 업무에 연결할 때는 누가 승인하고 오류가 나면 어디서 멈출지도 함께 정해야 한다.
출처: Mercor, A benchmark map of the US economy · Methodology · Benchmark Index