
고객 기록을 합쳐 한 사람의 신원으로 묶는 작업에는 늘 같은 사고가 따른다. 서로 다른 두 사람의 기록이 한 신원에 들어가는 과잉 병합이다. 이 사고가 얼마나 흔한지 알려면 사람이 신원을 하나씩 열어 봐야 한다. Hightouch 팀은 이 점검에 한 시간에 약 50건이 걸리고, 드문 사고의 비율을 오차 ±1% 안으로 추정하려면 1,000건이 넘는 표본이 필요하다고 적었다.
그래서 이 팀은 점검을 모델에게 맡겨 봤다. 결론은 어려운 건 큰 모델에게 물어보는 방식이 값싼 모델 단독보다 정확하고 큰 모델 단독보다 싸다는 것이다. 다만 4분의 1이라는 비용은 쉬운 시험에서만 나온 수치다. 어려운 시험에서는 절감 폭이 절반 아래로 줄었다.
채점시킨 일은 과잉 병합 찾기였다
시험 자료는 워싱턴대학교 보건지표평가연구소의 pseudopeople로 만든 가상의 미국 소도시 기록이다. 센서스, 가구 조사, 사회보장, 세금 신고 서류에 현실적인 입력 오류를 섞었다. 신원 1,000건 가운데 절반은 한 사람의 지저분한 기록이고, 절반은 서로 다른 사람이 섞인 과잉 병합이다. 모델은 각 신원이 과잉 병합인지 판정한다.
비교 대상은 Claude Opus 5.5, Gemini 3.1 Pro, GPT-6 Sol 같은 대형 모델과, 조건이 참일 확률을 0~1로 내놓는 결정 모델 두 개(Jev, OpenAI Decisions API의 GPT-6 Luna)였다. 결정 모델이 무엇이고 문장 모델과 어떻게 다른지는 AI가 문장 대신 선택지만 고르면, 챗봇 밖에서 무엇을 할 수 있을까에서 다뤘다. 프롬프트에 입력 오류의 종류를 나열하자 모든 모델의 정확도가 가장 크게 올랐다고 한다.
싼 모델은 빠르고 값쌌지만 덜 정확했다
쉬운 시험에서 Opus 5.5는 99.0%를 맞혔고 1,000건을 채점하는 데 3.86달러가 들었다. 건당 2.2초가 걸렸다. Jev는 95.6%였고 비용은 0.05달러, 건당 0.15초였다. Luna는 97.3%에 0.10달러, 0.17초였다. 정확도는 Opus보다 2~3점 낮지만 비용은 39분의 1에서 77분의 1이다.
오답 수로 보면 차이가 더 또렷하다. 1,000건 중 Jev 단독은 44건을 틀렸고, Opus는 10건을 틀렸다. 판정 결과를 사람이 다시 보지 않고 쓴다면 이 차이가 곧 품질이다.
확신도가 중간인 22%만 Opus에게 넘겼다
저자들이 쓴 해법은 Jev가 낸 확신도를 분류 기준으로 쓰는 것이다. 모든 신원을 Jev가 먼저 보고, 확신도가 정해 둔 구간 안에 들어오는 것만 Opus에게 다시 묻는다. 구간 밖이면 Jev의 답을 그대로 쓴다. 비용은 Opus에게 넘어간 비율만큼만 늘어난다.
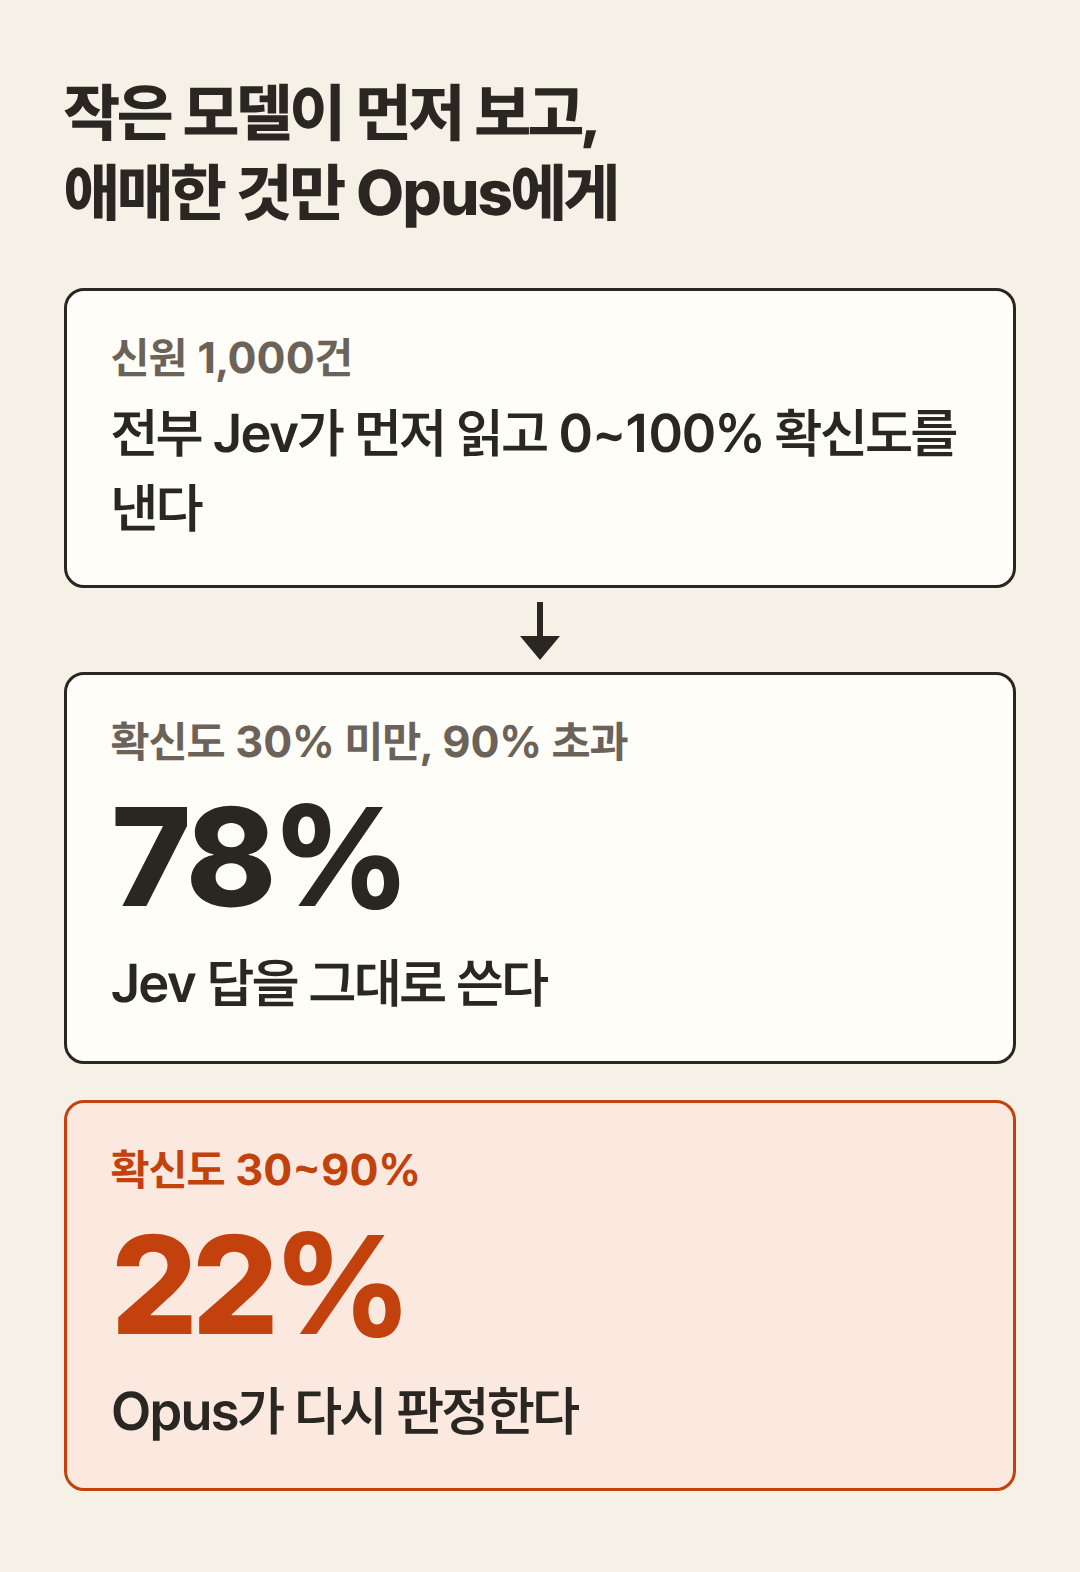
구간을 30~90%로 잡으면 신원의 22%가 Opus에게 갔고, 정확도는 98.8%, 비용은 1,000건당 0.88달러, 건당 0.63초였다. Opus 단독과 비교하면 정확도는 0.2점 낮고 비용은 4.4분의 1이다. 오탐은 5건, 미탐은 7건이다.
구간 폭이 비용과 정확도를 함께 정한다. 50~80%로 좁히면 7%만 넘어가서 97.5%에 0.31달러다. 10~100%로 넓히면 74%가 넘어가고 정확도는 Opus와 같은 99.0%지만 비용은 2.92달러라 Opus 단독보다 4분의 1 정도만 싸다. 30~90%에서 10~90%로 넓혀 보면 22%가 40%가 되고 비용은 거의 두 배가 되는데 정확도는 98.8%로 그대로였다. 이 시험에서는 30~90%가 가장 효율적인 지점이었다.
중간 확신도를 믿을 수 있는 모델이어야 한다
이 방식은 모델이 자기가 모른다는 신호를 정직하게 내야 작동한다. 저자들은 Jev의 실수가 대부분 확신도 50% 근처에 몰려 있다고 설명했다. 반대로 Luna는 오답이 더 적은데도 90~100% 구간에서 과신한다고 했다. 어려운 시험에서는 Luna의 과신이 더 심해졌다.
같은 방식을 Luna에 적용한 결과가 이를 뒷받침한다. 쉬운 시험에서 Luna를 먼저 두고 10~90% 구간만 Opus에게 넘기면 6%만 넘어가서 98.5%에 1,000건당 0.33달러였다. 비용만 보면 Jev 조합보다 싸다. 하지만 어려운 시험에서는 Luna 조합이 91.6%에 머문 반면 Jev 조합은 95.3%를 냈다.
어려운 시험에서는 절감이 4배에서 1.8배로 줄었다
저자들은 생년월일이나 이름에 오타가 있는 경우, 쌍둥이나 부자처럼 닮은 사람이 합쳐진 경우만 모은 더 어려운 시험도 돌렸다. Opus 단독은 95.1%로 떨어졌고 비용은 5.39달러로 올랐다. Jev 단독은 89.1%, Luna 단독은 88.8%였다. Jev를 먼저 두고 30~90%를 넘기는 조합은 95.3%에 2.94달러였다.
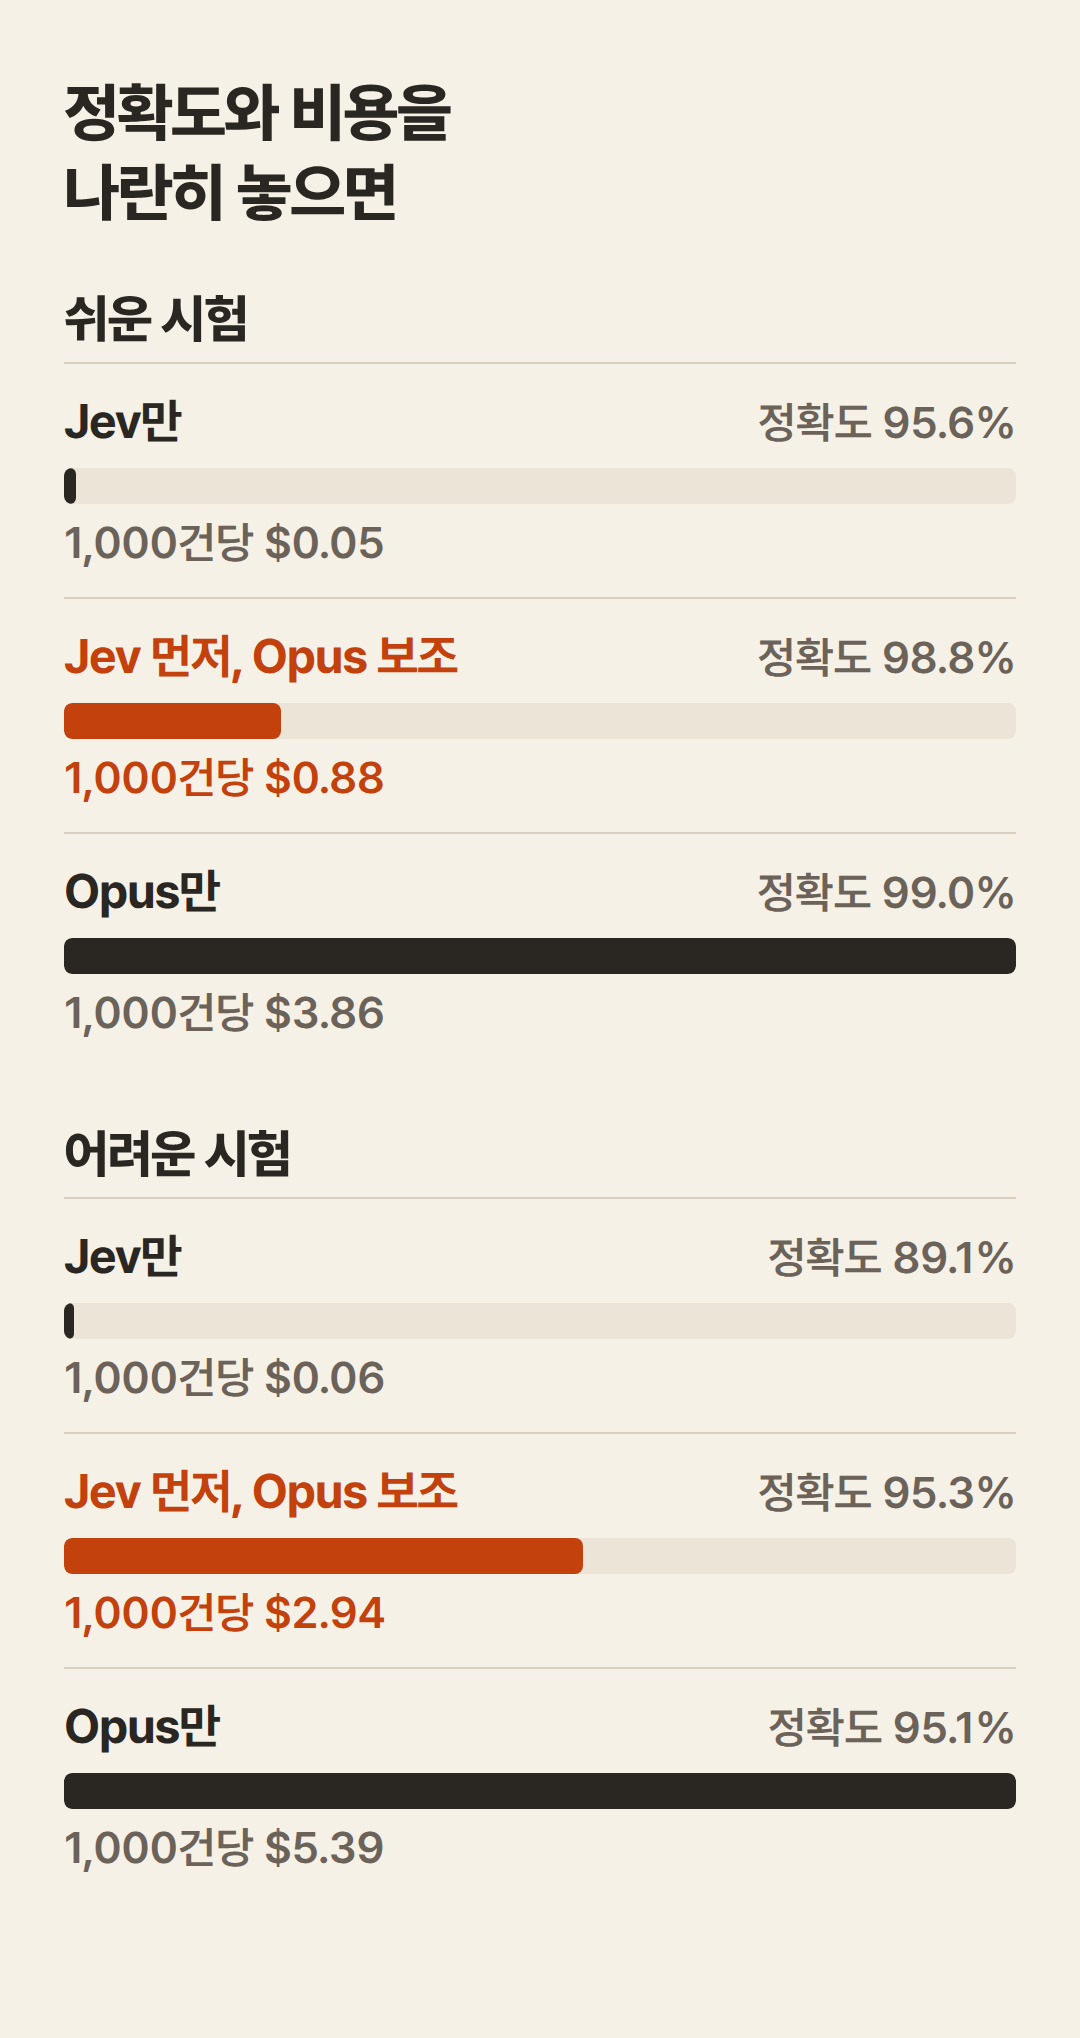
어려운 시험에서도 조합은 Opus 단독 이상의 정확도를 내지만 비용은 1.8분의 1이다. 원문 제목의 4배는 쉬운 시험의 수치다. 판정 비용을 아끼는 정도는 데이터가 얼마나 어려운가에 따라 달라진다.
자기 업무에 옮겨 볼 만한 설계다
싼 판단 모델이 실제 업무에서 맞힌 것과 놓친 것은 장애 진단 105회에 추론비 15센트에서 다뤘다. 판정할 일이 많고 대부분은 쉽다면, 작은 모델이 확신도를 내게 하고 애매한 구간만 큰 모델이나 사람에게 보내는 구조가 후보가 된다. 구간은 글의 값을 가져다 쓰기보다 사람이 채점한 자기 표본에서 정확도와 넘어가는 비율을 같이 보고 정해야 한다. 어려운 사례가 늘면 넘어가는 비율과 비용이 함께 오른다는 점도 예산에 넣어야 한다.
출처: Hightouch 블로그