
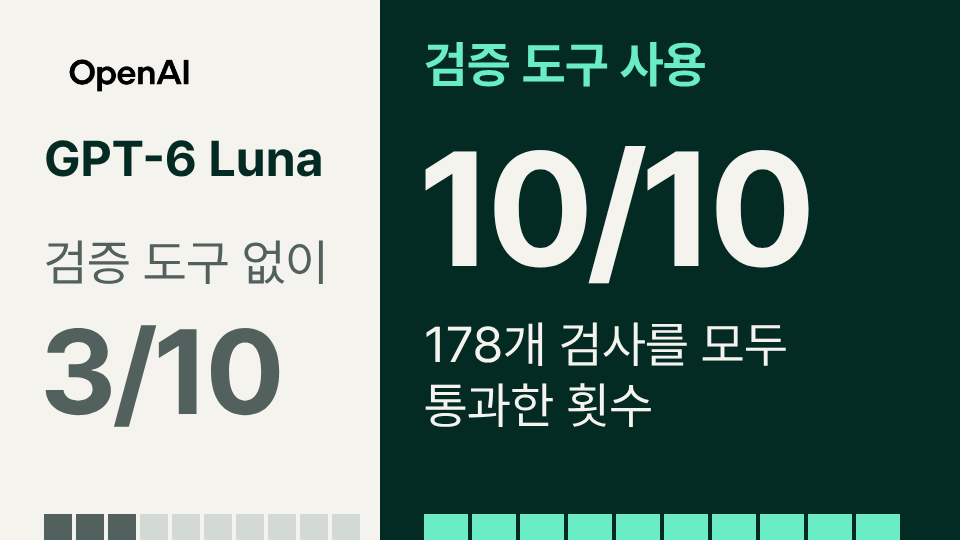
싼 코딩 모델을 쓰면 검토와 재작업에 돈이 더 들까. Specmatic 창업자 나레시 자인은 같은 API 서비스를 만들게 한 뒤, 개발 중 검증 도구를 제공했을 때와 주지 않았을 때를 비교했다. 10월 13일 마틴 파울러 사이트에 공개한 실험에서 GPT-6 Luna는 도구 없이 10회 중 3회, 도구를 쓰면 10회 모두 최종 평가를 통과했다.
검증을 붙인 Luna의 1회당 추정 생성 비용은 0.273달러였다. 검증 도구 없이도 10회 모두 통과한 GPT-6 Sol의 0.406달러보다 약 33% 낮다. 대신 Luna 쪽이 훨씬 오래 걸렸다. 이 결과를 모델 가격표만으로 읽으면 놓치는 선택지가 생긴다. 같은 통과 횟수를 얻더라도 비용과 대기 시간은 서로 다른 방향으로 움직인다.
무엇을 만들어야 통과했나
과제는 상품 검색용 자바 서비스였다. 앱의 요청을 받아 주문 API를 호출하고, 검색에 성공하면 첫 번째 상품만 Kafka로 보내야 했다. Kafka는 다른 서비스가 읽을 메시지를 전달하는 시스템이다. 결과를 그대로 중계하는 코드로는 부족했다. 요청과 응답의 형식을 검사하고, 어느 상품을 보낼지도 골라야 했다.
지연과 실패에 대한 약속도 구체적이었다. 상품 생성 요청이 시간 초과되면 202 상태와 진행 상황을 조회할 링크를 돌려주고, 백그라운드에서 재시도해야 했다. 검색 중 일시적인 실패에는 재시도 간격을 담은 429를, 의존 서비스 장애나 메시지 발행 실패에는 503을 반환해야 했다. 주문 API가 성공으로 응답해도 상품이 요청한 필터에 맞지 않으면 502로 처리하는 조건까지 있었다.
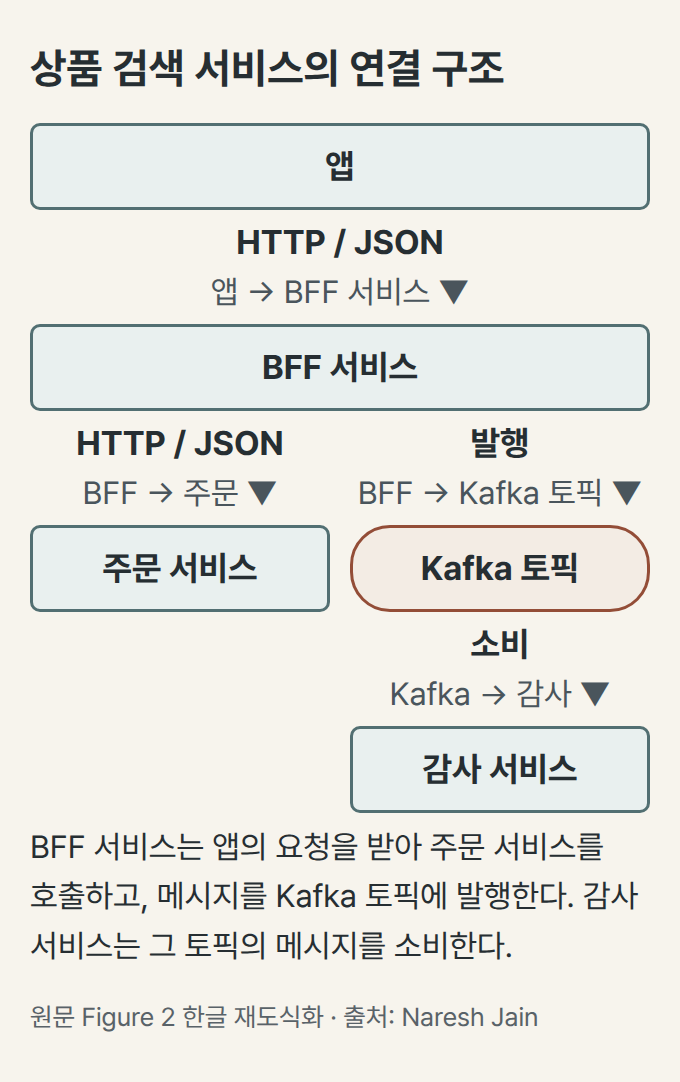

완성된 서비스는 외부 평가의 178개 검사를 전부 통과해야 합격이었다. 개발 중 쓰는 도구와 최종 평가를 분리했고, 도구가 최종 평가의 정답을 읽지는 못하게 했다. 조건마다 독립 작업 공간에서 실행했으며, 두 모델 모두 추론 강도를 low로 맞췄다. 각 모델에서 검증 도구 사용·미사용 조건을 각각 10회씩 비교한 결과다.
요구사항을 읽는 것과 실행해서 검사하는 것은 달랐다
여기서 하네스란 코딩 에이전트 주변에 둔 작업 지침과 검증 도구를 뜻한다. 이 실험에서는 API의 요청·응답 약속을 적은 OpenAPI 문서, 메시지 형식을 적은 AsyncAPI 문서, 실패 상황의 예제를 제공했다. 이어 가짜 의존 서비스를 띄워 시간 초과와 잘못된 응답을 재현하고, 작성한 서비스가 약속대로 반응하는지 검사했다. 구현에는 Specmatic을 썼다.
모델이 자기 코드를 보고 “맞다”고 평가하는 방식은 아니다. 정해진 규격과 예제로 도구가 불일치를 찾고, 에이전트가 그 결과를 읽어 코드를 고쳤다. 예제 자체가 규격에 맞는지도 먼저 검사했다. 실패했다고 기대값을 느슨하게 바꾸지 못하도록 지침을 줬다는 점도 눈여겨볼 만하다. 구현과 테스트를 같은 오해에 맞춰 함께 고치는 일을 막으려는 장치다.
검사는 코드 수정 때마다 자동으로 실행된 것이 아니라 에이전트가 개발 도중 호출했다. 따라서 이 결과는 검사를 몇 번 돌려야 최적인지까지 알려주지는 않는다. 지침과 실행 피드백을 함께 제공한 조건의 효과를 본 실험이다.
싸게 끝났지만, 빨리 끝나지는 않았다
Luna는 하네스 없이 평균 15분 56초, 하네스를 쓰면 35분이 걸렸다. 추정 비용도 0.086달러에서 0.273달러로 늘었다. 토큰 사용량은 약 586만 개에서 2,293만 개로 약 3.9배가 됐다. 같은 모델만 비교하면 검증은 분명 추가 비용이다. 그 대가로 모든 검사를 통과한 실행이 3회에서 10회로 늘었다.
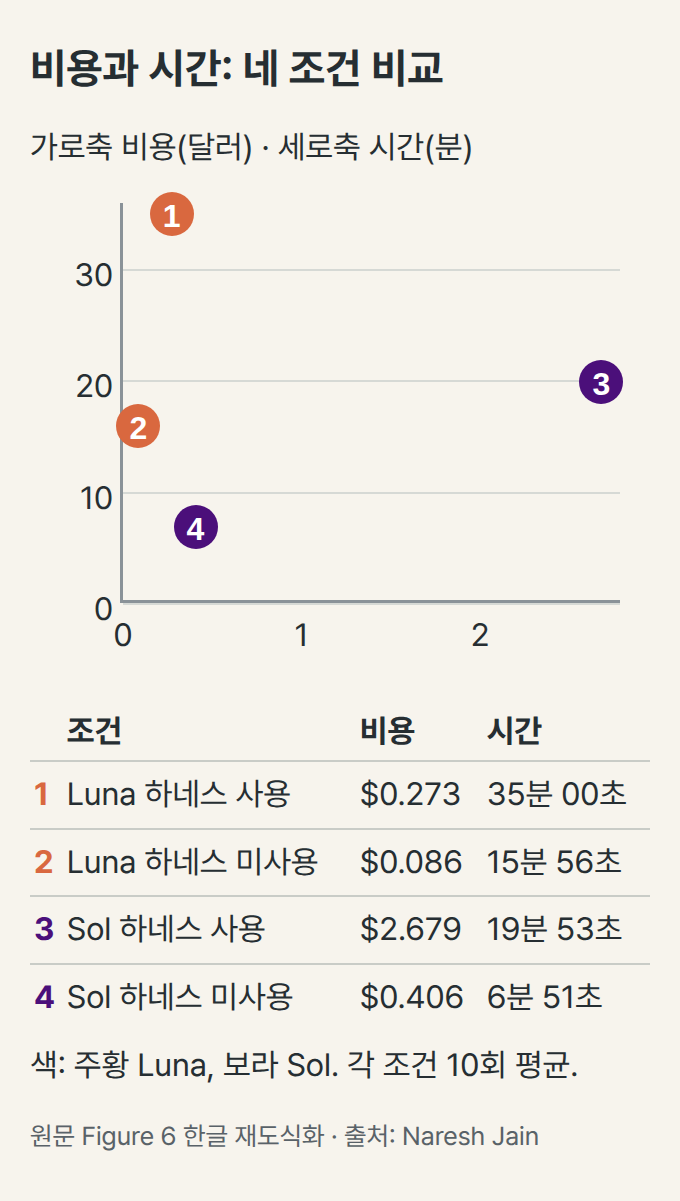

Sol에서는 양상이 달랐다. 검증 도구 없이도 178개 검사를 10회 모두 통과했다. 하네스를 제공하자 평균 시간은 6분 51초에서 19분 53초로, 추정 비용은 0.406달러에서 2.679달러로 늘었지만 합격 횟수는 같았다. 이 과제에서는 더 자주 확인하게 한 비용만 관찰된 셈이다.
두 모델을 교차 비교하면 선택이 달라진다. 하네스를 쓴 Luna가 쓰지 않은 Sol보다 저렴하지만, 기다리는 시간은 35분과 6분 51초다. 사람이 결과를 기다리며 다음 일을 못 하는 작업과 밤새 돌려 두는 작업에 같은 구성을 고집할 이유는 없다. 비용은 기록된 토큰과 모델 가격으로 환산한 API 상당액이며, 규격과 예제를 만들고 유지하는 사람의 시간은 포함하지 않았다.
메시지가 도착해도 서비스는 불합격일 수 있다
도구 없이 실행한 Luna도 기능 검사 평균 94.8%를 통과했다. 대부분을 못 만든 것이 아니라 일부 경계 조건에서 탈락했다. 시간 초과된 상품 생성을 202로 넘겨야 하는데 503이나 400, 429를 반환했고, 그 때문에 진행 상황을 조회할 링크도 빠졌다. 링크가 없어서 뒤따라 실패한 검사까지 별개의 결함으로 세면 문제 수를 부풀리게 된다.
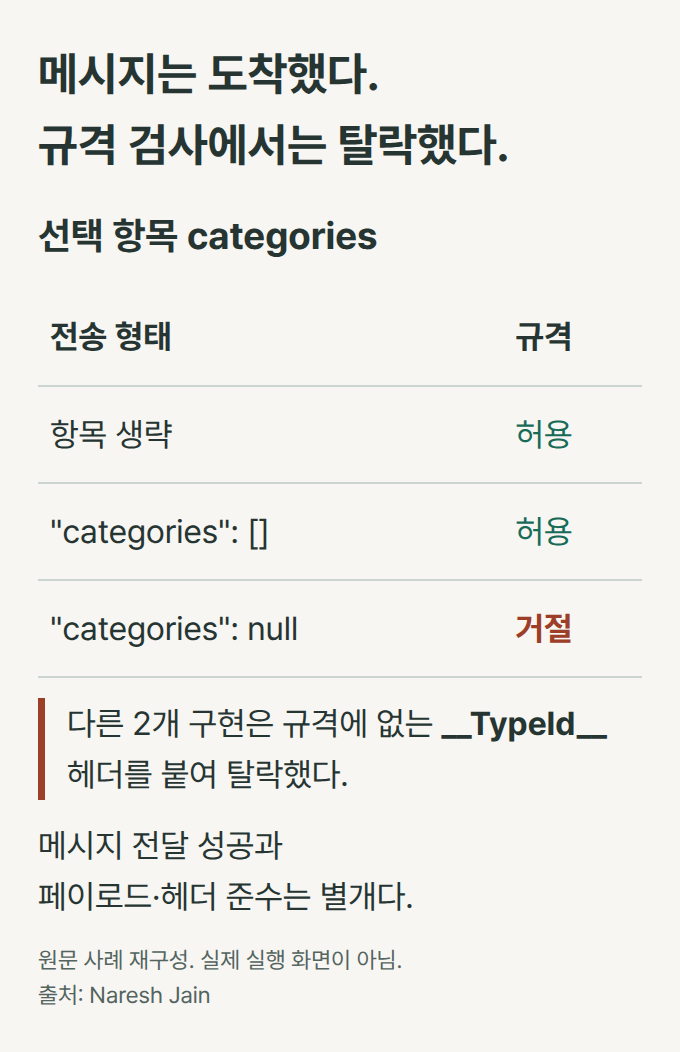
메시지가 Kafka에 도착하고도 탈락한 실행은 3회였다. 두 구현은 직렬화 과정에서 규격에 없는 __TypeId__ 헤더를 붙였다. 다른 구현은 선택 항목인 categories에 null을 넣었다. 이 항목은 생략하거나 배열을 넣을 수 있었지만 null은 허용하지 않았다. “전송됐다”와 “상대 서비스가 약속한 형태로 받았다”를 따로 검사해야 드러나는 차이다.
이런 작업에서는 테스트 개수보다 무엇을 검사하는지가 먼저다. 화면에 상품이 보이는지만 확인하면 시간 초과 뒤의 처리나 메시지 헤더는 빠지기 쉽다. 자인은 하네스가 놓친 요구사항을 다시 보게 만드는 외부 기억 장치처럼 작용했다고 해석했다. 실험이 그 원인까지 입증한 것은 아니지만, 어떤 조건을 놓쳤고 어떤 결과로 탈락했는지는 구체적으로 남겼다.
개발 중 검증과 최종 인수를 나눠 고른다
팀에 적용한다면 같은 작업을 여러 번 맡겨 보고, 실패가 몰리는 조건부터 실행 가능한 검사로 남기는 편이 현실적이다. 저가 모델의 결과가 들쭉날쭉하면 개발 중에 그 피드백을 돌려준다. 처음부터 안정적으로 통과하는 모델이라면 완성 뒤 독립 검사만 수행하는 구성을 비교해 볼 수 있다. 후자는 저자가 제안한 후속 실험이지 이번에 비용을 측정한 조건은 아니다.
요구사항을 매우 자세히 적은 신규 자바 서비스 하나에서 조건당 10회씩 얻은 결과다. 기존 코드 수정이나 요구사항이 흐릿한 업무는 비교하지 않았고, 장기 실패율도 이 표본으로 확정할 수 없다. 팀에서 모델을 고를 때는 호출 단가와 함께 요구사항을 통과하는 빈도, 결과를 기다리는 시간을 같은 작업에서 재면 된다.