
비싼 모델을 골라 요금을 냈는데 중간 서비스가 더 싼 모델로 바꿔 답했다면, 문장만 보고 이를 알아낼 수 있을까. 답이 그럴듯하다는 사실과 계약한 모델이 계산했다는 사실은 다르다. 모델 평가에서도 같은 문제가 생긴다. 출시 전에 시험한 모델과 고객에게 제공하는 모델이 같은지 확인할 근거가 필요하다.
Anthropic은 11월 2일 응답이 특정 모델의 계산과 일치하는지 암호학적으로 확인하는 연구 프로토타입 FlashProve를 공개했다. 모델의 내부 수치인 가중치를 고객에게 주지 않고도 검증할 수 있도록 설계했다. 발표에서 제시한 비용은 일반 추론 대비 GPU 시간 약 70~95배다. 응답에 증거를 붙이는 일은 가능해졌지만, 모든 대화에 적용하기에는 계산 부담이 크다.
모델 이름 대신 미리 고정한 가중치와 대조한다
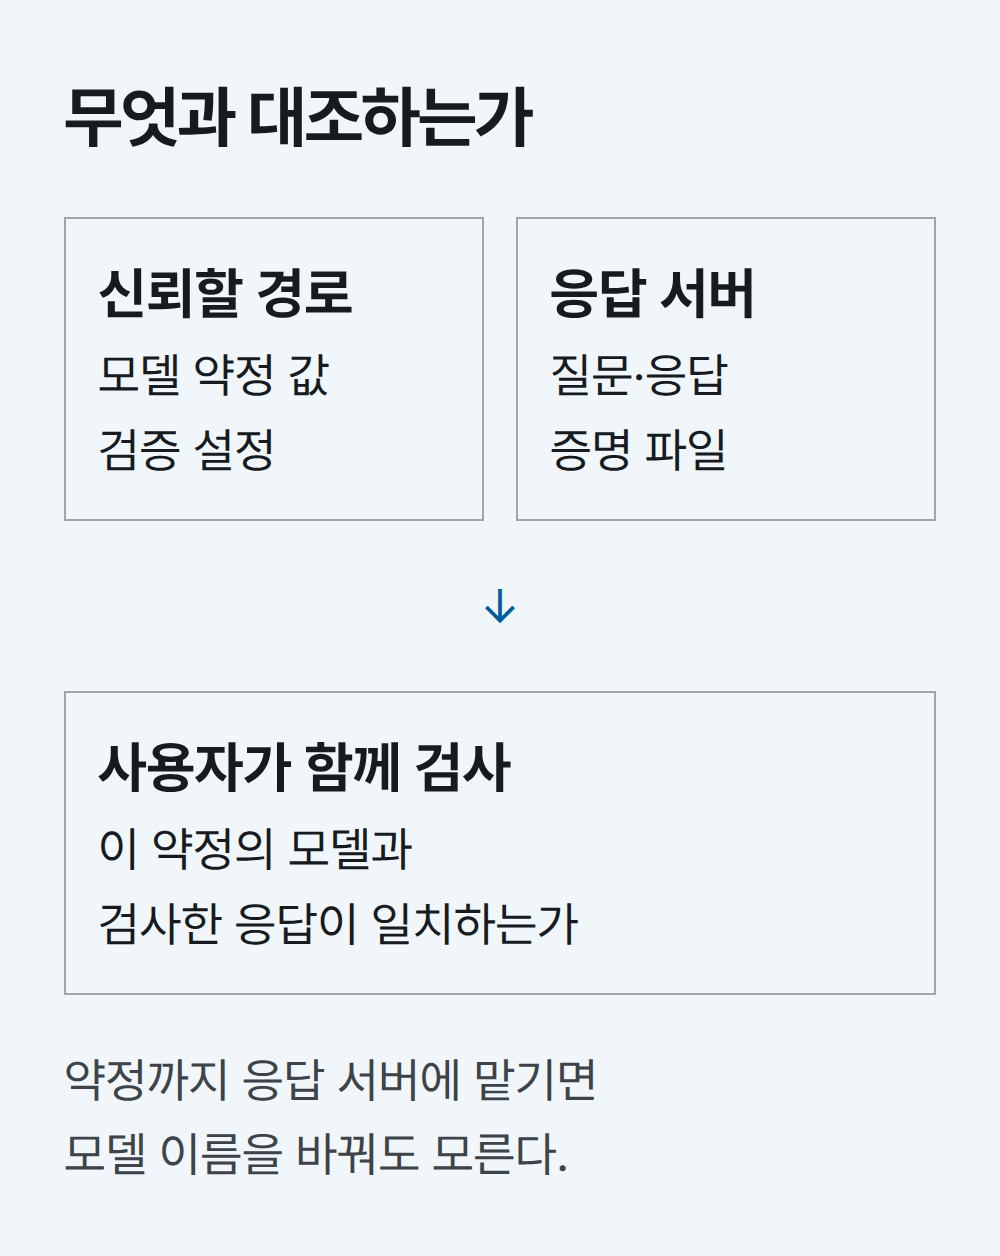
FlashProve에서 제공자는 먼저 가중치에 대한 암호학적 약정(commitment)을 공개한다. 나중에 다른 가중치로 바꿔 설명하지 못하도록 모델을 고정하는 값이다. 사용자는 질문과 응답, 이 약정에 연결된 증명 파일을 함께 검사한다. 가중치를 내려받거나 거대한 모델을 직접 다시 실행하는 대신, 제공자가 만든 증명을 CPU로 확인하는 구조다.
여기에 쓰이는 zkSNARK는 계산이 정해진 조건대로 이뤄졌다는 주장을 짧은 증명으로 확인하는 암호 기술이다. 설계상 가중치는 숨기지만 모델 구조까지 감추지는 않는다. 약정이 어느 회사의 어느 모델을 가리키는지는 별도로 신뢰할 수 있는 경로에서 확인해야 한다. 검사 대상 서버가 모델 이름과 약정 값을 모두 마음대로 정하도록 두면, 작은 모델에 대한 정당한 증명을 받는 것으로 끝날 수 있다.
초당 110토큰은 답변 생성 속도가 아니다
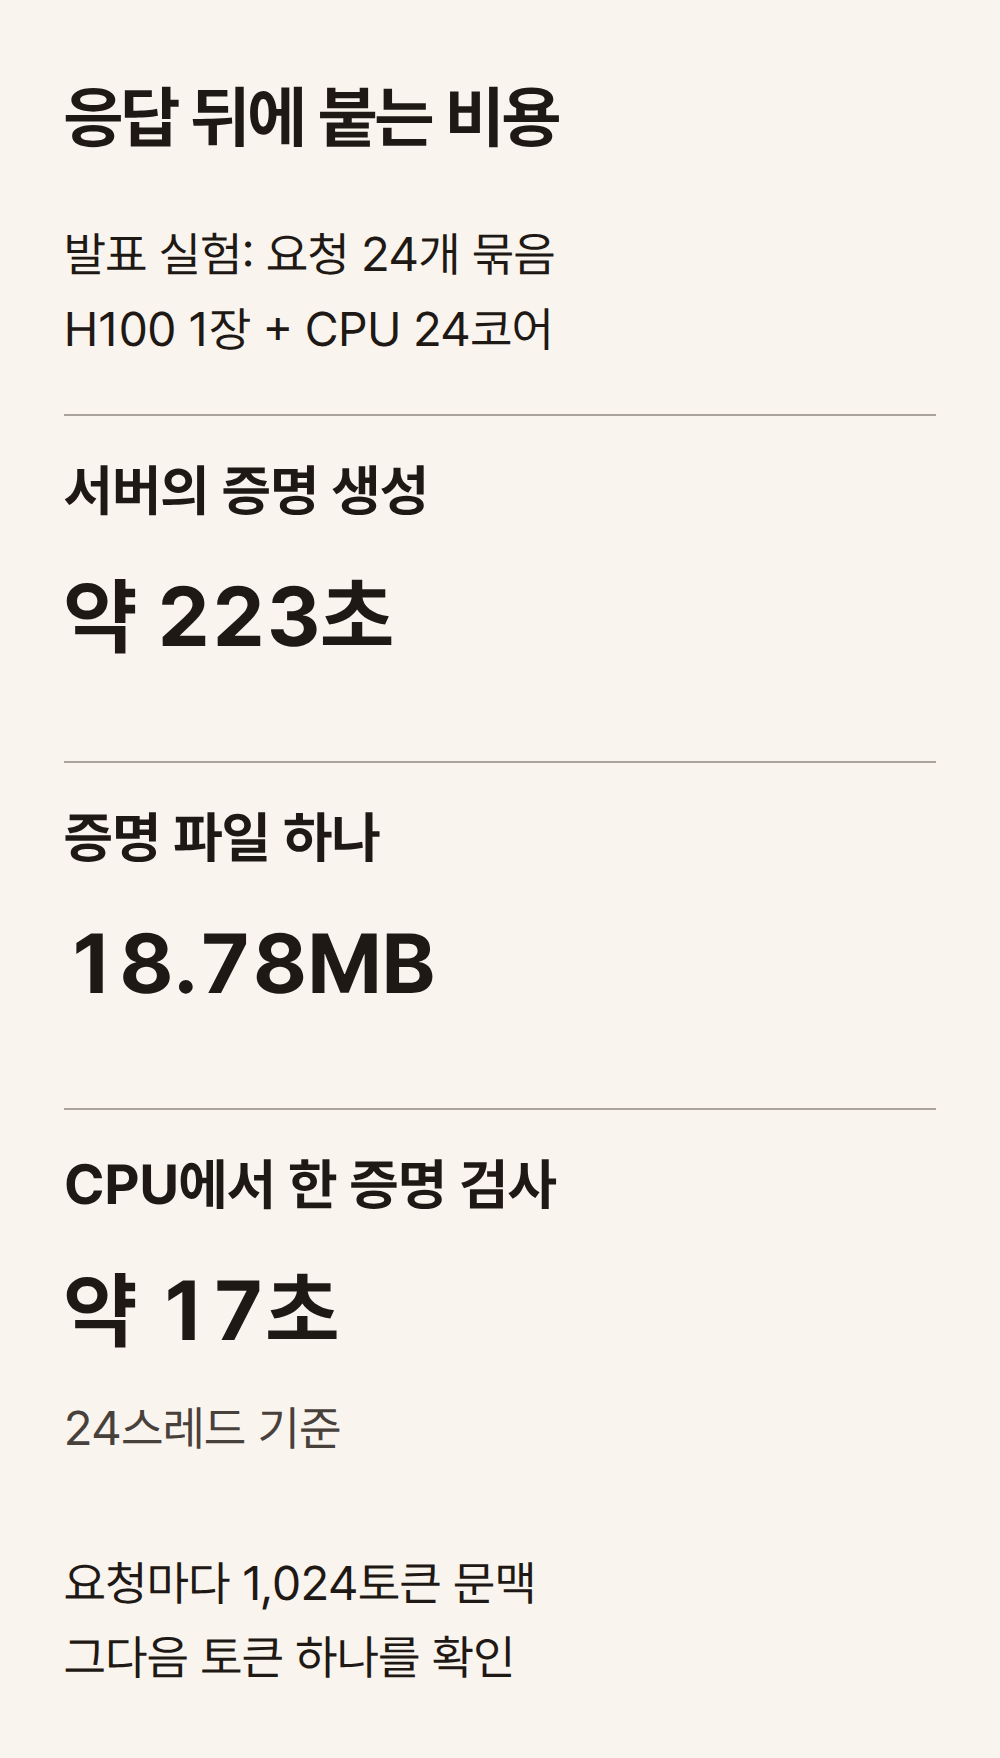
실험 대상은 전체 매개변수 4,000억 개 중 토큰마다 약 170억 개를 사용하는 Llama 4 Maverick이다. FlashProve는 공개된 4비트 가중치를 정수 연산으로 처리했다. H100 GPU 한 장과 CPU 24코어를 사용했고, 큰 가중치는 주기억장치에 두고 GPU로 나눠 가져왔다. GPU 한 장으로 된다는 말이 개인용 컴퓨터에서도 가볍게 돌아간다는 뜻은 아니다. 공개 저장소는 실제 가중치 예제 실행에 사용 가능한 호스트 메모리 330GB를 요구한다.
발표의 초당 약 110토큰은 완성된 텍스트를 병렬로 읽으며 증명을 만드는 처리율이다. 입력을 한꺼번에 처리하는 프리필 방식으로, 요청마다 1,024토큰을 센다. 기본 성능 실험의 증명은 그 문맥 다음 토큰 하나를 확인한다. 대화창에 새 답변이 초당 110토큰씩 나오고 그 전부가 즉시 검증된다는 의미가 아니다.
발표 기준 요청 24개를 묶으면 증명을 만드는 데 약 223초, 증명 파일 하나는 18.78MB가 든다. 사용자의 검사는 GPU 없이 가능하지만 CPU 24스레드에서 약 17초, 한 스레드에서는 약 21초로 제시됐다. 모델을 고정하는 사전 작업도 약 39분 걸린다. 응답을 먼저 제공한 뒤 일부 토큰을 사후 검증하는 방식이므로, 응답을 받는 시점과 증명이 도착하는 시점이 갈린다.
70~95배라는 비교도 계산 조건과 함께 읽어야 한다. 기준 추론 엔진 vLLM은 같은 모델의 FP8 버전을 H100 여덟 장에서 실행했고, FlashProve는 4비트 정수 모델을 썼다. GPU 한 장당 처리량으로 환산한 프리필 비교이며 사전 약정과 시작 비용은 제외했다. 이 수치를 곧바로 API 요금 인상률이나 한 답변의 대기 시간 배수로 바꿀 수는 없다.
검사 통과가 보장하는 범위부터 정해야 한다
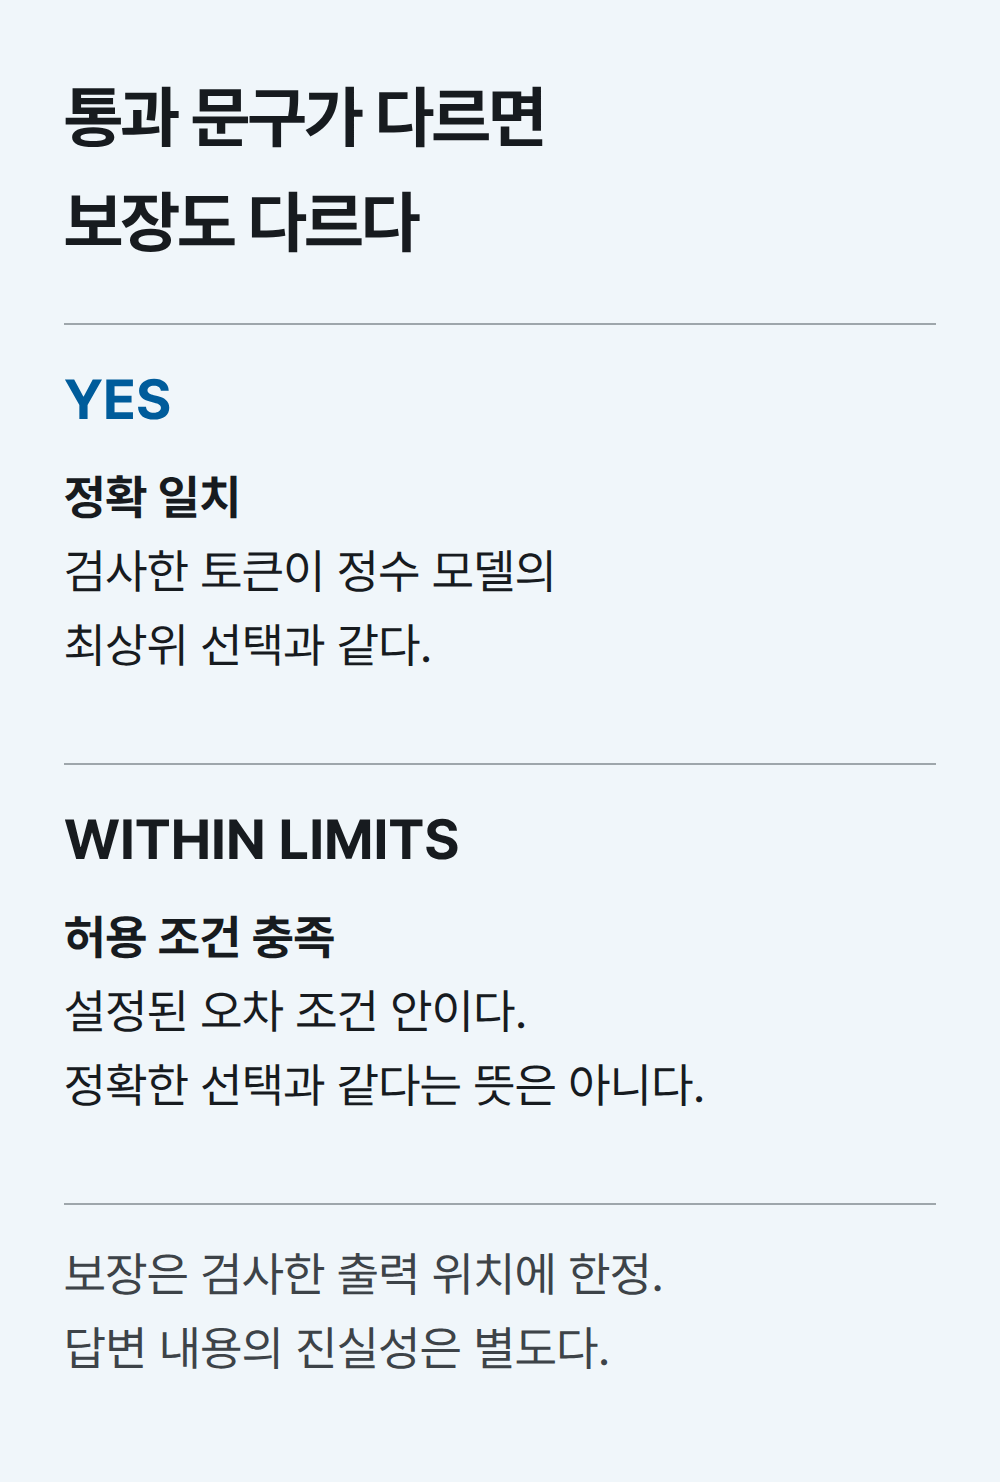
정확 일치 방식에서는 검사한 출력 토큰이 정수 모델의 최상위 선택과 같아야 한다. 일반 서비스의 부동소수점 계산이나 확률적으로 토큰을 고르는 생성 방식은 다른 결과를 낼 수 있다. 현재 저장소에는 차이를 일정 범위 안에서 허용하는 별도 정책도 있다. 이때 나오는 WITHIN LIMITS는 출력이 설정한 허용 조건에 들어간다는 뜻이다. 그 응답이 모델의 정확한 선택이었다는 뜻의 YES와 구분해야 한다.
검증 범위 역시 요청자가 정한 출력 위치에 한정된다. 한 토큰에 대한 증명으로 응답 전체를 확인했다고 말할 수 없다. 약정 값뿐 아니라 검증 설정과 검사할 위치를 사용자가 확보하고, 실제로 어느 범위가 검사됐는지 확인해야 한다. 현재 문맥 길이 1,024토큰도 긴 업무 대화나 문서 분석에 그대로 쓰기에는 짧다.
암호 프로토콜의 수학적 성질과 배포한 프로그램의 정확성도 나뉜다. 연구진은 Lean이라는 형식검증 도구로 보안 성질을 증명하고 실행 가능한 Lean 검증기를 제공했다. 일상 실행용 C++ 검증기와 GPU 증명 생성 코드 자체에는 같은 형식적 보장이 없다. 공개 저장소도 이를 연구 산출물로 표시하고 유지보수와 기여 접수를 하지 않는다고 명시한다.
구매 증빙과 모델 평가에 먼저 쓸 수 있다
이 연구가 다루는 것은 답의 출처와 계산의 일치 여부다. 계약한 모델이 답했어도 사실을 틀릴 수 있고, 보안 취약점을 놓칠 수 있다. 특정 코드에 대해 정해진 모델로 검사를 돌렸다는 증명은 검사의 수행 근거가 될 수 있지만, 코드가 안전하다는 인증까지 대신하지 않는다.
활용을 검토할 만한 곳은 모든 채팅 응답보다 모델 정체가 중요한 평가와 감사 업무다. 제3자 중계 서비스를 통해 고가 모델을 구매한 기업이라면, 신뢰할 모델 약정과 검증 설정을 계약에 연결하고 어떤 응답의 어느 부분에 증거를 요구할지 정할 수 있다. 증명을 생성할 계산 비용, 파일 전달량, 사후 검증까지 기다릴 시간을 함께 따져야 한다. FlashProve는 그 선택에 필요한 측정값과 코드를 공개한 단계다. Claude API의 모든 응답에 이 증명이 기본으로 붙는 서비스 발표는 아니다.
출처: Anthropic, 대규모 언어모델의 증명 가능한 추론 연구 · FlashProve 공개 코드와 문서