GPU 없이 2,840억 모델을 돌린다: 64GB 메모리에 맞춘 DeepSeek 재양자화
llama-modchip는 2,840억 파라미터 DeepSeek-V4-Flash를 GPU 없이 64GB 메모리에서 초당 약 10토큰으로 돌린다고 밝힙니다. 파일을 56.56GiB로 줄인 방식과 직접 돌려 보는 순서를 정리합니다.
 유토모 테크로그새 기술과 제품 이야기
주제
로컬 AI 관련 글을 모았습니다. 유토모 테크로그에서 새 기술과 제품이 일과 제품에 만드는 변화를 살펴봅니다.
llama-modchip는 2,840억 파라미터 DeepSeek-V4-Flash를 GPU 없이 64GB 메모리에서 초당 약 10토큰으로 돌린다고 밝힙니다. 파일을 56.56GiB로 줄인 방식과 직접 돌려 보는 순서를 정리합니다.
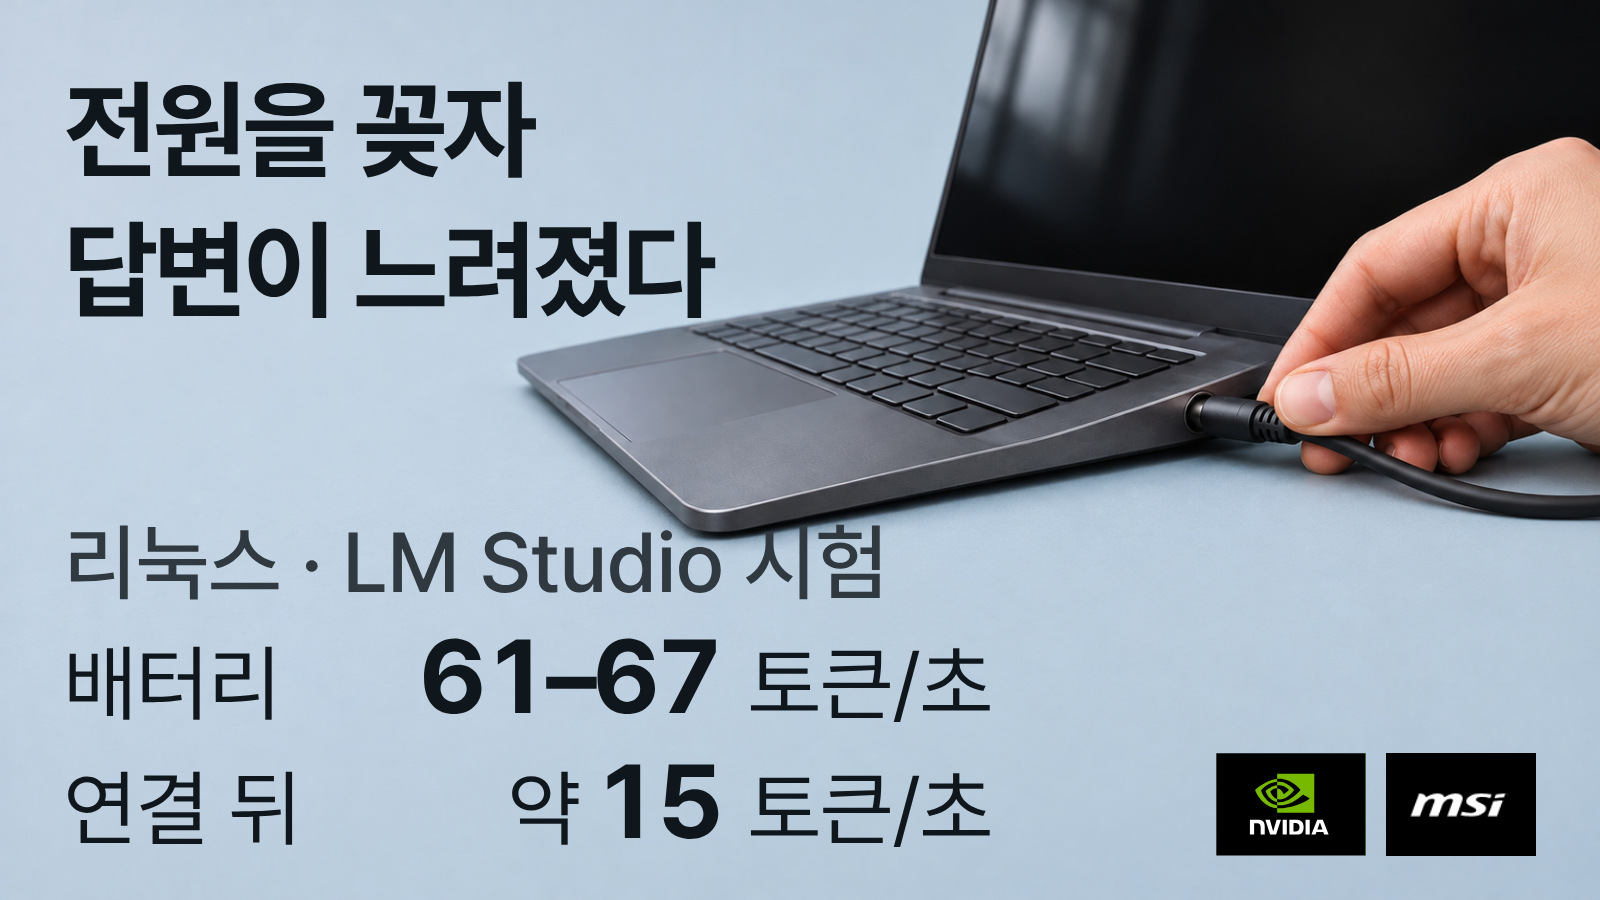
전원을 연결하자 리눅스 노트북의 모델 생성 속도가 떨어진 사용기가 공개됐습니다. GPU 인식과 전력 관리 지원의 차이, WSL을 통한 우회 경로를 살펴봅니다.
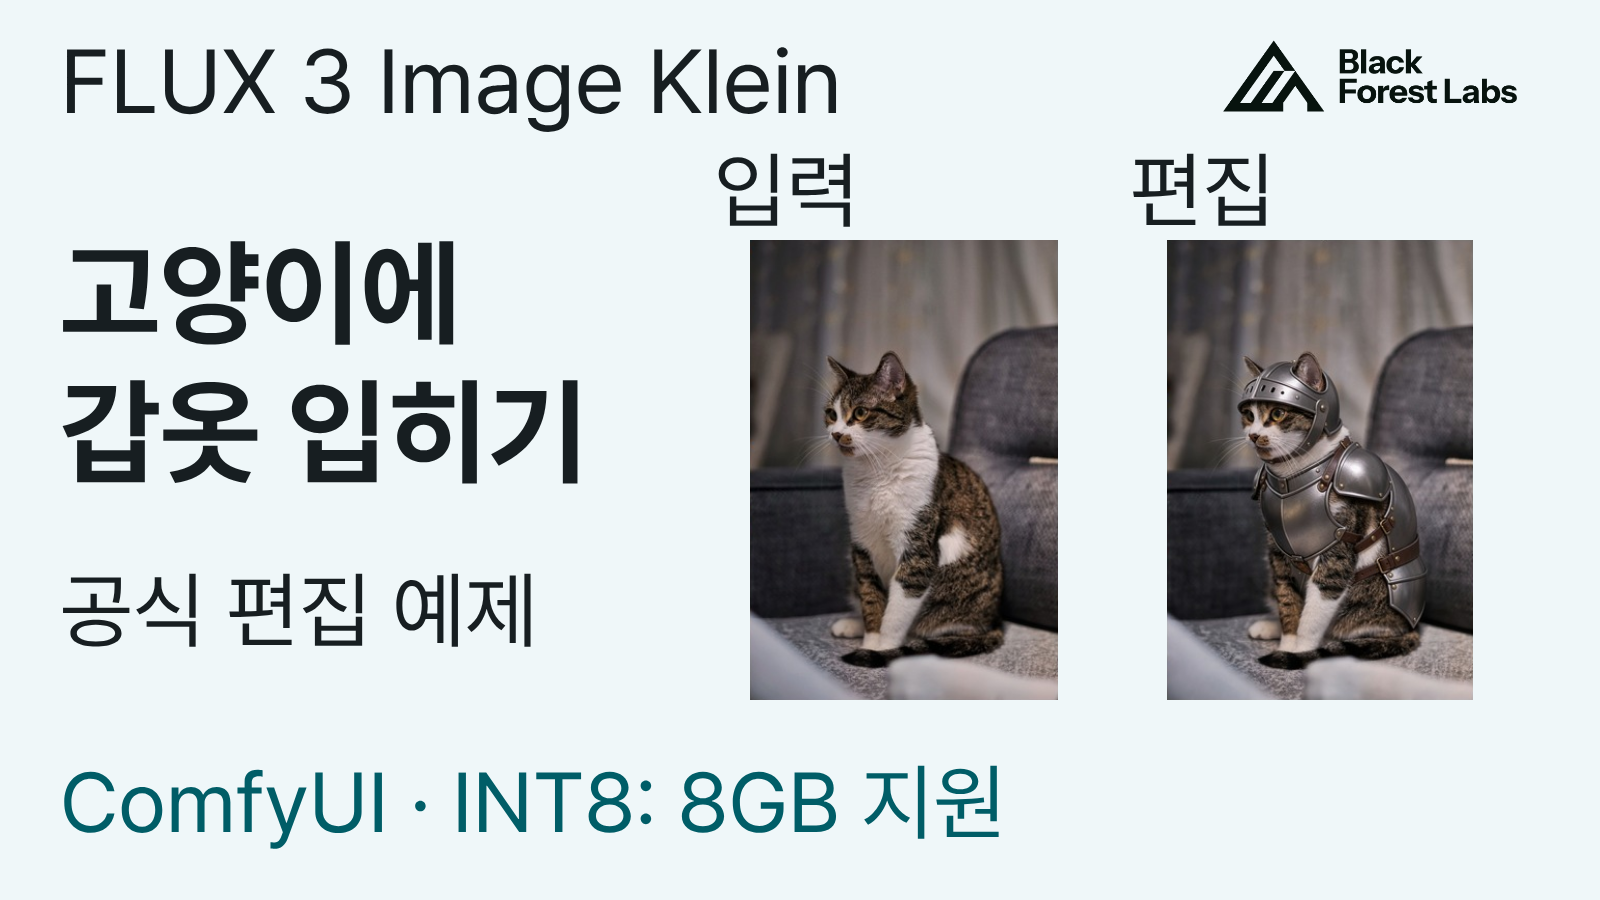
8GB GPU에서 쓰는 ComfyUI INT8 경로와 일반 추론 코드의 메모리 조건은 다릅니다. FLUX 3 Image Klein의 편집 예제와 계열사 합산 매출 500만 달러 미만의 상업 이용 조건을 살펴봅니다.
PrismML이 5.9GB 언어 모델 Bonsai 2 27B를 공개했습니다. 파일 크기와 실행 메모리, 기기별 처리 속도를 나누어 로컬 AI 도입 조건을 살펴봅니다.
Magnitude는 PC 하드웨어에 맞는 로컬 모델 조합을 추천하고, 기존 코딩 에이전트와의 연결을 관리합니다. 모델을 바꿀 때 반복되는 추론 환경 설정과 연결 작업을 줄이는 흐름을 살펴봅니다.
애플의 M6와 M5 Ultra는 단순 성능 비교 대상이 아닙니다. 새 PC 교체 때 메모리 용량·대역폭·작업 규모로 Mac mini와 Mac Studio의 선택 기준을 정리했습니다.
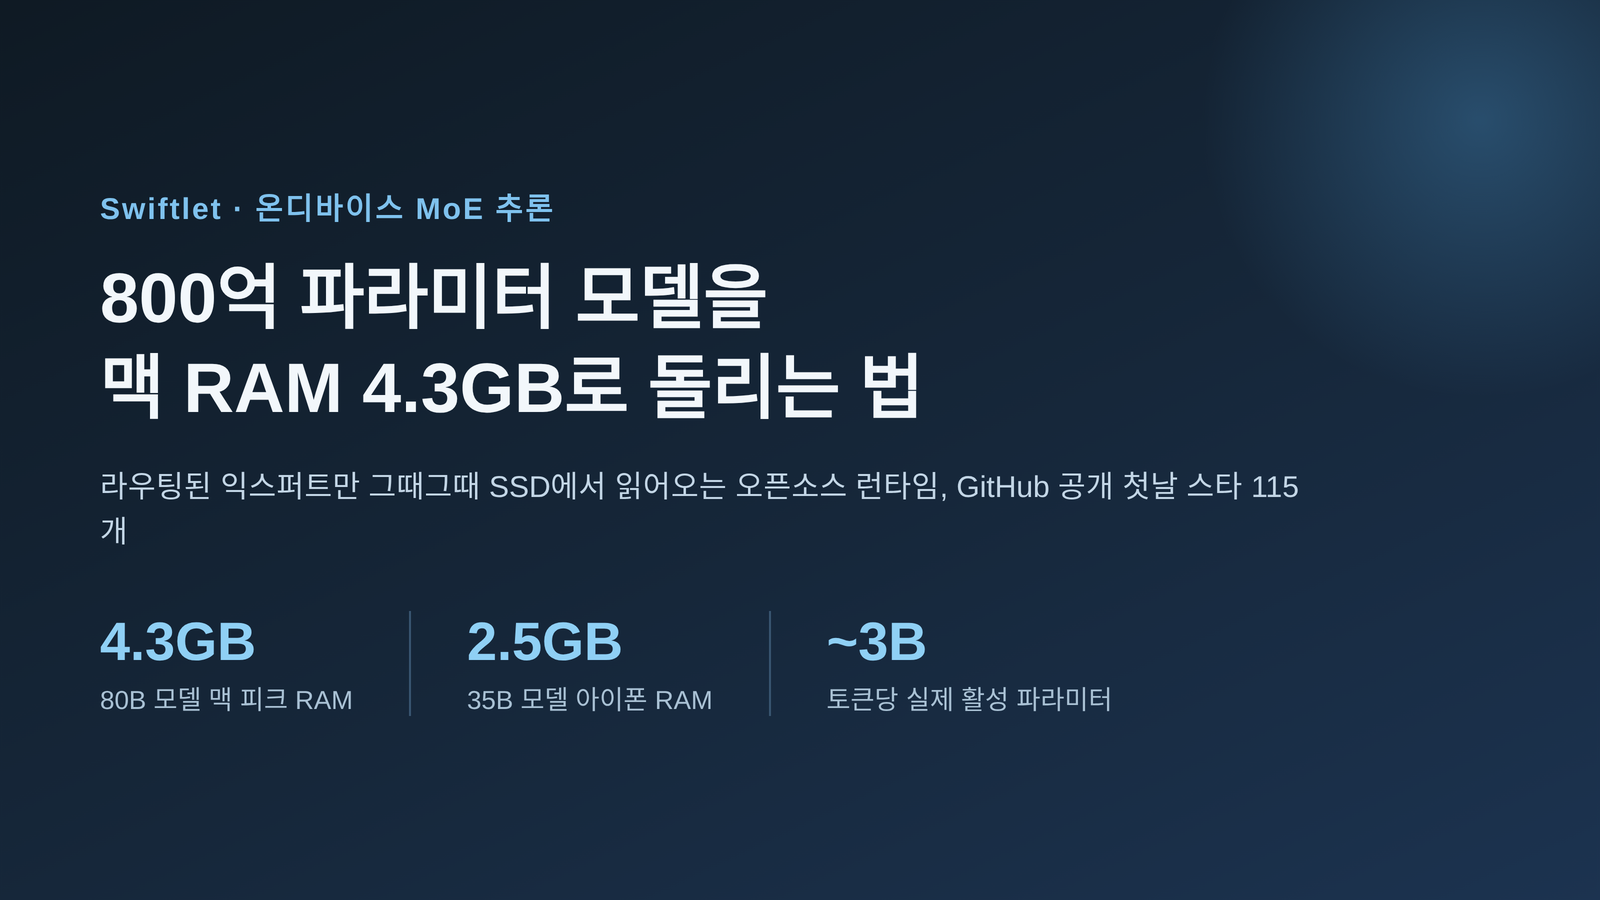
개인 개발자가 만든 오픈소스 런타임 Swiftlet이 800억 파라미터 Qwen을 맥에서 RAM 4.3GB로, 350억 파라미터 모델을 아이폰에서 2.5GB로 돌립니다. 익스퍼트를 SSD에서 그때그때 읽어오는 방식입니다.
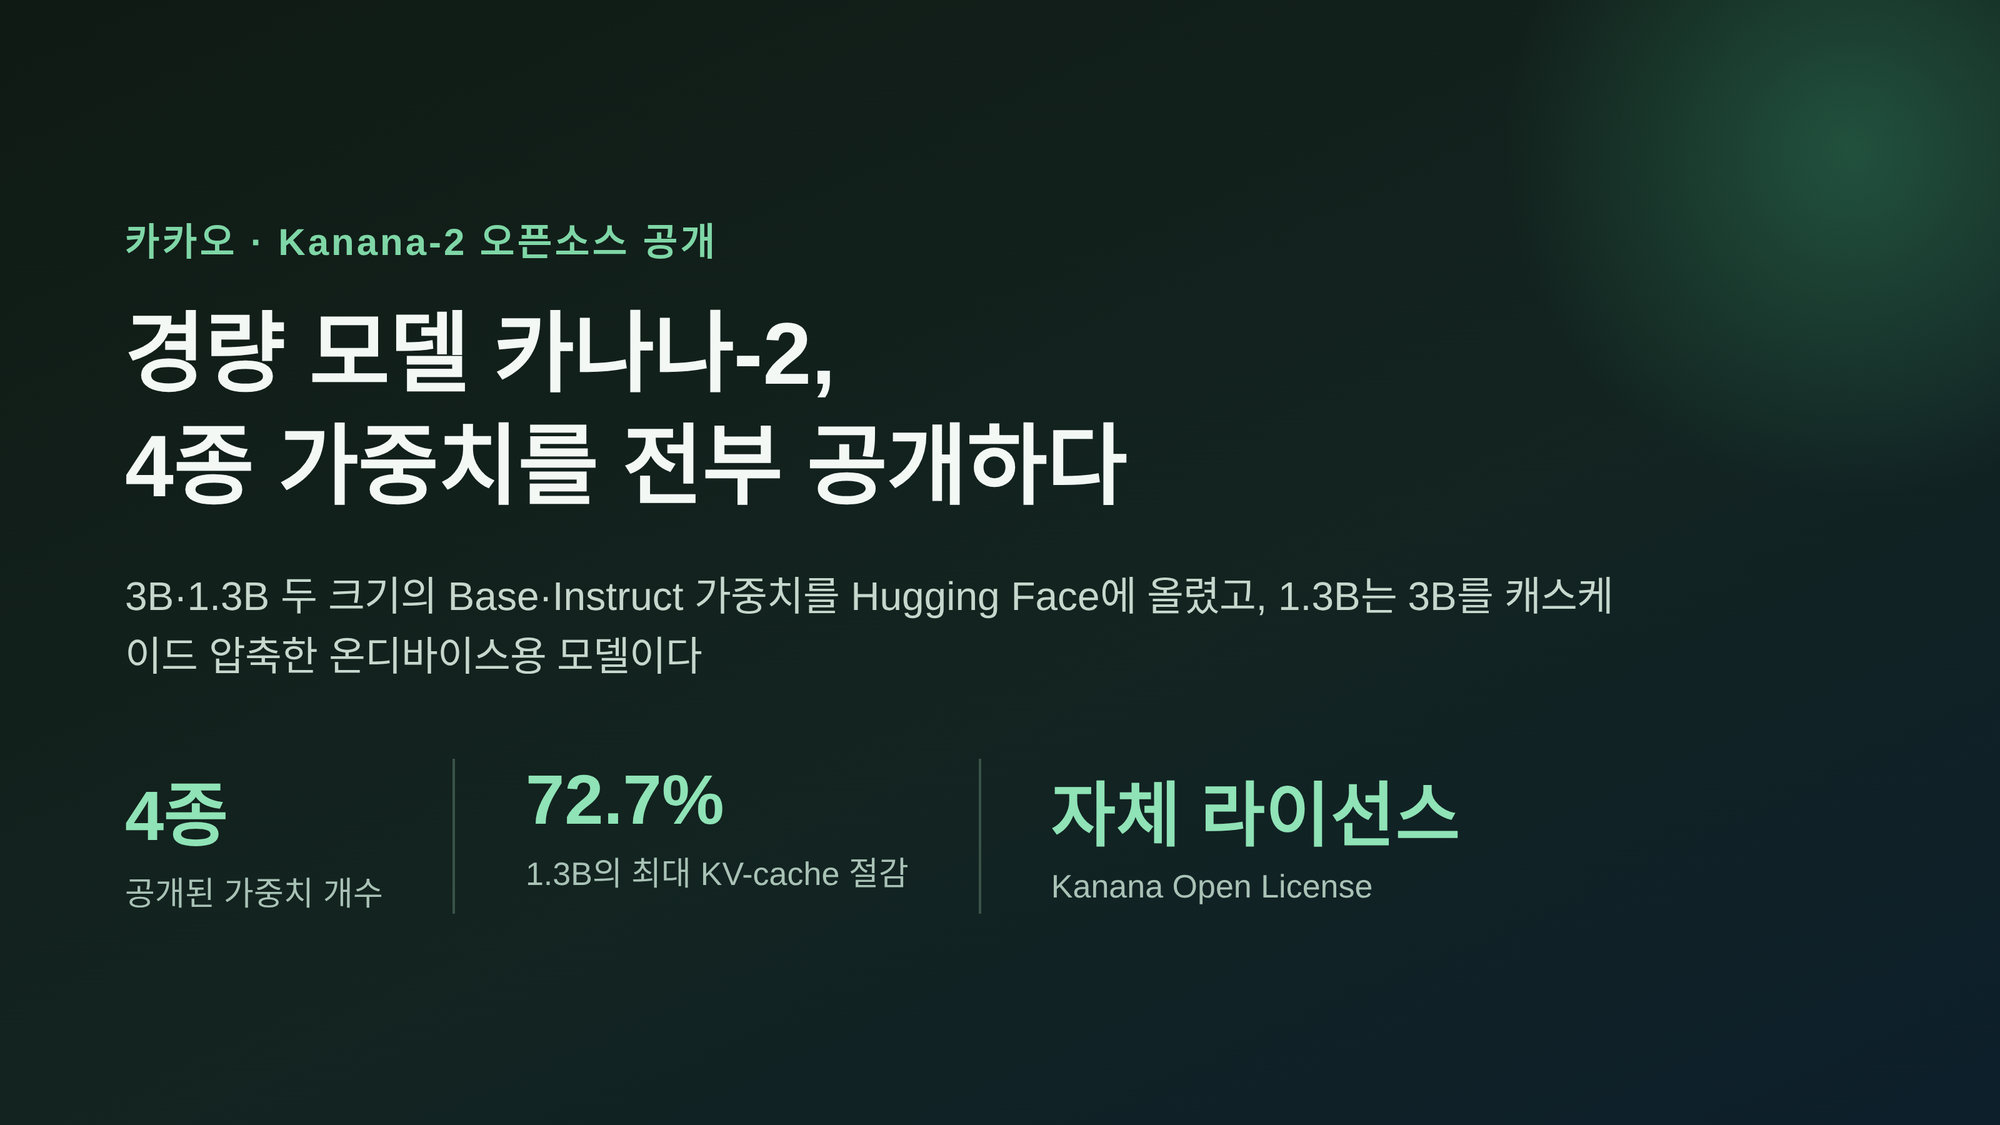
카카오가 Kanana-2 SLM 3B·1.3B 모델의 Base/Instruct 가중치 4종을 Hugging Face에 공개했습니다. 1.3B는 3B를 캐스케이드 압축한 온디바이스용 모델입니다.
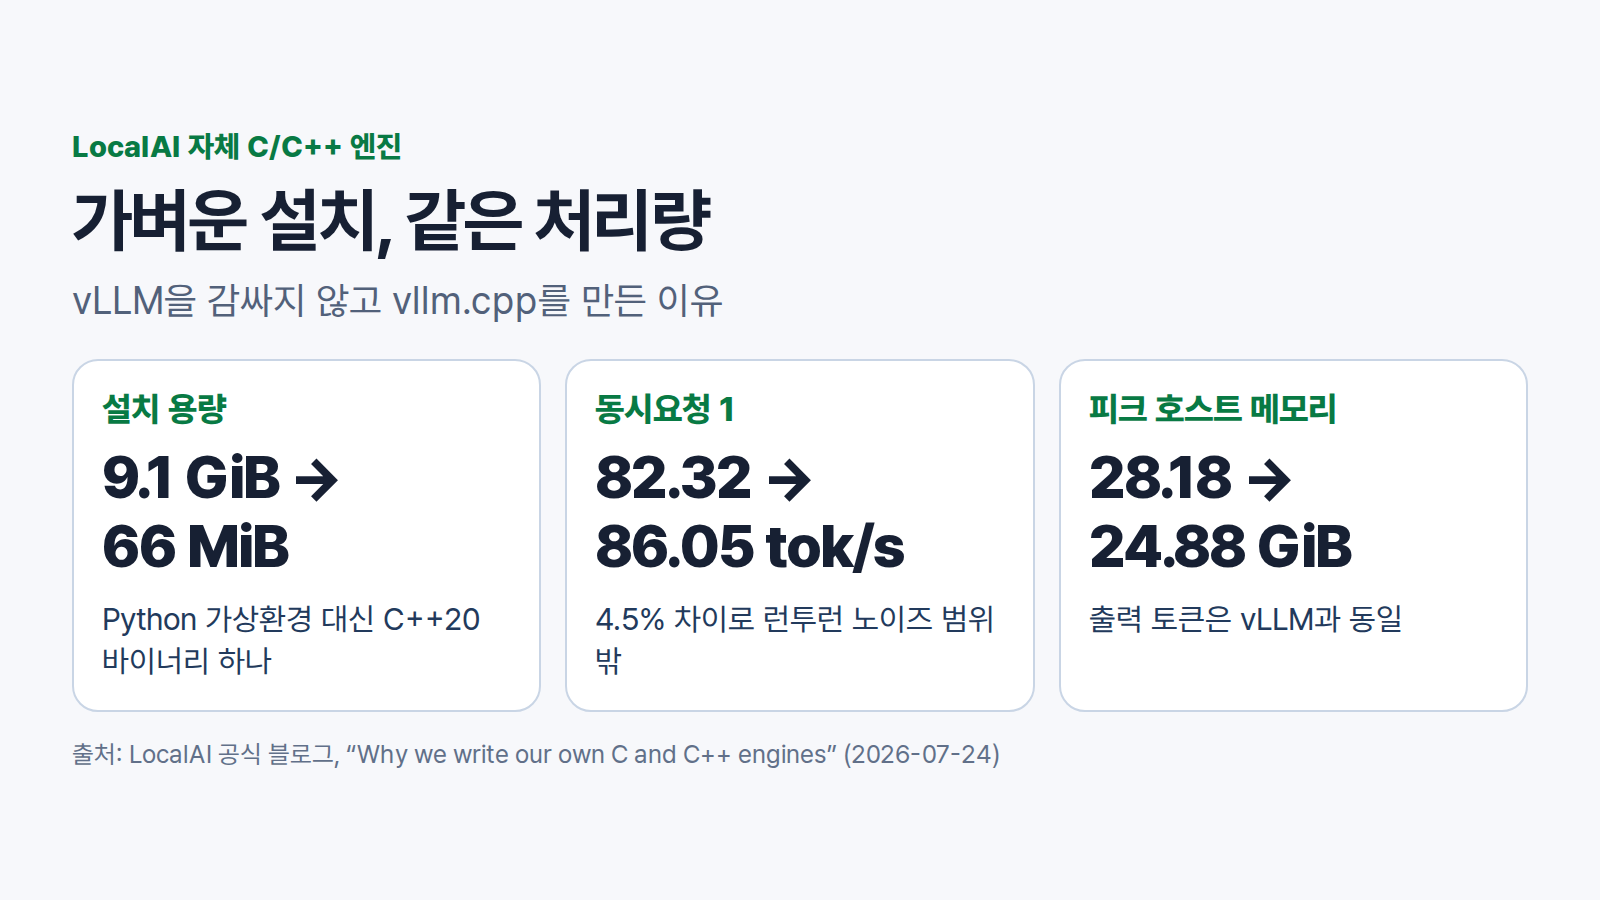
LocalAI가 왜 18개 백엔드를 llama.cpp나 vLLM을 감싸는 대신 C·C++로 직접 새로 짰는지, 설치 용량·메모리·속도 실측치와 함께 공개했습니다.
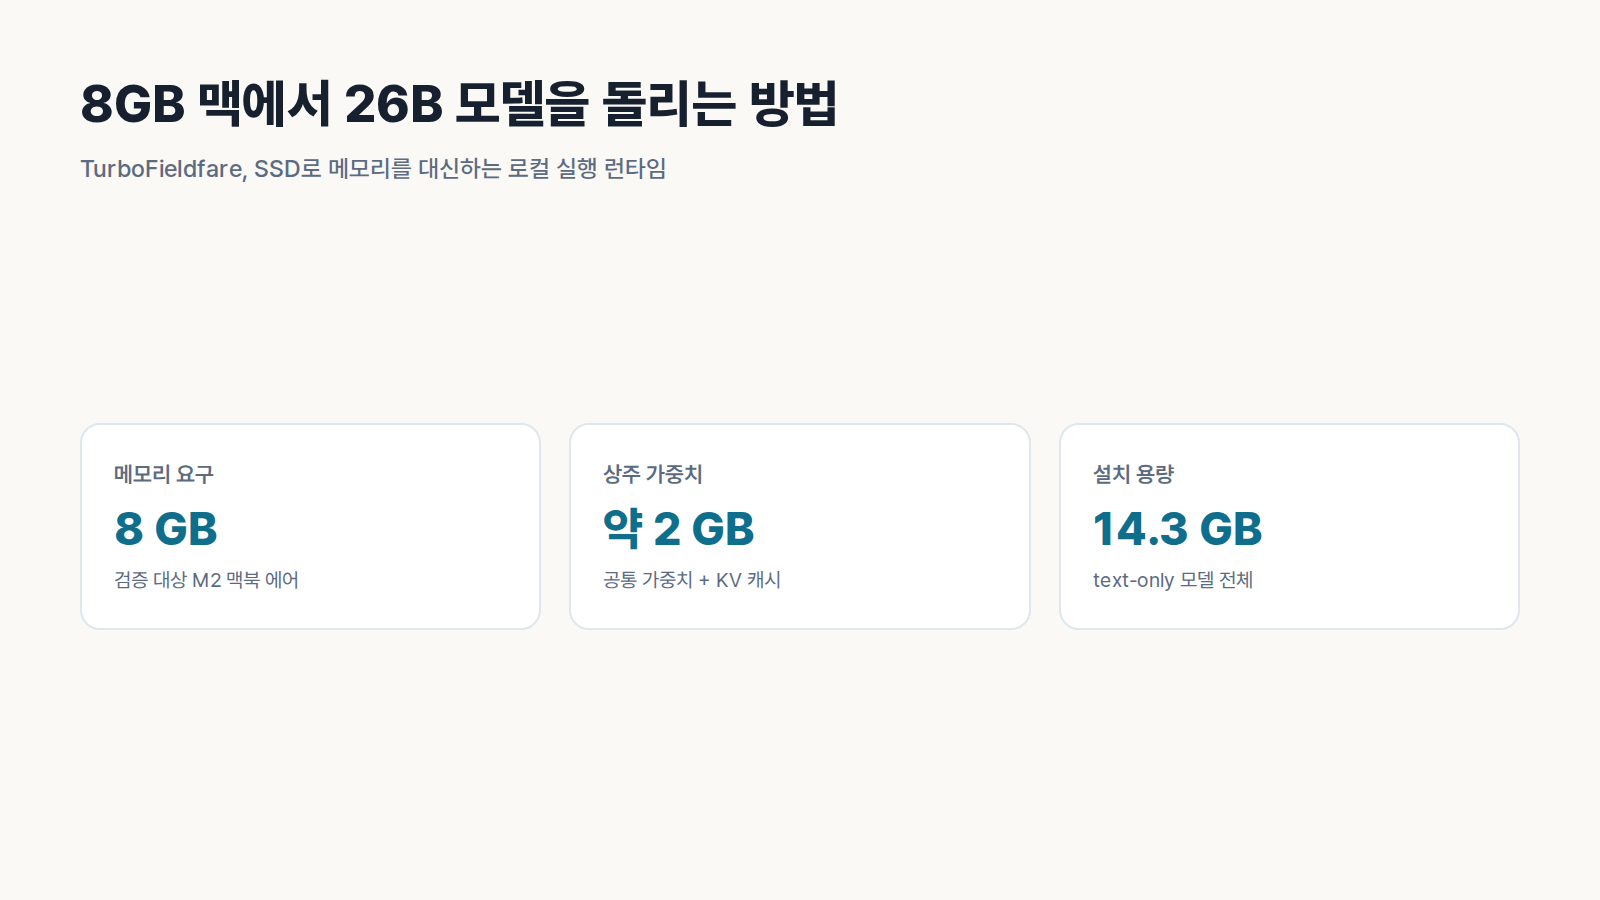
TurboFieldfare는 SSD에서 필요한 가중치를 읽어 8GB Apple Silicon 맥에서 26B Gemma 4 모델을 실행하려는 오픈소스 런타임입니다.