
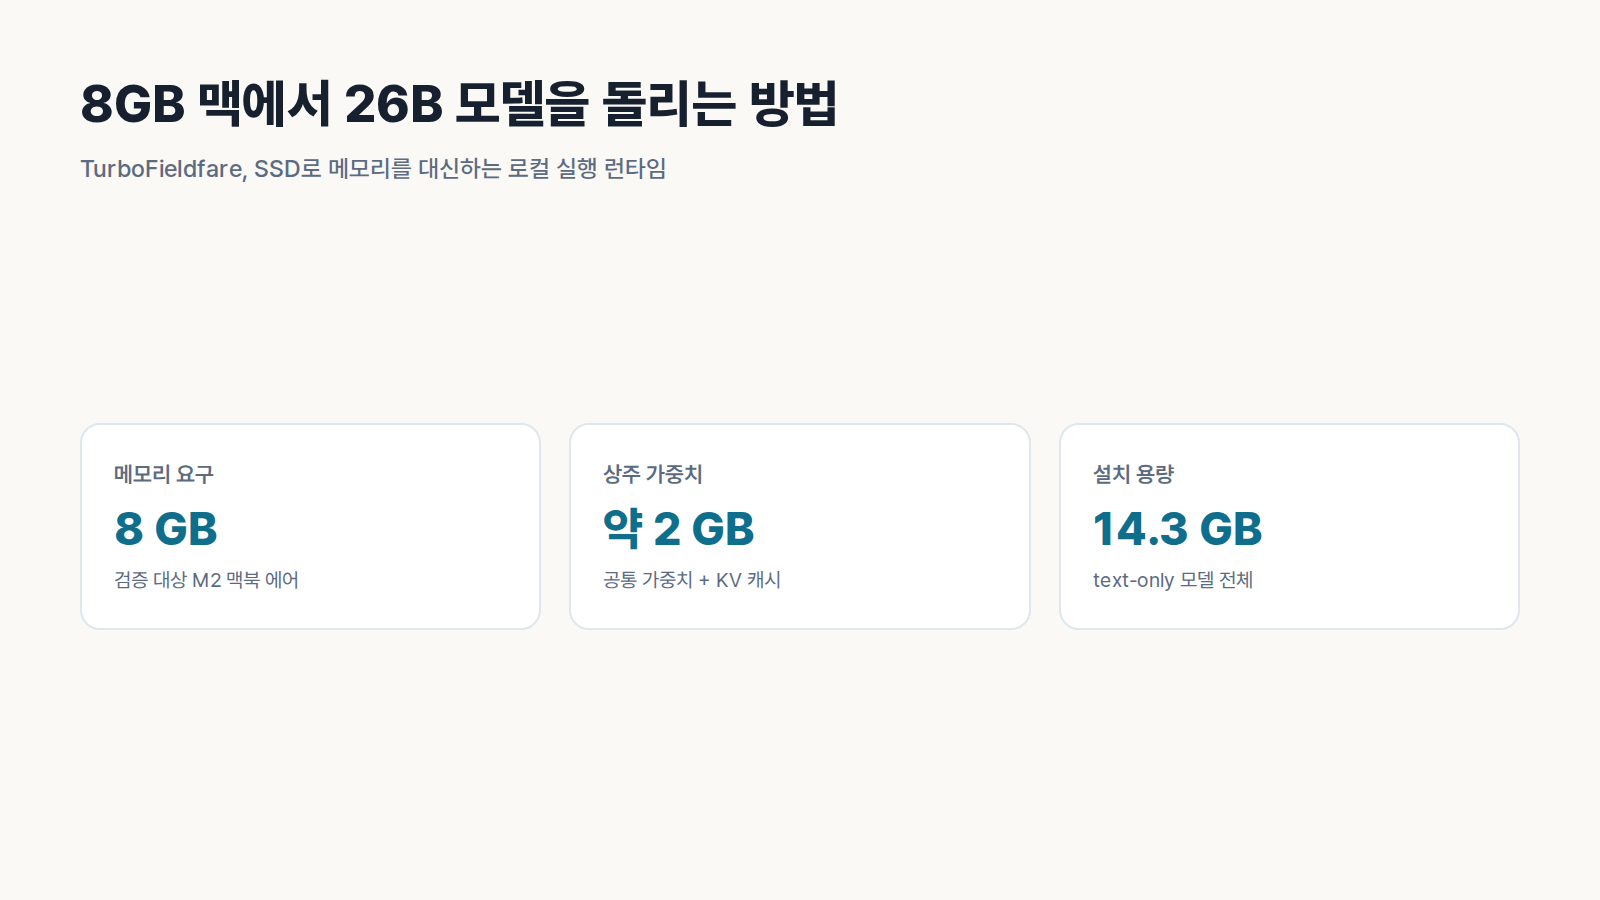
맥북에서 큰 언어 모델을 돌릴 때 가장 먼저 부딪히는 건 모델의 파라미터 수보다 메모리다. TurboFieldfare는 26B 규모의 Gemma 4 모델을 8GB 메모리의 Apple Silicon 맥에서도 돌리겠다고 만든 오픈소스 런타임이다. 프로젝트가 내세우는 숫자는 약 2GB다.
이 숫자는 모델 전체를 2GB에 넣는다는 뜻이 아니다. 프로젝트 문서에 따르면 공통으로 쓰는 가중치와 KV 캐시는 메모리에 남기고, 토큰마다 필요한 전문가 가중치만 SSD에서 읽어 온다. 필요한 부분만 잠깐 가져오는 방식이라 14.3GB짜리 모델 파일을 전부 메모리에 올리지 않아도 된다.
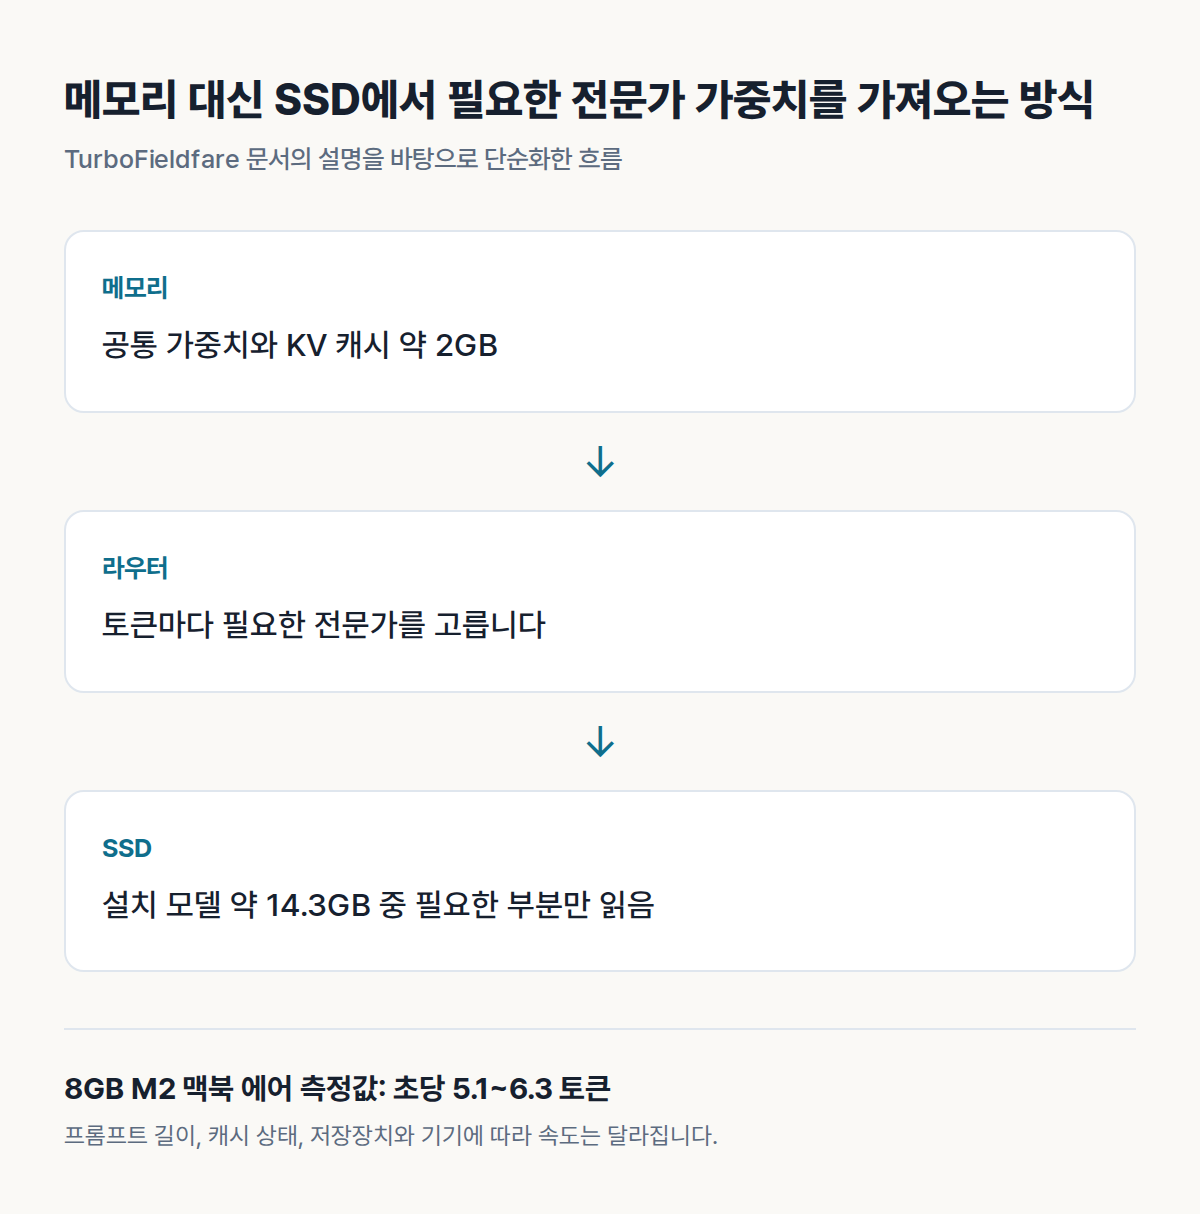
이 접근은 MoE, 즉 여러 전문가 중 일부만 골라 쓰는 모델 구조와 맞물린다. 매 토큰마다 모델이 고른 전문가를 미리 읽어 오고, 자주 쓰는 부분은 제한된 캐시에 남긴다. SSD를 메모리처럼 쓰는 셈이라 빠른 메모리를 넉넉히 쓰는 방식보다는 느릴 수 있지만, 아예 실행하지 못하던 기기에서 선택지가 생긴다.
다만 “8GB 맥에서 26B 모델”이라는 문장만 보고 설치를 시작하면 곤란하다. 프로젝트가 말하는 약 2GB는 실행 중 상주하는 일부 구성의 수치다. 설치된 text-only 모델은 약 14.3GB를 차지하고, 첫 설치 때는 약 15GB를 내려받는다. macOS 26, Metal 4, Swift 6.2도 요구한다.
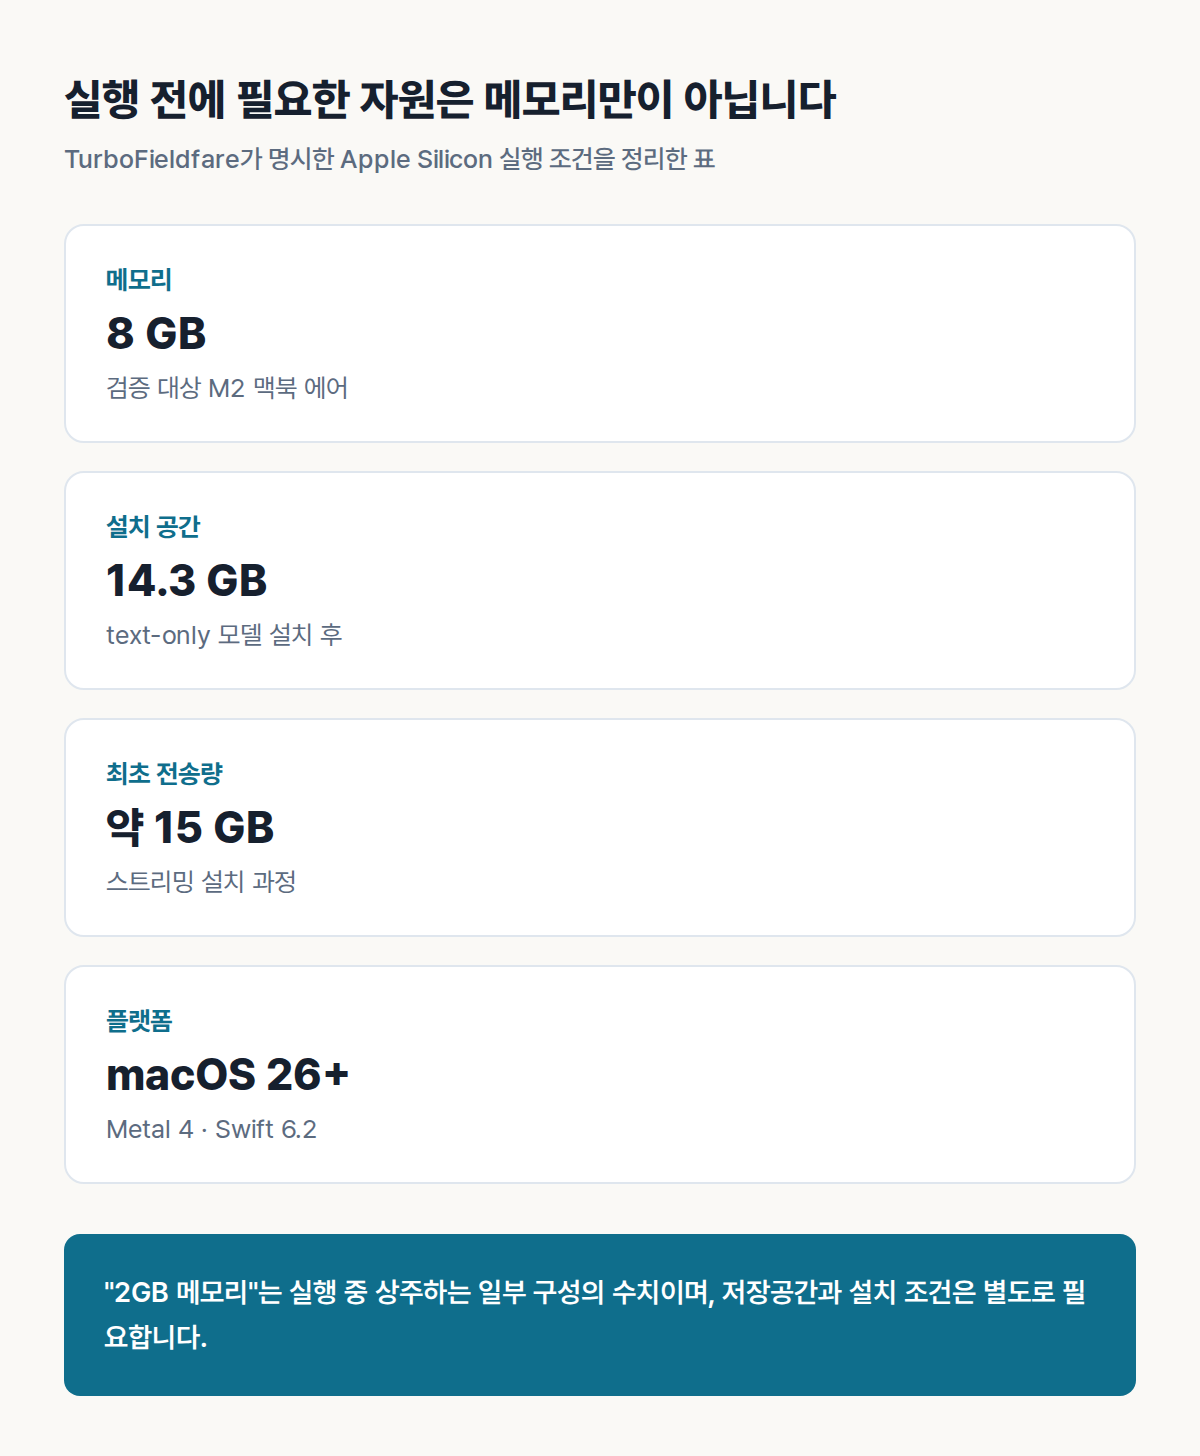
설치 과정도 일반적인 모델 내려받기와 조금 다르다. 프로젝트는 전체 체크포인트를 한 번에 디스크에 풀어놓지 않고, 필요한 바이트 범위를 받아 자체 형식으로 다시 묶는 방식을 쓴다. 설치 중에 큰 임시 파일을 하나 더 만들지 않으려는 선택이다. 저장공간이 넉넉하지 않은 노트북에서는 이런 설치 방식 자체가 사용성에 영향을 준다.
속도는 기대를 조절해야 하는 부분이다. 프로젝트가 공개한 8GB M2 맥북 에어 측정값은 초당 5.1~6.3토큰이다. 단순히 나누면 100토큰을 생성하는 데 약 16~20초가 걸리는 수준이고, 여기에 긴 프롬프트를 읽는 시간은 따로 더해진다. 짧은 질문이나 문서 초안에는 쓸 수 있지만, 누르는 즉시 답이 나와야 하는 서비스와는 거리가 있다.
또 같은 맥이라도 결과가 고정되지 않는다. 프롬프트가 길어지면 앞부분을 읽는 prefill 부담이 커지고, SSD 캐시 상태와 저장장치 속도도 영향을 준다. 프로젝트 문서가 한 번에 하나의 모델 소유 프로세스만 돌리고, 다른 메모리 무거운 앱을 닫으라고 권하는 이유가 여기에 있다.
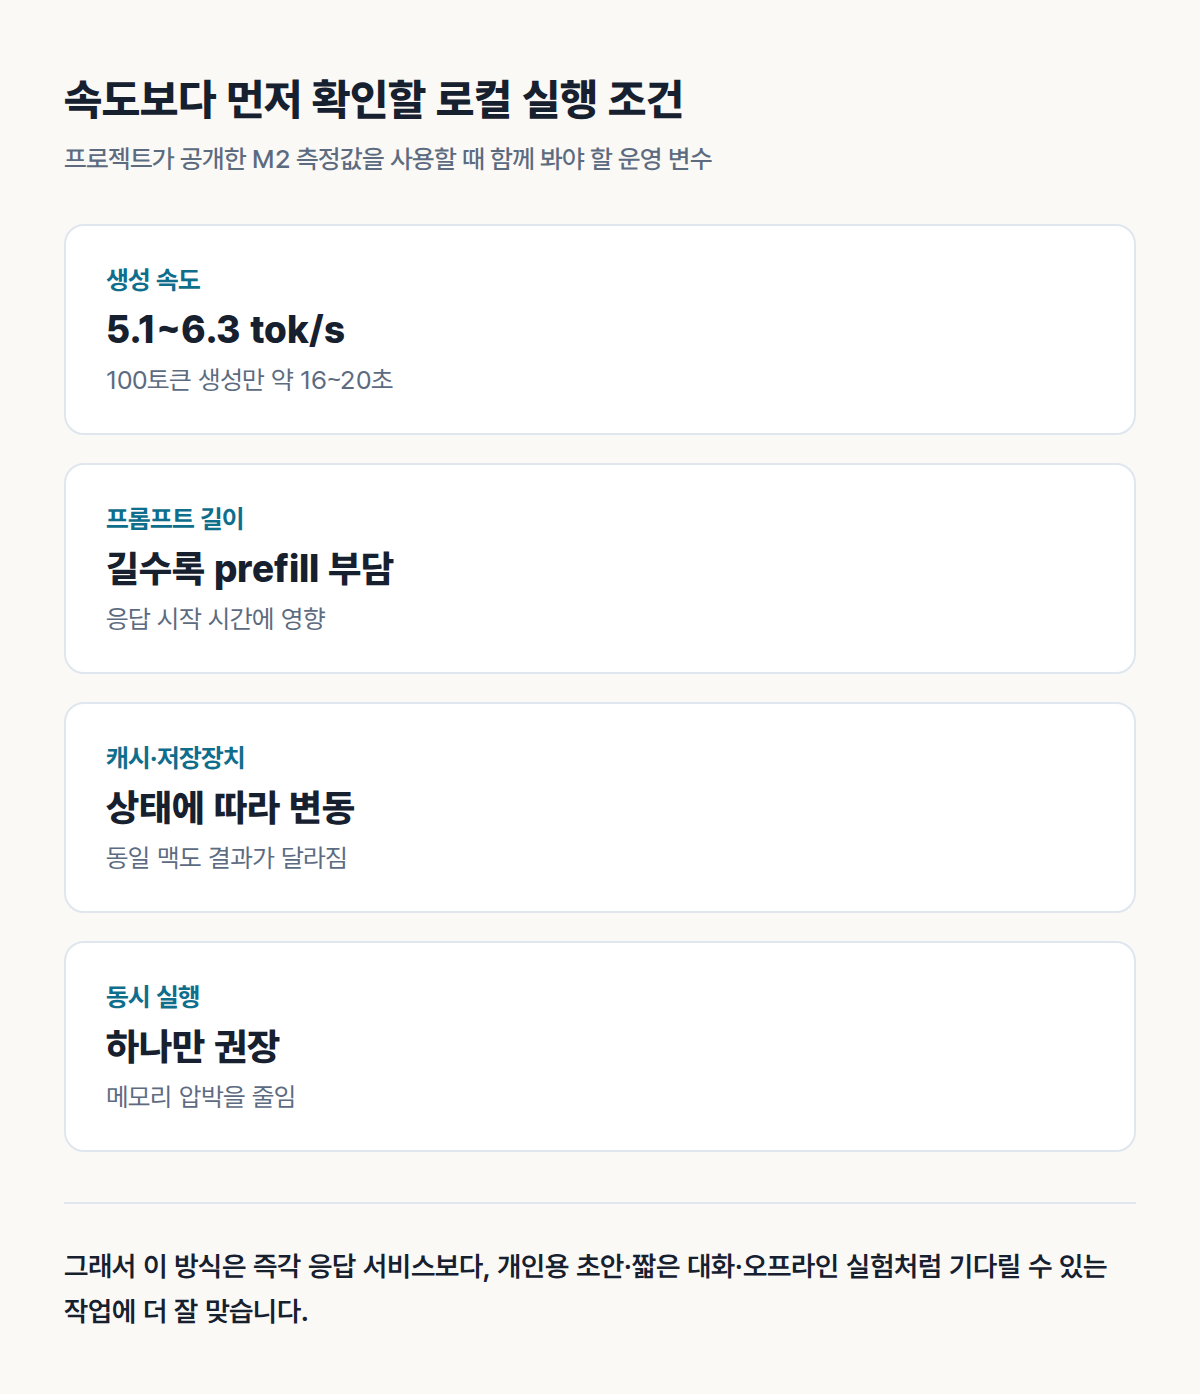
그렇다고 느린 모델이라는 말만으로 끝낼 일은 아니다. 로컬 실행에는 다른 장점이 있다. 프롬프트와 결과를 기기 밖으로 보내지 않아도 되고, API 사용량을 걱정하지 않아도 되며, 네트워크가 불안정한 곳에서도 작업할 수 있다. 민감한 메모를 정리하거나, 개인용 자동화의 초안을 만들거나, 연결 없이 실험해 보는 용도에서는 응답 속도와 맞바꿀 만한 가치가 있을 수 있다.
반대로 여러 사람이 동시에 쓰거나, 이미지와 음성까지 처리하거나, 긴 문서를 빠르게 훑어야 하는 작업에는 맞지 않을 수 있다. TurboFieldfare는 현재 텍스트 전용이고, Apple Silicon과 최신 macOS에만 맞춰져 있다. 로컬 모델을 쓴다고 해서 모든 클라우드 도구를 대체하는 것이 아니라, 어떤 작업을 내 기기 안에 남길지 선택하는 문제에 가깝다.
이 프로젝트가 보여 주는 것은 “큰 모델을 노트북에서 돌렸다”는 데만 있지 않다. 모델 전체를 메모리에 올리는 대신, 어떤 가중치를 언제 읽을지 세밀하게 관리하면 제한된 기기에서도 새로운 선택지가 생긴다는 점이다. 앞으로 로컬 AI를 고를 때도 파라미터 수보다 메모리, 저장공간, 속도, 그리고 내가 감수할 수 있는 대기 시간을 함께 보는 편이 낫다.