
고객 상담 기록이나 사내 기획서를 외부 AI 서버로 보내기 어려운 팀에는 모델의 성능만큼 실행 장소가 중요하다. PrismML이 9월 17일 공개한 Ternary Bonsai 2 27B는 이런 팀이 비교할 만한 로컬 AI 후보다. Qwen3.8 27B를 바탕으로 만든 모델로, 발표에서 내세운 크기는 5.9GB다. 원본 모델과 비교한 집계 벤치마크 성능 유지율은 98.2%다.
도입을 검토할 때는 두 숫자가 무엇을 재는지부터 구분해야 한다. 5.9GB는 특정 형식으로 저장한 언어 모델의 크기이며 컴퓨터에 필요한 총 RAM이 아니다. 98.2%도 모든 업무에서 원본과 같은 답을 낸다는 뜻이 아니다. 백서의 파일 구성과 기기별 측정치를 보면 어떤 조건에서 이 모델을 시험할지 더 구체적으로 정할 수 있다.
5.9GB 파일을 받으면 메모리도 그만큼만 필요할까
이 모델은 가중치를 주로 −1, 0, +1의 세 값과 묶음별 배율로 표현한다. 가중치는 모델이 학습한 정보를 담는 숫자다. 이를 낮은 비트 수로 저장해 공간을 줄인다. 백서의 PTQ1_0 형식은 언어 모델을 5.93GB에 담는다. 같은 언어 모델의 FP16 기준 크기는 53.80GB다. 발표문의 5.9GB는 이 5.93GB를 짧게 표기한 값이다.
배포 파일은 한 가지가 아니다. 실행 중 가중치를 풀어 쓰기 쉬운 PQ2_0 형식은 7.25GB다. GGUF 배포본에서 이미지까지 입력하려면 0.63GB의 비전 모듈을 별도로 더한다. 애플 기기용 MLX 패키지는 저장 방식이 다르고 고정밀 비전 모듈을 포함해 8.49GB다. 따라서 맥에 내려받을 파일도 모두 5.9GB일 것이라고 잡으면 용량 계획부터 어긋난다.
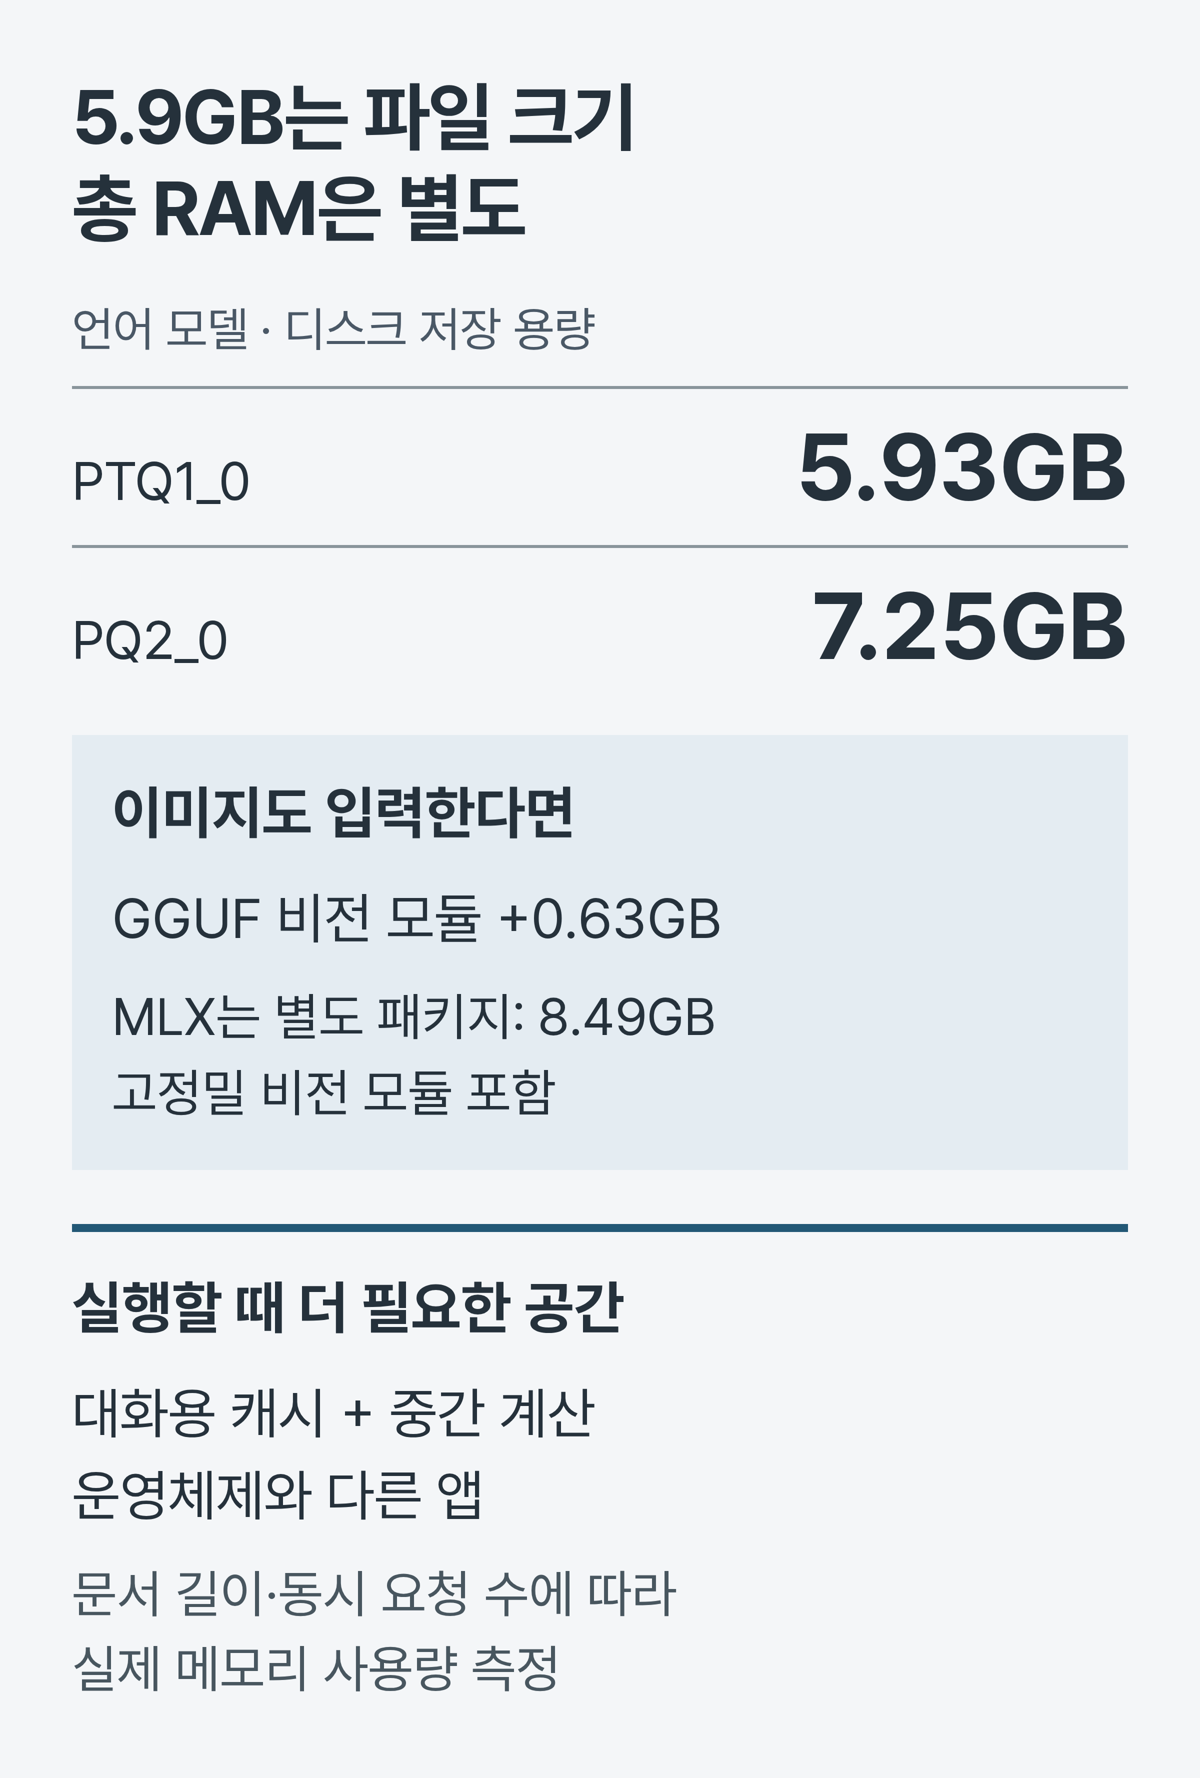
실행할 때는 모델 외에 대화 내용을 처리하기 위한 KV 캐시와 중간 계산 공간이 필요하고, 운영체제와 다른 앱도 메모리를 쓴다. 지원하는 최대 입력 길이는 262K토큰이지만, 이 길이의 문서를 넣는 데 필요한 메모리까지 5.9GB에 포함되는 것은 아니다. 제품팀은 실제 문서 길이와 동시 요청 수를 정한 뒤 최대 메모리 사용량을 재야 한다. 특히 이미지 입력을 쓰는 제품은 텍스트 전용 실행과 따로 측정할 필요가 있다.
스마트폰 관련 수치도 구분해야 한다. 7월 14일 발표된 이전 Bonsai 27B의 3.9GB는 Qwen3.6 기반 1비트 모델의 크기다. 이번 Qwen3.8 기반 Ternary Bonsai 2 27B와는 세대와 저장 방식이 모두 다르다. 이전 모델의 아이폰 시연을 이번 모델이 같은 메모리 조건에서 실행된다는 근거로 옮길 수는 없다.
98.2%는 어떤 성능을 남겼다는 뜻인가
PrismML은 추론 모드의 20개 벤치마크 평균에서 Bonsai 2가 83.9점, Qwen3.8 원본이 85.4점을 기록했다고 밝혔다. 98.2%는 이 집계 성능의 유지율이다. 지시 따르기에서는 Bonsai 2가 82.66점으로 원본의 81.25점보다 높지만, 시각 이해에서는 78.59점으로 원본의 81.64점보다 낮다. 문서를 읽고 표를 해석하는 제품이라면 평균보다 해당 작업의 오류가 더 직접적인 비교 대상이다.
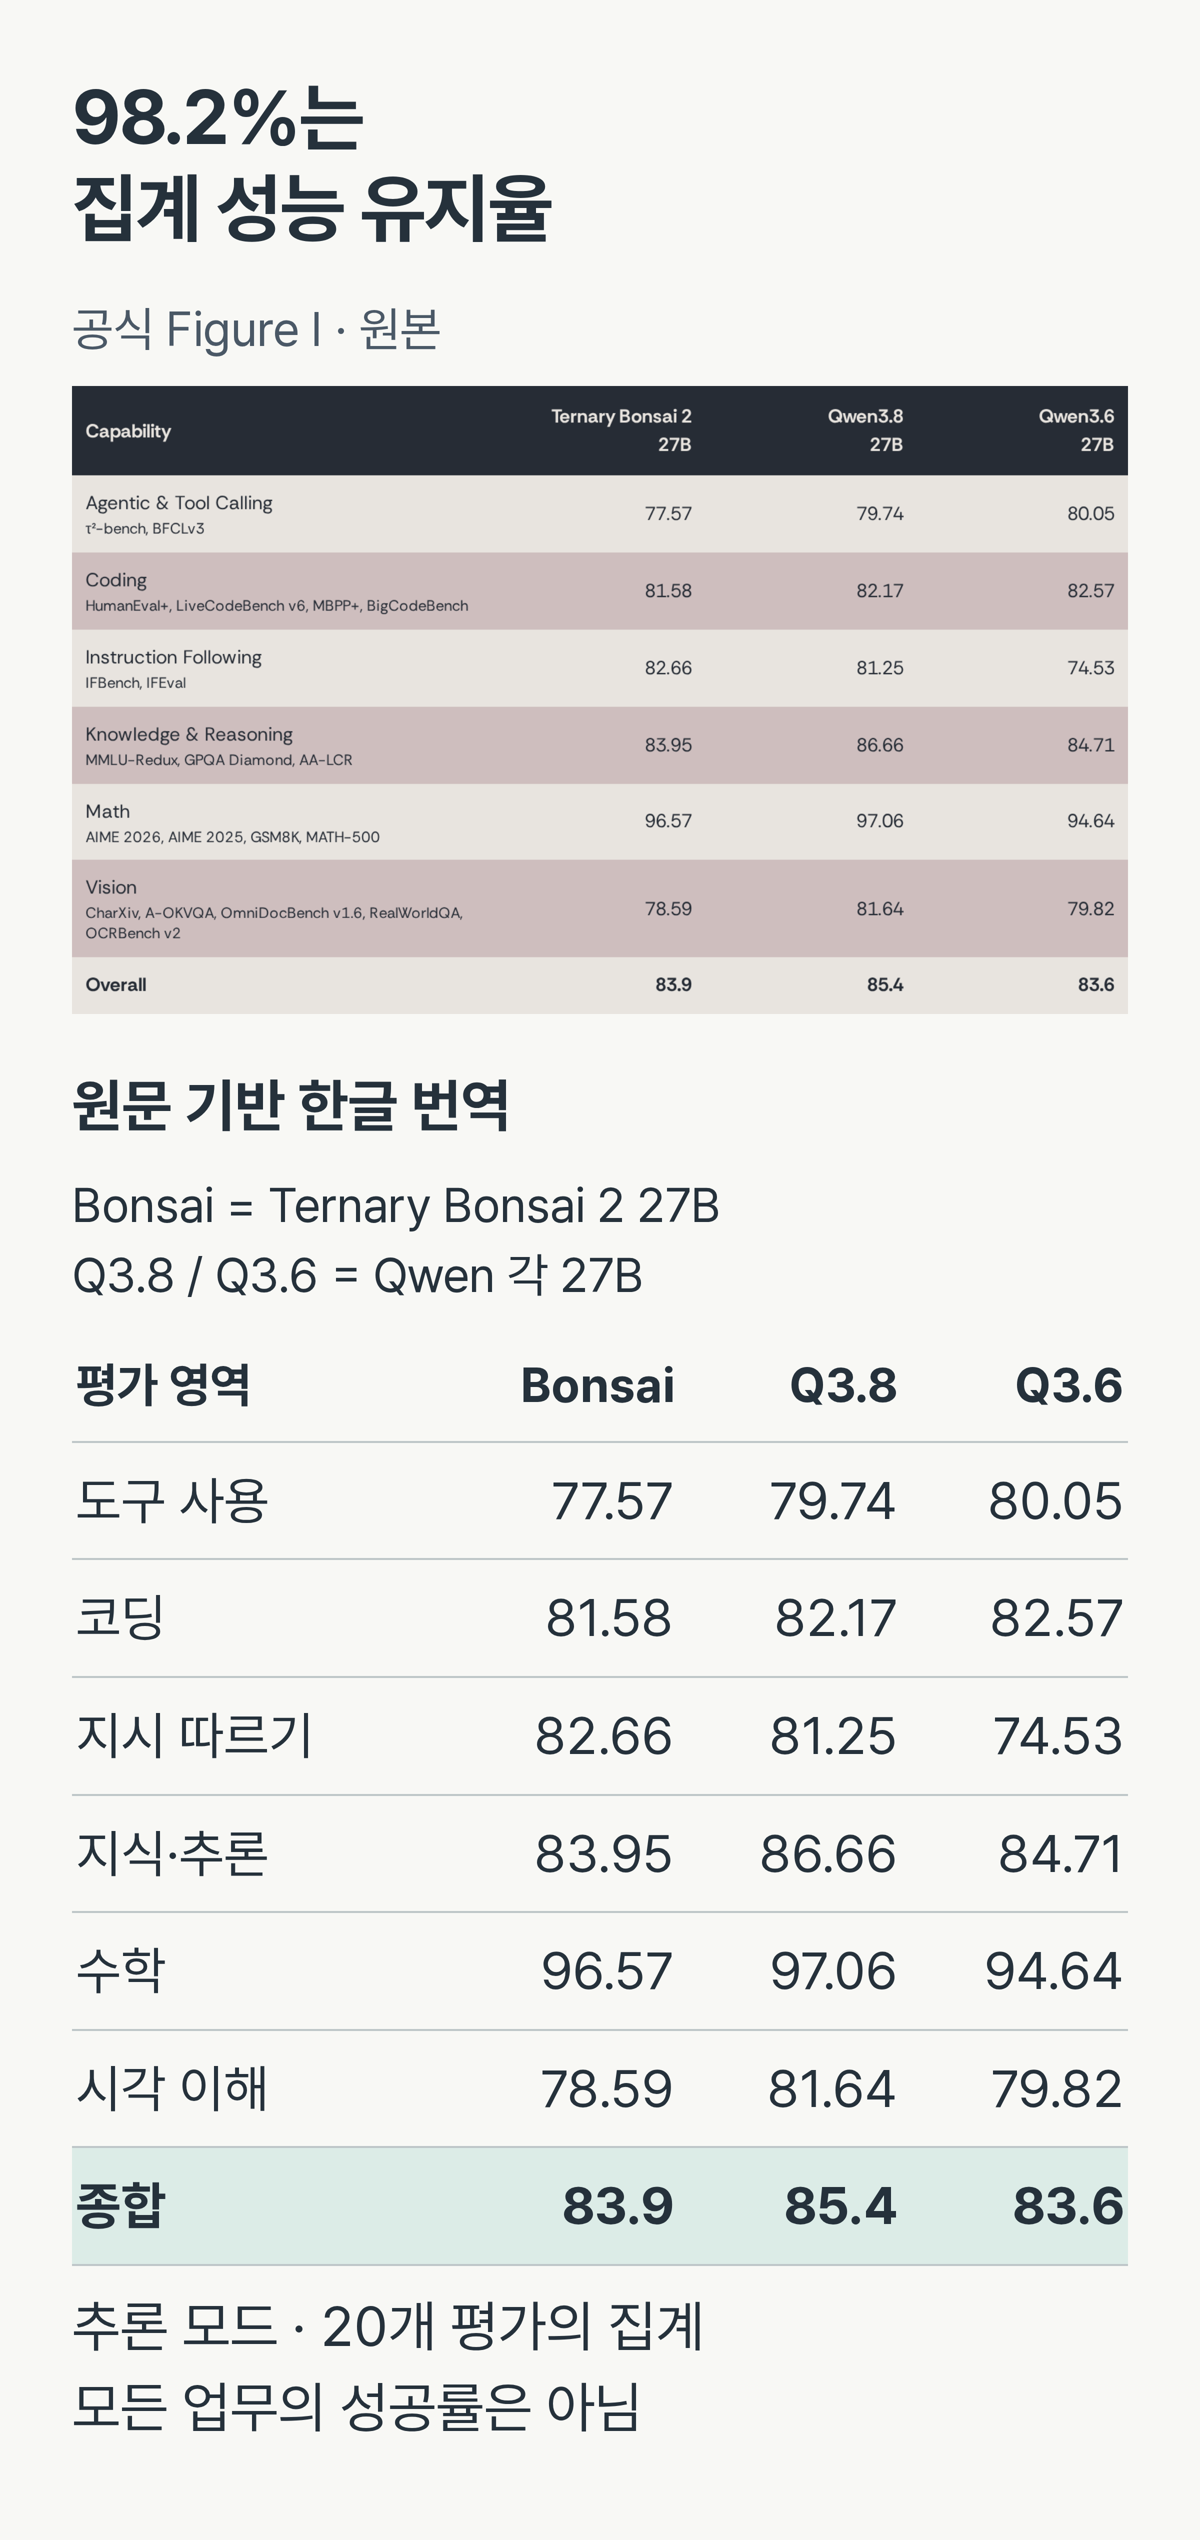
여러 단계에 걸쳐 도구를 쓰는 업무에서는 차이가 더 커진다. 백서가 별도로 제시한 Terminal-Bench 2.1 점수는 Bonsai 2가 52.8, 원본이 69.7이다. SWE-bench Verified에서는 각각 60.8과 80.6이다. 이 두 평가는 약 4분의 3 수준의 성능을 남겼다. 집계 유지율 98.2%를 코드 수정부터 검증까지 이어지는 전체 작업의 성공률로 읽으면 도입 효과를 과대평가하게 된다.
파일이 더 작은 형식이 항상 빠른가
발표문은 RTX 5090에서 최대 초당 143토큰, M5 Max에서 46.8토큰을 제시한다. 토큰은 모델이 글을 처리하는 단위로, 한국어 글자 수와 일치하지 않는다. 백서에서 RTX 5090의 142.5토큰은 7.25GB인 PQ2_0 형식의 측정값이다. 더 작은 5.93GB PTQ1_0 형식에서는 134.4토큰이다. 작은 파일과 최고 속도가 같은 설정에서 나온 수치는 아니다.
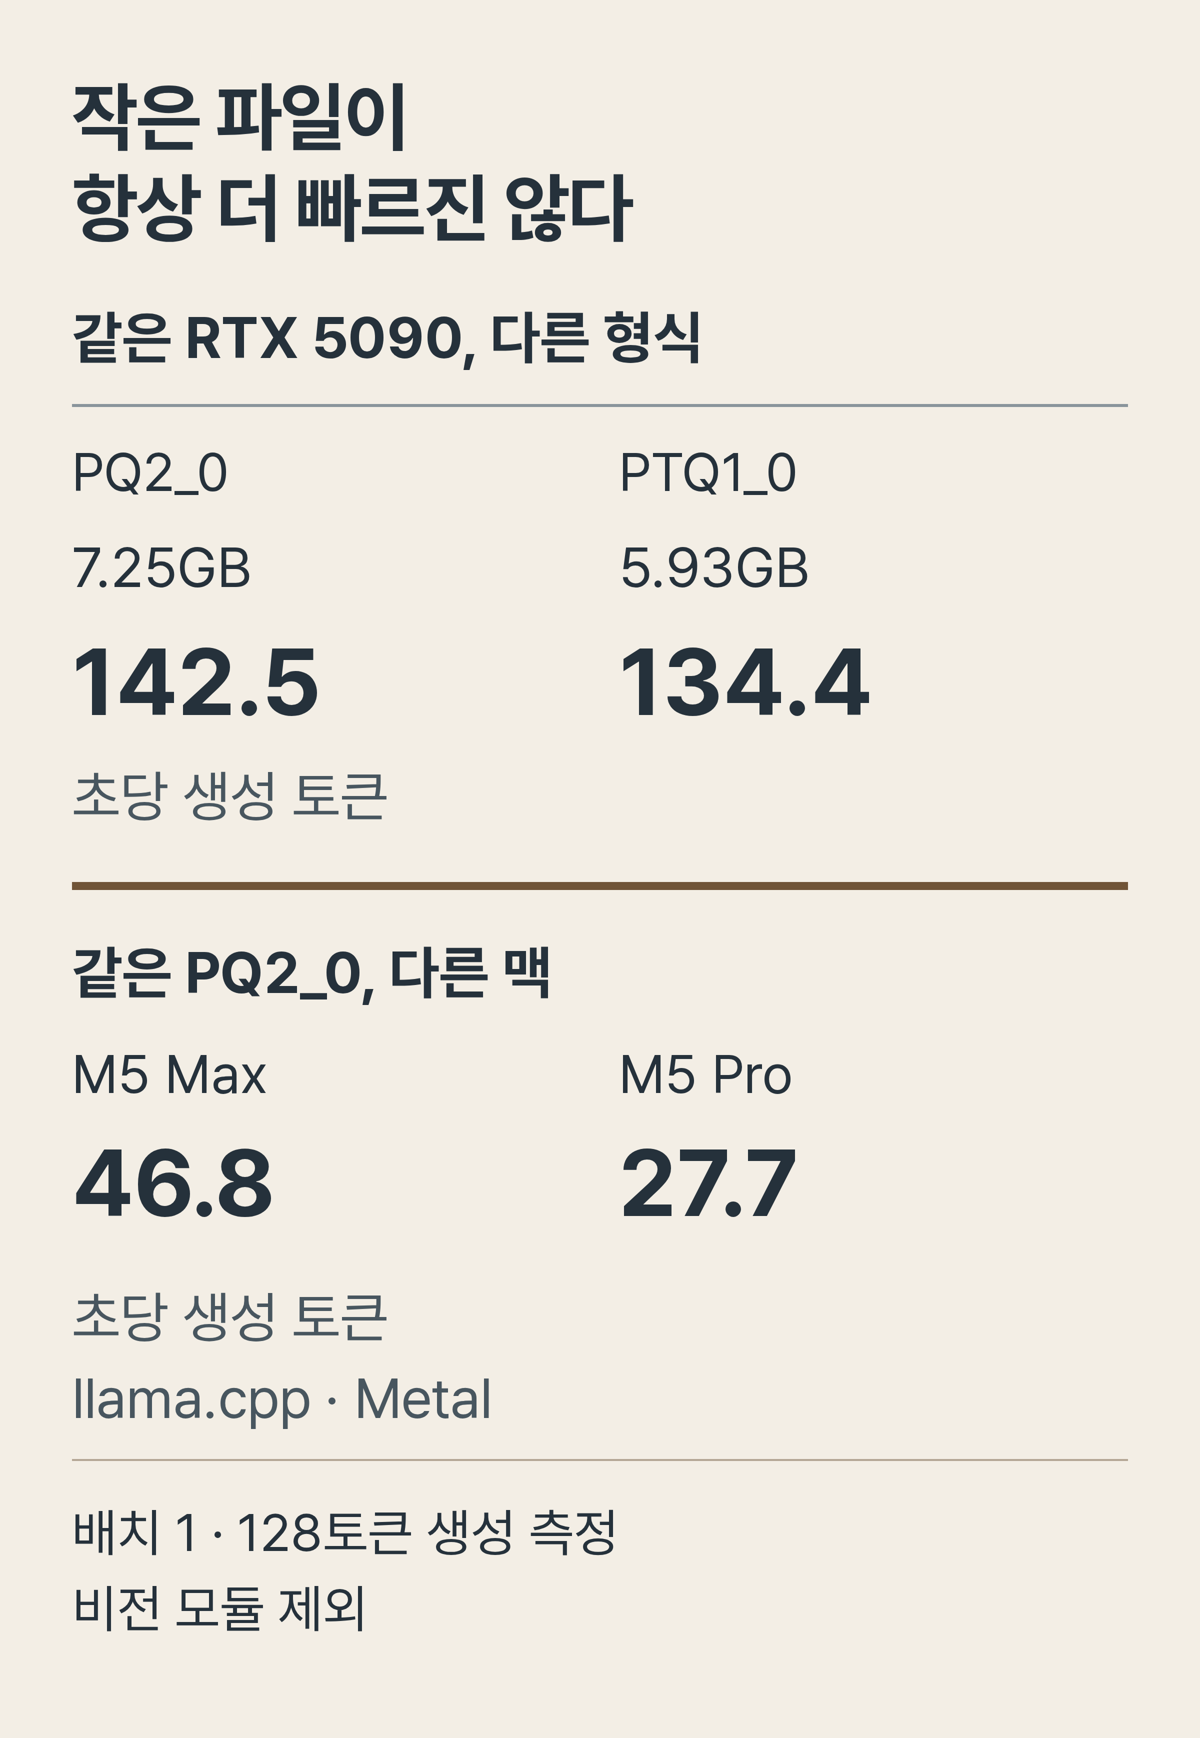
처음 문서를 읽는 속도도 따로 봐야 한다. PQ2_0 기준으로 M5 Max는 초당 46.8토큰을 생성하지만 512토큰 입력 처리 측정에서는 초당 765토큰이다. M5 Pro는 각각 27.7토큰과 397토큰이다. 이 애플 노트북 수치는 llama.cpp의 Metal 백엔드에서 측정됐다. 답이 나오기 시작한 뒤의 생성 속도만으로 긴 문서를 읽고 첫 답을 보여 주기까지의 대기 시간을 설명할 수는 없다.
민감한 문서 제품에서는 무엇부터 시험할까
먼저 사내 문서에서 자주 묻는 질문과 정답 근거를 묶어 작은 평가 세트를 만드는 편이 좋다. 같은 기기에서 다른 로컬 모델과 비교하되, 짧은 요약만 시키지 말고 실제 길이의 문서에서 수치와 예외 조항을 찾게 해야 한다. 정답률과 함께 첫 응답까지의 시간, 작업 완료 시간, 최대 메모리 사용량을 기록하면 파일 크기가 줄어든 이익과 품질 손실을 같은 업무에서 비교할 수 있다.
로컬 추론은 문서를 기기 안에서 처리하는 구성을 가능하게 한다. 모델에 연결한 검색 도구나 로그 수집기가 외부로 데이터를 보내면 그 이점은 사라질 수 있으므로, 제품 시험에는 외부 통신 경로 확인도 포함해야 한다. 모델은 Apache 2.0으로 공개됐다. 민감한 문서를 외부로 보내지 않는 제품을 검토하는 팀이라면, 보유 기기에서 감당할 문서 길이와 허용할 오류 수준을 정해 Bonsai 2를 후보군에 넣어 볼 만하다.
출처: PrismML의 9월 17일 발표 · 기술 백서 · 7월 14일 이전 모델 발표