
2,840억 파라미터짜리 DeepSeek 모델이 GPU 없는 노트북급 CPU와 64GB 메모리에서 초당 약 9~10토큰으로 돌아간다. 오픈소스 프로젝트 llama-modchip가 DeepSeek-V4-Flash를 그렇게 돌렸다고 밝혔다. 모델 파일을 줄이고, CPU 쪽 계산 방식을 고치고, 추측 디코딩을 얹은 세 가지 조합이다.
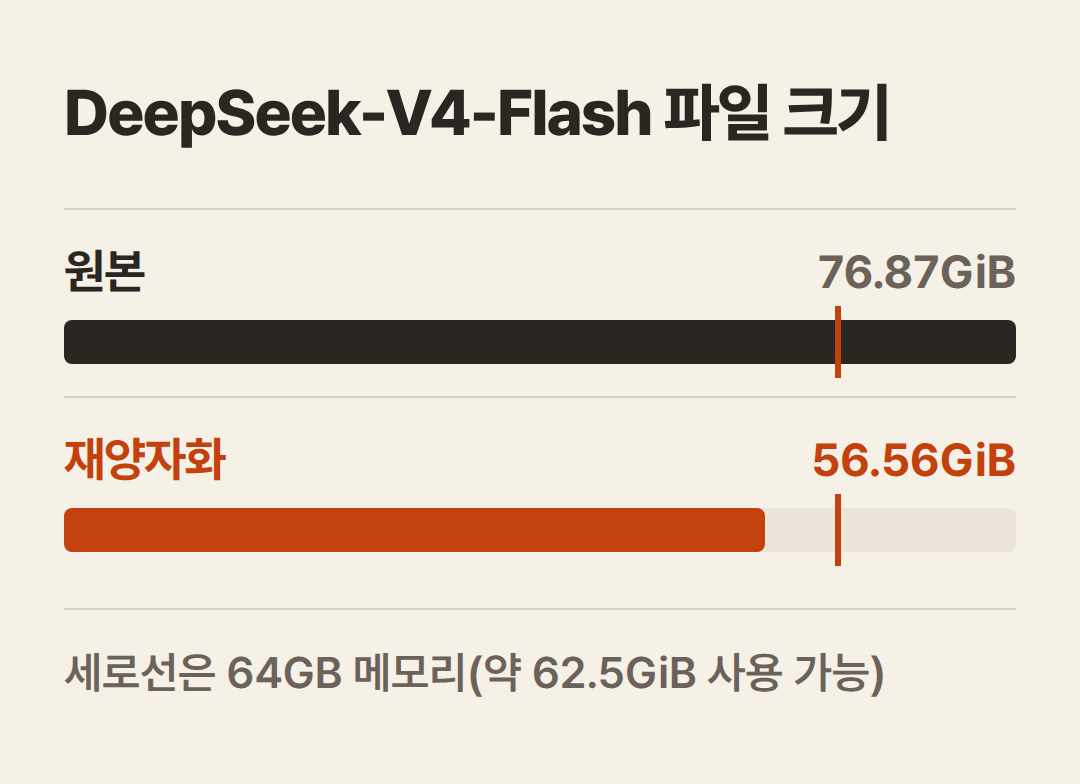
76.87GiB를 56.56GiB로 줄였다
핵심은 모델 크기다. 작성자는 DeepSeek-V4-Flash를 다시 양자화해 파일을 76.87GiB에서 56.56GiB로, 가중치당 평균 1.71비트까지 낮췄다. 질문마다 일부만 켜지는 전문가(MoE) 계층은 대부분 IQ1_S로 줄이고, 민감한 계층은 더 정밀한 형식으로 남겼다. 어텐션 투영에는 Fractal-64라는 3.75비트 형식을 새로 만들어 썼다. 이렇게 하면 256K 컨텍스트에서도 메모리 사용이 약 57.6GiB에 머문다고 한다.
CPU 쪽에서 속도를 더한다
- AVX-512로 여러 열을 한 번에 계산해 프롬프트 처리를 빠르게 한다.
- 전문가 가중치를 읽을 때 캐시를 밀어내지 않는 방식(non-temporal 힌트)으로 스트리밍해, KV 캐시가 L3에 남도록 한다.
- n-gram 초안기가 다음 토큰을 먼저 제안하고, KV 캐시 스냅샷을
/dev/shm에 두어 컨텍스트를 13~33ms에 복원한다.
속도
작성자가 Ryzen 9 9955HX, 64GB, GPU 없는 환경에서 잰 값이다.
- 프롬프트 처리: 초당 43~44토큰
- 생성: 전문가를 모두 쓰면 초당 약 9.1~9.95토큰, 초안기와 일부 절충을 쓰면 초당 11.5~14.7토큰
더 작은 30B Nemotron-3.5-A3B(14.35GiB)는 CPU만으로 초당 25~60토큰, Vulkan GPU를 섞으면 약 81토큰, Threadripper PRO 7985WX에서는 약 112토큰이 나온다고 한다. Zen 4·5 데스크톱, Apple M4 Max와 M4 Pro, AWS Graviton3 같은 기기에서 커뮤니티가 보낸 결과도 저장소에 모여 있다.
직접 돌려 보려면
x86_64(AVX2 이상) 또는 ARM64 기기가 필요하다. 284B 모델은 메모리 약 64GB, 30B 모델은 16~32GB면 된다. 이 프로젝트가 만든 새 텐서 형식은 기본 llama.cpp, Ollama, LM Studio가 읽지 못하므로 저장소의 자체 바이너리를 빌드해야 한다. 저장소 스크립트는 다음과 같다.
./modchip chat: 대화./modchip bench: 속도 측정./modchip claude: 로컬 엔진에 Claude Code CLI를 연결
모델을 받기 전에 점검 스크립트로 기기가 맞는지 먼저 볼 수 있다. 빠른 시작은 컨텍스트 32K로 설정되어 있다.
적용해 볼 점
대형 MoE 모델은 한 번에 일부 전문가만 쓰니 연산보다 메모리가 병목이라는 점이 이 실험에서 보인다. 64GB 메모리를 단 최신 데스크톱이 있다면 GPU를 사지 않고도 수백억 파라미터급 모델을 써 볼 수 있다. 먼저 30B Nemotron으로 환경을 확인한 뒤 284B로 올리는 순서가 부담이 적다. 클라우드 API 비용이 부담스러운 반복 작업이나, 데이터를 밖으로 내보내고 싶지 않은 작업의 후보로 올려 둘 만하다.
출처: llama-modchip