
로컬 모델을 코딩 도구에 붙이는 일은 모델 파일을 한 번 내려받는 것으로 끝나지 않는다. 새 모델이 나올 때마다 내 PC에서 어느 양자화와 컨텍스트 조합이 돌아가는지 가늠하고, Codex나 Claude Code 같은 에이전트가 그 모델을 호출할 주소와 형식을 다시 맞춰야 한다. 성능이 기대보다 낮거나 메모리가 부족하면 이 과정을 다시 한다.
9월 8일 GitHub Trending 주간 신호로 수집된 Magnitude는 이 반복을 로컬 추론 서버 하나로 묶으려는 오픈소스다. PC의 프로세서, 메모리, 메모리 대역폭을 프로파일링한 뒤 모델, 양자화, 컨텍스트 크기를 한 조합으로 추천하고, 선택한 조합을 기존 에이전트 연결에 넣는다. 목표는 특정 모델을 고르는 일이 아니라 모델을 바꿔도 코딩 흐름을 다시 조립하지 않는 데 있다.
로컬 모델 선택에는 연결 설정까지 따라붙는다
같은 로컬 모델이라도 에이전트가 바로 쓸 수 있는 것은 아니다. 추론 런타임을 띄우고, API 호환 방식과 모델 선택을 설정하고, 도구 호출과 대화 형식의 차이를 처리해야 한다. 모델이 바뀌면 속도와 메모리 조건도 다시 달라진다. 그래서 로컬 모델 실험은 모델 비교보다 연결 설정을 되풀이하는 시간이 더 길어지기 쉽다.
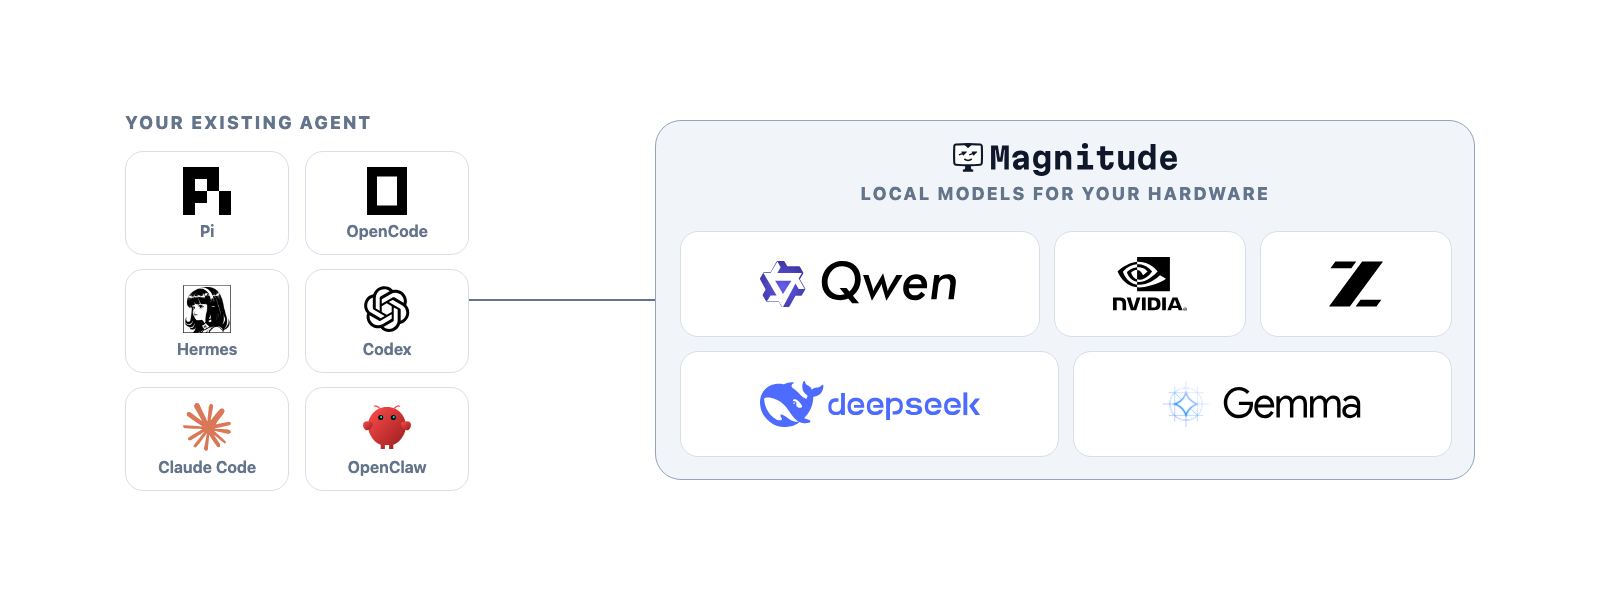
Magnitude는 이 접점을 자신의 백그라운드 서비스로 통일한다. 문서상 서비스는 로컬 루프백 주소의 OpenAI 호환 API와 Anthropic 호환 API를 제공한다. 각 하네스가 모델마다 별도 동작을 구현하는 대신, Magnitude가 서로 다른 추론 형식, 도구 호출 형식, 채팅 템플릿을 정규화한다는 구조다. 지원 목록에는 Pi, OpenCode, Hermes, OpenClaw, Codex, Claude Code, Oh My Pi, Cline과 자체 Magnitude Harness가 들어 있다.
설정 화면이 아니라 사용 흐름에서 시작한다
공식 온보딩은 에이전트에게 magnitude docs onboarding을 읽게 하는 흐름을 앞에 둔다. 에이전트가 하드웨어를 확인하고, 추천 후보를 보여 주고, 사용자가 고른 모델을 내려받은 뒤 자신의 연결을 전환한다. 수동 설정에서도 순서는 같다. 하드웨어 프로파일링, 모델·양자화·컨텍스트 조합의 순위화, 속도·지능·메모리 조건 비교, 다운로드와 구성, 하네스 연결, 연결된 하네스 실행이 이어진다.


추천은 단순한 모델 이름 목록이 아니다. Magnitude 문서는 모델, 양자화, 컨텍스트 크기를 합친 완성된 구성으로 추천한다고 설명한다. 최대 열 개 구성을 지능, 추정 생성 속도, 양자화 품질, 설정된 컨텍스트, 물리 메모리 기준으로 정렬한다. 선택을 바꿀 때도 하네스의 모델 선택 메뉴를 쓰거나 에이전트에게 더 빠른 후보를 찾아 설치하고 전환하게 할 수 있다.
모델을 바꿔도 PC에 남는 것은 무엇인가
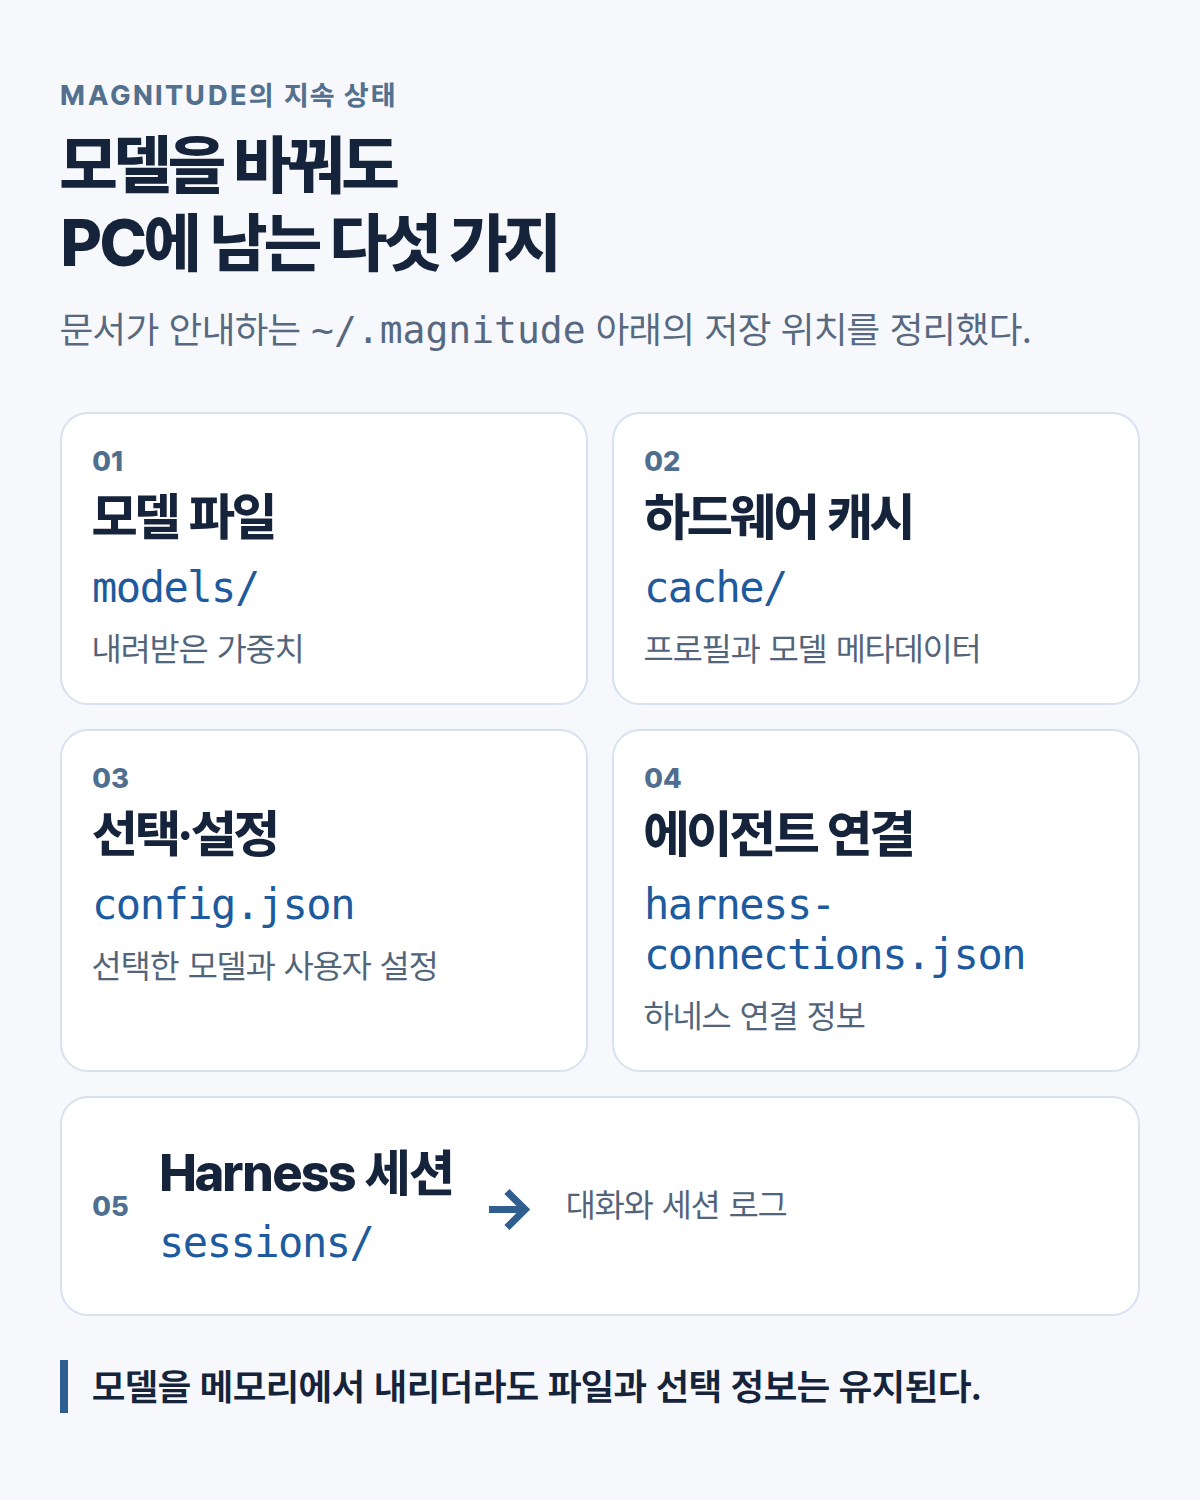
이 흐름에서 남는 산출물은 다운로드한 가중치만이 아니다. Magnitude 관리 모델은 ~/.magnitude/models/에 남고, 하드웨어 프로필과 모델 메타데이터는 ~/.magnitude/cache/에 저장된다. 선택한 모델과 사용자 설정은 ~/.magnitude/config.json, 에이전트 연결 정보는 ~/.magnitude/harness-connections.json에 기록된다. 자체 Harness를 쓰면 대화와 세션 로그도 ~/.magnitude/sessions/에 보존된다.
이 파일들이 남는다는 뜻은 다음 모델을 시험할 때 처음부터 환경을 세우지 않는다는 뜻이다. 내려받은 모델은 필요할 때만 메모리에 올라가고, 유휴 상태이거나 메모리가 부족하면 내려간다. 파일과 선택 정보는 지우지 않는다. 다음 요청에서 같은 모델을 다시 올릴 수 있고, 다른 설치 모델로 바꿀 때도 연결의 기준점은 유지된다. 첫 요청에는 모델 적재 시간이 붙고, 이미 활성화된 모델에는 바로 추론이 시작된다는 운영 차이도 문서에 명시돼 있다.
교체 비용을 낮추는 범위는 모델 품질과 다르다
Magnitude가 줄이려는 비용은 모델 자체의 답변 품질을 올리는 비용이 아니다. 모델이 내 하드웨어에서 어느 정도 속도로 돌지 판단하고, 모델을 받으며, 에이전트와 다시 연결하고, 메모리 상태에 맞춰 실행하는 운영 비용이다. 실제 생성 속도는 프롬프트 길이, 동시 작업, 다른 앱의 메모리 사용량, 모델 리비전에 따라 달라진다. 추천 화면의 속도 범위도 이 조건을 전제로 제시된다.
Codex와 Claude Code 연결은 Magnitude 백그라운드 서비스에 의존한다. 문서는 두 도구가 호스팅 모델로 되돌아갈 때도 연결이 설치된 동안에는 이 로컬 게이트웨이를 거친다고 적고 있다. 따라서 이 두 도구를 쓰는 사람은 모델을 바꾸는 것만큼 서비스 상태와 연결 해제 방법도 작업 규칙으로 정해 두는 편이 낫다. 반대로 여러 로컬 모델을 번갈아 시험하고 같은 코딩 에이전트에서 계속 쓰려는 경우에는, 모델별 설정 파일을 직접 갈아끼우는 일을 줄일 수 있다.
설치는 마지막에 한 번만 하면 된다
도입 판단이 끝났다면 CLI를 설치하고 magnitude setup으로 대화형 설정을 시작할 수 있다. 지원 운영체제는 macOS와 Linux이며 Windows는 WSL을 통해 지원한다. 그러나 먼저 확인할 일은 설치 명령이 아니라 현재 코딩 도구와 연결 가능한지, PC 메모리 조건에서 원하는 컨텍스트를 유지할 수 있는지, 모델을 바꾼 뒤에도 남겨 둘 연결과 세션 기록이 무엇인지다. Magnitude는 그 판단과 전환을 한 서비스와 파일 구조에 남기는 도구다.
출처: Magnitude README, Get Started, Inference, Models, Reference, Troubleshooting