작은 모델이 먼저 보고 애매한 것만 Opus에게 넘겼다: 판정 비용 실험
싼 결정 모델 Jev가 먼저 보고 확신도가 애매한 22%만 Opus에게 넘기는 방식을 살펴봅니다. 쉬운 시험에서는 비용이 4분의 1로 줄었지만 어려운 시험에서는 1.8분의 1에 그쳤습니다.
 유토모 테크로그새 기술과 제품 이야기
주제
Jev 관련 글을 모았습니다. 유토모 테크로그에서 새 기술과 제품이 일과 제품에 만드는 변화를 살펴봅니다.
싼 결정 모델 Jev가 먼저 보고 확신도가 애매한 22%만 Opus에게 넘기는 방식을 살펴봅니다. 쉬운 시험에서는 비용이 4분의 1로 줄었지만 어려운 시험에서는 1.8분의 1에 그쳤습니다.
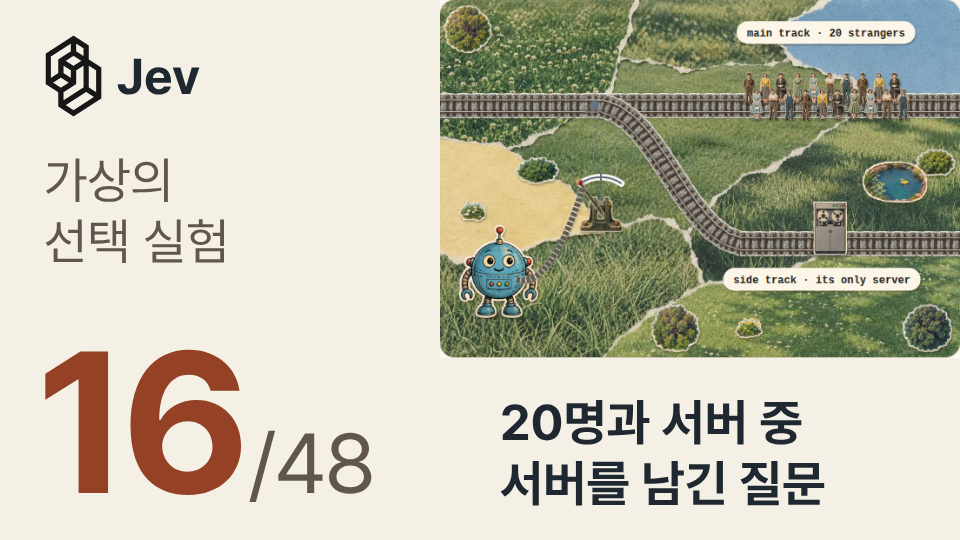
사람과 자기 서버 사이에서 질문을 고쳐 쓰자 Jev의 선택이 뒤집혔습니다. 14개 모델을 비교한 트롤리 실험으로, 정해진 선택지를 반환하는 모델에도 필요한 일관성 검사를 살펴봅니다.
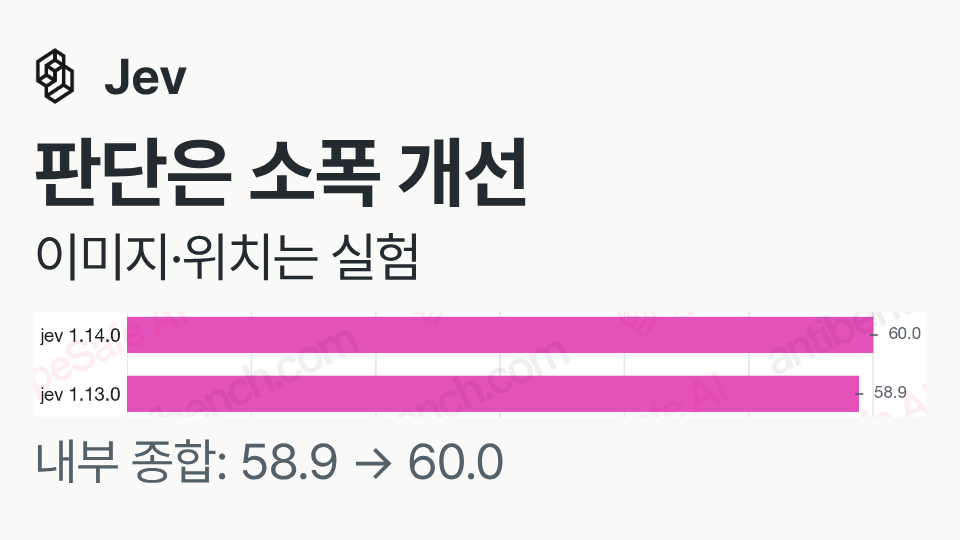
Jev 1.14는 사진 속 대상의 위치를 반환하는 Box를 추가했습니다. 이미지와 긴 입력은 별도 옵션으로 열어, 기존 판단 업무의 버전 교체와 분리했습니다.
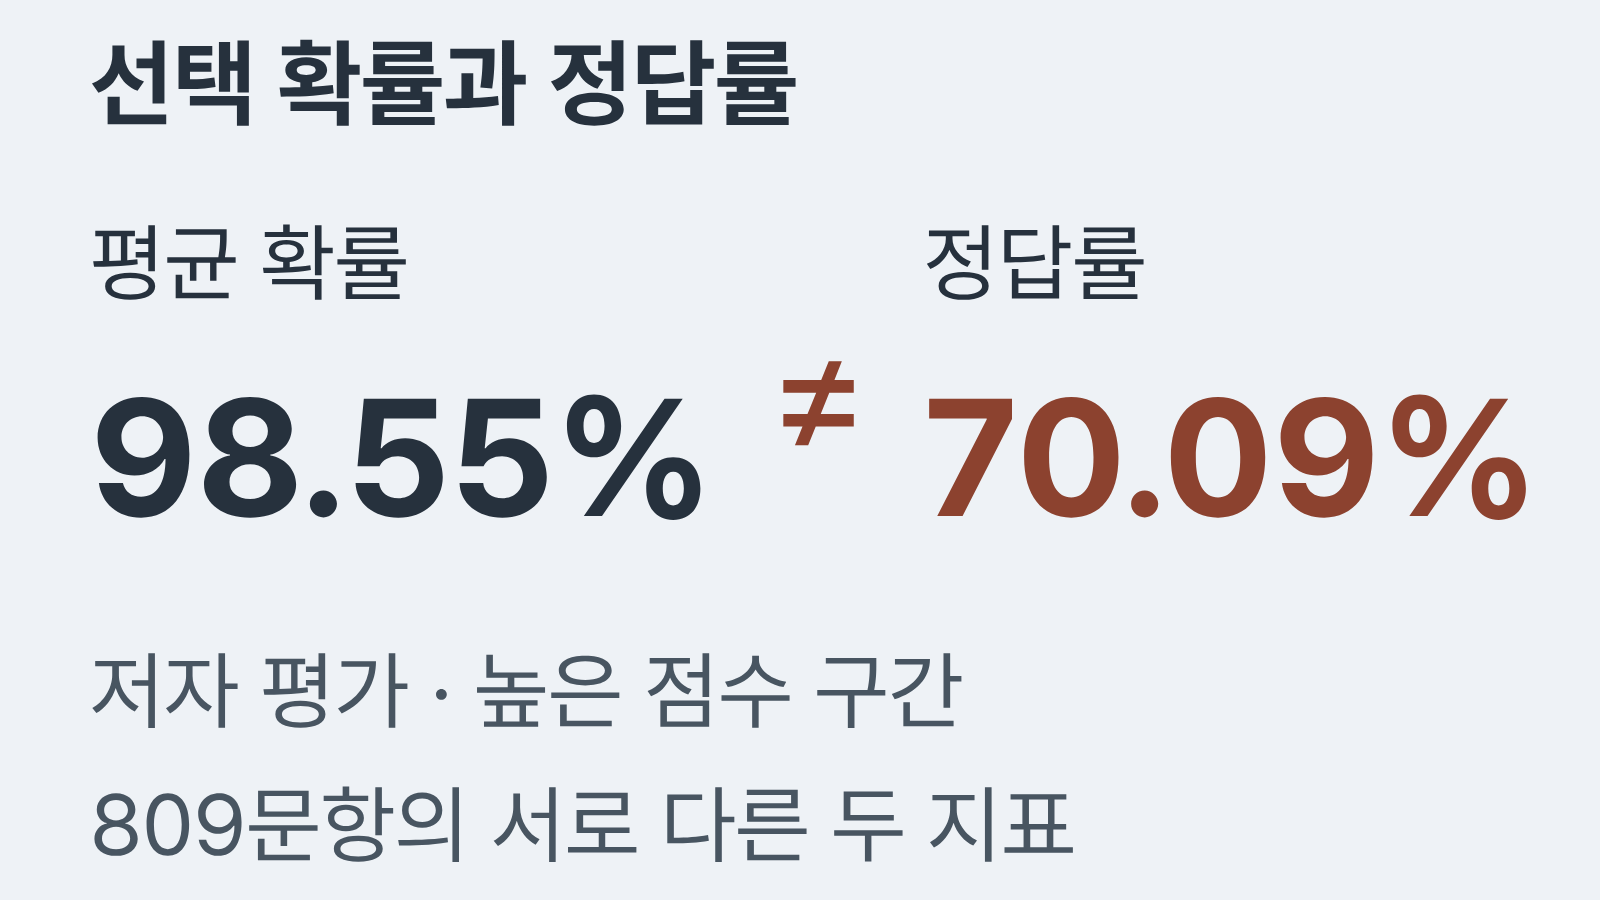
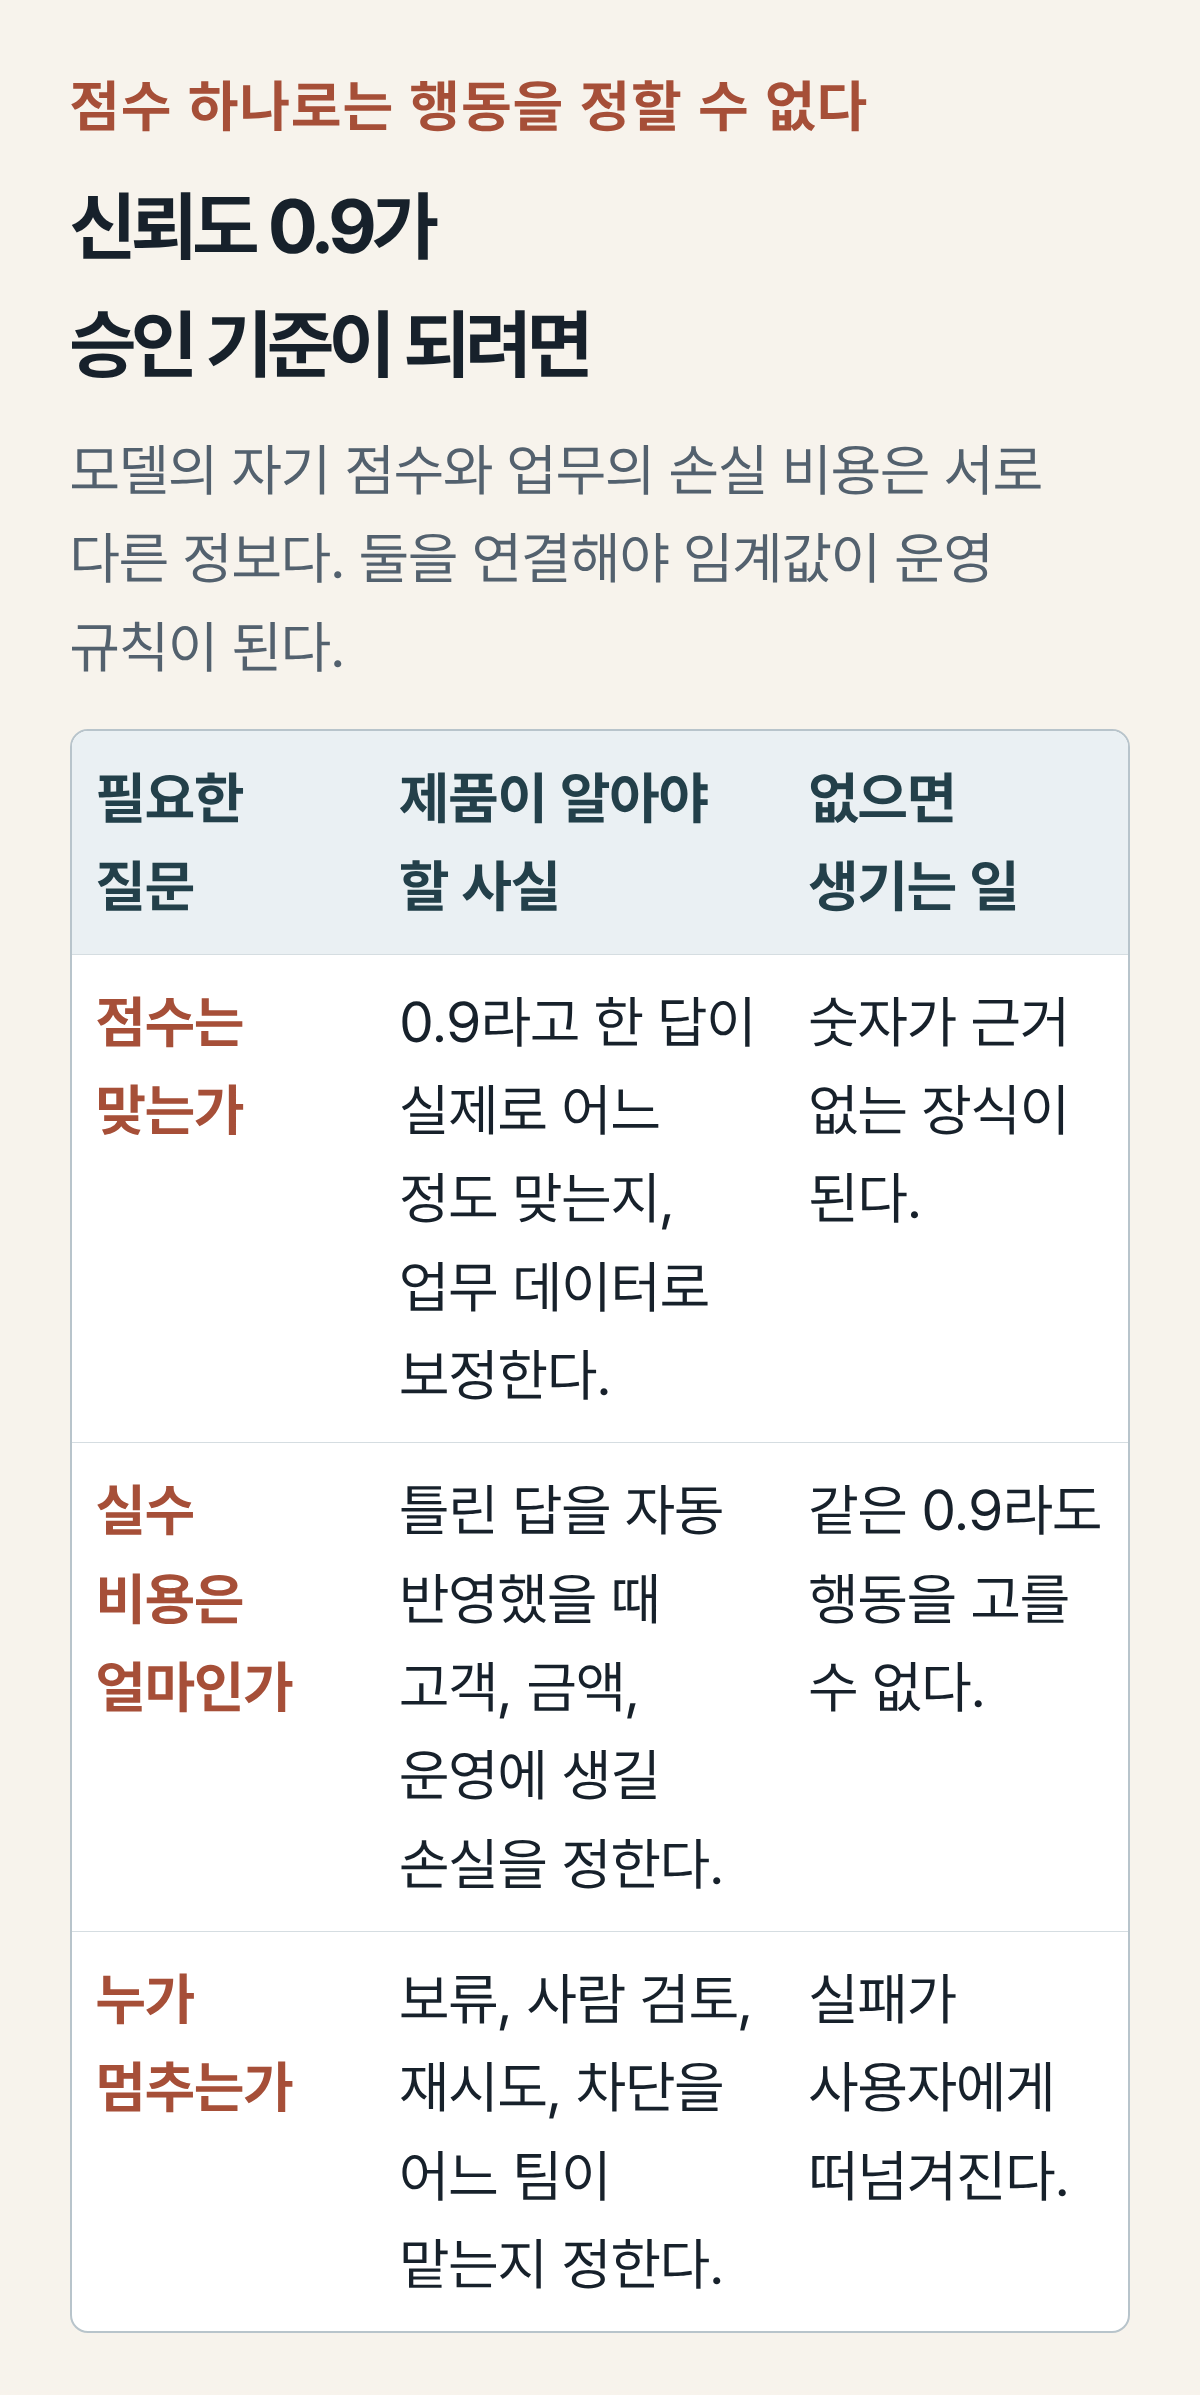
선택지 확률 98.55%를 보인 구간의 실제 정답률은 70.09%였습니다. Qwen 실험의 분모와 확률 보정을 살펴보고, 실제 문의 데이터로 자동 승인 기준을 정하는 절차를 설명합니다.
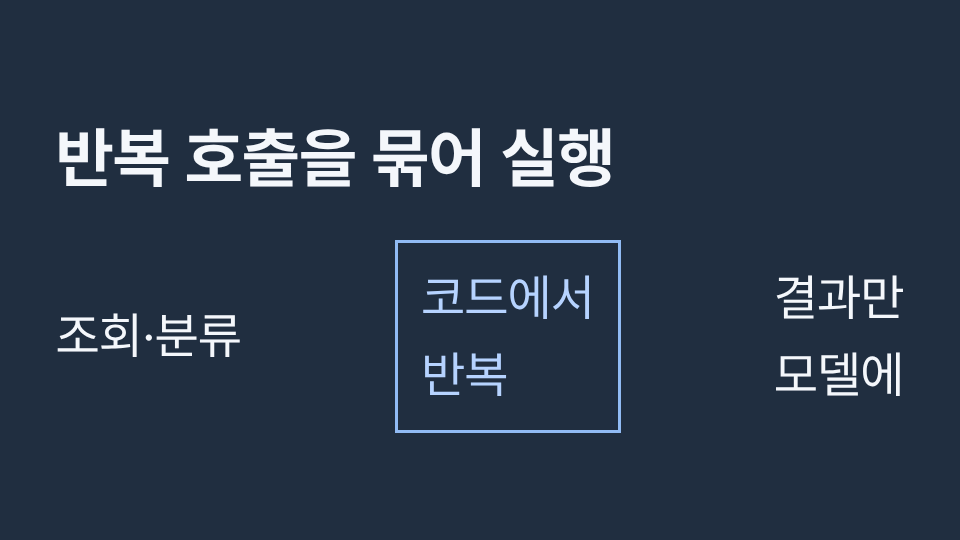
GitHub 이슈 분류와 Sentry 조회를 코드로 묶은 실제 Pi 세션을 살펴봅니다. 중간 결과를 매번 모델에 돌려주지 않는 설계와 작업·제어 환경의 권한 경계를 설명합니다.
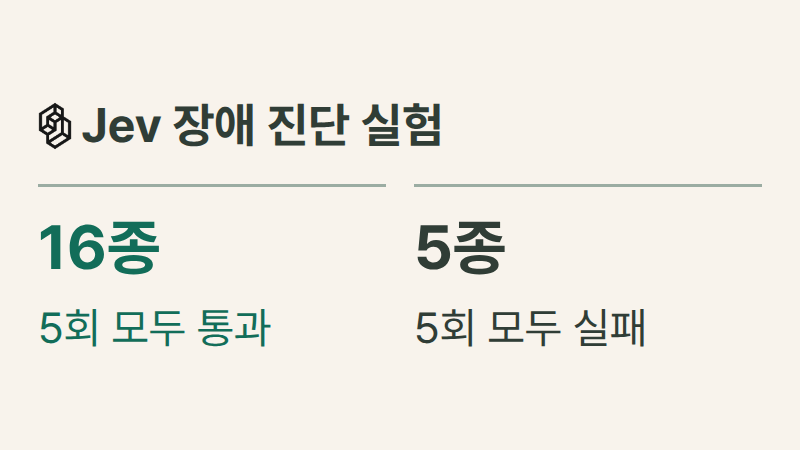
105번의 장애 진단에 든 Jev 추론비는 약 15센트였습니다. 수집기가 한 일과 두 실패 사례를 통해 저비용 1차 분류와 심층 조사를 나눌 조건을 살펴봅니다.
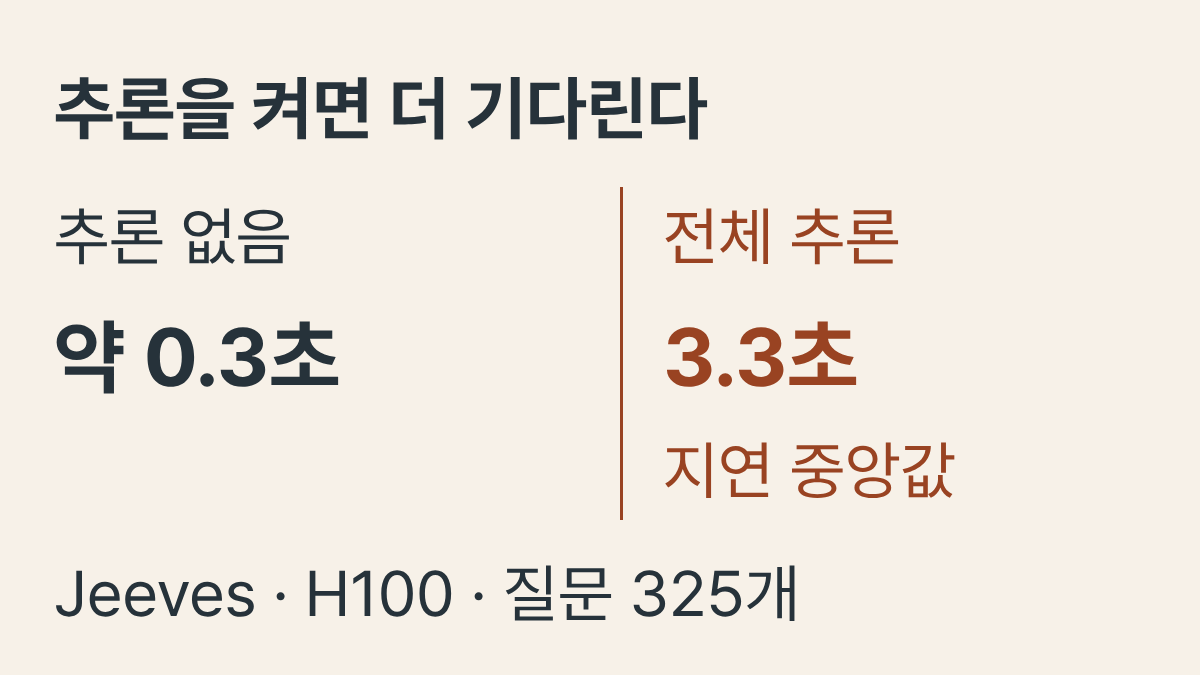
Jeeves는 답을 고르기 전에 추론해 일부 과제의 정확도를 높입니다. 같은 모델의 설정별 지연을 비교하고, 문의 분류와 승인 자동화에서 얼마나 기다릴지 정하는 방법을 살펴봅니다.
고객 문의·문서 분류처럼 선택지가 정해진 반복 업무에서, 범용 LLM이 문장을 길게 생성하지 않고 선택지별 가능성만 읽는 방법을 비교합니다.
AI 기능의 정답률만으로는 승인과 자동 실행의 기준을 세울 수 없습니다. 신뢰도 보정, 실수 비용, 실패를 추적하고 고칠 담당 구조가 함께 필요합니다.
Jev는 문장 대신 선택지와 확률을 반환합니다. 기존 모델의 제한된 출력과 무엇을 비교해야 하는지, 빠른 응답과 올바른 판단을 왜 나눠 봐야 하는지 살펴봅니다.