
고객이 "배송도 늦었고 사이즈도 틀렸는데, 카드에는 두 번 결제됐다"고 문의하면 담당 부서를 하나로 고르기 어렵다. 배송, 반품, 결제가 한 문장에 섞여 있다. PostHog 저장소에 공개된 Jeeves는 이런 선택 문제에서 답을 바로 고르는 대신, 질문마다 추론을 거친 뒤 선택지별 확률을 내놓는 AI 모델이다. Qwen3.5-9B를 바탕으로 만들었으며, 예·아니오 판단과 객관식 선택, 등급 평가를 한 요청에서 처리한다.
2026년 9월 30일 확인한 공개 자료에서 눈여겨볼 부분은 최고 정확도보다 설정에 따른 차이다. 같은 모델도 생각을 생략하면 빨리 응답하고, 길게 생각하면 일부 과제의 정답률이 올라간다. 고객 문의 분류나 승인 자동화를 설계하는 PM에게는 모든 요청을 한 방식으로 처리해야 할 이유가 줄어든다. 잘못 분류했을 때의 손실과 사용자가 기다릴 수 있는 시간을 업무별로 정할 수 있기 때문이다.
선택 전에 무엇을 더 하는가
Jev 계열 모델은 주어진 상태와 질문을 읽고, 미리 정한 선택지에 확률을 매기는 방식이다. Jeeves는 이 사이에 질문별 추론을 넣었다. 추론이 끝나면 질문과 선택지를 다시 제시하고, 선택지를 점수화하는 전용 구조로 답을 고른다. 자유로운 답변을 써 놓고 나중에 분류하는 대신, 마지막 출력은 정해진 선택지 안에 머문다.
README의 고객 문의 예시는 담당 부서, 긴급한 사람 개입의 필요성, 고객의 불만 정도를 동시에 묻는다. 응답에서 담당 부서는 billing(결제)으로 선택됐지만, 확률은 결제 0.46, 반품 0.40, 배송 0.14다. 결제를 골랐다는 결과만 보면 놓치기 쉬운 경합이다. 이런 문의를 곧바로 한 부서에 확정 배정할지, 사람이 확인하는 대기열로 보낼지는 제품 쪽의 규칙으로 남는다.
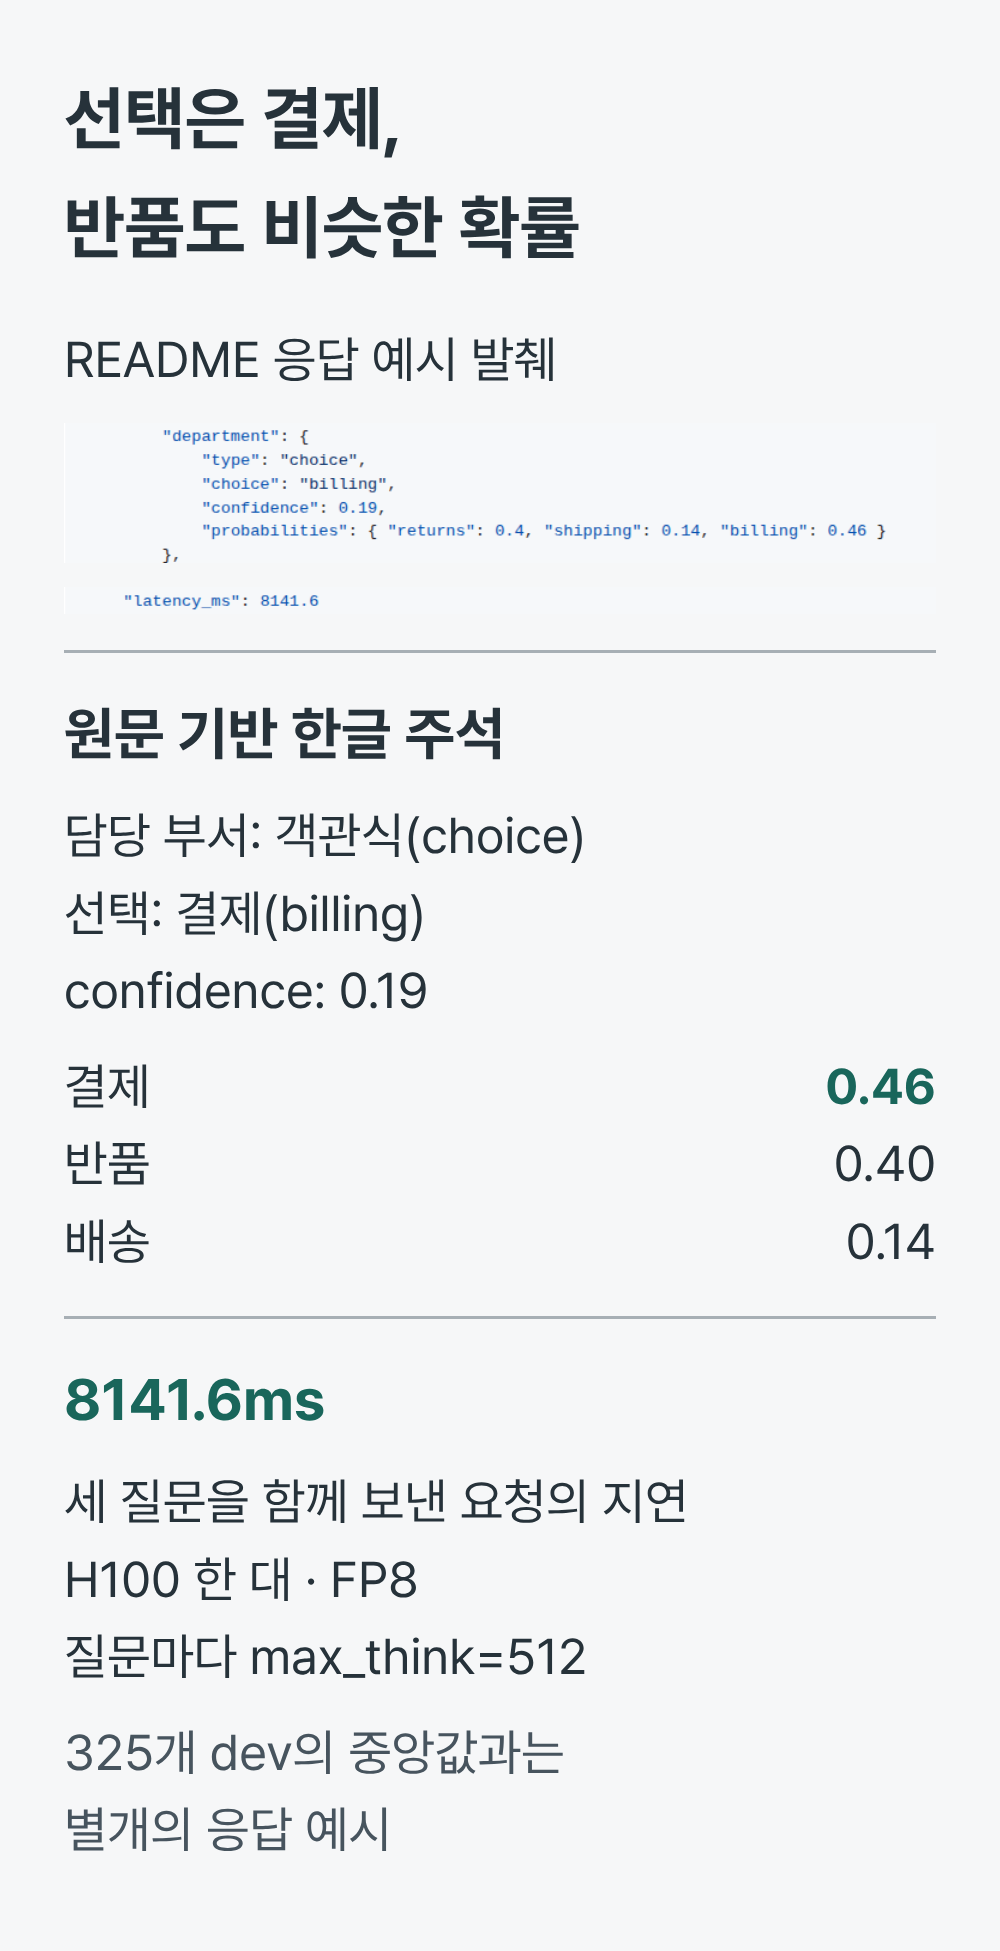
이 예시에 적힌 지연은 8141.6ms다. H100 한 대에서 FP8을 사용하고, max_think=512로 세 질문이 병렬 추론한 요청의 응답 값이다. 아래 개발용 평가의 중앙값 3.3초와는 측정 대상과 설정이 다르다. 질문 하나의 평균 시간으로 바꾸거나, 모든 고객 문의가 이 시간 안에 끝난다고 해석하면 안 된다.
정확도가 올랐다는 숫자는 같은 문제를 풀었는가
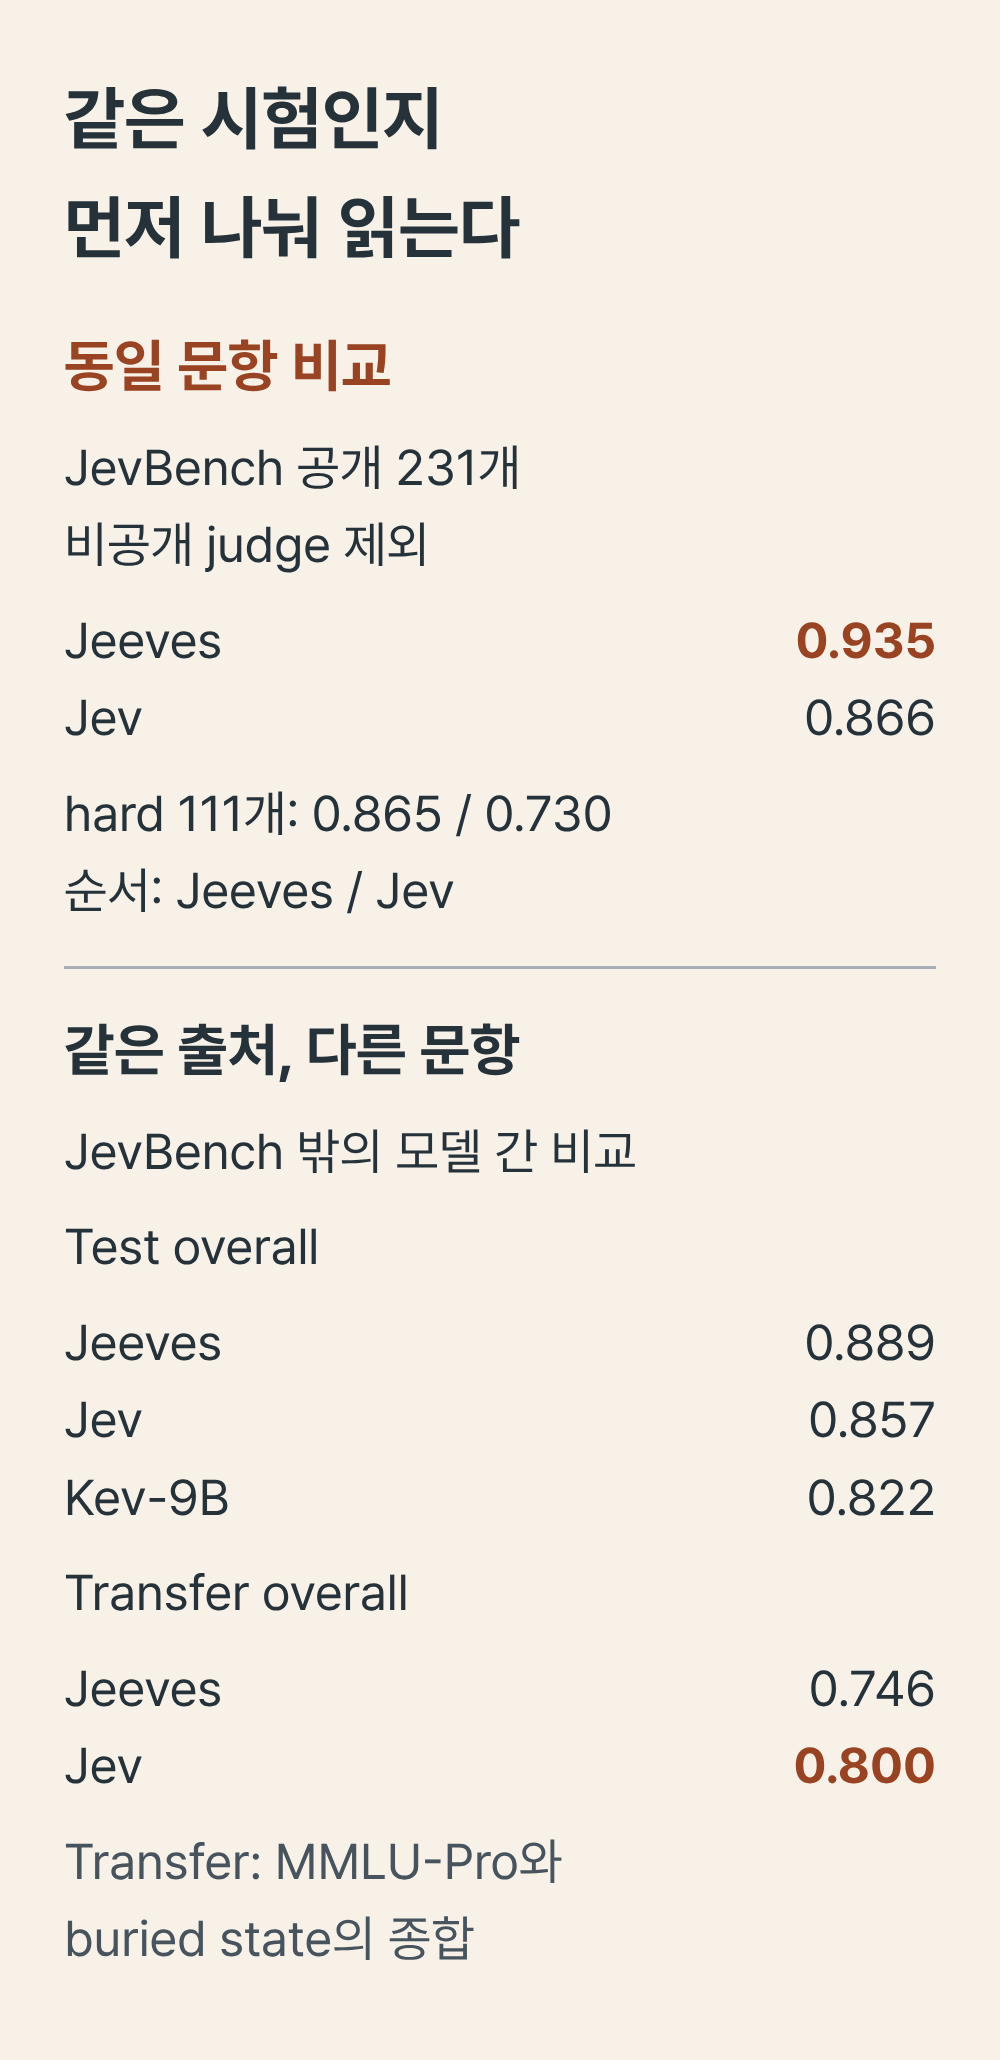
모델 간 비교에서 가장 분명한 조건은 JevBench의 공개 231개 문항이다. easy·standard·hard 구간의 같은 문항으로 제한한 정확도는 Jeeves 0.935, Jev 0.866이다. 이 중 hard 111개에서는 각각 0.865와 0.730이다. 비공개 judge 구간은 포함하지 않았다. Kev의 JevBench 수치는 9B 모델이 아니라 Qwen3 기반 Kev-8B의 결과다.
README의 다른 종합 비교에는 조건 차이가 있다. Test overall은 Jeeves 0.889, Jev 0.857, Kev-9B 0.822지만, JevBench 밖의 모델 간 비교는 같은 데이터 출처에서 서로 다른 문항을 사용했다. 따라서 이 숫자만으로 같은 시험에서 Jeeves가 두 모델을 이겼다고 말할 수 없다. MMLU-Pro와 buried state를 묶은 Transfer overall에서는 Jeeves 0.746보다 Jev 0.800이 높다. 생각을 더 한다고 모든 종류의 문제가 좋아지는 것도 아니다.
추론 자체의 효과를 보려면 같은 체크포인트의 켜기·끄기 비교가 더 가깝다. Jeeves 자체 테스트 분할 2,962개 문항에서는 추론 없이 0.804, 추론을 켜면 0.840이다. 이 역시 앞의 Test overall 0.889와 별개로 제시된 평가다. 모델 간 종합 비교, 같은 모델의 테스트 비교, 운영 설정을 고르는 개발용 비교를 한 표의 연속된 개선 단계로 읽으면 수치를 잘못 쓰게 된다.
얼마나 기다리면 어느 정도 나아지는가
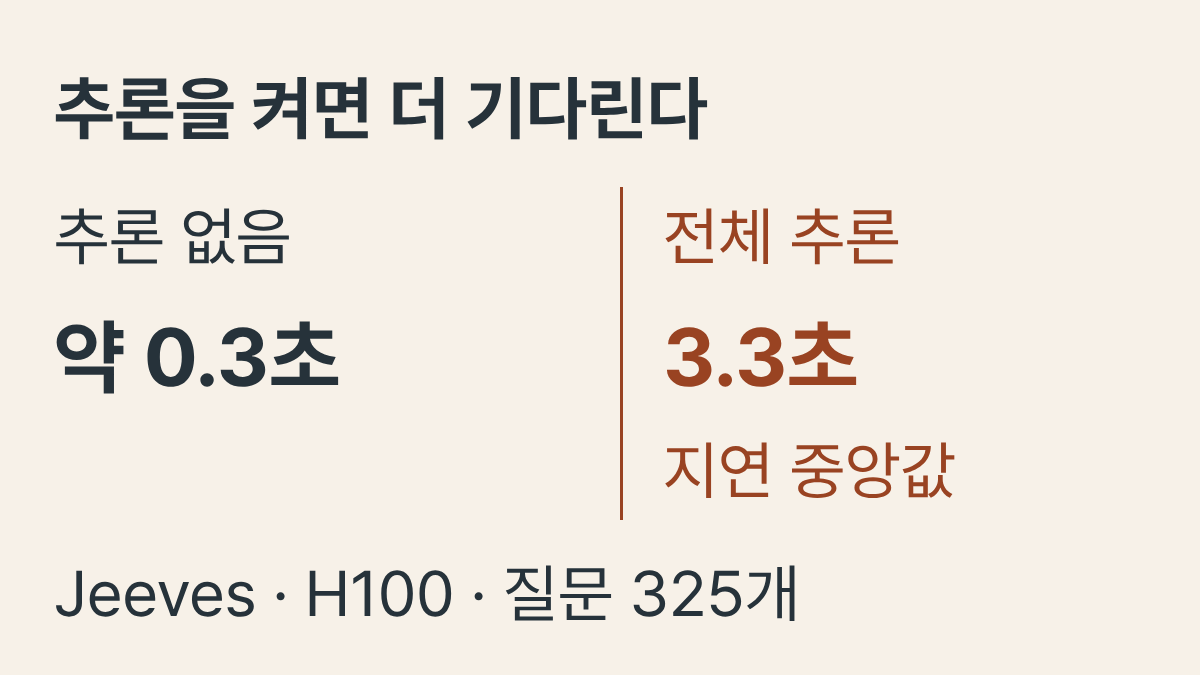
H100 한 대에서 개발용 질문 325개로 비교한 결과는 운영 설정의 선택에 도움이 된다. 전체 추론은 정확도 0.825, 지연 중앙값 3.3초, p90 17.1초다. p90은 응답의 90%가 그 시간 이하였다는 뜻이다. 사용자가 느끼는 대기시간을 중앙값 하나로 정하면 느린 쪽 요청을 놓친다.
max_think=768과 nothink_threshold=0.9를 함께 쓰면 정확도는 0.806, 지연 중앙값은 2.0초, p90은 5.6초다. 추론 길이를 제한하고, 추론 없는 경로의 confidence가 기준 이상인 질문은 생각을 생략한다. 평균 추론 토큰도 전체 추론의 1,138개에서 344개로 줄었다. 추론을 전혀 하지 않을 때는 정확도 0.775, 지연 약 0.3초다. 원문은 이 0.3초에 중앙값과 p90을 따로 적지 않았다.
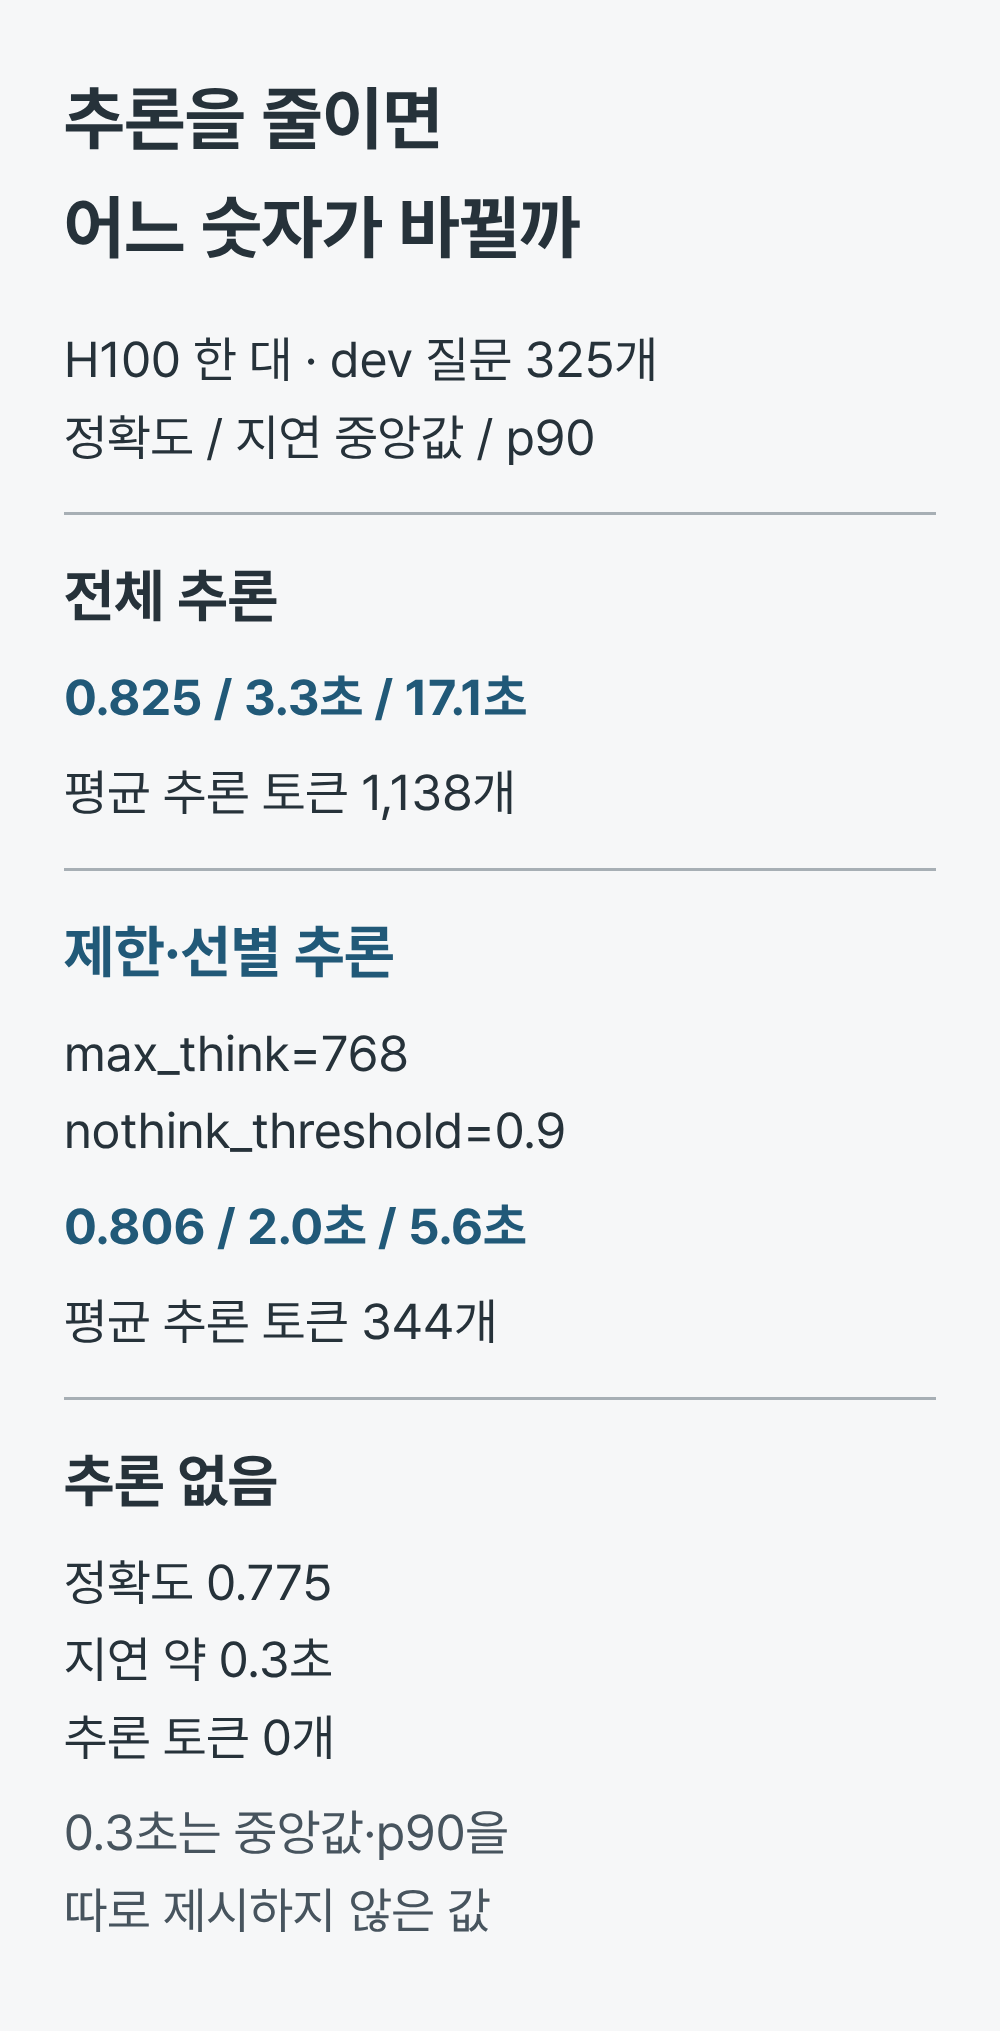
제한·선별 설정은 전체 추론보다 정답률이 낮지만 느린 요청의 대기시간도 짧다. 이 결과를 고객 상담 화면에 적용한다면, 즉시 다음 화면을 띄워야 하는 분류와 뒤에서 처리해도 되는 검토를 나눠 실험할 수 있다. 모델이 내놓는 확률과 confidence는 이름이 다른 필드이므로, 최상위 선택 확률을 그대로 생략 기준이라고 가정하지 않고 실제 응답과 설정을 맞춰 봐야 한다.
문의 분류와 승인 자동화에 같은 기준을 쓰지 않는다
제품 설계에 적용해 보면, 잘못 배정해도 다른 팀으로 쉽게 옮길 수 있는 문의는 빠르게 분류한 뒤 사람이 수정하는 비용을 감수할 수 있다. 잘못 승인하면 돈이나 권한이 바로 나가는 업무는 몇 초를 더 기다릴 가치가 있을 수 있다. 이때 추론을 켜는 것과 실제 승인 권한을 주는 것은 따로 결정한다.
도입 시험에서는 실제 문의와 정책 예외를 모아 같은 문항으로 설정을 비교하는 편이 낫다. 정답률과 p90 대기시간을 재고, 긴급 문의를 놓친 비율과 사람에게 넘긴 건수도 확인한다. 모델 카드의 평가는 영어 입력에 한정돼 있으므로 한국어 문의는 별도 평가가 필요하다.
추론 내용이 필요하면 return_reasoning으로 질문별 텍스트를 받을 수 있다. 개발자는 학습에 언어 일관성 보상을 넣지 않아 추론을 해석하기 어렵다고 적었다. 승인 이유를 고객에게 설명하는 문장은 이 텍스트를 그대로 노출하기보다, 실제 적용한 정책과 확인한 사실로 별도 구성할 필요가 있다. 도입 전에 추론 시간의 상한과 사람이 검토할 답의 조건을 정해 두면, 지연 설정과 승인 규칙을 함께 시험할 수 있다.