
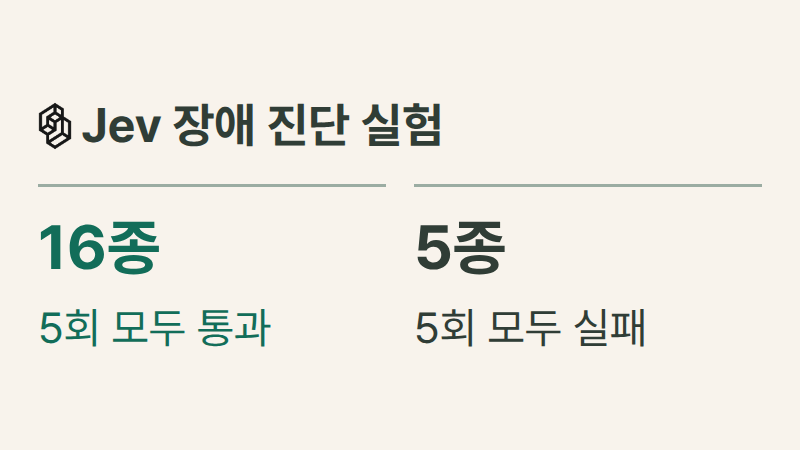
SREGym 연구진이 10월 6일 공개한 실험에서는 자료 수집을 코드에 맡기고, 원인 후보와 증거를 고르는 일만 TypeSafe의 판단 모델 Jev에 맡겼다. 21가지 장애를 각각 다섯 번 진단한 결과 105회 중 80회가 채점 기준을 통과했다. 전체 Jev 추론비 추정치는 0.15달러, 진단 시간 중앙값은 14.6초였다.
서비스 운영자와 PM은 이 결과로 1차 진단의 범위를 가늠해 볼 수 있다. 관측자료와 선택지를 먼저 준비했을 때 어떤 사건을 빠르게 분류할 수 있고, 어떤 사건에서 조사가 막히는지가 드러났다. 성공한 사례에서도 수집기가 이미 상당한 원인 분석을 해놓았다.
메모리 부족을 맞힌 것은 모델일까, 수집기일까
이번 파이프라인에는 명령을 만들고 실행하는 범용 언어모델 에이전트가 없다. 수집기가 Kubernetes의 설정 객체, 이벤트, 최근 실행 로그와 자원 사용량을 읽는다. Kubernetes는 여러 서비스를 컨테이너로 배치하고 관리하는 시스템이다. 수집기는 서비스 구성요소별로 이상 징후를 요약하고, Jev는 주어진 선택지에서 조사할 대상을 고른다. 이후 수집기가 그 대상의 상세 자료에 번호를 붙이면 Jev는 원인인지, 다른 장애의 피해자인지, 무관한지 판단하고 제출할 증거를 선택한다. 최종 보고서는 코드가 조립한다.
Social Network 애플리케이션에서는 nginx-thrift 컨테이너가 메모리 부족으로 종료되고 재시작했다. 배포 설정인 Deployment 템플릿에는 메모리 한도가 256Mi로 적혀 있었지만 실제 실행 단위인 Pod에는 16Mi만 적용됐다. Pod를 생성할 때 설정을 바꾸는 웹훅이 한도를 덮어쓴 것이다. 웹훅 설정은 다른 네 개도 있어 이름만 찾아서는 범인을 고를 수 없었다.
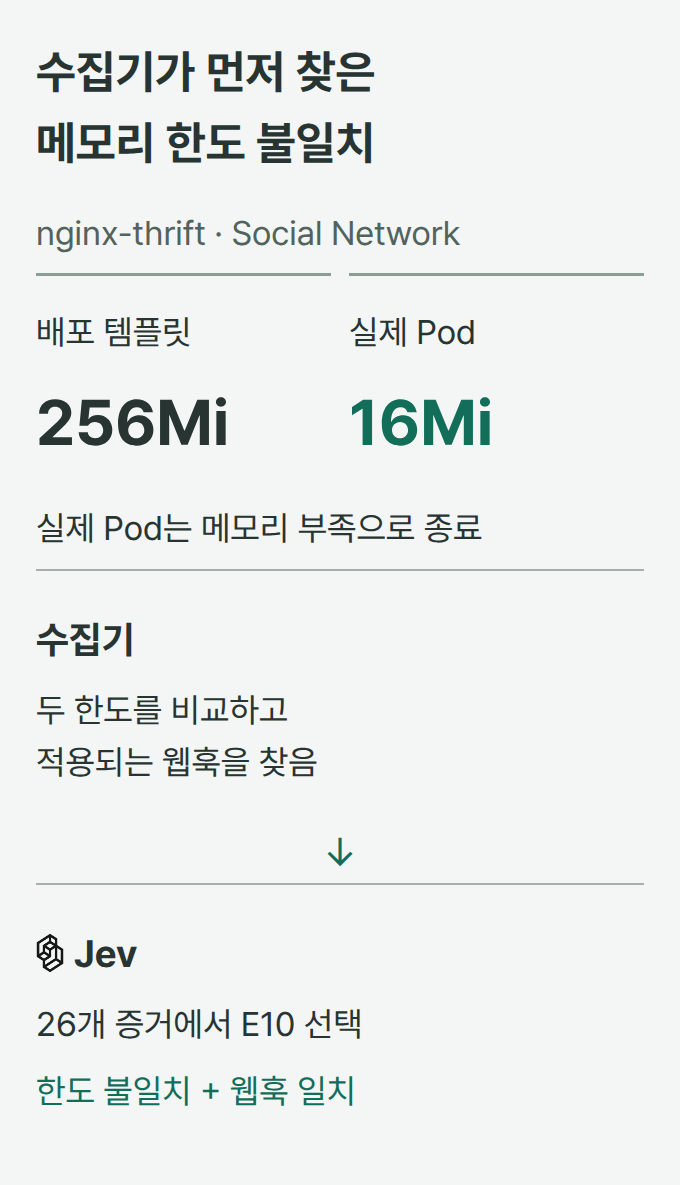
수집기는 27개 Deployment를 살핀 뒤 이 불일치와 해당 Pod에 적용되는 웹훅을 찾아 Jev에 전달했다. Jev가 받은 상세 증거는 26개였다. 모델은 메모리 부족 종료 기록인 E6보다, 한도가 다르고 웹훅이 일치한다는 E10을 원인 설명의 증거로 골랐다. 파이프라인은 그 선택으로 웹훅을 원인 객체로 지목했고, 이 장애의 다섯 번 진단은 모두 통과했다. 설정 비교와 웹훅 후보 축소는 수집기가 했고, Jev는 그 결과에서 대상과 증거를 골랐다. 이 역할 분담을 빼면 모델의 성능을 과대평가하게 된다.
15센트에는 어디까지의 비용이 들어 있나
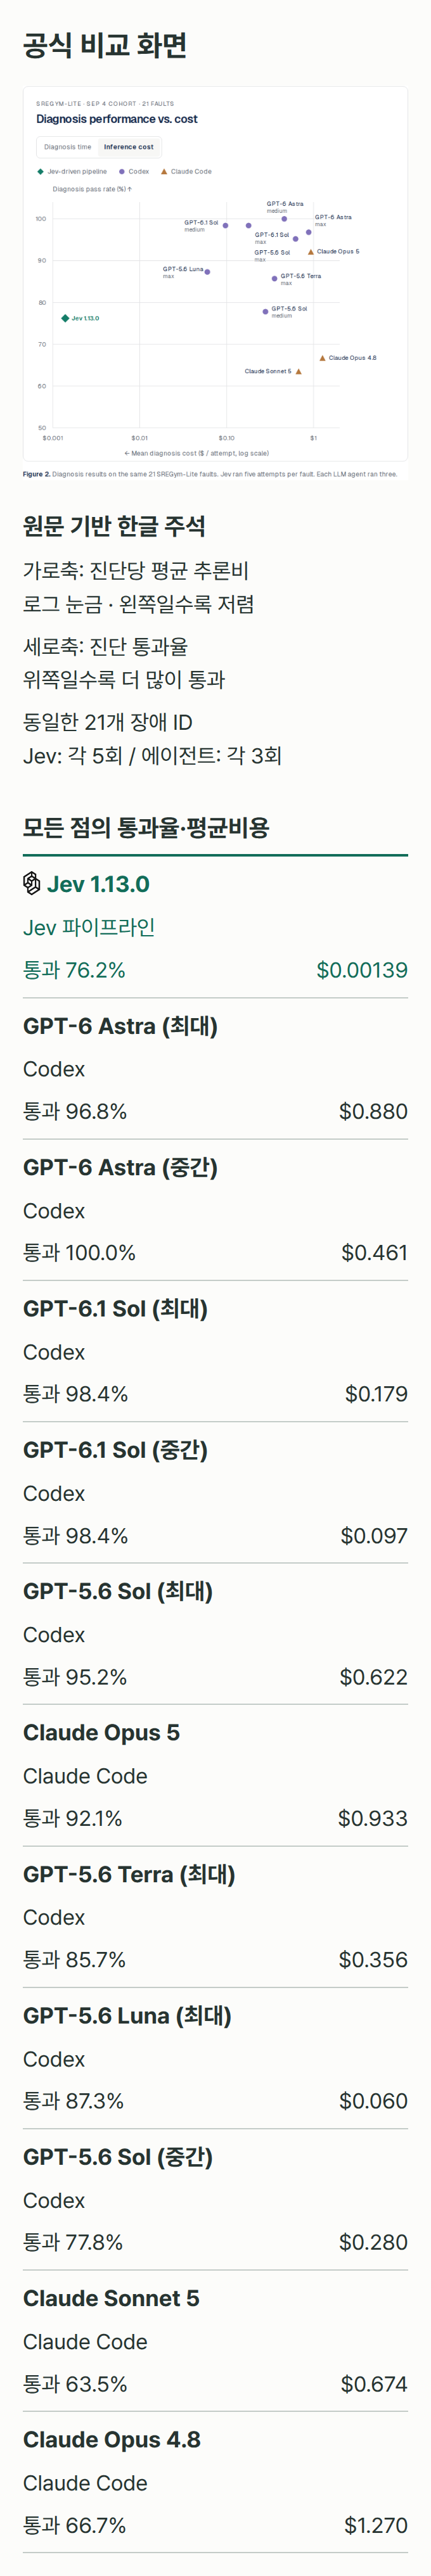
실험은 jev-1.13.0으로 진행했다. 9월 4일 기준 SREGym-Lite의 21개 장애 묶음을 사용했으며 현재 리더보드의 평가 묶음과는 다르다. 제출한 진단은 gpt-6-astra의 높은 추론 설정으로 채점했다. 질문 아홉 개로 구성한 진단 평가에서 0.70 이상을 통과로 봤다. 76.2%는 이 조건에서 보고서가 통과한 비율이지, 장애를 복구한 비율이 아니다.
Jev 호출은 총 252회, 진단 시도당 평균 2.4회였다. 입력 토큰은 348만 개다. TypeSafe가 공개한 입력 100만 토큰당 0.042달러를 적용하면 약 0.146달러여서 원문은 0.15달러로 표기했다. 출력 토큰은 무료다. 이 금액의 범위는 Jev 추론비다. 관측자료 수집과 클러스터 운영, 수집기 개발·유지보수, 채점 모델 사용 비용까지 포함한 운영 총액으로 읽으면 안 된다.
진단 한 번에 쓴 Jev API 지연시간 합계의 중앙값은 0.53초였지만 전체 진단 중앙값은 14.6초였다. 두 중앙값의 차이가 곧 수집 시간은 아니다. 전체 진단 시간을 줄이려면 판단 API와 함께 자료를 가져오고 정리하는 경로도 살펴야 한다.
원문은 같은 21개 장애 ID를 사용한 별도 에이전트 실험과도 비교했다. GPT-5.6 Sol의 중간 추론 설정은 통과율 77.8%였고 Jev는 76.2%였다. 비교 화면의 평균값으로는 Jev가 약 7배 빠르고 진단당 추론비가 약 200분의 1이었다. Jev는 장애마다 다섯 번, 범용 에이전트는 세 번 시도한 비교다. 비교 대상 중에는 Jev보다 더 높은 통과율을 기록한 범용 모델도 있었다.
증거를 잘못 고른 실패와, 증거가 없던 실패
결과는 장애별로 갈렸다. 16개 장애는 다섯 번 모두 통과했고 나머지 5개는 다섯 번 모두 실패했다. 같은 구성을 반복 실행해서 실패가 우연히 사라지는 모습은 없었다. 연구진은 실패 기록에서 서로 다른 두 문제를 짚었다.
Astronomy Shop에서는 특수하게 만든 요청이 frontend-proxy의 비싼 정규식 검사를 유발해 CPU를 소진하고 시간 초과를 일으켰다. 수집기는 정규식 규칙 추가(E7)와 CPU 한도를 100m으로 바꾼 기록(E8)을 모두 제공했다. Jev는 다섯 번 모두 E8을 골라 CPU 한도를 원인으로 설명했다. 위치와 영향 범위는 맞혔지만 장애를 일으킨 필터 규칙을 놓쳐 점수 0.67로 실패했다. 필요한 단서가 있어도 잘못 고를 수 있었다.
Hotel Reservation에서는 잠깐 늘어난 검색 요청이 rate 서비스의 대기열을 채웠다. 호출 시간이 초과되자 search가 재시도했고, 새로 유입되는 트래픽이 정상으로 돌아온 뒤에도 재시도가 부하를 유지했다. Jev는 다섯 번 모두 rate의 초당 20개 요청 한도에 집중해 과부하만 설명하고 대기열·시간 제한·재시도의 반복을 놓쳤다.
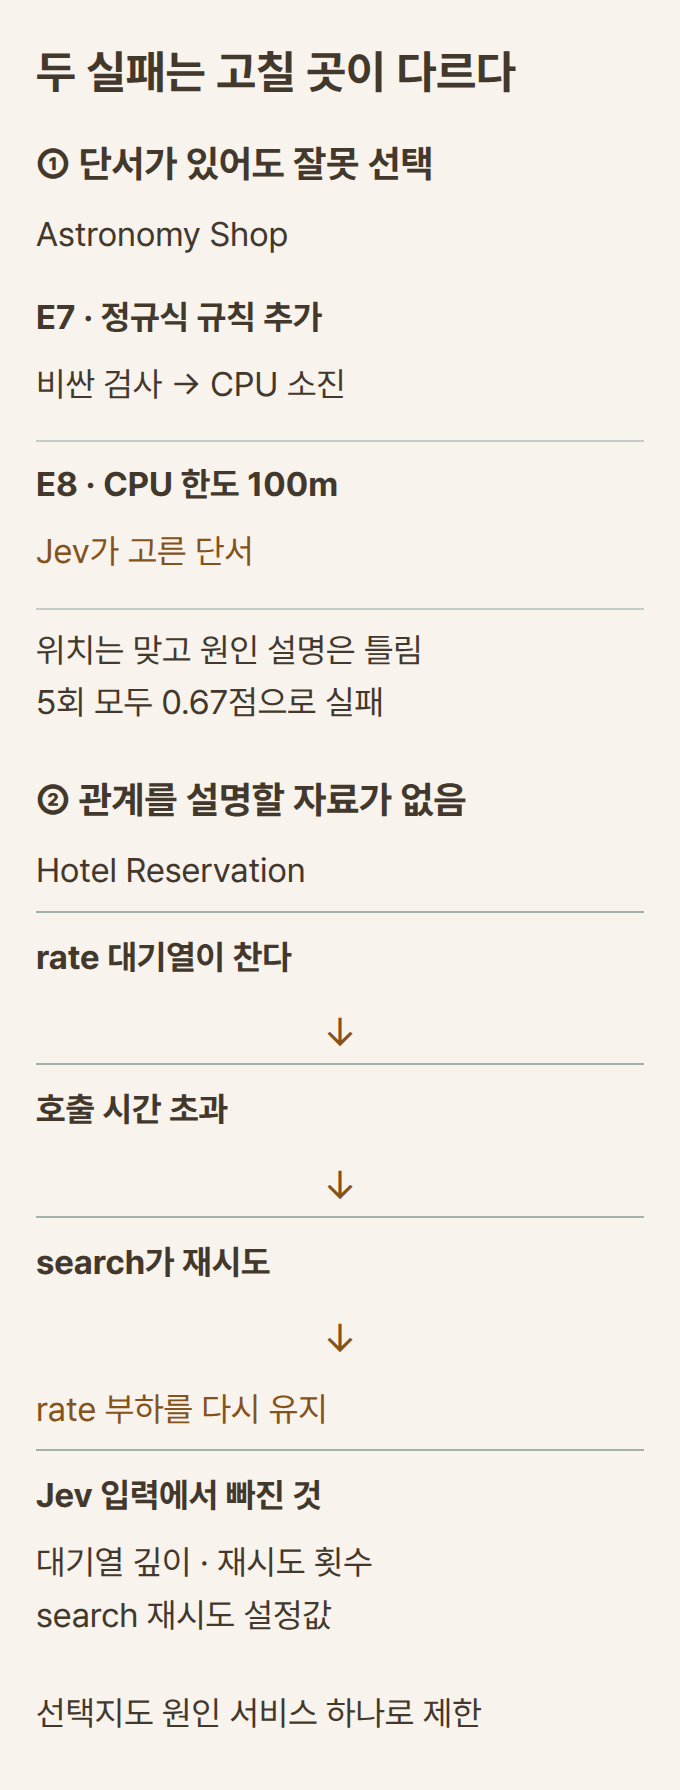
두 번째 실패에서는 관측 범위부터 부족했다. 넓은 요약에는 search의 재시도 설정 이름만 있고 값이 없었다. 파이프라인은 search를 자세히 조사하지 않았으며 Jev 입력에는 대기열 깊이나 재시도 횟수 지표도 없었다. 답은 원인 구성요소 하나를 고르게 돼 있었다. 두 서비스의 상호작용이 원인인 사건을 단일 서비스 문제로 좁힌 셈이다. 첫 실패는 증거 선택을 개선해야 하고, 두 번째는 수집자료와 답의 구조를 바꿔야 한다.
어떤 사건을 저비용 진단으로 먼저 보낼까
이 결과를 운영 설계에 옮긴다면, 설정과 실행 상태의 차이를 비교할 수 있고 원인 후보가 충분히 준비된 사건부터 저비용 판단 경로에 넣어볼 수 있다. 모델의 답과 함께 선택한 증거 번호를 남기면 운영자가 그 판단을 되짚기도 쉽다. 원문처럼 구성요소를 하나씩 보는 방식이 맞는 사건에서는 매번 범용 에이전트가 새 조사 명령을 만들 필요가 줄어든다.
여러 서비스가 얽히거나 시간이 지나면서 원인이 드러나는 사건은 심층 조사로 넘기는 쪽이 맞다. 트래픽이 줄어도 부하가 남고, 원인 후보의 증거만으로 설명이 안 되거나, 대기열·재시도 측정값이 빠져 있다면 같은 입력으로 판단만 반복하는 대신 관측 범위를 넓혀야 한다. 연구진도 요청 단위 신호와 시간에 따른 지표를 모으고 여러 구성요소를 연결하는 진단으로 확장하겠다고 밝혔다.
PM이 비용을 검토할 때는 판단 호출 단가와 별도로 수집기 유지비를 잡아야 한다. 서비스가 바뀌면 읽을 설정과 로그, 준비할 선택지도 달라진다. 운영팀은 저렴한 1차 분류가 틀렸을 때 어떤 자료를 더 모으고 누구에게 넘길지 정해야 한다. 이 실험에서 검증한 것은 진단 보고서까지다. 자동 복구 권한은 별도의 설계와 검증이 필요하다.
출처: SREGym, Jev-Driven SRE Diagnosis: What Worked and What Failed · TypeSafe 모델·가격 문서