
AI가 낸 분류 결과를 어디까지 믿을지는 샘플을 직접 채점해 판단할 수 있다. 그러나 그 결과로 고객에게 문장을 보여 주거나, 결제·계정 변경을 실행하고, 다른 시스템으로 데이터를 보내기 시작하면 다음 질문이 남는다. 실패했을 때 무엇이 일어났는지 되짚고, 누가 멈추고 고칠지까지 설계되어 있는가다.
패트릭 시아의 글 The Normalization of Inexplicable Failures은 이 문제를 ‘설명할 수 없는 실패의 일상화’로 부른다. 일반 소프트웨어의 버튼이 고장 나면 사용자에게는 원인이 보이지 않아도, DNS·코드·연동·배포 중 어느 계약이 깨졌는지 추적할 담당자와 경로가 있다고 기대한다. AI가 답을 틀렸다는 말로 조사와 책임이 끝나는 순간, 그 기대가 약해진다.
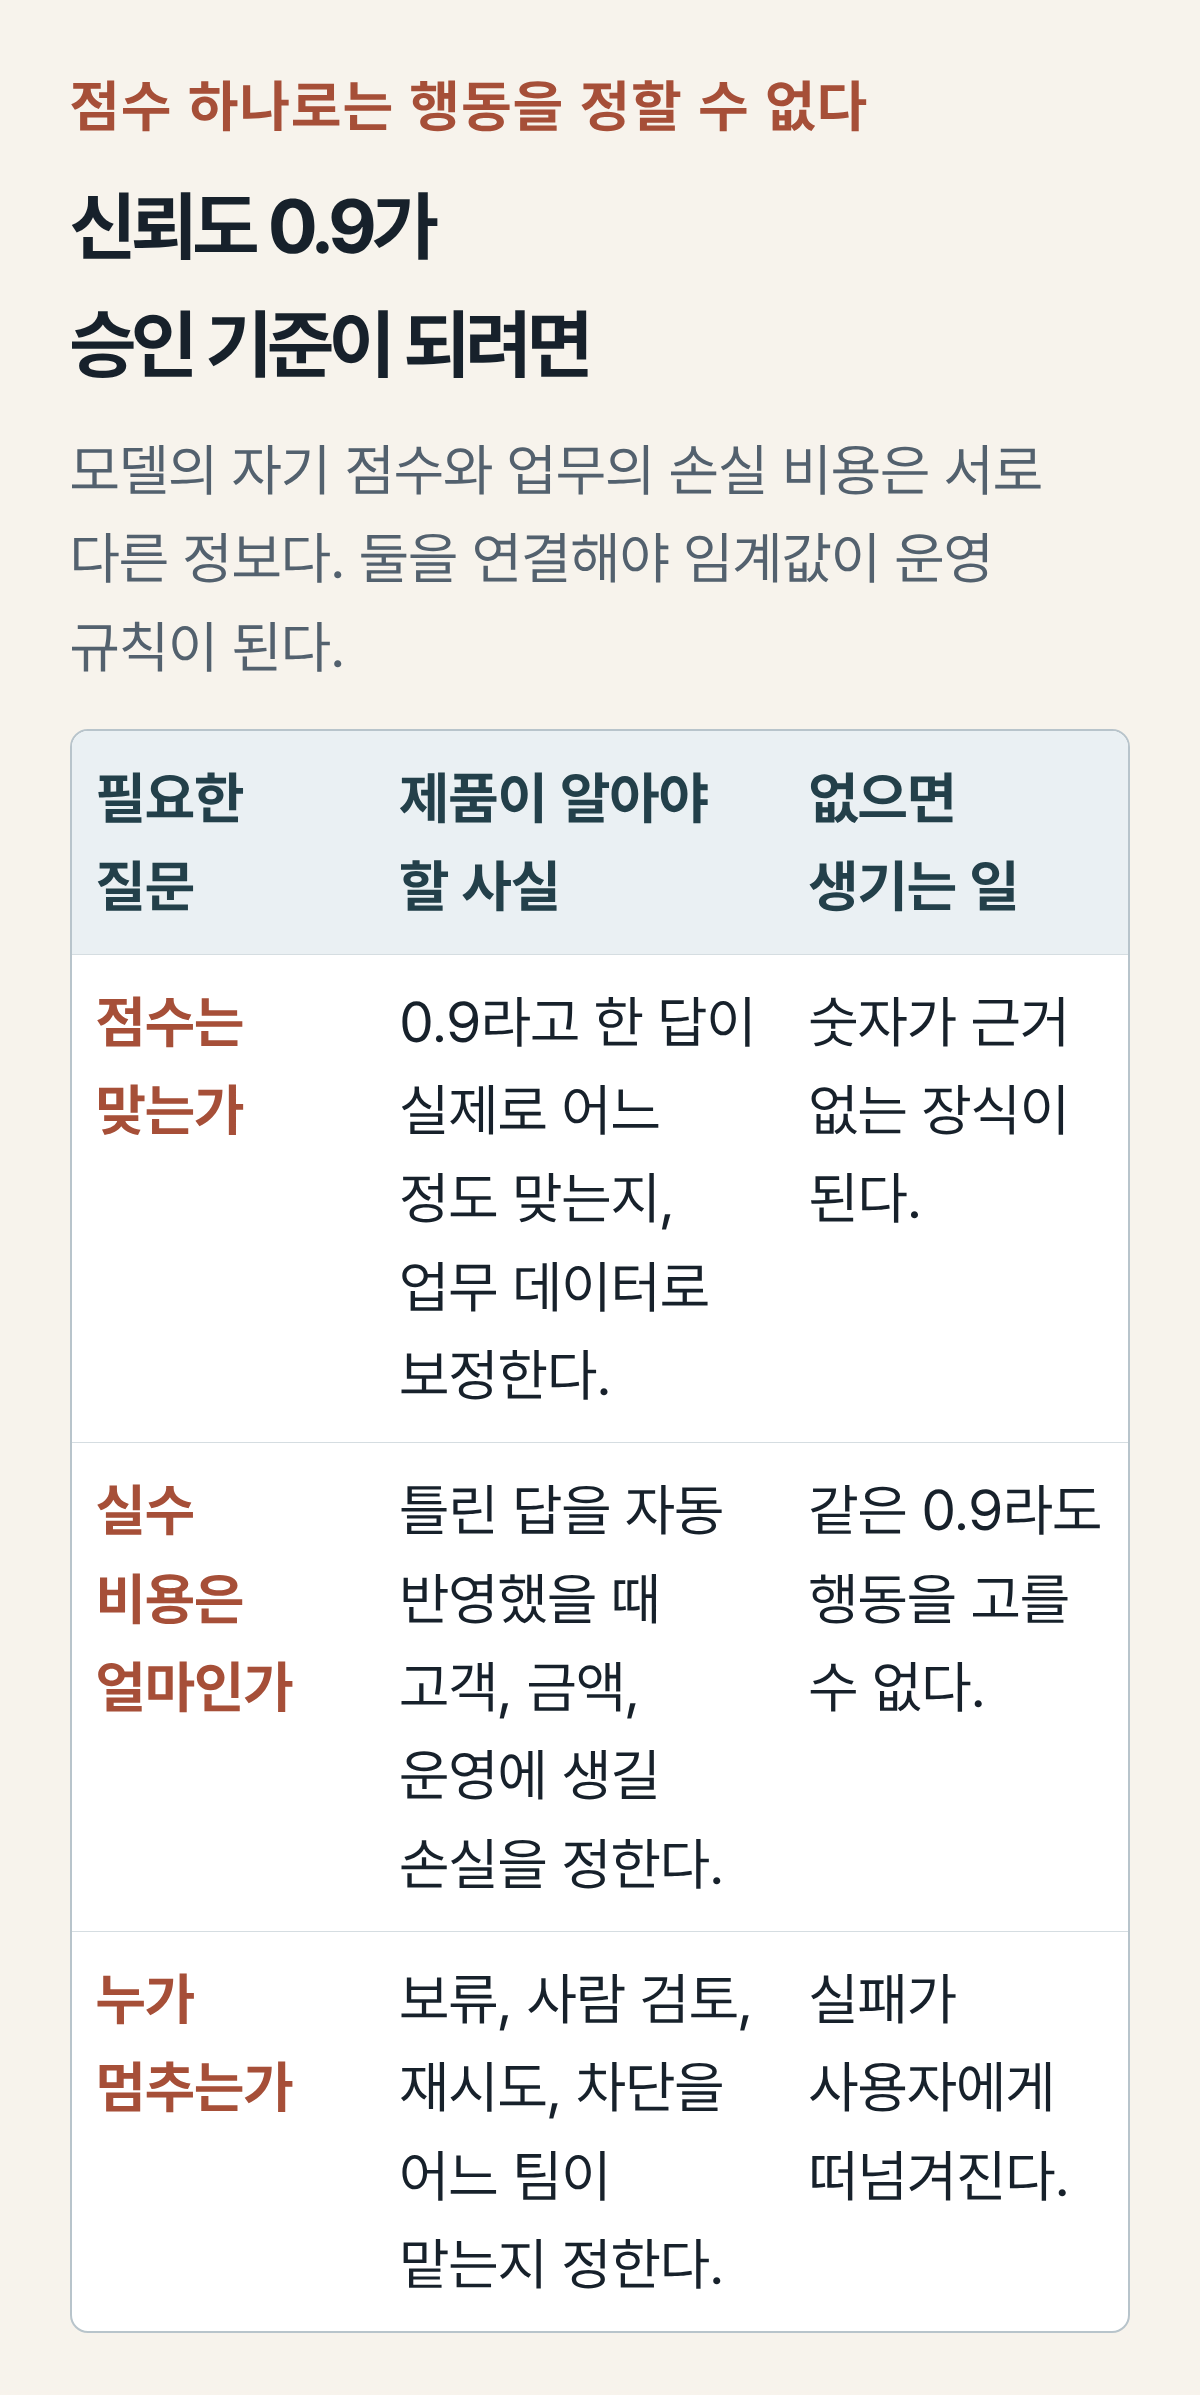
신뢰도 점수는 왜 승인 기준이 될 수 없나
원문은 TypeSafe AI의 Jev를 예로 든다. Jev는 확률 추정치를 포함한 타입 값을 반환하는 모델로 소개되지만, 점수가 있다고 해서 곧바로 행동 규칙이 생기지는 않는다. ‘신뢰도 0.9 이상이면 승인’이라는 문장을 쓰려면 적어도 두 가지를 알아야 한다. 0.9라는 점수가 실제 업무 데이터에서 어느 정도 맞는지, 그리고 틀린 답을 자동 적용했을 때 손실이 얼마인지다.

예를 들어 고객지원 답변을 사람이 검토하는 기능과 환불을 자동 실행하는 기능은 같은 점수라도 허용할 수 있는 오류가 다르다. 원문이 지적하듯 모델 문서의 임계값 예시는 특정 도메인의 정답이 아니다. 제품팀은 보정된 평가 세트와 손실 기준을 묶어 보류·재시도·사람 검토·차단의 경계를 정해야 한다.
실패 로그에는 모델 이름보다 처리 경로가 필요하다
AI 기능에서 오류가 나면 모델 제공사의 이름이나 ‘환각’이라는 라벨을 먼저 붙이기 쉽다. 하지만 운영에 필요한 질문은 더 구체적이다. 어떤 입력과 모델 버전에서, 어떤 점수와 정책을 거쳐, 어떤 행동이 실행됐는가. 실패 원인이 모델 자체인지, 오래된 데이터인지, 잘못 세운 승인 정책인지, 외부 연동인지 구분할 수 있어야 다음 조치가 달라진다.
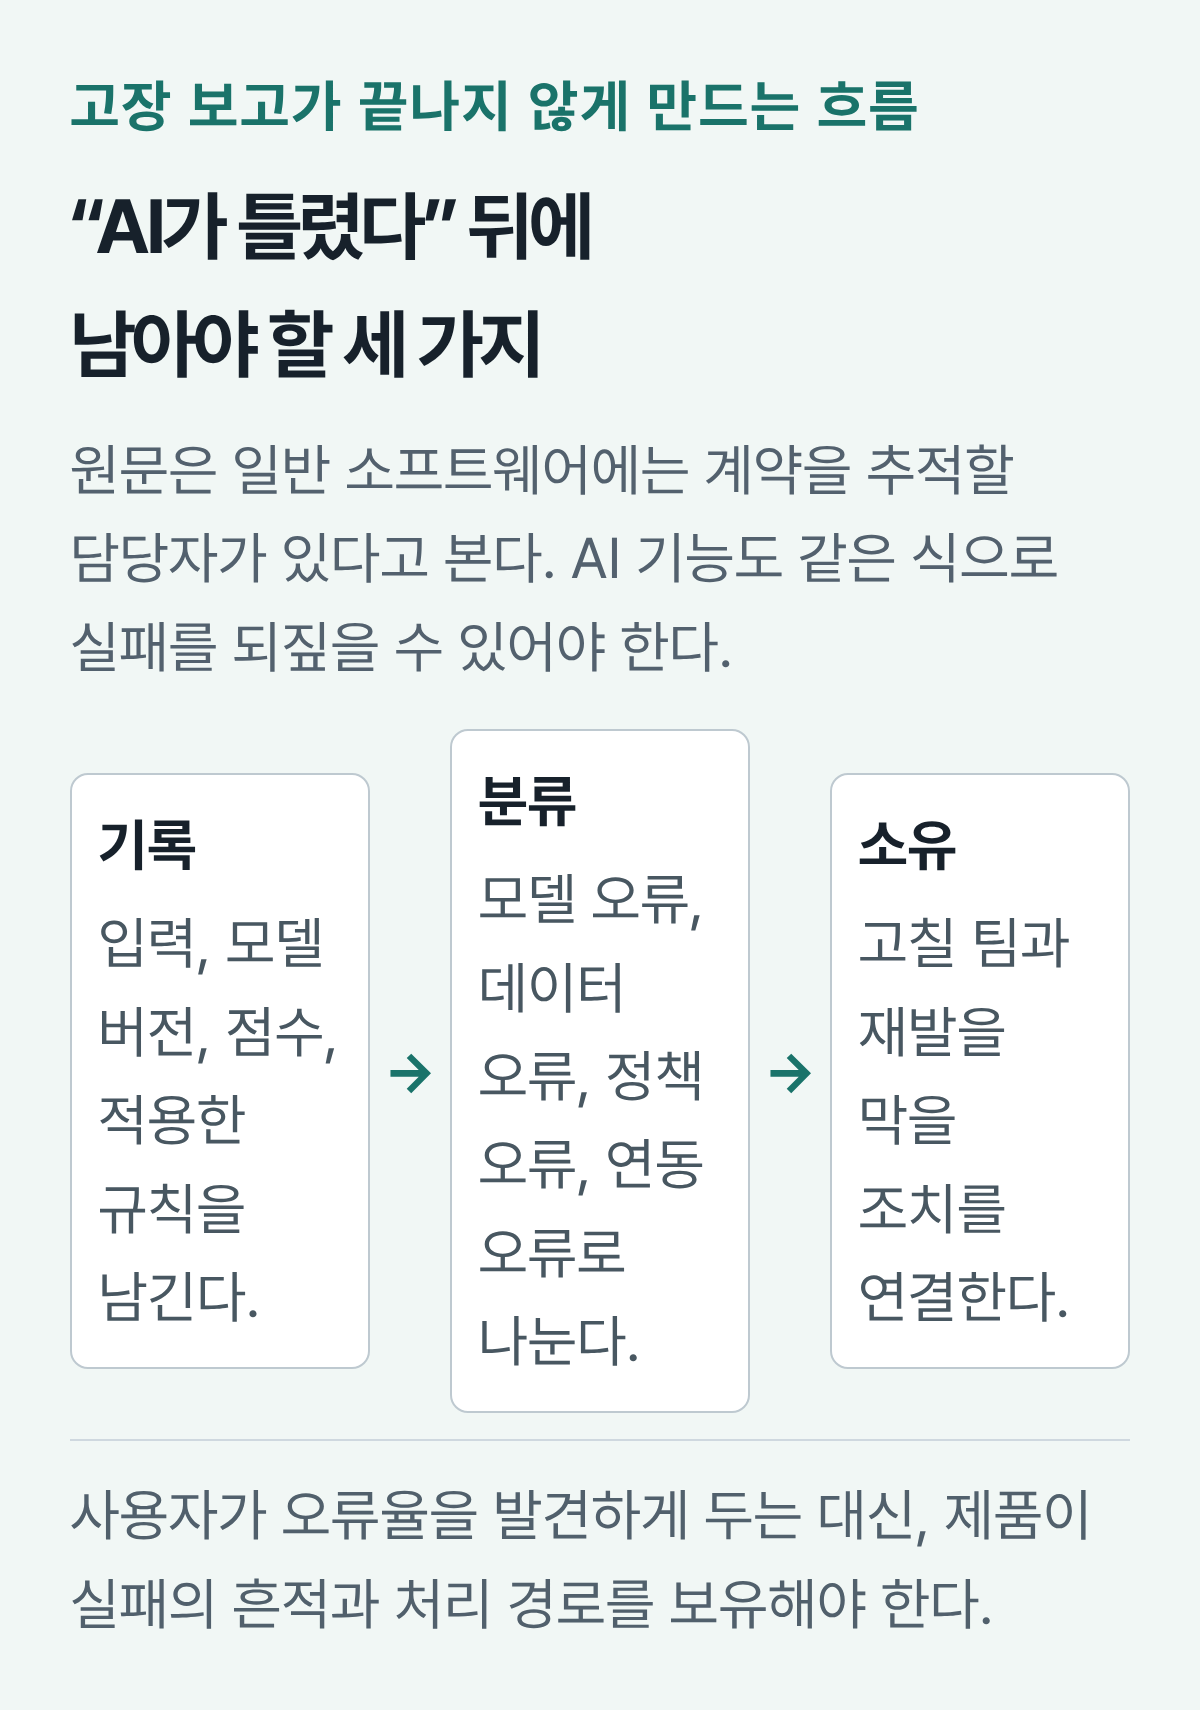
여기서 ‘소유’는 한 팀을 탓하는 절차가 아니다. 고칠 팀, 일시 중단을 결정할 사람, 재발 방지 조치를 연결하는 일이다. 이 연결이 없으면 사용자는 오류율을 발견하는 시험자가 되고, 고객 대응팀은 왜 그런 결과가 나왔는지 알 수 없는 답변을 반복하게 된다. 오류 기록에는 입력 전문을 무조건 쌓기보다 개인정보와 민감정보를 분리·보호하는 기준도 함께 필요하다.
빠른 출시를 지키면서 책임 구조를 만드는 법
책임 구조는 출시를 늦추기 위한 추가 문서가 아니다. 위험한 행동부터 나누면 범위를 줄일 수 있다. 외부 전송, 금액 변경, 계정 권한처럼 되돌리기 어려운 동작에 먼저 중단 규칙과 사람 검토를 붙이고, 안내 문구나 내부 초안처럼 영향이 작은 기능에는 더 가벼운 규칙을 둘 수 있다.
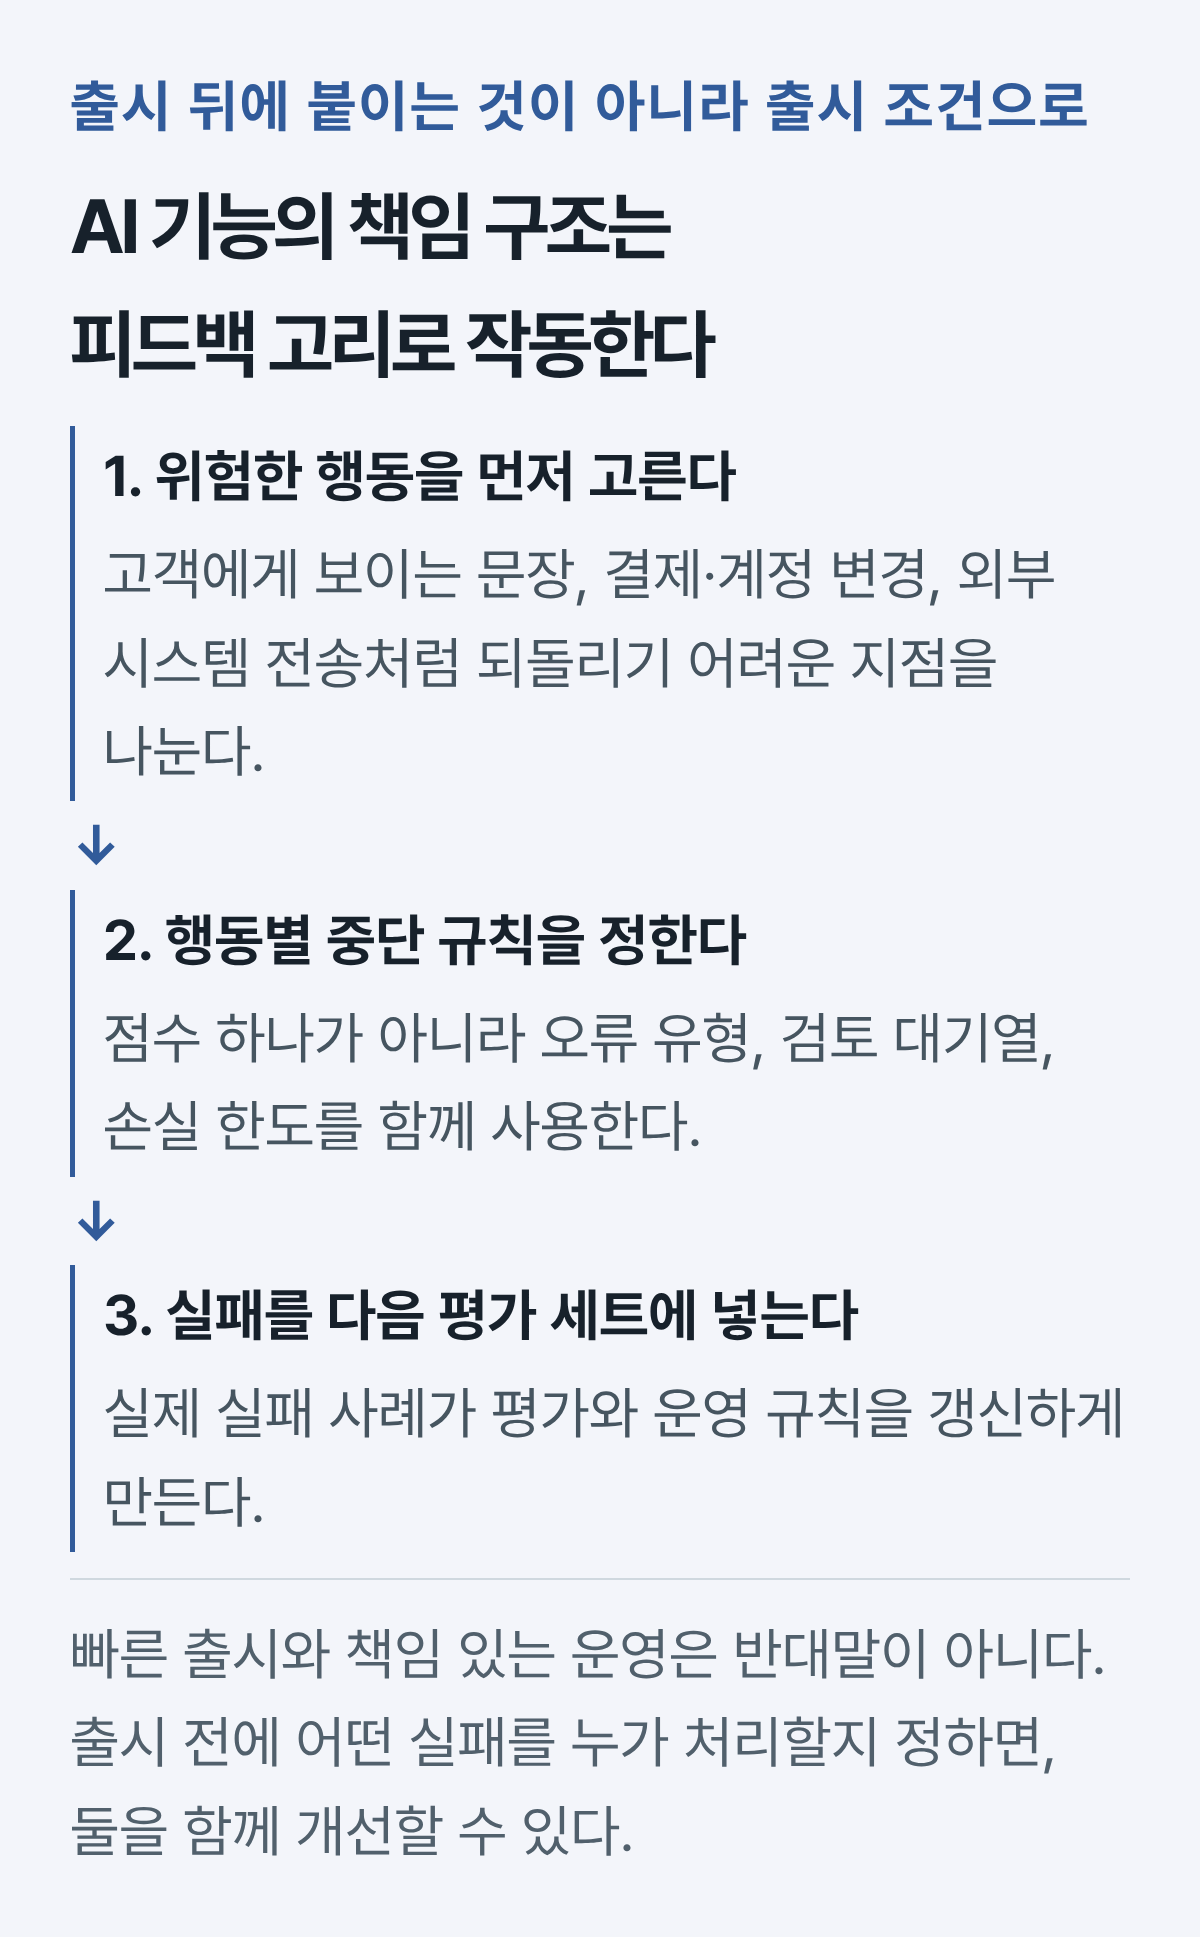
제품 기획 단계에서 남길 질문도 단순하다. 이 기능이 실행할 수 있는 가장 위험한 행동은 무엇인가. 그 행동을 보류할 신호는 무엇인가. 장애가 났을 때 입력과 정책을 조회할 권한은 누가 갖는가. 이 세 질문에 답하면 평가 범위와 운영 대시보드에 필요한 항목이 자연스럽게 드러난다.
핵심은 실패를 예외 보고서에 가두지 않는 데 있다. 실제 실패 사례를 평가 세트에 넣고, 임계값과 정책을 다시 조정하며, 바뀐 규칙이 현장에서 작동하는지 확인하는 고리가 있어야 한다. 원문도 LLM이 개발과 QA를 빠르게 만들 수 있다는 가능성을 인정한다. 그 속도를 실패 조사의 생략에 쓰지 않고, 평가와 자동화된 점검을 만드는 데 쓰는 편이 제품과 사용자 모두에게 낫다.
출처: i hate the future, The Normalization of Inexplicable Failures