
고객이 “결제가 두 번 됐다”고 말했을 때 필요한 것은 그 문장을 더 길게 요약하는 답이 아닐 수 있다. 결제팀, 배송팀, 기술지원팀 가운데 어디로 보낼지를 고르는 일이라면, 프로그램은 설명문 대신 정해진 선택지와 그 선택의 확률을 받는 편이 낫다.
이런 선택형 AI가 주목받는 이유는 자동화의 범위가 넓어졌기 때문이다. 문의 분류, 계약 조항 판별, 콘텐츠 검수처럼 같은 결정을 하루 수천 번 내려야 하면, 매번 JSON과 설명을 길게 생성한 뒤 다시 해석하는 비용이 쌓인다. 이미 AI가 문장 대신 선택지만 고를 때 가능한 일을 다뤘지만, 이번 사례는 범용 LLM을 별도 학습 없이 그 역할에 쓸 수 있는지 숫자로 비교했다는 점에 의미가 있다.
문장을 만들지 않고 선택지의 가능성만 읽는다
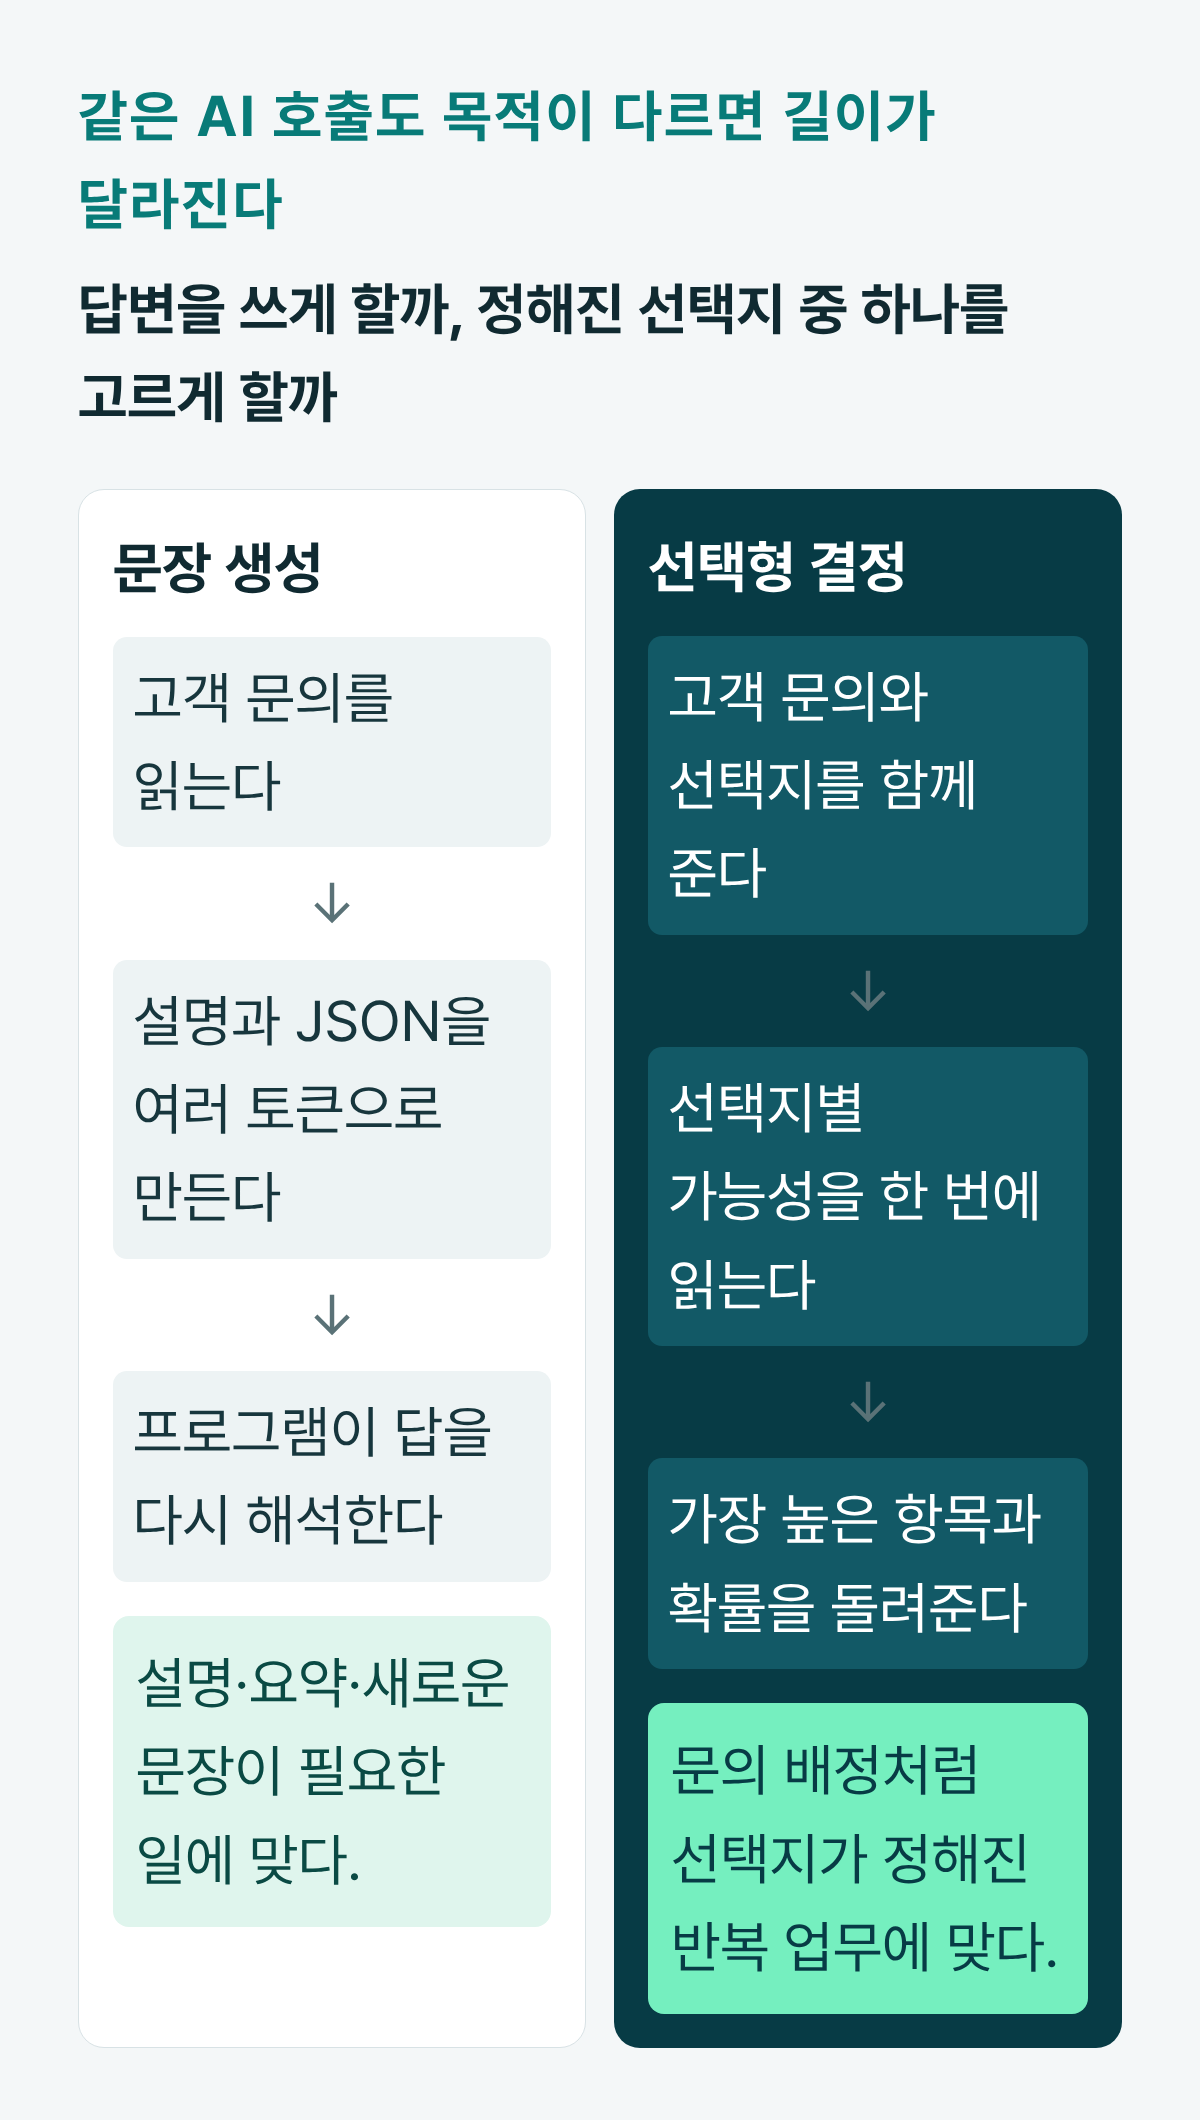
Privatemode는 GLM-5.3-Flash에 고객 문의와 선택지 목록을 함께 주고, 답이 들어갈 자리를 미리 시작한 뒤 다음 토큰 한 번의 확률을 읽는 방식을 제시했다. 선택지 번호만 허용하고, 각 번호의 확률을 다시 합계 1이 되도록 맞춘다. 결과는 “결제팀” 같은 항목 하나와 각 항목의 가능성이다.
차이는 단순한 출력 형식이 아니다. 문장 생성은 새로운 설명이 필요한 일에 맞고, 선택형 결정은 선택지가 바뀌지 않는 반복 업무에 맞는다. 낮은 확률을 사람에게 보내는 경계도 함께 만들 수 있다. 다만 확률이 승인 규칙 자체는 아니다. 자동 처리의 중단 기준과 담당 경로는 정답률보다 실패 책임 구조를 먼저 설계하는 방식으로 따로 정해야 한다.
정확도는 비슷했지만, 비용과 속도는 조건에 따라 갈렸다
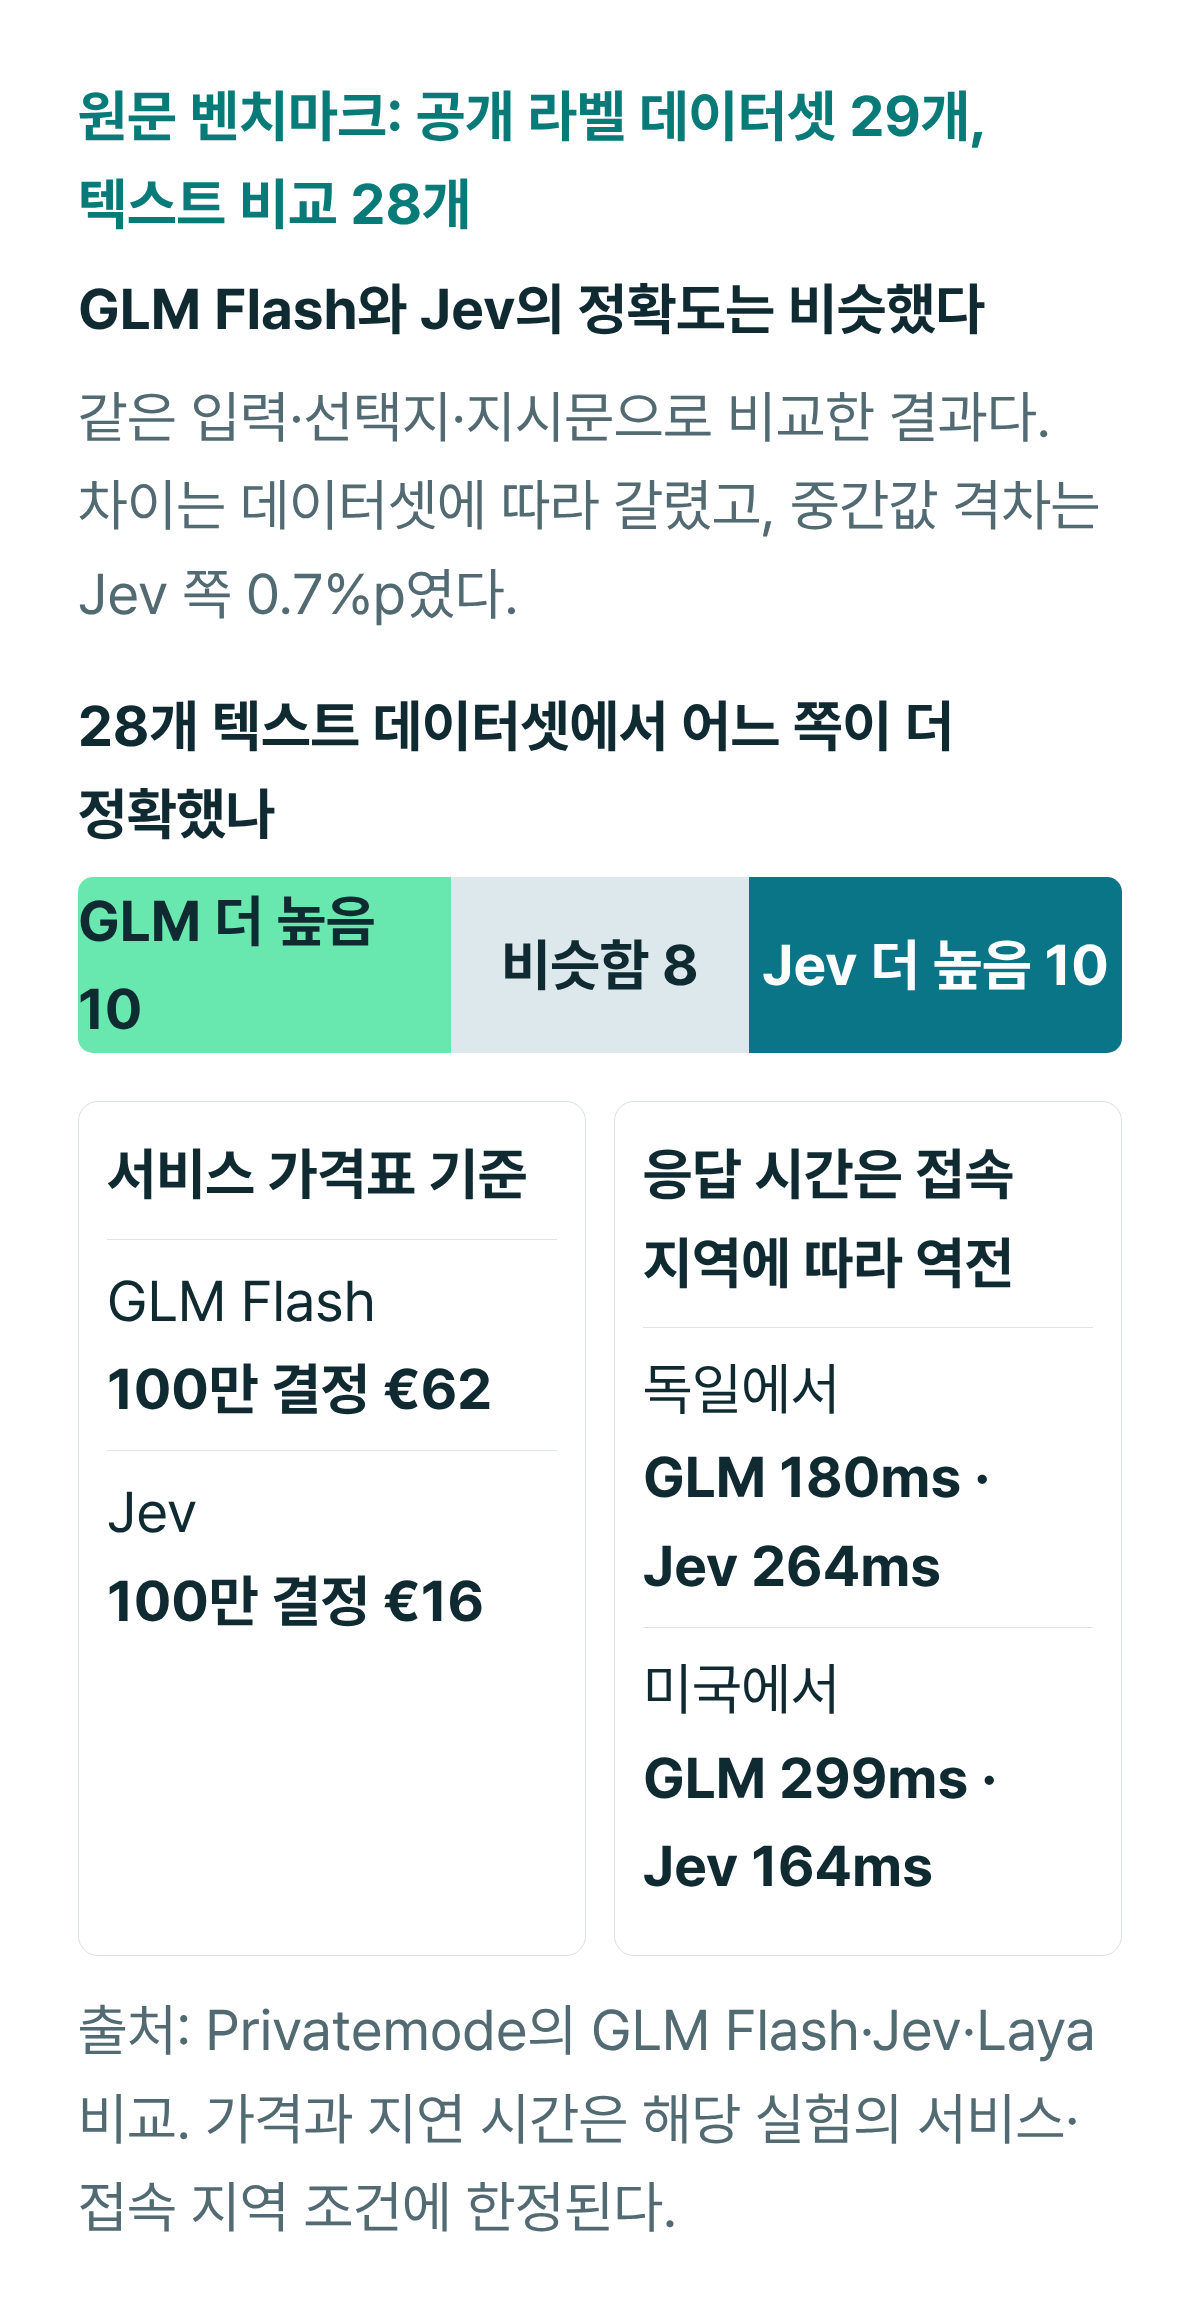
원문은 공개 라벨 데이터셋 29개로 GLM-5.3-Flash, Jev, Laya를 비교했다. 텍스트 데이터셋 28개에서 GLM이 더 정확한 경우와 Jev가 더 정확한 경우가 각각 10개였고, 8개는 1%포인트 안쪽이었다. 중간값 격차는 Jev 쪽 0.7%포인트였지만 통계적으로 의미 있는 차이로 보지 않았다.
같은 정확도라는 말이 같은 운영비를 뜻하지는 않는다. 이 실험에서 서비스 가격표 기준 100만 번의 결정 비용은 GLM-5.3-Flash가 약 62유로, Jev가 약 16유로였다. 응답 시간은 접속 지역에 따라 반대가 됐다. 독일에서는 GLM이 180ms, Jev가 264ms였고 미국에서는 Jev가 164ms, GLM이 299ms였다. 따라서 기존 모델을 바꿀지 판단할 때는 정확도 하나보다 선택지 수, 처리 지역, 기존 인프라와 가격을 함께 계산해야 한다.
기존 LLM을 바꿔 볼 만한 업무와 아닌 업무
선택지가 적고 고정된 고객 문의 배정, 문서 유형 분류, 정책 위반 1차 판별은 이 접근에 잘 맞는다. 이미지가 함께 들어오는 스캔 문서도 GLM-5.3-Flash 쪽의 장점으로 제시됐다. 반대로 새 선택지가 자주 생기거나, 결정 이유를 긴 문장으로 설명해야 하거나, 분류 체계 자체를 다시 만들어야 하는 일은 보통의 대화형 LLM 흐름이 더 자연스럽다.
핵심은 “더 싼 모델”을 찾는 일이 아니다. 이미 쓰는 LLM에게 문장을 쓰게 하는 비용이 실제 병목인지 먼저 확인하고, 맞다면 선택지와 사람 검토 경계를 제품 흐름에 넣는 일이다. 그때 GLM-5.3-Flash 같은 범용 모델의 단일 추론 방식은 Jev 전용 모델을 바로 대체한다는 주장이 아니라, 별도 모델을 들이기 전 비교할 수 있는 선택지가 된다.
출처: Privatemode AI, Turn GLM-5.3-Flash into a Jev-like System One model