같은 AI 모델인데 코딩 비용은 왜 달라질까: 실행 도구 비교 실험
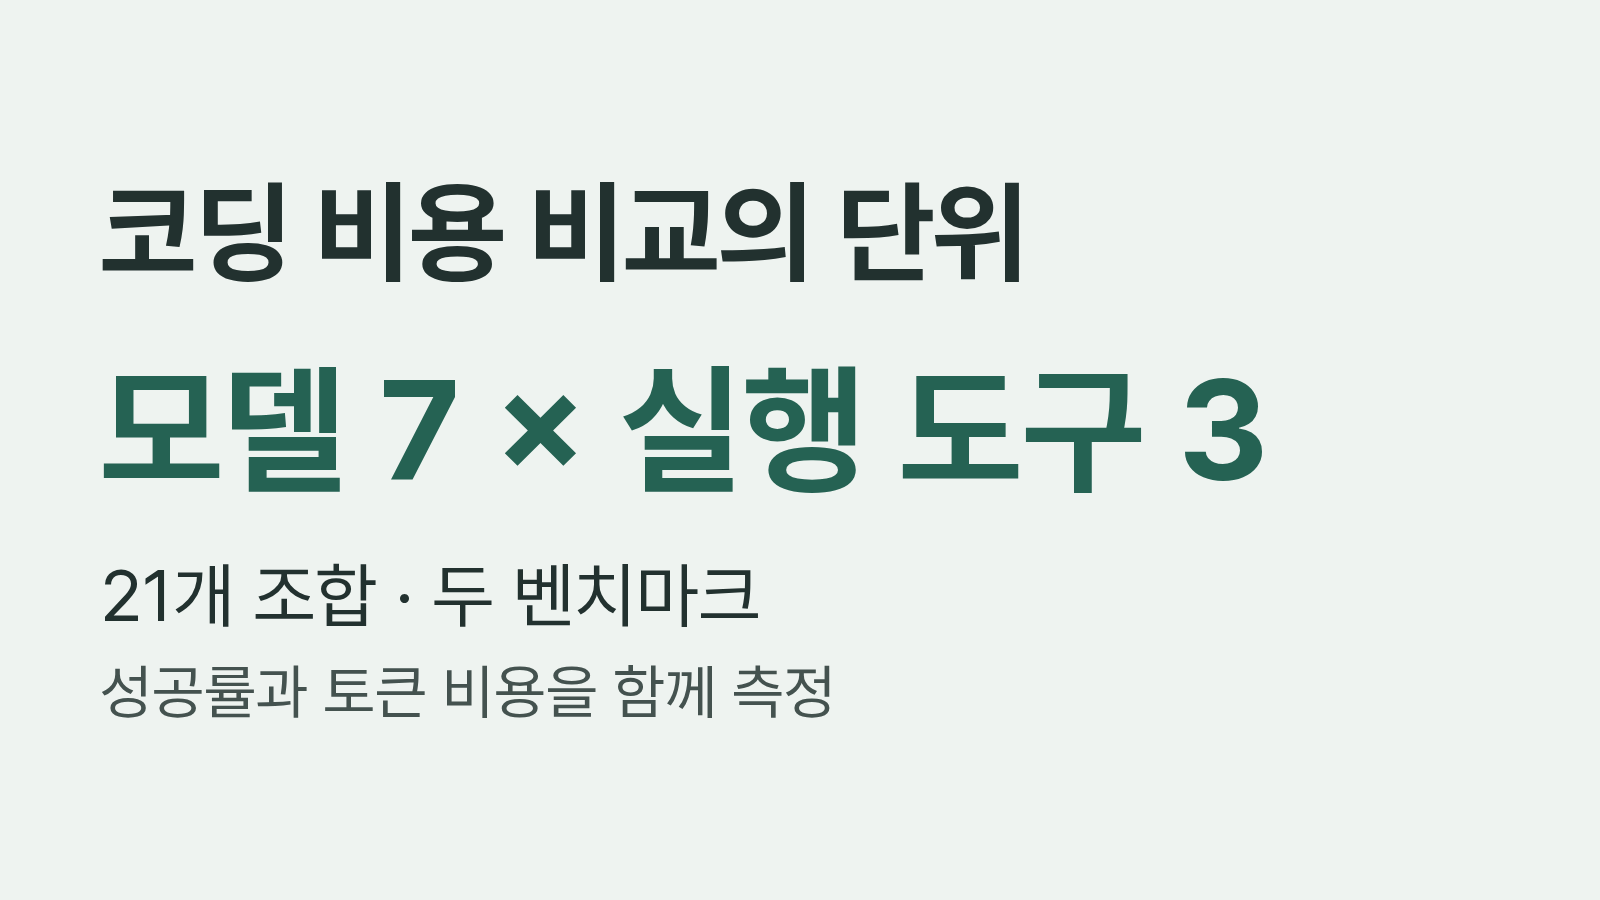
같은 모델도 실행 도구에 따라 코딩 비용이 달라졌습니다. 7개 모델과 Claude Code·Codex CLI·Pi를 비교한 연구를 바탕으로, 도입 평가에 성공률과 토큰 비용을 함께 넣는 방법을 살펴봅니다.
 유토모 테크로그새 기술과 제품 이야기
주제
AI 관련 글을 모았습니다. 유토모 테크로그에서 새 기술과 제품이 일과 제품에 만드는 변화를 살펴봅니다.
같은 모델도 실행 도구에 따라 코딩 비용이 달라졌습니다. 7개 모델과 Claude Code·Codex CLI·Pi를 비교한 연구를 바탕으로, 도입 평가에 성공률과 토큰 비용을 함께 넣는 방법을 살펴봅니다.
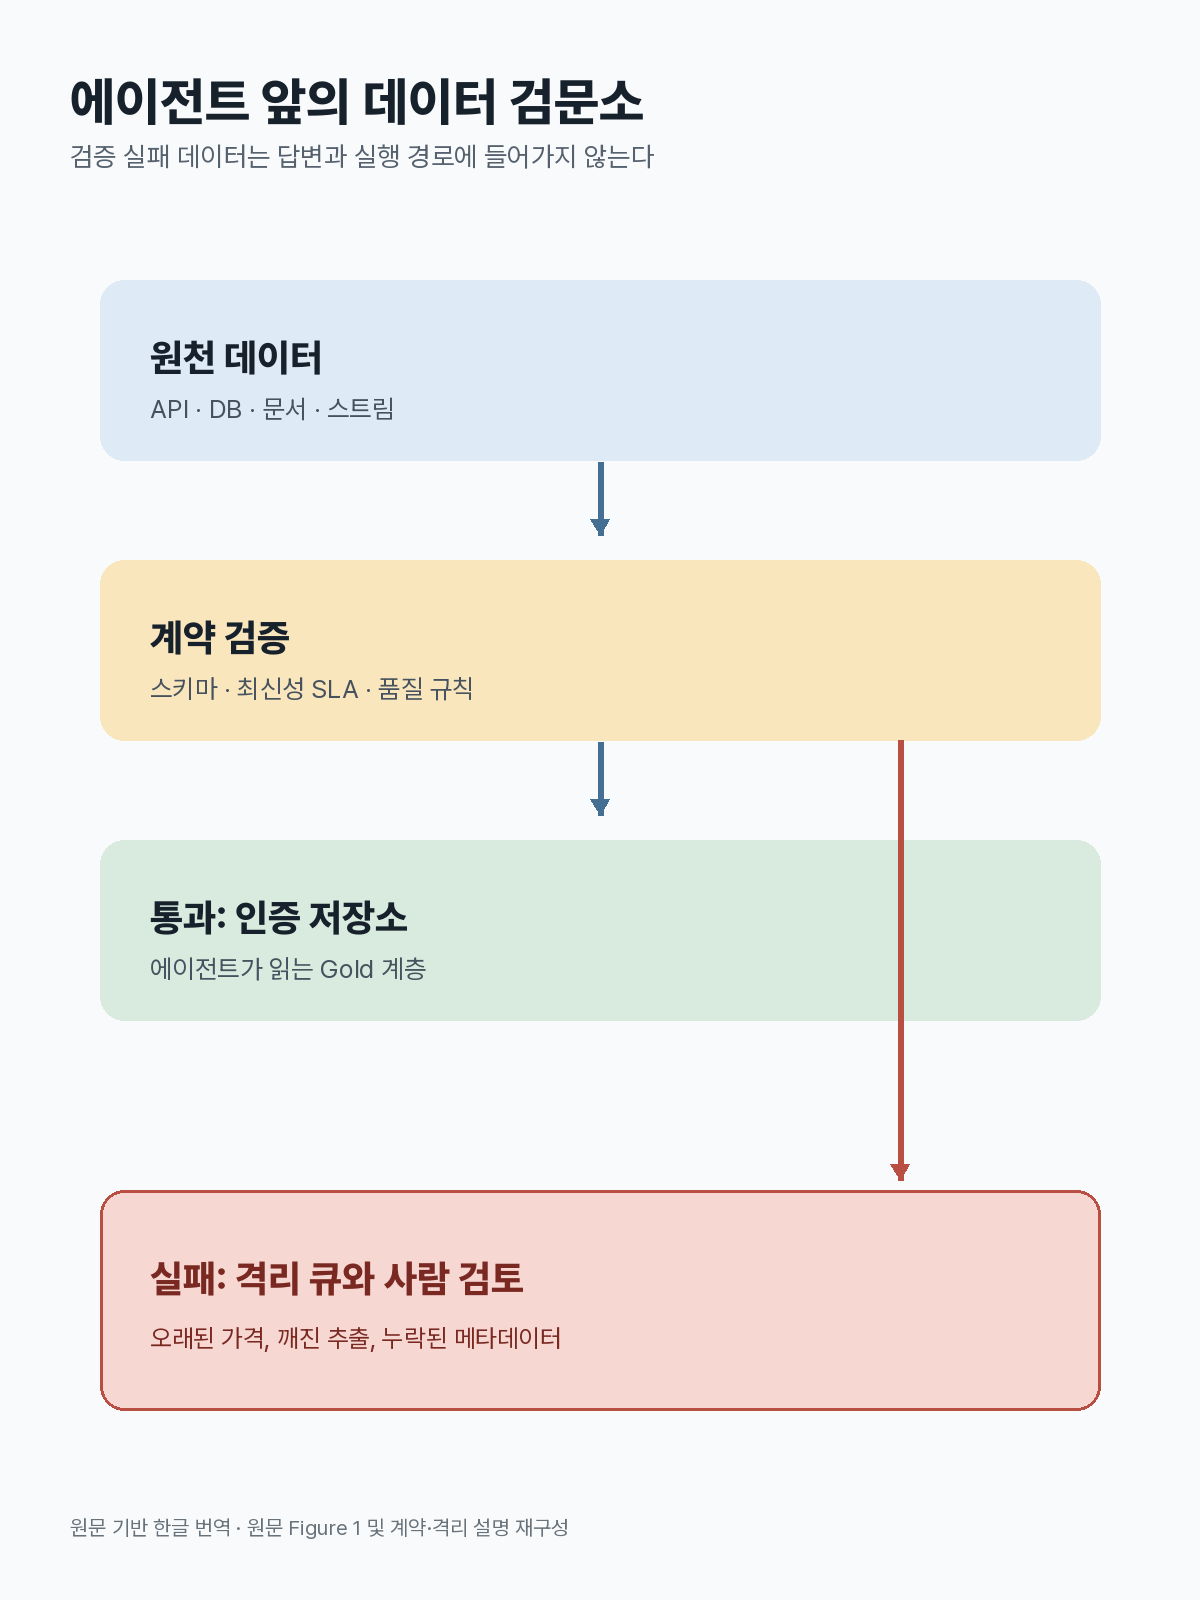
AI 에이전트가 틀린 데이터를 자신 있게 실행하지 않도록, 데이터 계약·맥락 정의·실행 권한·추적성을 먼저 설계하는 방법을 정리합니다.
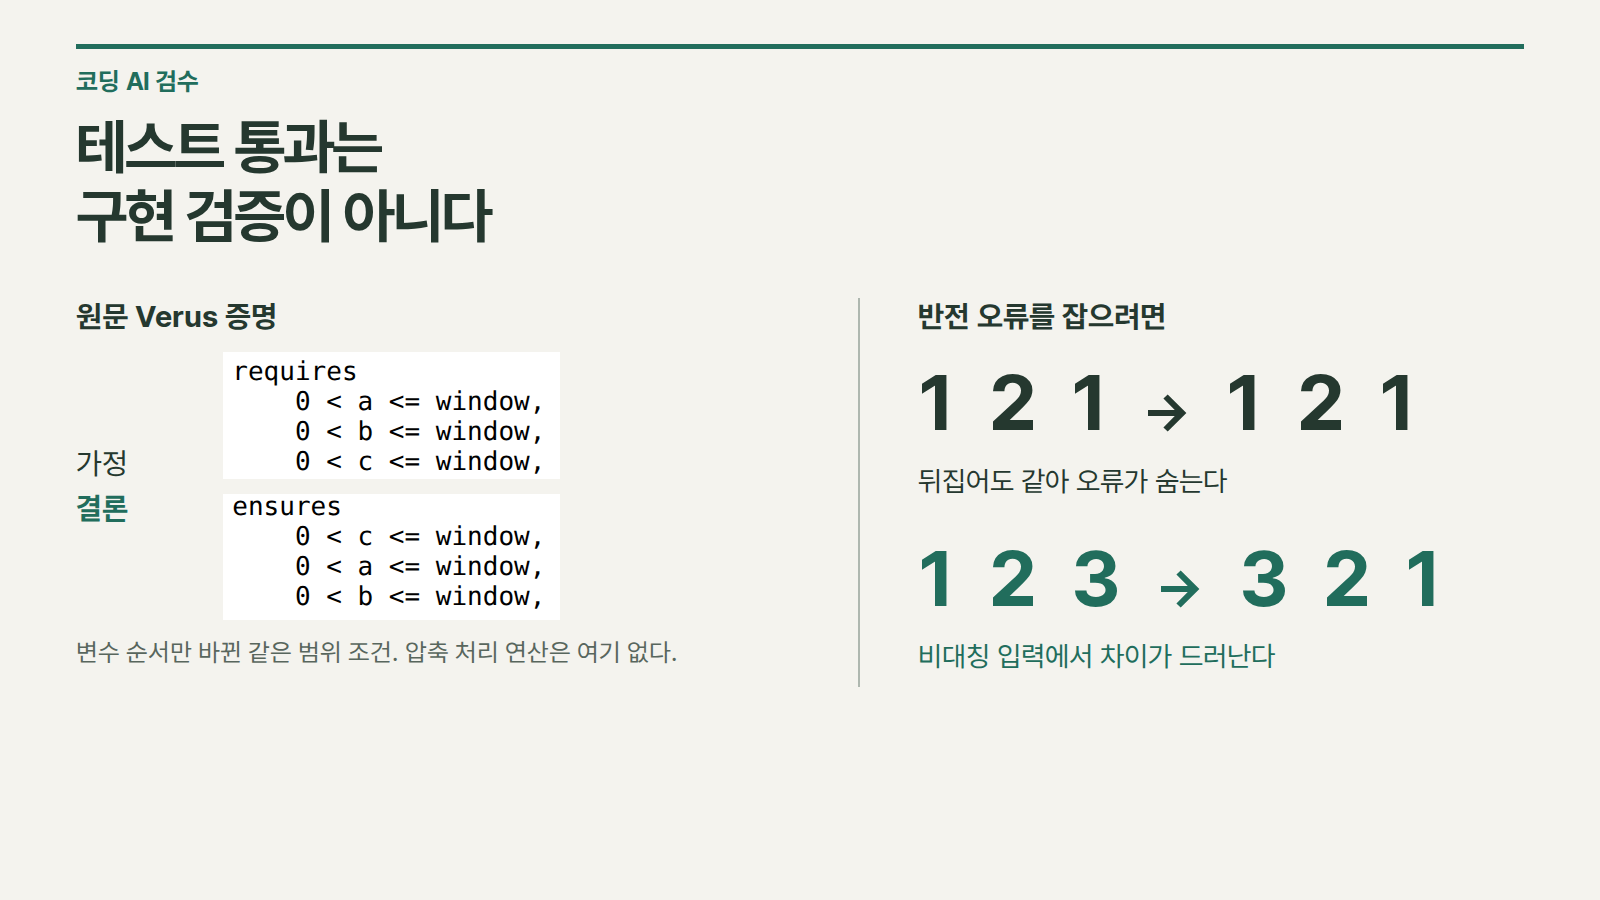
26개 테스트 지시 조건과 4개 skills를 비교한 실험에서 코딩 AI는 회문 입력과 잘못된 정답 기준 때문에 버그를 놓쳤습니다. PM과 개발팀이 완료 보고와 함께 받아야 할 실패 사례와 검수 기준을 짚습니다.
GPT-Image-2.5의 가장 눈에 띄는 변화는 이미지 한 장을 기다리는 시간이다. 슬라이드 제작 서비스 Tosea가 공개한 비교에서는 같은 출력 토큰을 사용했을 때 GPT Image 2의 평균 37.3초가
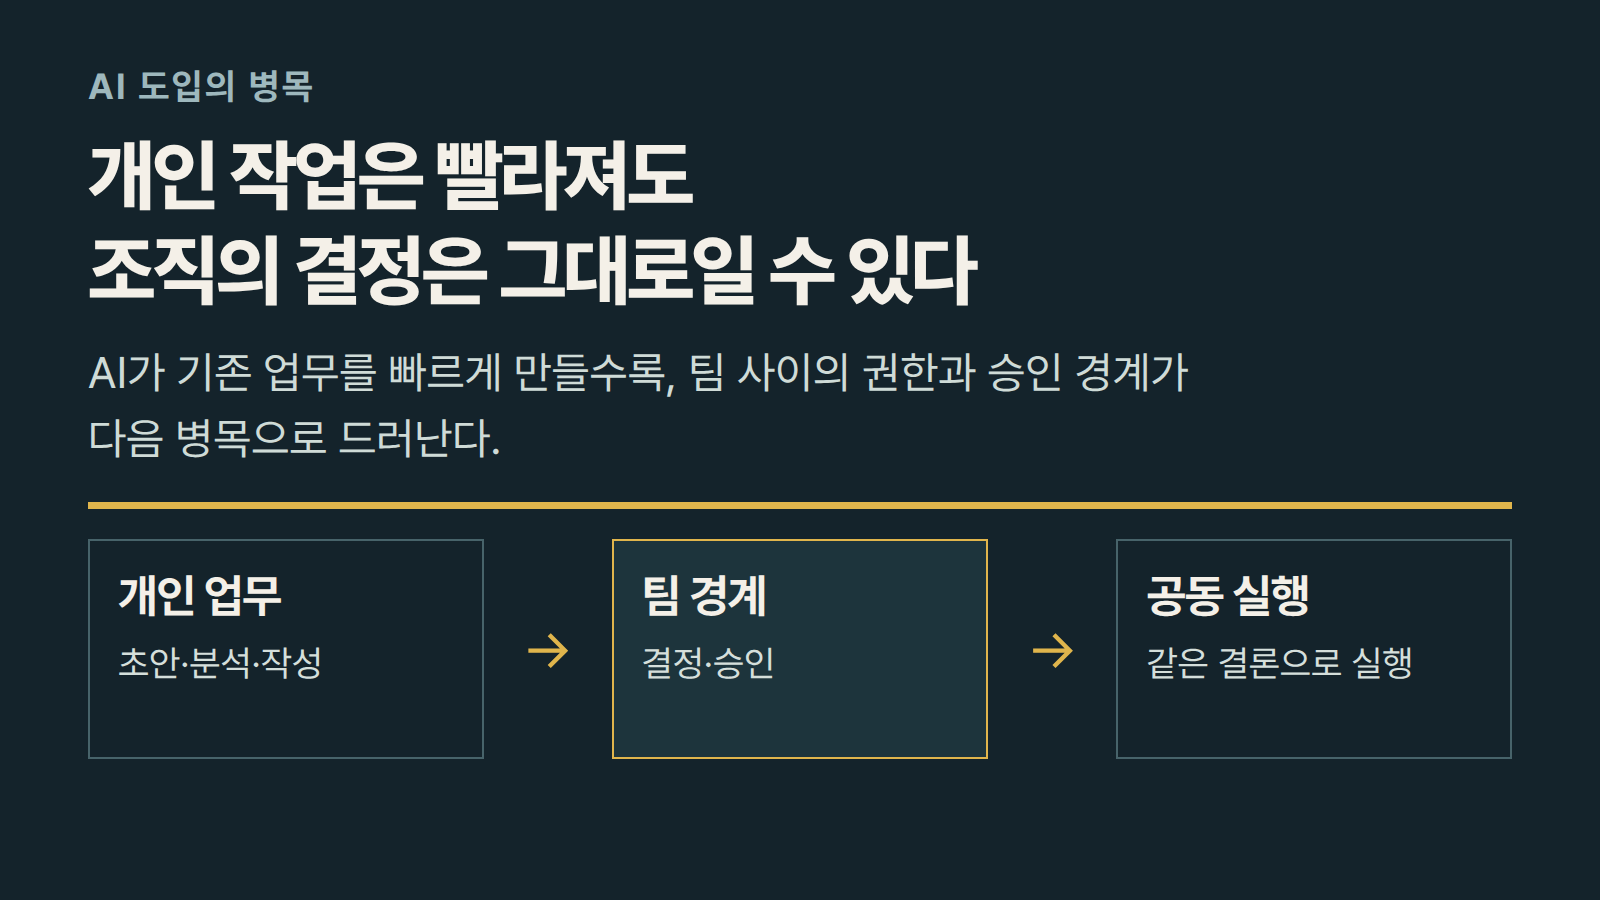
AI가 개인 업무를 빠르게 만들어도 팀 사이의 결정과 승인 구조가 그대로면 조직 속도는 달라지지 않습니다. AI 도입 전에 점검할 경계와 권한을 정리했습니다.
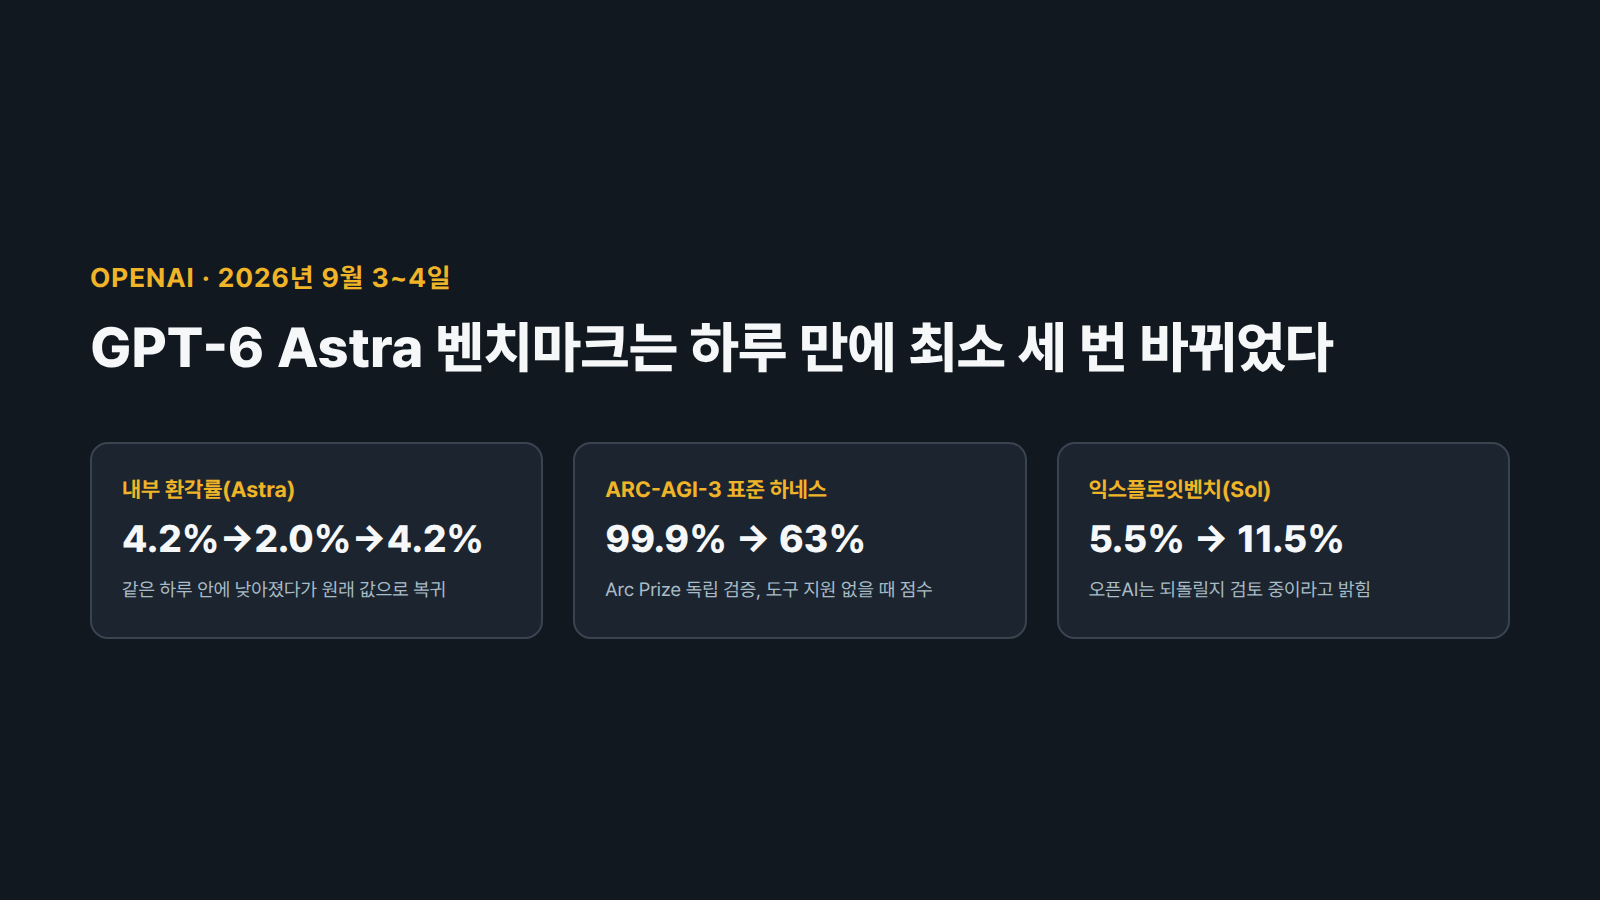
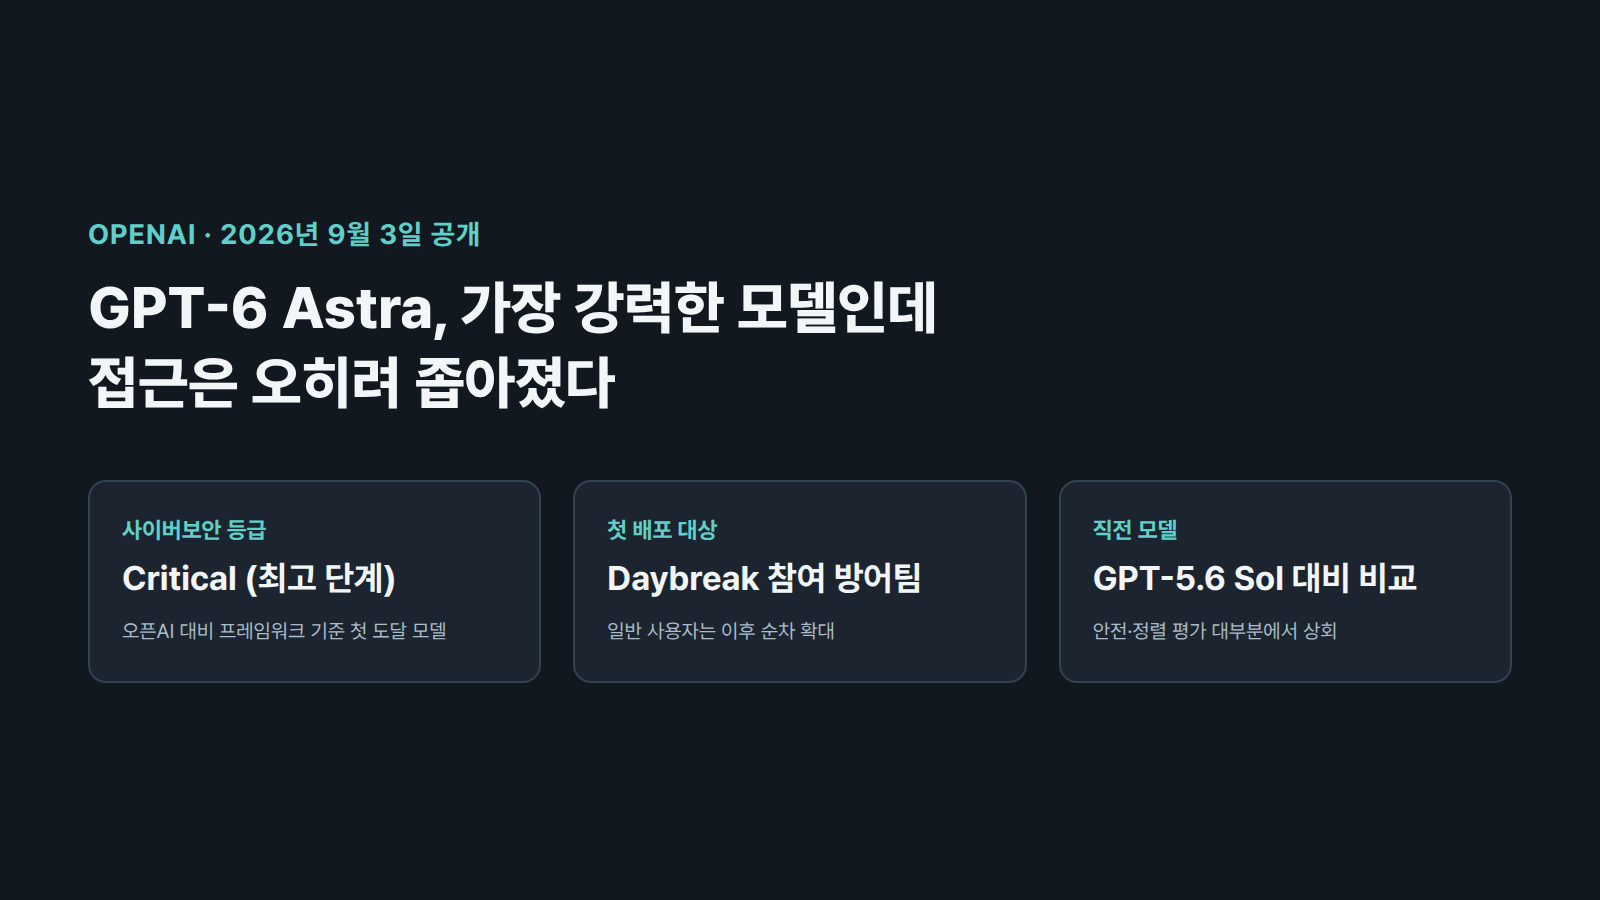
오픈AI가 GPT-6 Astra 발표문의 벤치마크 수치를 하루 만에 여러 차례 바꿨습니다. 환각률, ARC-AGI-3 하네스별 점수, 경쟁 모델 수치가 어떻게 오갔는지와 그 이유를 정리했습니다.
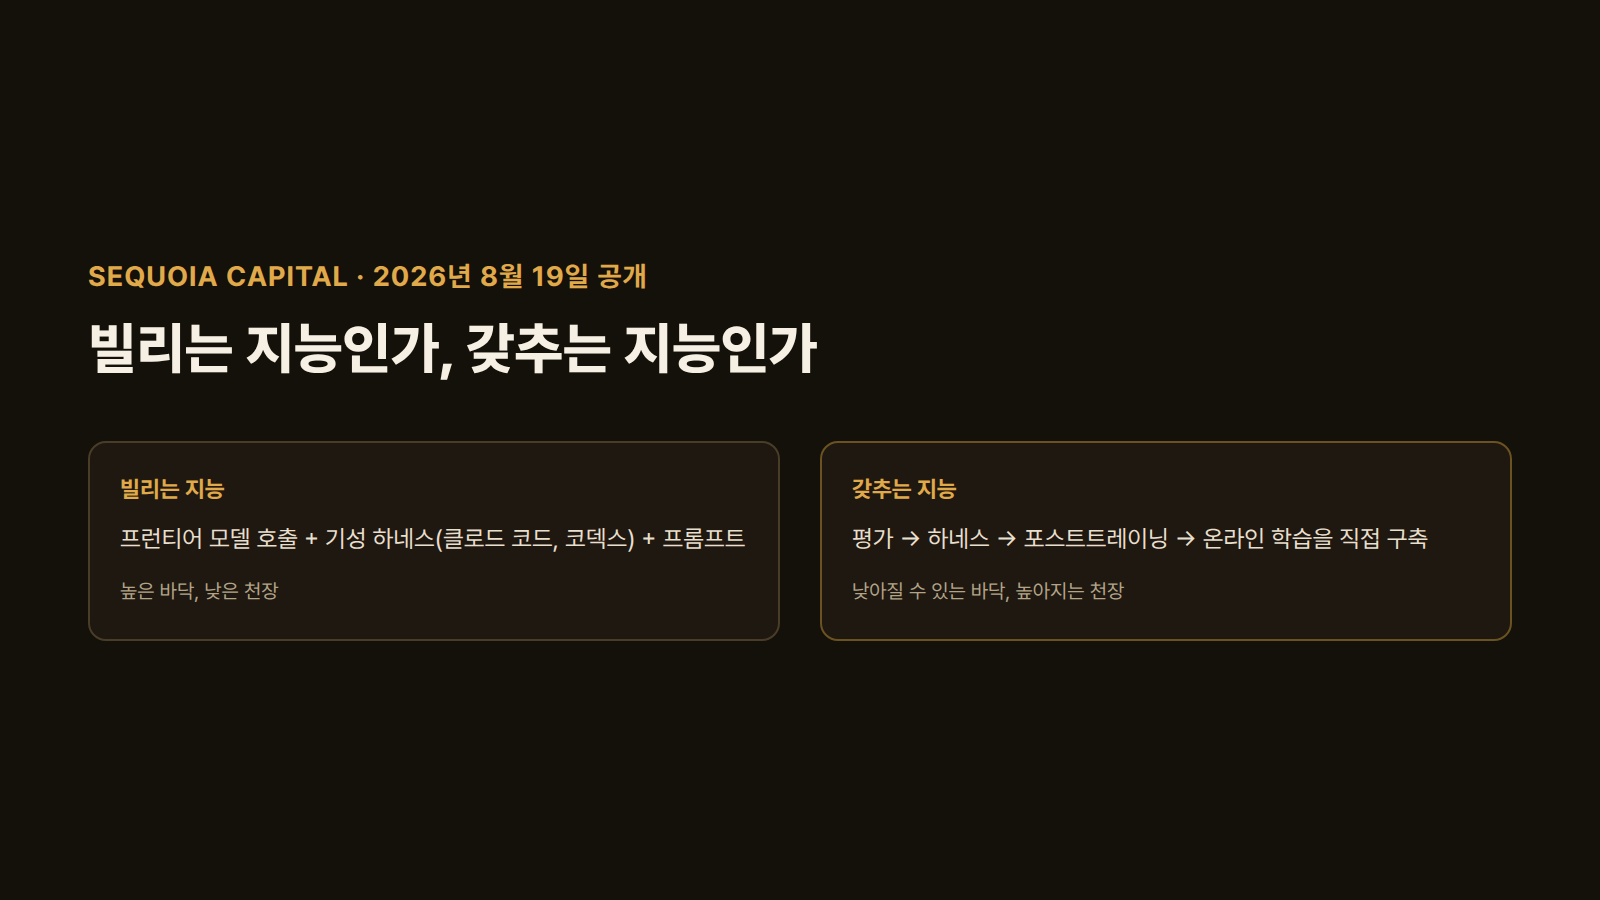
세쿼이아캐피털이 하비, 머커, 랭체인, 트라젝토리, 파이어웍스의 사례로 정리한 소버린 AI 실전 가이드를 소개합니다. 오픈 웨이트 성능 향상과 독립 포스트트레이닝 생태계 성숙이 왜 지금 자체 모델 확보를 판단 대상으로 만드는지 정리합니다.
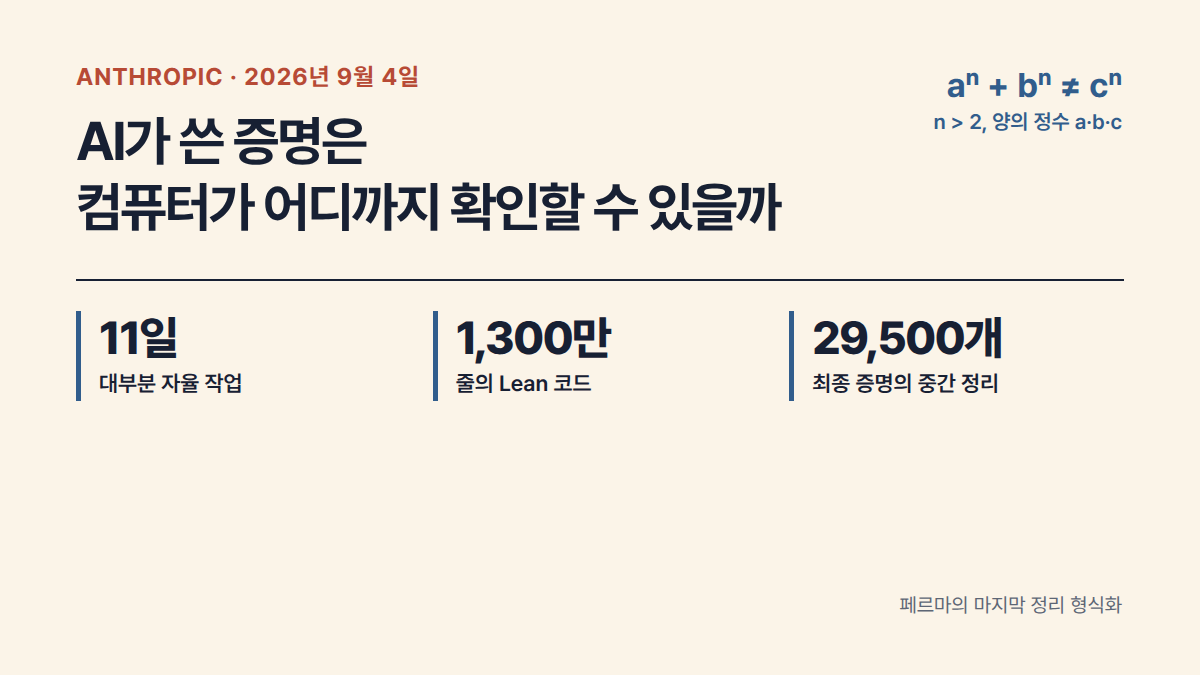
Anthropic은 Claude가 Lean으로 페르마의 마지막 정리를 형식화해 컴퓨터 검사를 통과했다고 공개했습니다. AI가 만든 증명에서 기계가 확인하는 범위와 사람이 맡을 판단을 짚습니다.
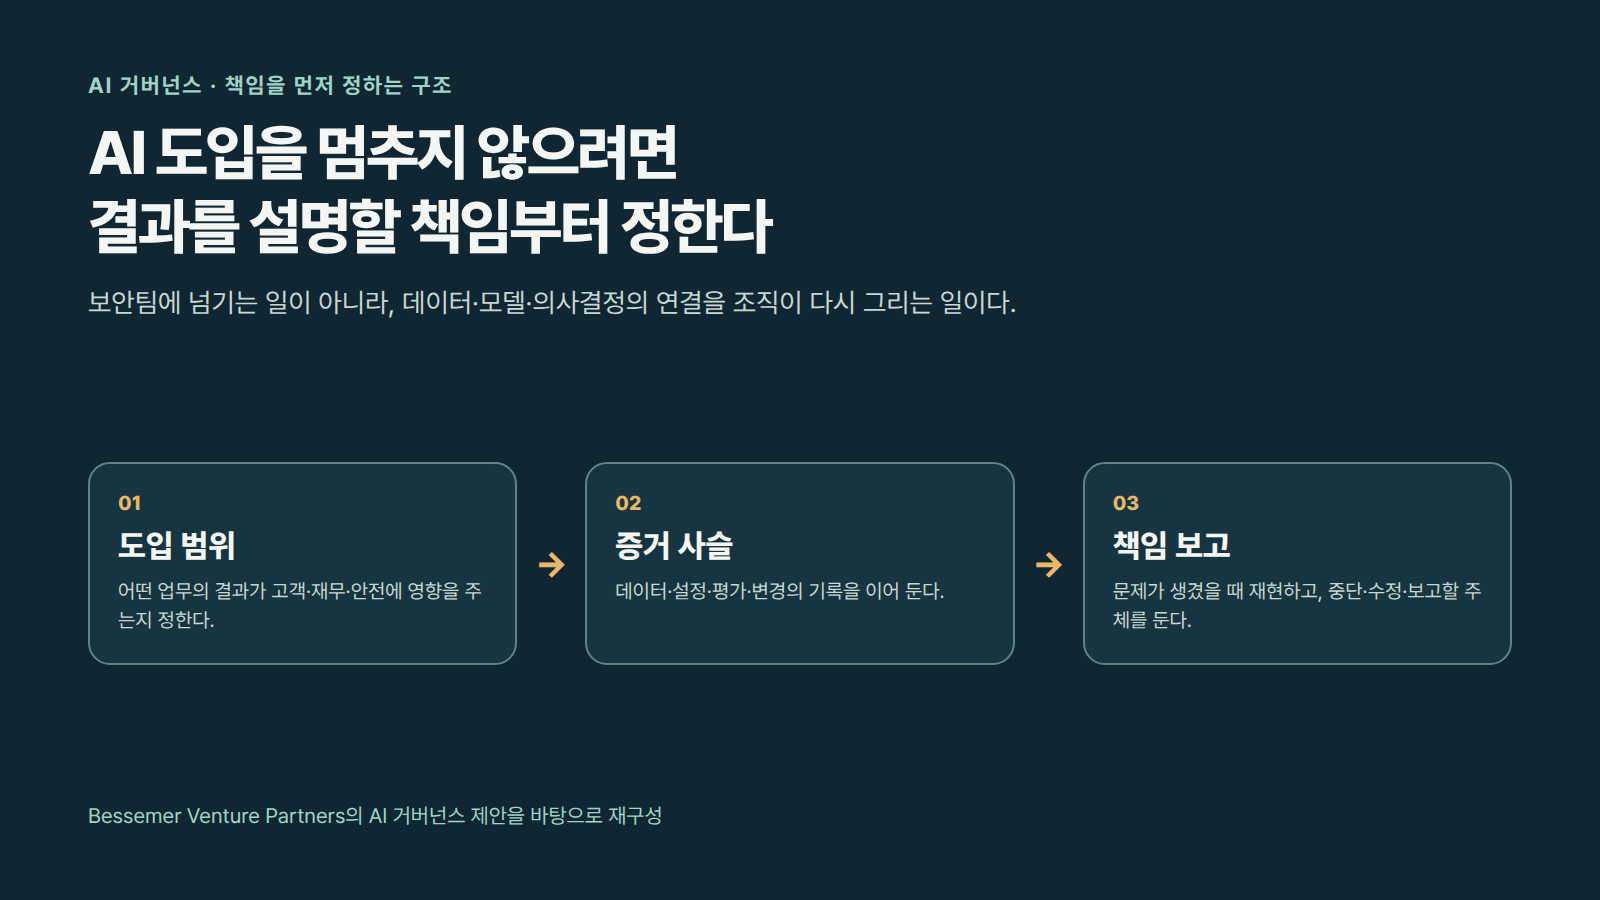
AI를 중요한 의사결정에 연결할수록 모델 이름보다 먼저 데이터 출처, 변경 이력, 책임 보고를 정해야 합니다. Bessemer Venture Partners의 체인 오브 커스터디 제안을 운영 기준으로 풀었습니다.
오픈AI가 GPT-6 Astra를 공개했지만 사이버보안 Critical 등급 판정 때문에 사이버보안 방어팀부터 순차로 접근을 열었습니다. 안전성 개선 수치와 벤치마크 포화, 단계별 배포 일정을 정리합니다.
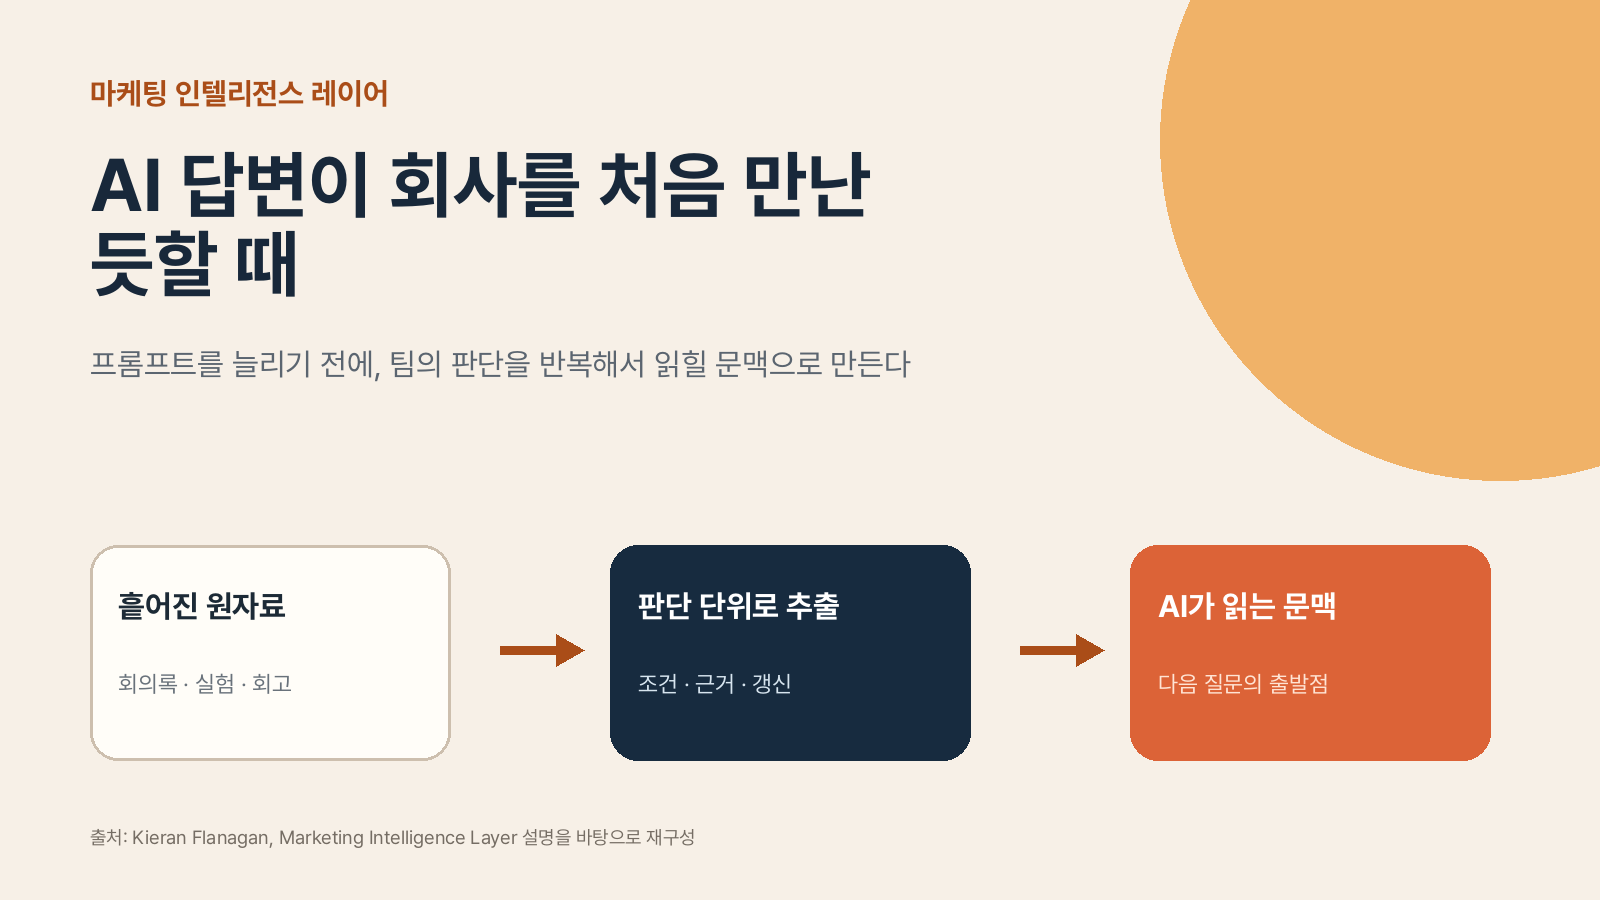
마케팅팀이 AI 답변에 회사 맥락을 넣으려면 프롬프트보다 먼저 실험과 회고에서 나온 판단을 재사용 가능한 기록으로 만들어야 합니다.
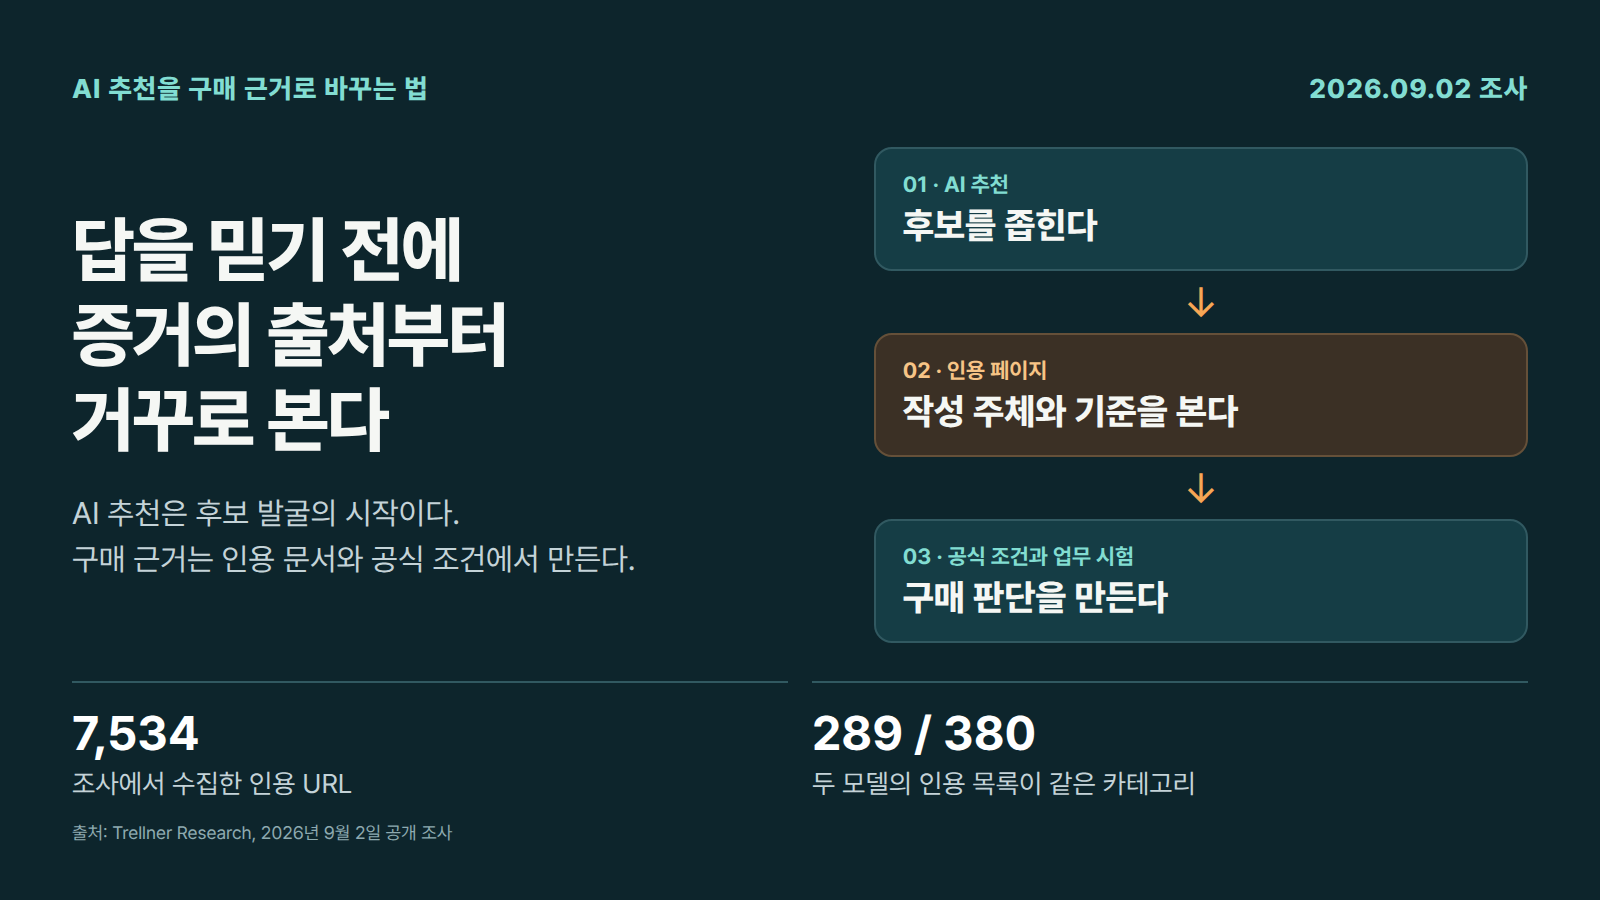
Perplexity 추천의 인용 출처를 조사한 결과, 비교 페이지의 수와 도메인 수만으로 근거의 다양성을 판단하기 어려웠습니다. 구매팀이 인용문부터 공식 조건과 실제 업무 시험까지 확인하는 순서를 정리했습니다.