
같은 AI 모델에 같은 코딩 문제를 맡겨도, 어떤 실행 도구에 연결하느냐에 따라 토큰 비용은 달라질 수 있다. UC Berkeley와 Arena 소속 연구진의 HarnessTax 연구는 모델 7개를 Claude Code, Codex CLI, Pi에 각각 연결해 비교했다. SWE-bench Lite와 Terminal-Bench 2.0에서 작업 성공률이 비슷한 조합 사이에도 비용 차이가 나타났다. PM과 개발팀은 도입 예산을 짤 때 모델과 실행 도구를 조합별로 비교할 수 있다.
여기서 실행 도구를 뜻하는 하네스는 모델에게 파일을 읽고 고칠 도구를 제공하고, 대화 맥락과 작업 진행을 관리하는 소프트웨어다. 모델이 무엇을 할지 판단하면 하네스가 그 판단을 실제 파일 수정이나 명령 실행으로 이어 준다. 같은 모델을 쓰더라도 모델에 전달하는 지침, 도구 설명, 이후 호출에 남기는 정보가 달라질 수 있다.
같은 문제를 풀었는데 비용은 얼마나 달랐나
SWE-bench Lite에서 Claude Fable 5의 시도별 성공률은 Claude Code에서 97.8%, Codex CLI와 Pi에서 각각 96.7%였다. 평균 토큰 비용은 Claude Code가 시도당 $1.33, Pi가 $0.67이었다. 성공률은 가까웠지만 비용은 약 두 배였다. 이 수치는 제품의 월 구독료가 아니라 연구진이 토큰 사용량에 공통 API 단가를 적용해 계산한 값이다.
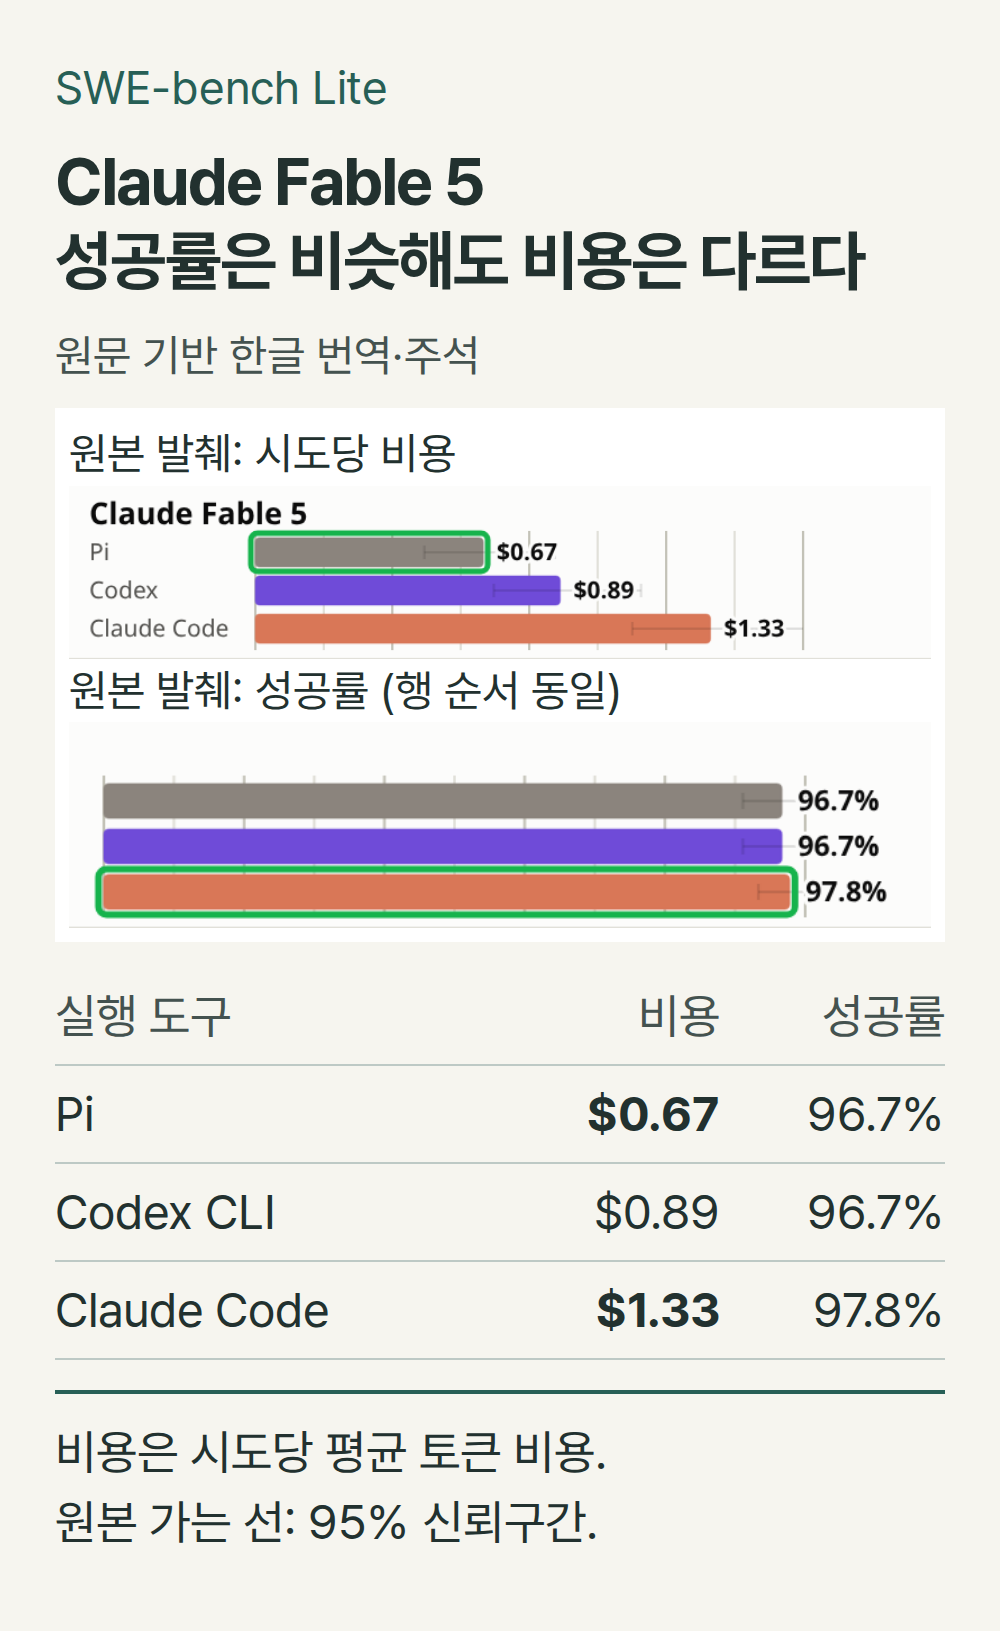
여러 모델을 묶어도 비슷한 경향이 나왔다. 같은 모델끼리의 비용 비율을 기하평균으로 비교하면, SWE-bench Lite에서 Claude Code는 Pi의 약 2.0배, Codex CLI의 약 1.6배 비용이 들었다. Terminal-Bench 2.0에서는 Claude Code가 Pi의 약 1.5배였다. 연구진이 소개한 최대 5배 차이는 이 실험에서 관측한 사례의 범위이며, 모든 모델에서 적용되는 배수가 아니다.
무엇을 고정하고 무엇을 바꾼 실험인가
연구에 쓰인 모델은 Claude Fable 5, Claude Opus 4.8, Claude Sonnet 4.6, Claude Haiku 4.5, GPT-5.6 Sol, GPT-5.6 Luna, Kimi K3다. 각 모델을 세 하네스에 연결한 21개 조합이 벤치마크별로 무작위 추출한 동일한 30개 과제를 풀었다. 과제마다 세 번 시도했고, 성공 여부는 각 벤치마크의 공식 평가기로 판정했다.
하네스의 기본 구성을 출발점으로 높은 추론 노력 설정을 선택하고, 한 시도를 최대 100 에이전트 턴으로 제한했다. 추론 노력과 턴의 정의는 각 하네스의 정의를 따랐다. SWE-bench Lite 과제 컨테이너에서는 외부 네트워크를 막고 Claude Code와 Codex의 기본 웹 도구도 껐다. Pi에는 구독 키 설정과 턴 제한을 위한 패키지 두 개를 추가했으며, Kimi K3는 세 하네스 모두 Fireworks AI를 거쳐 같은 기본 사고 모드로 사용했다.
비용 계산에는 2026년 9월 1일자 직접 API 가격표를 고정해 사용했다. 과제별 세 번의 시도를 평균 낸 뒤 30개 과제의 평균을 구했으며, 95% 신뢰구간은 과제 평균을 10,000회 재표집해 추정했다. 따라서 이 결과를 읽을 때는 작은 성공률 차이 자체보다, 비슷한 성공률을 내는 조합의 비용이 얼마나 벌어지는지 함께 보는 편이 유용하다.
모델을 부르는 횟수가 비슷해도 왜 비싸질까
Claude Fable 5가 SWE-bench Lite에서 기록한 평균 턴 수는 Pi가 15.4회, Claude Code가 15.3회였다. 기록상 턴 수가 거의 같아도 비용은 달랐다. 하네스마다 턴을 세는 방식이 달라 이를 정확히 같은 호출 횟수라고 볼 수는 없지만, 턴 수만으로 지출을 설명하기 어렵다는 관찰이다.
첫 호출에 담기는 정보도 차이가 났다. SWE-bench Lite에서 일곱 모델 전체의 평균 초기 컨텍스트는 Claude Code가 Pi의 10배를 넘었다. 지침과 도구 명세가 더 길었고, 공급자가 보고한 초기 입력 토큰에는 과제 프롬프트도 포함됐다. 아래 원본 그림의 오차 막대는 평균 주변의 표준편차를 나타낸다. 앞서 성공률 비교에 쓴 95% 신뢰구간과는 다른 표시다.
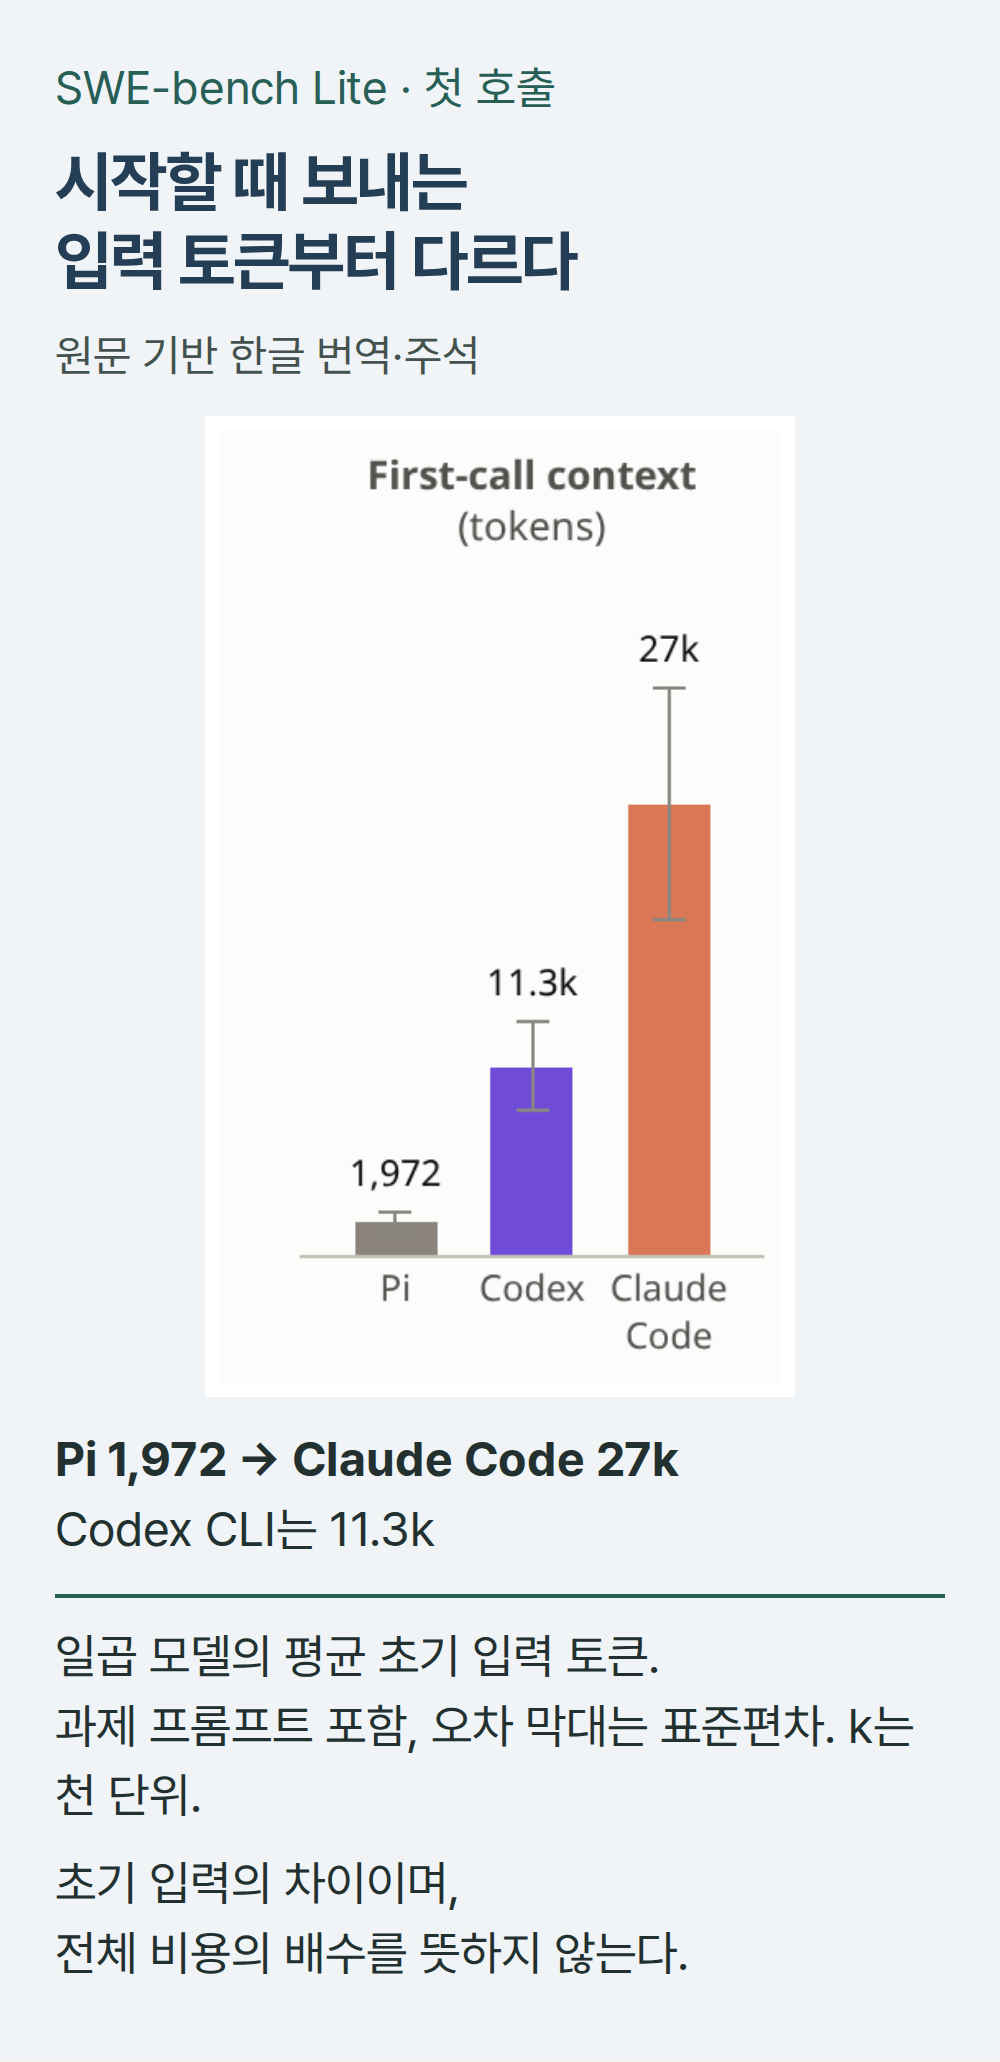
Pi는 기본적으로 read, write, edit, bash 네 도구를 제공하는 단순한 구성이다. 연구에서는 이 구성이 두 벤치마크의 비용과 성공률 비교에서 경쟁력을 보였다. 긴 초기 컨텍스트는 비용을 높일 수 있지만, 전체 비용에는 캐시 적용과 생성 토큰, 이후 호출도 영향을 준다. 첫 입력 토큰이 10배라는 관측을 전체 청구액이 10배라는 뜻으로 읽으면 안 된다.
모델 제작사의 도구가 가장 잘 맞을까
Terminal-Bench 2.0에서 GPT-5.6 Sol은 Pi에 연결했을 때 성공률 83.3%, 평균 비용 $0.42를 기록했다. Codex CLI에서는 78.9%, $0.76이었다. 같은 회사가 제공하는 모델과 도구의 조합이 이 표본에서 가장 유리하지는 않았다. SWE-bench Lite의 Claude Sonnet 4.6도 Codex CLI에서 68.9%, Claude Code에서 66.7%를 기록했고, 비용은 비슷했다.
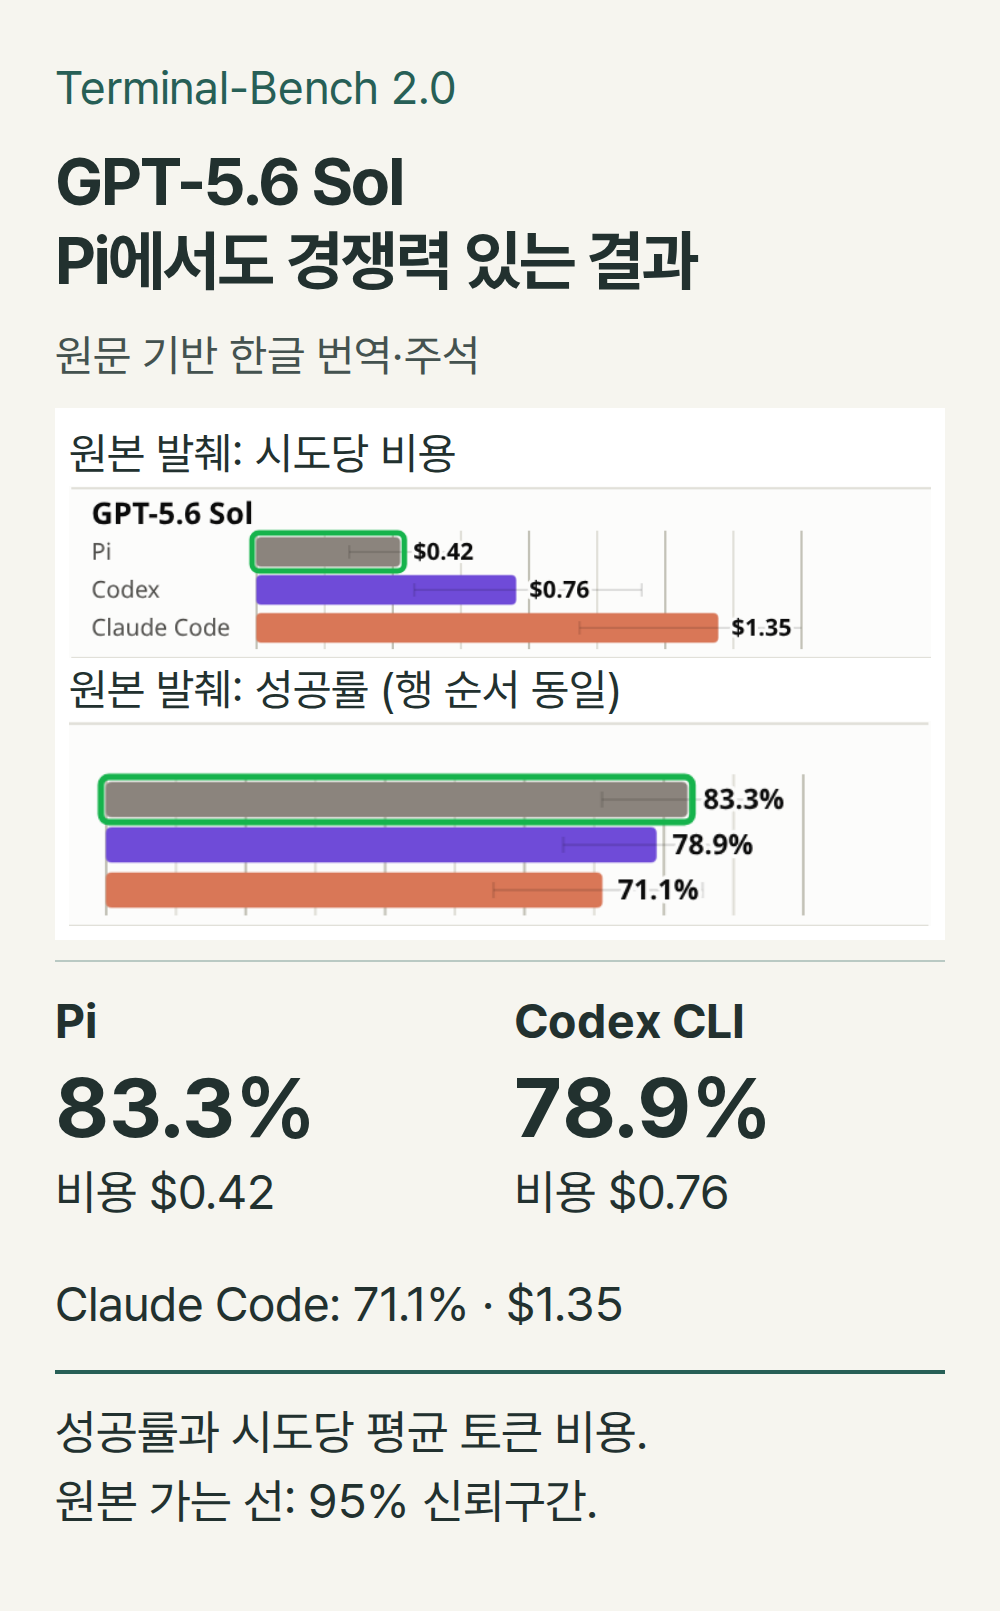
이 비교는 두 공개 벤치마크에서 추출한 과제에 한정되며, 모델이 학습 중 해당 벤치마크를 접했을 가능성도 있다. 요구사항이 도중에 바뀌거나 개발자가 피드백을 주고, 여러 세션에 걸쳐 이어지는 실제 업무까지 같은 순위가 유지된다는 결과는 아니다. 연구진도 실제 개발 흐름에서의 하네스 평가를 다음 과제로 제시했다.
우리 팀 예산표에는 어떤 항목을 추가하면 될까
실무에 적용한다면 기존의 모델 비교표를 모델과 하네스의 조합별 비교표로 바꿀 수 있다. 팀에서 반복하는 버그 수정이나 테스트 작성 과제를 정하고, 같은 입력과 완료 기준으로 도구를 바꿔 실행하는 방식이다. 이때 성공률과 함께 실패한 시도까지 포함한 토큰 비용을 기록해야 한다. 성공한 작업만 골라 비용을 평균 내면 재시도에 들어간 예산이 빠진다.
구독형 제품을 검토하는 팀이라면 연구의 API 환산 비용과 실제 요금제도 구분해야 한다. 사용 한도와 추가 과금 조건에 따라 지출은 달라진다. 개발자가 결과를 고치는 시간 역시 별도로 기록할 필요가 있다. PM은 같은 모델을 다른 실행 도구에 연결한 대조군을 도입 평가에 넣을 수 있다. 그 비교에서 필요한 성공률을 유지하며 비용을 줄이는 조합이 나오면, 해당 업무의 예산에 반영하면 된다.
출처: HarnessTax: How Much Does the Harness Matter for Coding Agents? · Pi coding agent 문서