
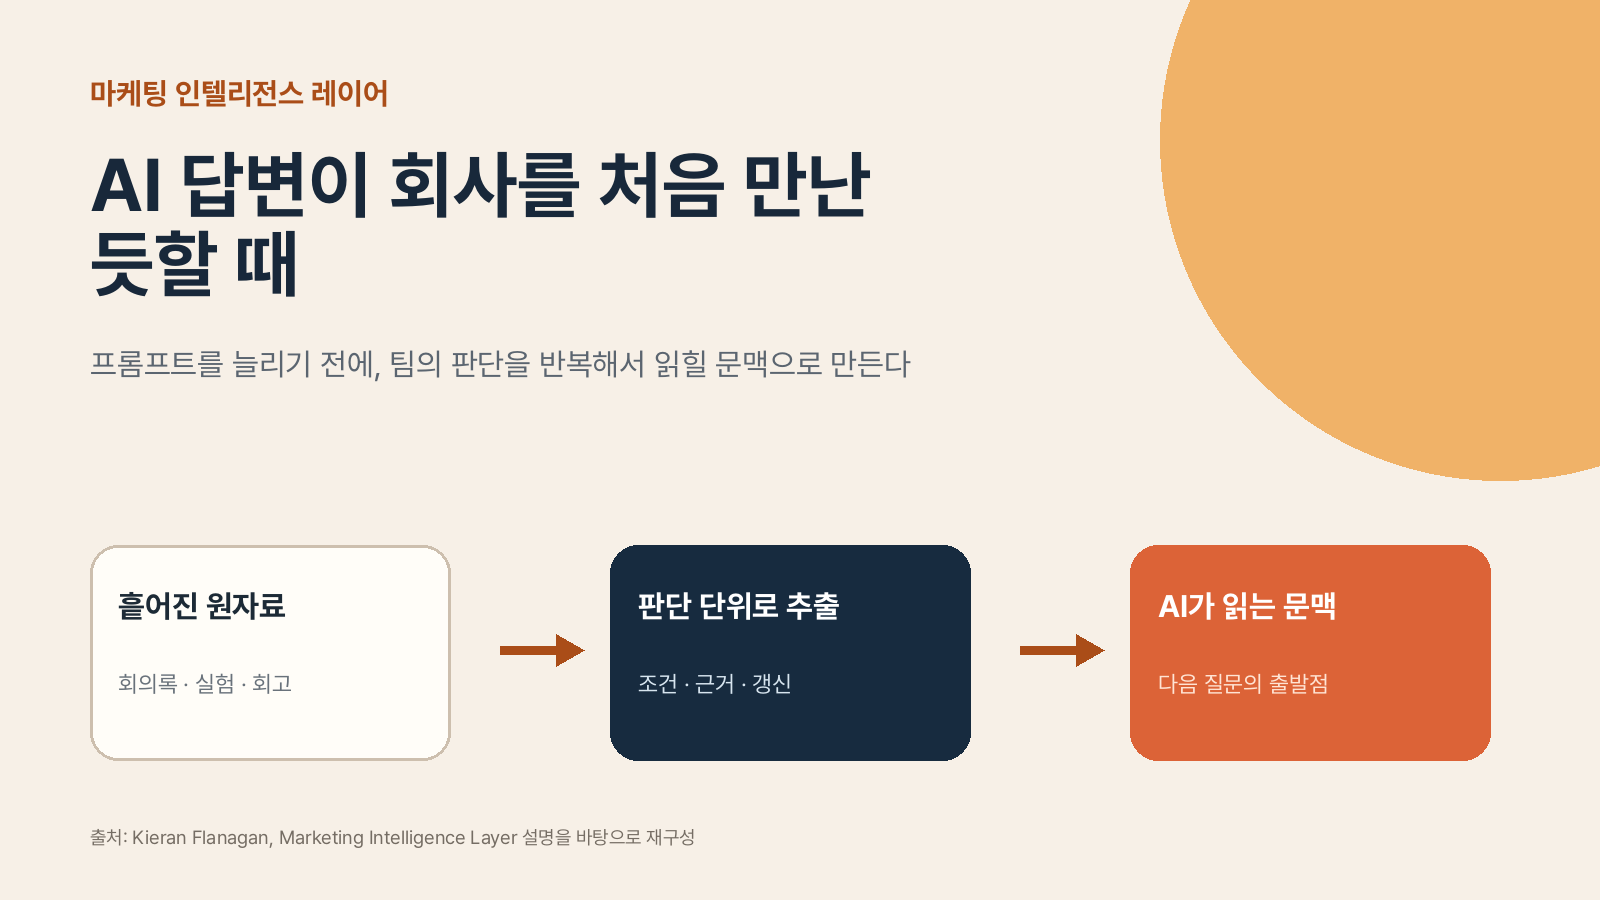
마케팅팀이 AI에게 회사 상황을 설명할 때마다 답변이 평범해지는 이유는 모델의 지식 부족만이 아니다. 캠페인 회고, 영업 대화, 실험 실패, 포지셔닝 논의가 문서와 메신저에 흩어진 채 의사결정에 다시 쓰일 수 있는 형태로 남지 않기 때문이다.
마케팅 리더 키어런 플래너건은 2026년 8월 자신이 쌓은 15년 이상의 경험을 여러 AI 도구가 읽을 수 있는 하나의 HTML 파일, ‘Marketing Intelligence Layer’로 정리한 방식을 공개했다. 핵심은 문서를 요약해 쌓는 일이 아니라, 그 안의 재사용 가능한 판단을 꺼내어 주제별 문맥으로 만드는 데 있다. 원문에서 그가 비교한 두 번의 동일한 프롬프트도 한쪽은 새 대화창에서, 다른 한쪽은 이 레이어를 읽힌 뒤 실행했다.

무엇을 먼저 만들어야 답변이 회사 일을 안다?
보통 AI 도입은 프롬프트 모음이나 챗봇 화면부터 시작한다. 그러나 회사가 이미 알고 있는 사실과 판단이 입력에 빠져 있으면, 모델은 그 회사가 어떤 고객을 포기했는지, 어떤 전환 지표를 믿지 않는지, 어떤 메시지가 실제로 반응을 얻었는지 알 방법이 없다. 매번 담당자가 이를 다시 설명하거나, 설명을 생략한 채 일반론을 받게 된다.
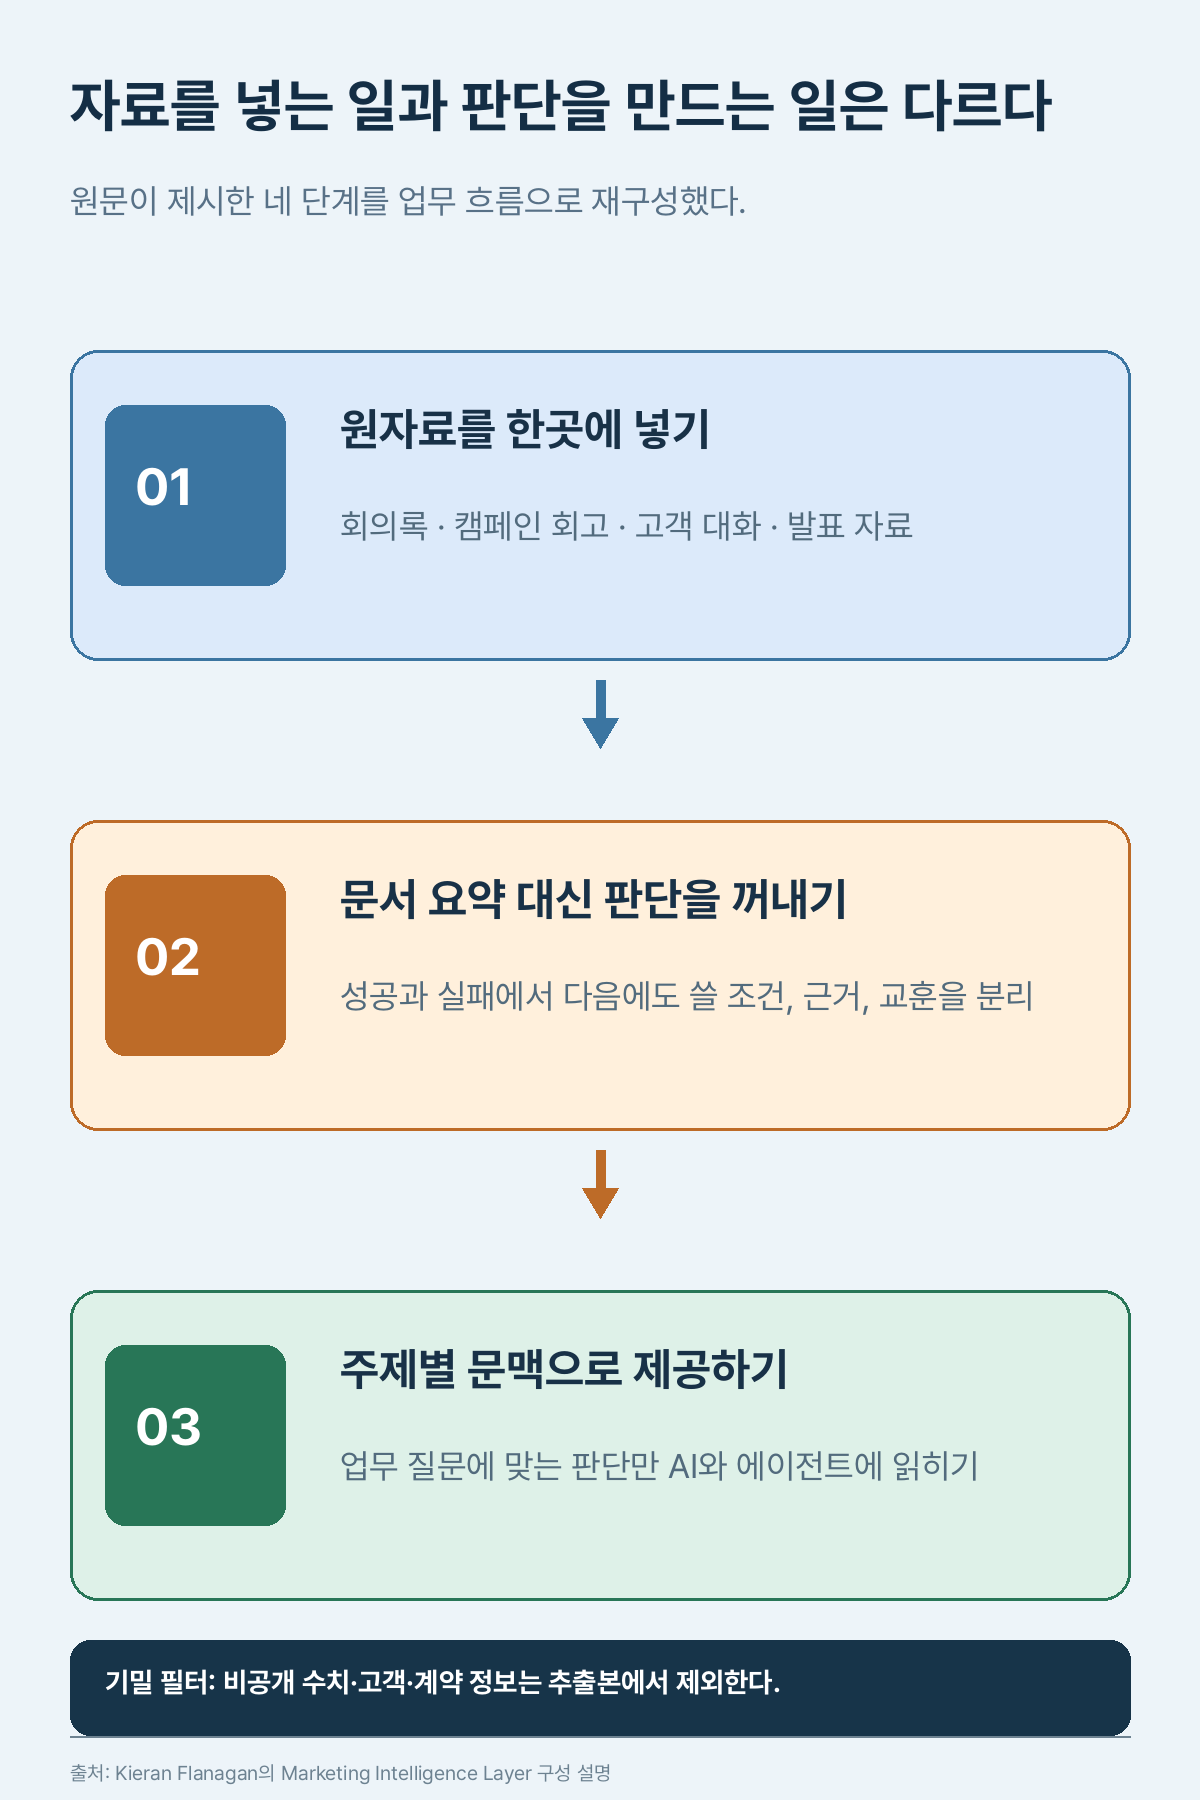
플래너건의 방식은 자료를 넣는 /raw 폴더, 판단을 뽑는 /build, 주제별 분류, 기밀 정보 필터의 네 단계로 구성된다. 회의록이나 발표 자료를 정리해서 올릴 필요는 없다. 다만 시스템이 찾아야 하는 것은 문서 전체의 짧은 요약이 아니라, 한 문서 안에 여러 개 있을 수 있는 ‘전이 가능한 배움’이다. 예컨대 한 회의록에는 채널별 예산 판단, 팀 운영 방식, 활성화 흐름의 문제처럼 서로 다른 판단이 함께 들어갈 수 있다.
‘문서 요약’과 ‘재사용할 판단’은 어떻게 다른가?
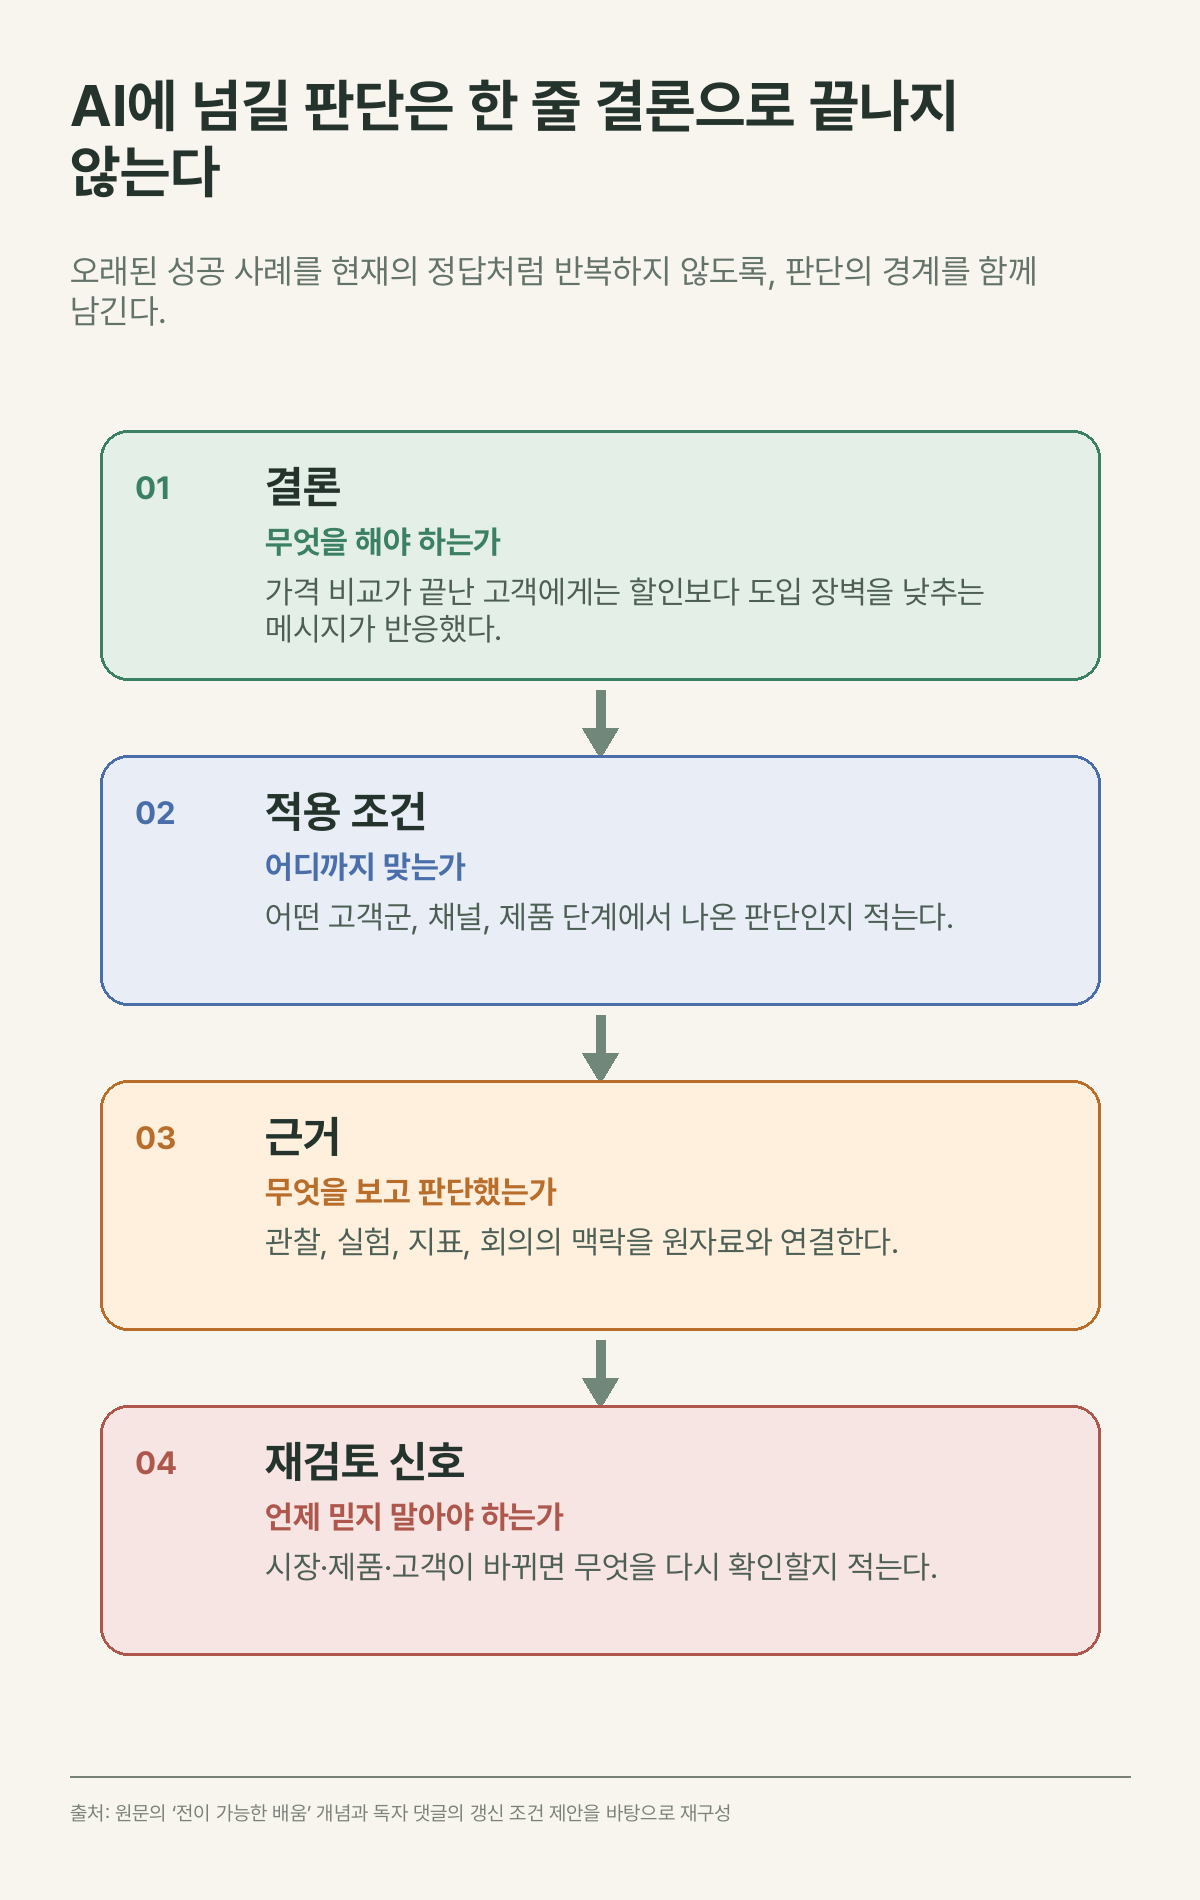
요약은 회의가 무엇을 다뤘는지 남긴다. 인텔리전스 레이어에 필요한 단위는 다음 일을 할 때 다시 꺼낼 수 있는 판단이다. “광고 예산을 줄였다”보다 “가격 비교가 끝난 잠재 고객에게는 할인보다 도입 장벽을 낮추는 메시지가 반응했다”가 더 쓸모 있다. 전자는 사건 기록이고, 후자는 다음 캠페인의 가설을 바꾼다.
그래서 팀은 각 항목에 결론만 적지 말고 적용 조건을 붙여야 한다. 어떤 고객군과 채널에서 나온 판단인지, 어떤 지표나 관찰이 근거였는지, 언제 다시 검토할지를 함께 남기면 오래된 성공 사례가 현재의 정답처럼 반복되는 일을 줄일 수 있다. 원문 댓글에서도 한 독자가 각 배움 옆에 “무엇이 이 판단을 더는 믿지 못하게 만들까”라는 필드를 두자고 제안했다. 이 항목은 AI가 과거의 승리를 과신하는 문제를 막는 실무 장치가 된다.
분류는 누가 하고, 무엇을 기준으로 하나?
원문 속 기본 레이어는 수요 창출, 유료 광고, SEO, 콘텐츠, 어트리뷰션, 제품 마케팅, 활성화, 리더십의 여덟 영역을 둔다. 하지만 문서가 쓰인 장소와 판단이 쓰일 장소는 다를 수 있다. 예를 들어 유료 광고팀의 조직 설계에 관한 배움은 광고 운영보다 리더십에 들어갈 수 있다. 분류의 기준은 자료의 형식이나 작성 부서가 아니라, 다음번 어떤 질문에 답할지를 정하는 편이 낫다.
여기서 자동 분류는 초안 작성자 역할에 가깝다. 분류가 편해도 팀의 용어와 판매 방식이 바뀌면 같은 문장을 다른 칸에 넣어야 한다. 마케팅팀은 먼저 반복되는 질문을 8개 안팎의 영역으로 정하고, 분기마다 실제 AI 질의와 맞지 않는 항목을 합치거나 나누면 된다. 모든 지식을 한 파일에 길게 붙이는 것보다 업무별로 필요한 묶음을 고르는 편이 대화창의 문맥도 관리하기 쉽다.
회사 데이터와 개인의 배움을 어디서 가를까?
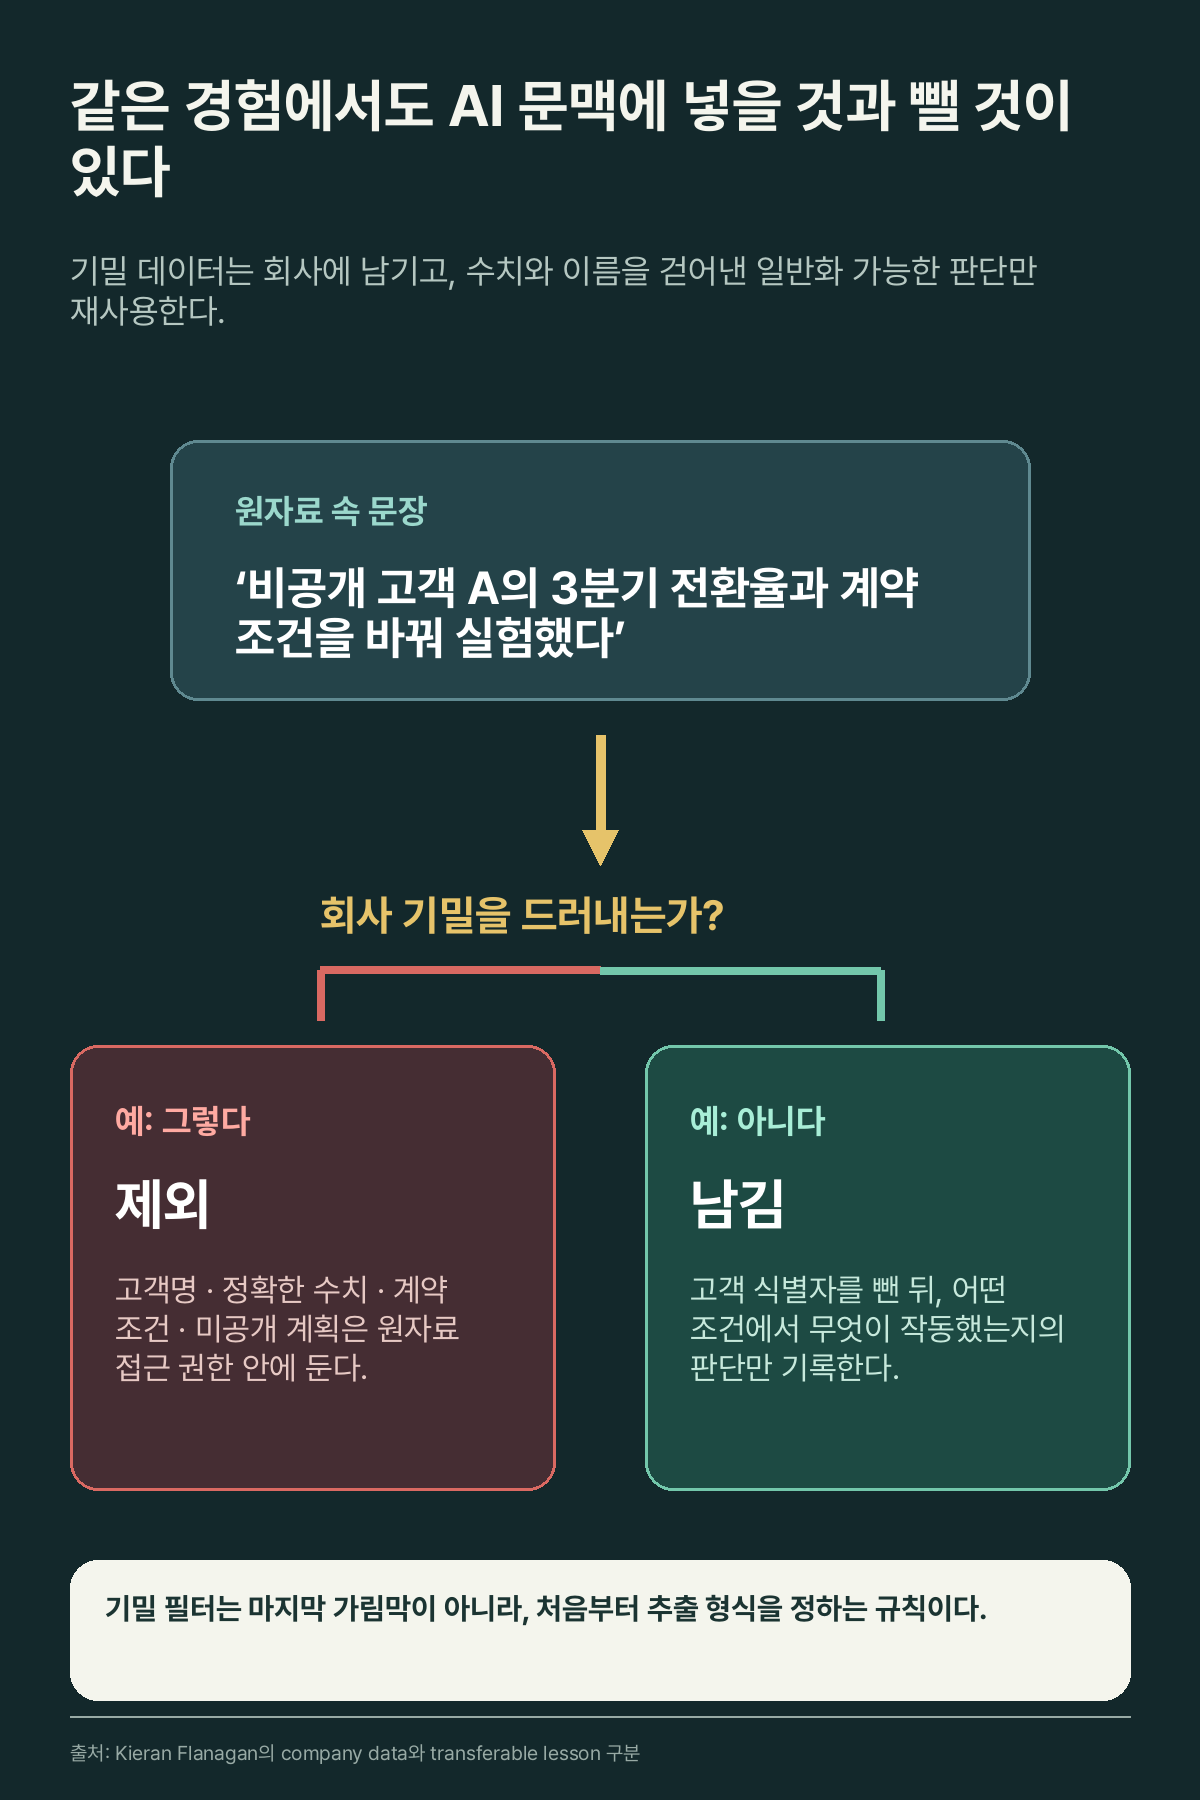
가장 중요한 경계는 기밀 정보다. 플래너건은 /build에 기밀 필터를 넣어 회사의 독점 데이터는 빼고, 그 일을 하며 얻은 일반화 가능한 배움만 남기도록 했다. 정확한 계약 조건, 고객 목록, 비공개 매출, 아직 공개하지 않은 제품 계획은 개인 문맥 레이어에 넣을 자료가 아니다. 반면 특정 수치나 고객명을 제거한 뒤에도 남는 실험 설계의 원리, 메시지 검증 순서, 조직 운영의 교훈은 별도로 다룰 수 있다.
마케팅팀이 공동 자산을 만들 때도 같은 기준이 필요하다. 원자료의 접근 권한과 AI에 넣는 추출본을 분리하고, 항목마다 소유자와 마지막 검토일을 기록해야 한다. 기밀을 삭제한 뒤 남길 문장이 너무 모호해졌다면, AI 문맥에 넣기보다 원자료 안에 두는 편이 낫다. 기밀 필터는 끝 단계의 가림막이 아니라 추출 형식부터 결정하는 규칙이다.
마케팅팀이 이번 주에 시작할 가장 작은 단위
새 지식관리 도구를 도입할 필요는 없다. 최근 캠페인 회고 한 건, 고객 인터뷰 메모 한 건, 실패한 실험 한 건을 골라 각각에서 판단을 한두 개만 추출해보면 된다. 각 판단에 적용 조건, 근거, 재검토 신호, 공개 가능 여부를 붙인 뒤 다음 기획 회의에서 AI에게 실제 질문과 함께 읽히면 된다.
이 과정을 반복하면 AI는 회사의 모든 것을 아는 비서가 되지는 않는다. 대신 팀이 이미 지불한 실험 비용과 토론 시간을 다음 질문의 출발점으로 쓸 수 있다. 답변 품질을 바꾸는 첫 작업은 프롬프트 문장을 더 길게 쓰는 일이 아니라, 회사가 어떤 판단을 왜 믿는지 꺼내 쓸 수 있게 만드는 일이다.