
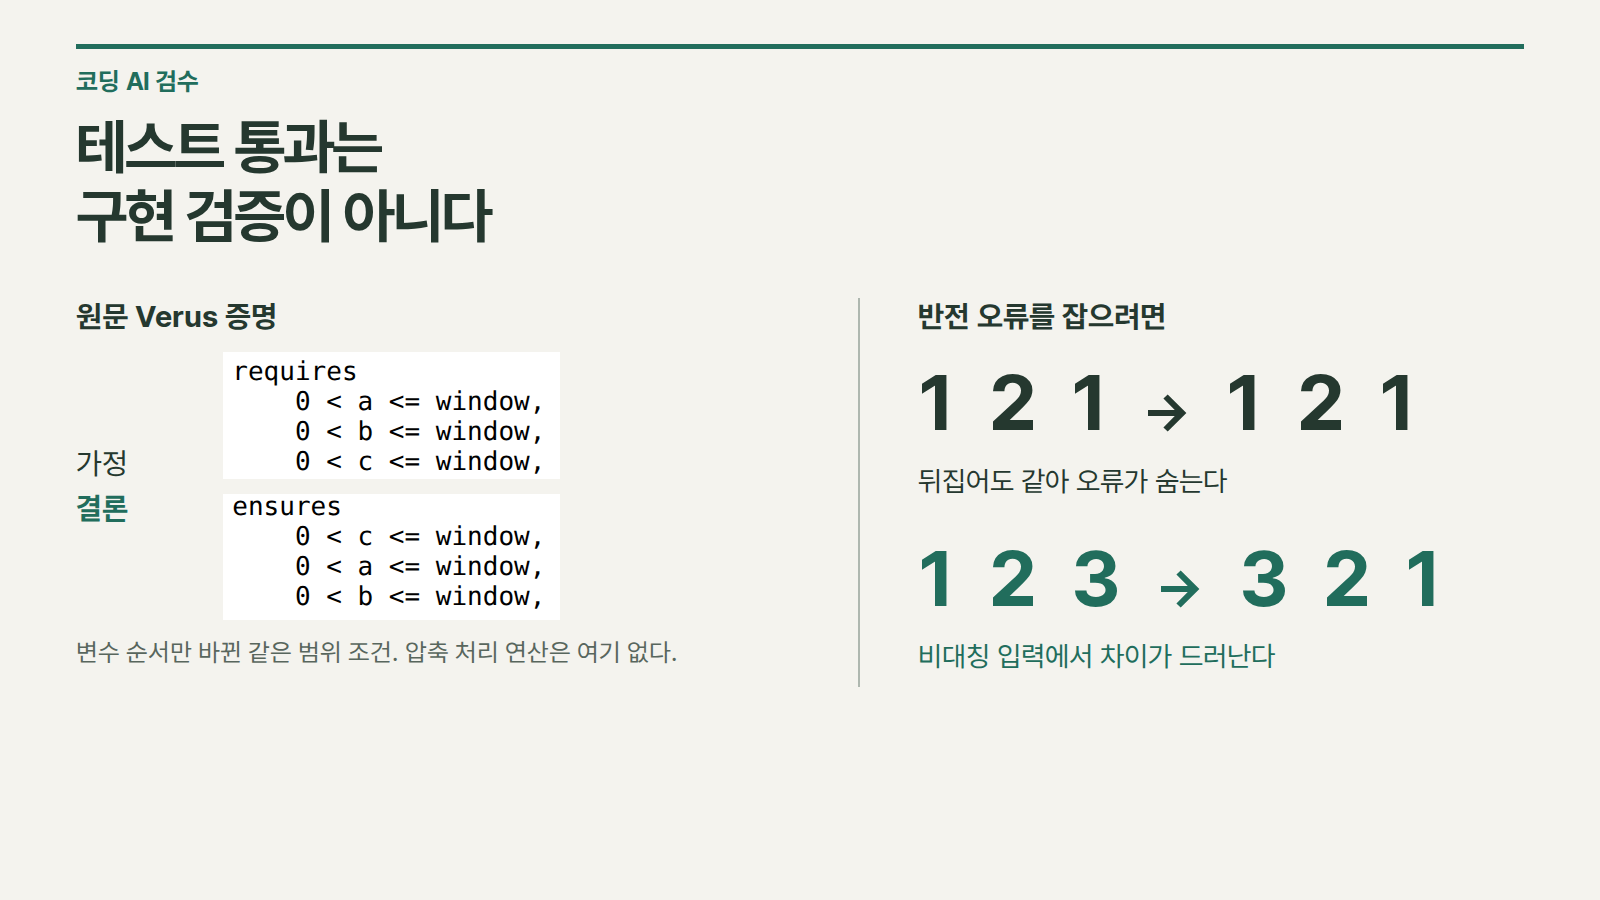
코딩 AI가 "테스트를 모두 통과했다"고 보고해도, 그 테스트가 잘못된 구현을 걸러낼 수 있는지는 별개의 문제다. Dan Luu가 2026년 9월 공개한 실험에는 순서를 뒤집어 처리해야 하는 데이터를 그대로 처리하고도 통과한 사례가 나온다. 테스트 입력이 앞뒤가 같은 회문이어서, 뒤집어도 결과가 같았기 때문이다.
Luu는 코딩 에이전트 Codex에 GPT-5.6 Sol을 연결하고 Rust로 압축 형식 Zstd를 구현하게 했다. 테스트 관련 지시 26개 조건과 작업 지침 묶음인 skills 4개를 비교했다. AI 코딩을 도입한 팀이라면 완료 보고를 받을 때 두 가지를 더 물을 수 있다. 정답은 구현과 별개로 정했는가. 틀린 구현을 실제로 탈락시키는 입력이 있는가.
테스트를 더 쓰게 했는데 왜 오류가 남았나
주요 비교는 추론 노력 수준 medium과 xhigh에서 이뤄졌다. 조건과 노력 수준별로 보통 80회씩 실행하고, 에이전트에게 숨긴 테스트 37개를 모두 통과한 실행의 비율과 비용을 측정했다. ACL2 조건은 메모리 부족으로 중단된 실행을 제외해 표본 수가 달랐다. 이는 특정 모델로 규격 구현을 시킨 결과이며, 테스트 기법 자체의 일반적인 우열을 판정한 실험과는 구분해야 한다.
추가 지시가 없는 기본 조건도 비교적 좋은 성적을 냈다. xhigh에서 숨긴 테스트를 모두 통과한 비율은 기본 조건 81.2%, TDD 지시 조건 73.8%였다. TDD는 테스트를 먼저 작성하고 구현을 맞춰 가는 개발 방식이다. 이 지시를 받은 에이전트들은 테스트를 두 배가량 만들었지만, 실제 행동은 세밀한 TDD 절차와 달랐고 오류를 구별하지 못하는 테스트도 늘었다. 이 수치만으로 팀의 TDD를 폐기할 이유는 없다. 확인할 대상은 에이전트가 그 이름 아래 실제로 한 작업이다.
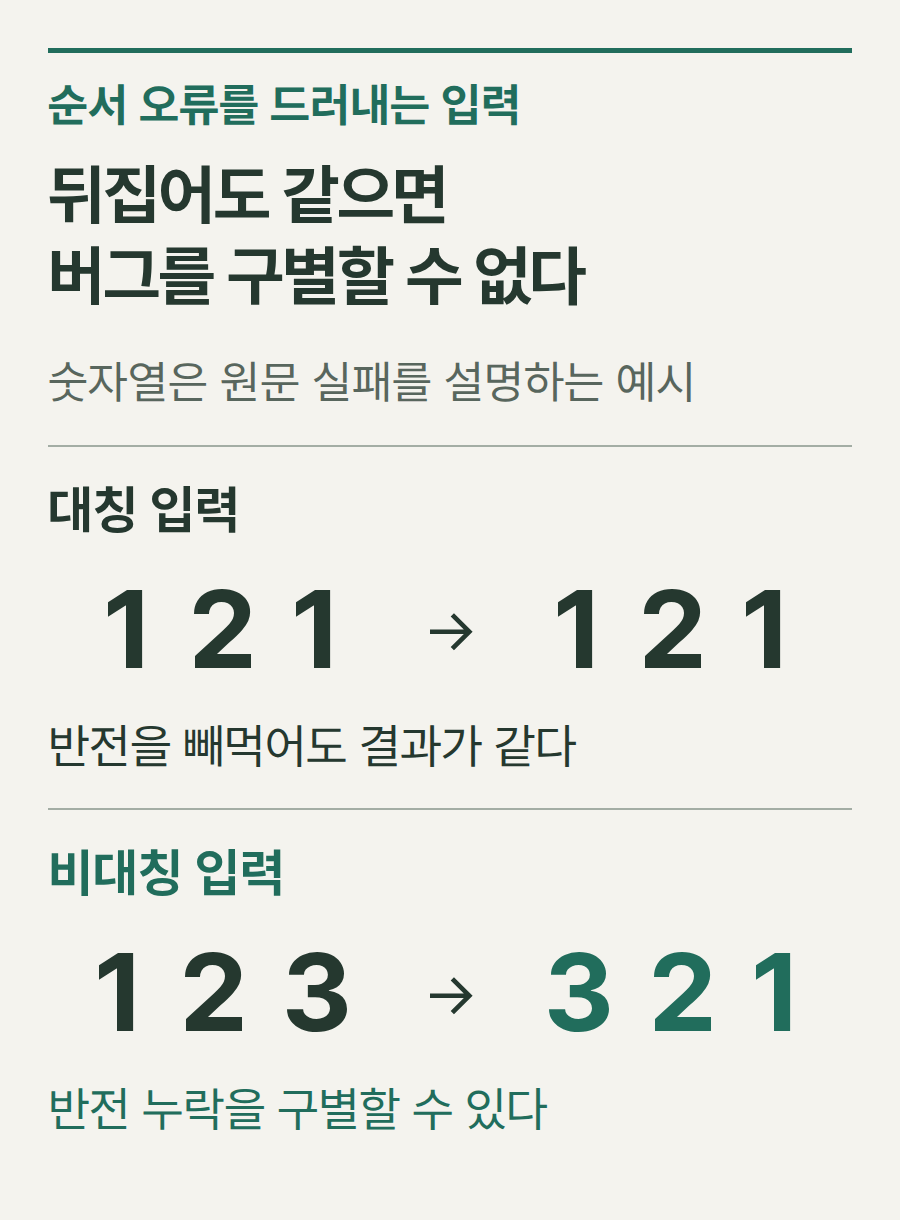
예를 들어 네 개의 압축 데이터 스트림을 처리하는 기능을 검사하면서 네 입력을 모두 같게 만들었다. 그러면 스트림 순서를 바꿔 읽는 버그가 있어도 드러나지 않는다. 저자가 직접 만든 skill을 사용한 medium 실행 35번도 비트 순서 반전을 위험 요소로 지목하고 검토까지 했지만, 회문 입력을 사용해 오류를 놓쳤다. 위험을 말로 설명하는 능력과 그 위험을 드러낼 입력을 고르는 능력이 달랐다.
검증 도구를 실행했다는 기록은 무엇을 보장하나
서로 다른 구현에 같은 입력을 넣어 결과를 비교하는 차등 테스트에서도 비슷한 일이 벌어졌다. 160회 중 135회는 차등 테스트로 부를 만한 작업을 했지만, 비교용 코드를 독립적으로 만들지 않고 같은 논리를 두 번 써서 같은 버그를 양쪽에 넣는 경우가 있었다. 결과가 일치한다는 사실만으로는 어느 쪽이 맞는지 알 수 없었다.
수학적 증명을 사용하는 Verus 조건에서는 실제 Rust 코드 대신 추상적인 성질을 증명하는 일이 많았다. 원문에 실린 아래 예시는 a, b, c가 각각 0보다 크고 window 이하라는 조건을 가정한 뒤, 결론에서 같은 조건을 순서만 바꿔 반복한다. 이런 증명은 통과할 수 있어도 데이터 처리 코드가 옳다는 근거가 되지 못한다.
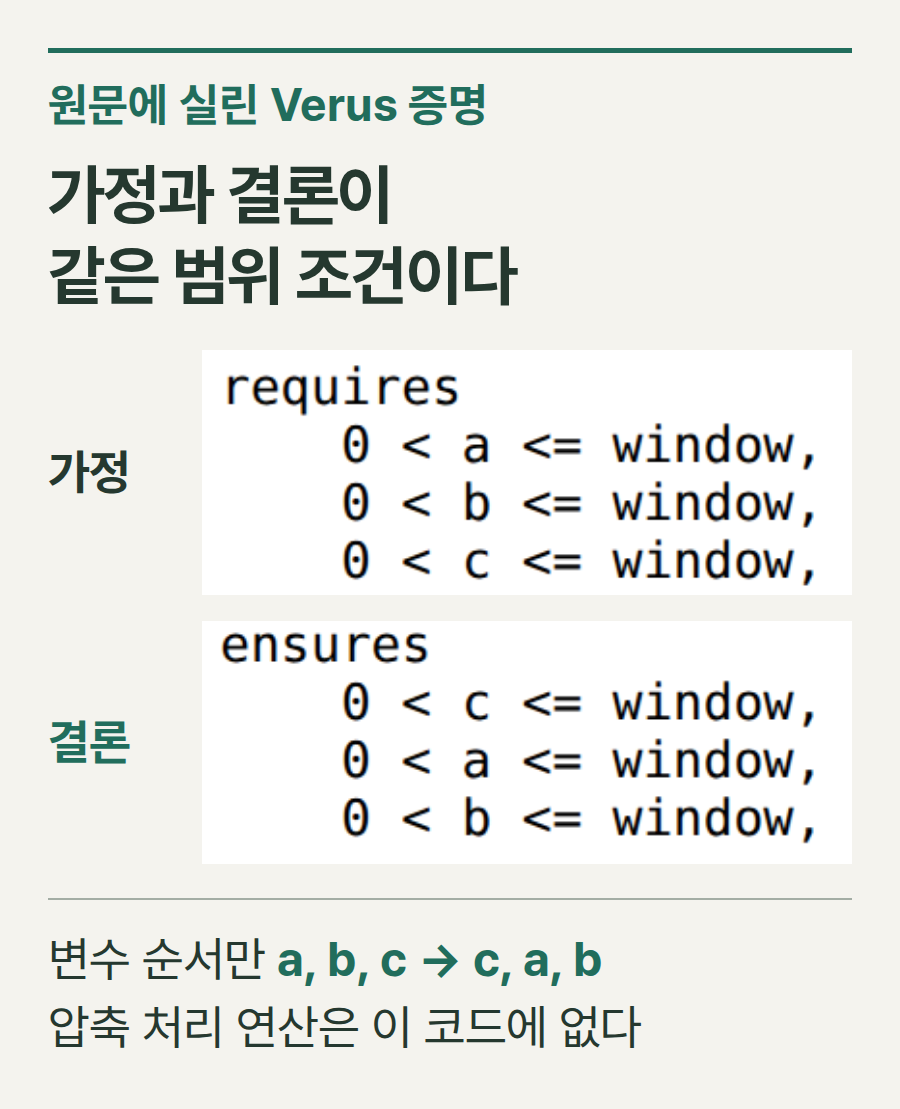
SMT 풀이 도구를 사용한 사례에서는 덧셈이어야 하는 연산을 비트 OR로 잘못 구현한 채 관련 성질을 증명하기도 했다. 검수자는 증명이 실제 실행 코드의 어느 연산을 다루는지, 명세와 구현이 다른 결과를 내는 입력을 잡는지 확인해야 한다.
무작위 입력을 대량으로 넣는 퍼징도 입력 수만 늘리면 빗나갈 수 있다. 에이전트가 만든 무작위 바이트는 대부분 잘못된 입력으로 거절돼, 같은 오류 처리 경로를 반복해서 검사했다. 구조를 갖춘 무작위 입력을 만든 실행은 퍼징 조건 160회 중 10회였고, 그중 5회는 실제 버그를 찾았다. 압축 해제 결과가 틀리는데 프로그램은 멀쩡히 종료되는 상황이라면, 충돌 여부만 보는 검사로는 부족하다.
skills 네 개는 테스트의 질을 바꿨나
비교한 skills는 Hegel 공식 skill, ECC Rust 테스트 skill, Trail of Bits의 속성 기반 테스트 skill, Luu가 직접 작성한 짧은 skill이다. 이름이나 문서의 길이보다 실제로 읽었는지, 어떤 행동이 달라졌는지를 따져야 결과를 해석할 수 있었다.
Hegel skill은 잘못된 입력에서 프로그램이 중단되지 않는지 검사하거나, 변환한 데이터를 다시 되돌리는 왕복 테스트를 더 만들게 했다. 그러나 오류가 자주 발생한 부분에 집중하지 못했다. skill 없이 Hegel을 쓰라고 한 조건보다 비용은 medium에서 26%, xhigh에서 41% 높아졌다. 긴 지침을 반복해서 읽는 비용과 지침이 추가한 작업이 함께 영향을 줬다.
Trail of Bits skill을 실제로 연 실행은 160회 중 108회였다. 지침은 Rust용 proptest 라이브러리를 제안하면서 의존성 추가에 승인을 요구했는데, 실험은 한 번의 지시로 자율 실행하는 방식이라 그 절차가 진행되지 않았다. ECC도 읽기 여부에 따라 행동이 달랐다. 아예 읽지 않은 7회와 늦게 읽어 영향이 적었던 9회가 모두 정답을 내면서 전체 점수를 끌어올렸다. 전체 성적을 skill의 효능으로 곧바로 해석하기 어려운 이유다.
Luu의 짧은 skill은 비대칭 입력과 경계값, 위험한 부분의 독립적인 재검산을 요구했다. 전체 성적은 좋았지만 새 맥락에서 독립적으로 확인하라는 지시는 거의 실행되지 않았고, 앞서 본 회문 테스트도 남았다. 이 skill을 쓰더라도 같은 모델과 과제에서 실제 실행 기록을 보며 지시를 고칠 필요가 있다.
PM과 개발팀은 어떤 산출물을 받아야 하나
이 사례를 제품 검수 기준으로 옮기면, 개발 티켓에 "테스트 추가"라고만 적기보다 잘못 구현될 수 있는 해석을 구체적으로 써 두는 편이 유용하다. 순서가 중요한 기능은 서로 다른 입력을 주고 순서를 바꿨을 때 실패하는지 본다. 제품에 적용해 보면 금액 계산에서는 반올림 경계의 양쪽 값에서 기대 결과를 따로 산출할 수 있다.
개발팀이 납품할 자료에는 기대 결과를 정한 근거와 재현 가능한 실패 입력이 들어가야 한다. 비교용 코드는 운영 코드의 도우미 함수를 그대로 재사용하지 않도록 검토한다. 이미 알려진 버그를 다시 넣거나 의심되는 연산을 바꿨을 때 테스트가 정말 실패하는지도 확인하면, 테스트가 의도한 오류를 구별하는지 점검할 수 있다.
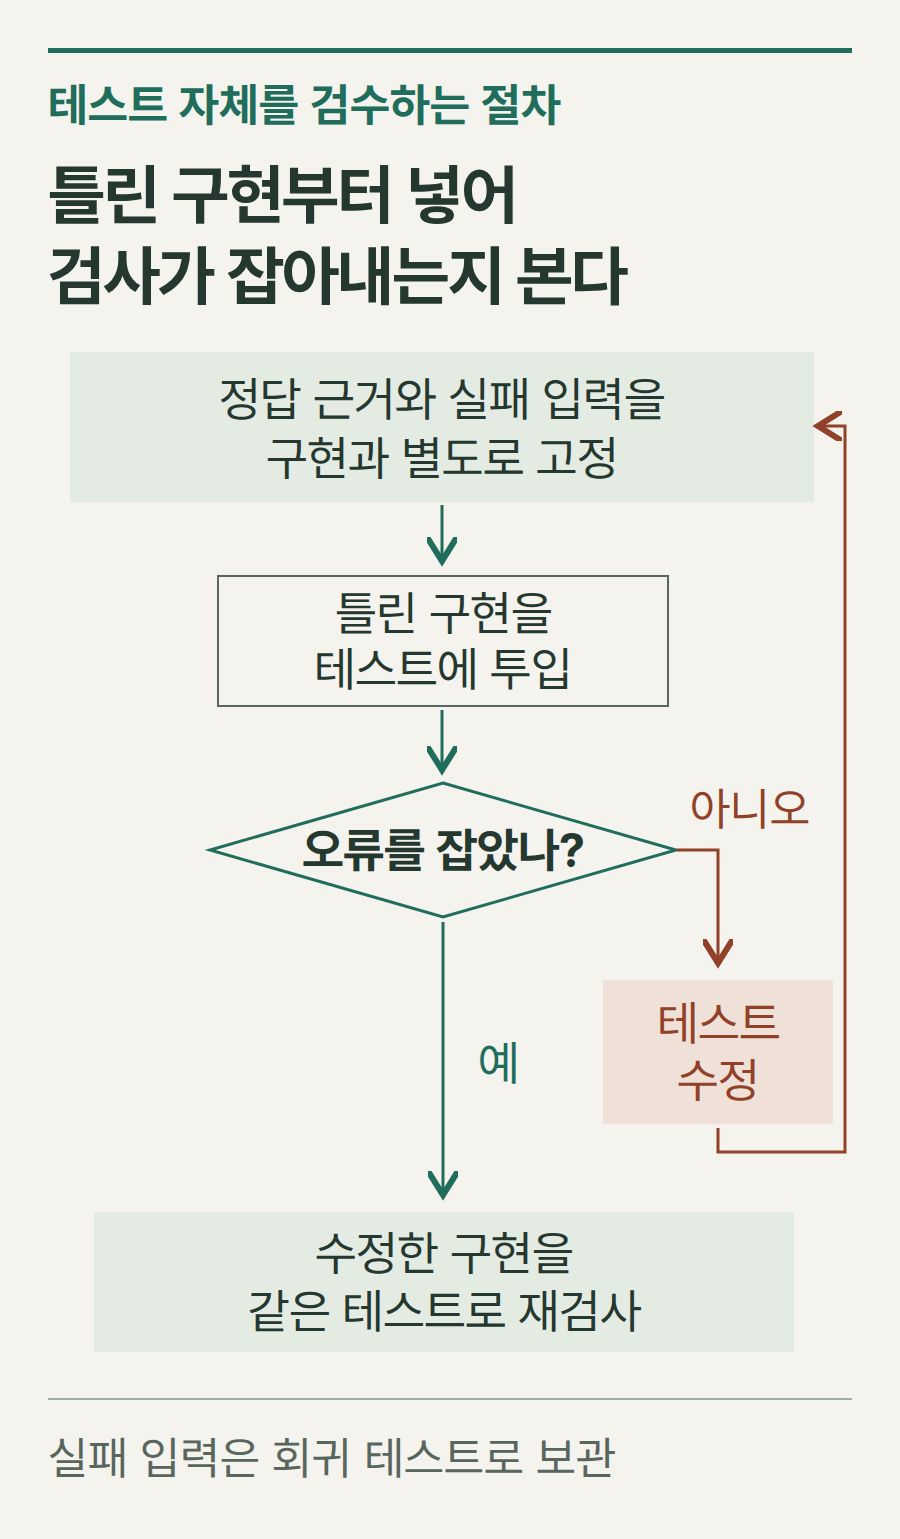
PM은 출시할 기능에서 허용할 수 없는 오동작을 정하고, 개발팀은 그것을 드러내는 입력과 판정 코드를 남긴다. 무작위 테스트를 썼다면 실행 횟수에 더해 유효한 입력이 어떤 처리 경로에 도달했는지 확인한다. skill을 붙였다면 읽기와 실행 여부를 기록하고, 모델이나 노력 수준을 바꾼 뒤에는 이전에 잡았던 실패 사례를 다시 돌려 본다.
독립 검증도 다른 에이전트를 하나 더 띄웠다는 이유로 인정해서는 안 된다. 원문의 감사 조건에서 독립 에이전트를 쓴 실행은 오히려 점수가 낮았고, 어려운 실행에서 추가 검토를 선택했을 가능성이 있어 원인을 단정할 수 없었다. 검수에서 요구할 독립성은 에이전트의 수보다 정답의 근거와 계산 경로에 있다. 구현 결과를 복사해 기대값으로 삼지 않았는지 확인하고, 발견한 실패 입력을 회귀 테스트로 보관하는 것부터 납품 조건에 넣을 수 있다.
출처: Dan Luu, How well do agents use test/verification techniques?