
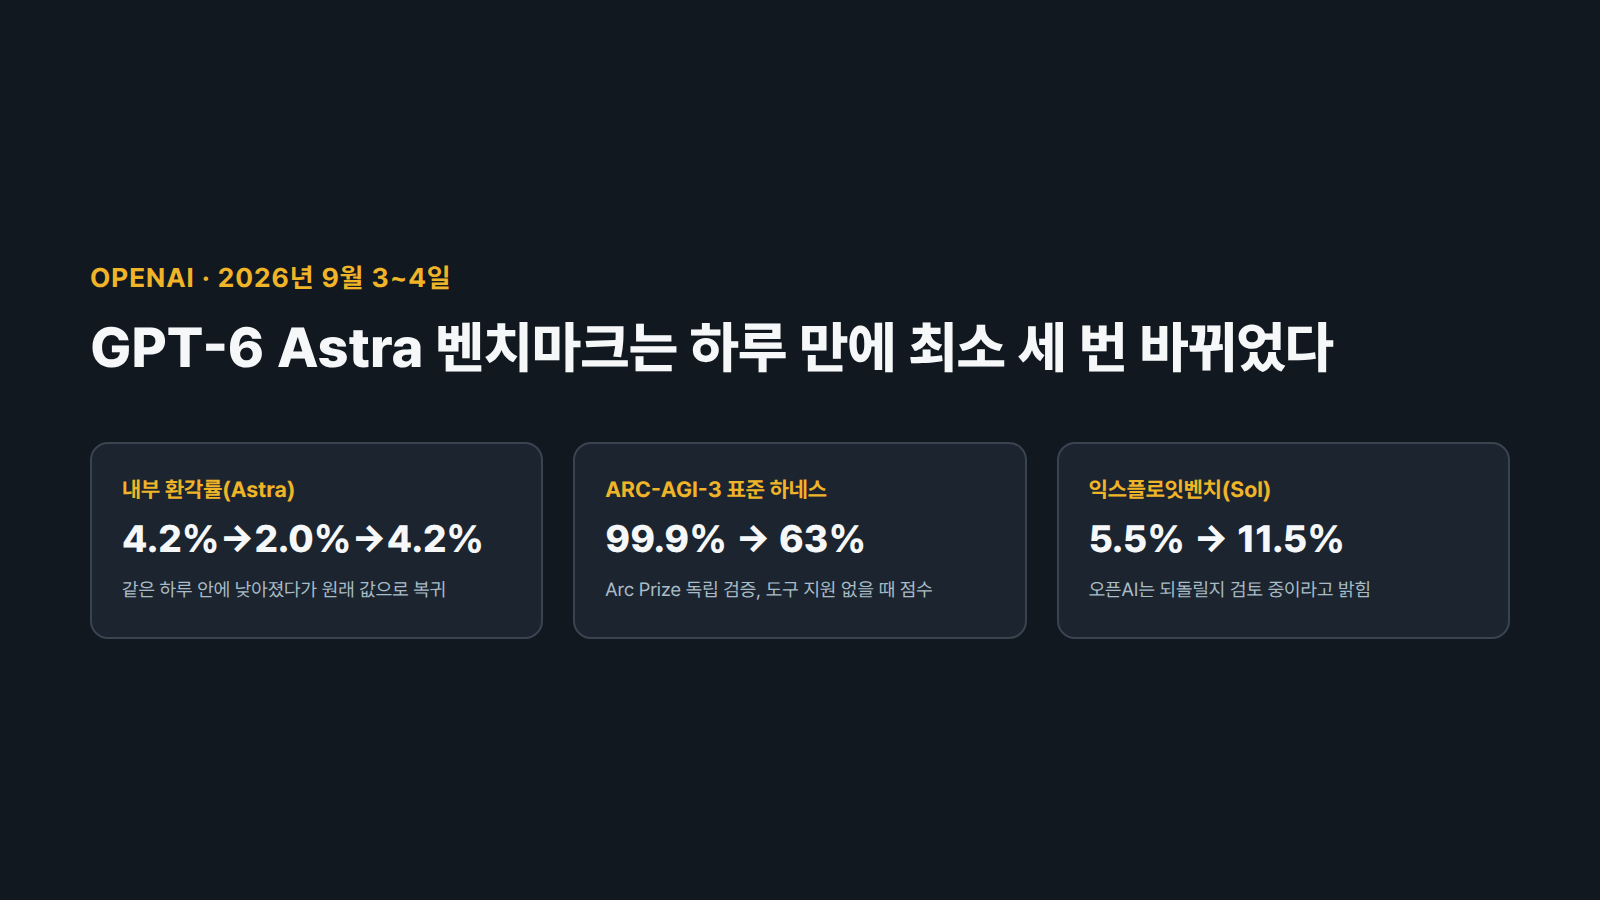
오픈AI가 2026년 9월 3일 공개한 GPT-6 Astra 발표문의 벤치마크 수치는 하루도 지나지 않아 여러 차례 바뀌었다. 내부 환각률 벤치마크 점수는 같은 날 안에 낮아졌다가 다시 원래 값으로 돌아왔고, 경쟁 모델인 앤스로픽 Claude Fable 5.1의 수학 점수는 한때 10%포인트 가까이 낮게 표시됐다가 되돌아왔다. 이 변화를 처음 짚어낸 곳은 포춘의 시니어 AI 기자 에밀리 포를리니다.
포를리니는 아카이브가 저장한 발표문 스냅샷 네 개를 시간순으로 대조해, 같은 벤치마크의 같은 항목이 시점마다 다른 숫자를 냈다는 사실을 확인했다. 오픈AI는 이 변화가 벤치마크 조작이 아니라 평가 정확도를 높이는 과정이라고 설명했지만, 어떤 조건에서 어떤 숫자가 최종인지는 발표문에 명시하지 않았다.

발표문이 두 시간 늦게 뜬 사이 무슨 일이 있었나
오픈AI는 이 발표문을 미국 동부시간 오후 2시에 공개할 계획이었지만, 실제로 누구나 볼 수 있게 된 시점은 그로부터 거의 두 시간 뒤였다. 오픈AI 공식 X 계정이 오후 3시 32분에 링크를 올렸을 때도 페이지는 오류를 냈고, 오후 3시 50분에는 샘 올트먼 최고경영자가 직접 "블로그 포스트를 배포하는 데 작은 문제가 있었지만 내용은 정말 좋다"고 썼다. 그 뒤로도 한동안 여러 사용자가 같은 오류를 겪었고, 포춘도 마찬가지였다.
오픈AI는 실제로는 오후 2시 직후에 글을 올렸다가 곧바로 내렸다고 나중에 밝혔다. 내린 이유는 공개하지 않았고, 벤치마크 수치와는 무관하다고만 설명했다. 처음에는 콘텐츠관리시스템 버그라고 했다가, 다시 인터넷 장애였다고 말을 바꿨다. 그리고 글을 다시 올렸을 때는 오전 버전과 다른 평가 수치가 담겨 있었고, 그중 일부는 그 이후로도 계속 바뀌었다.
어떤 숫자가 어떻게 바뀌었나
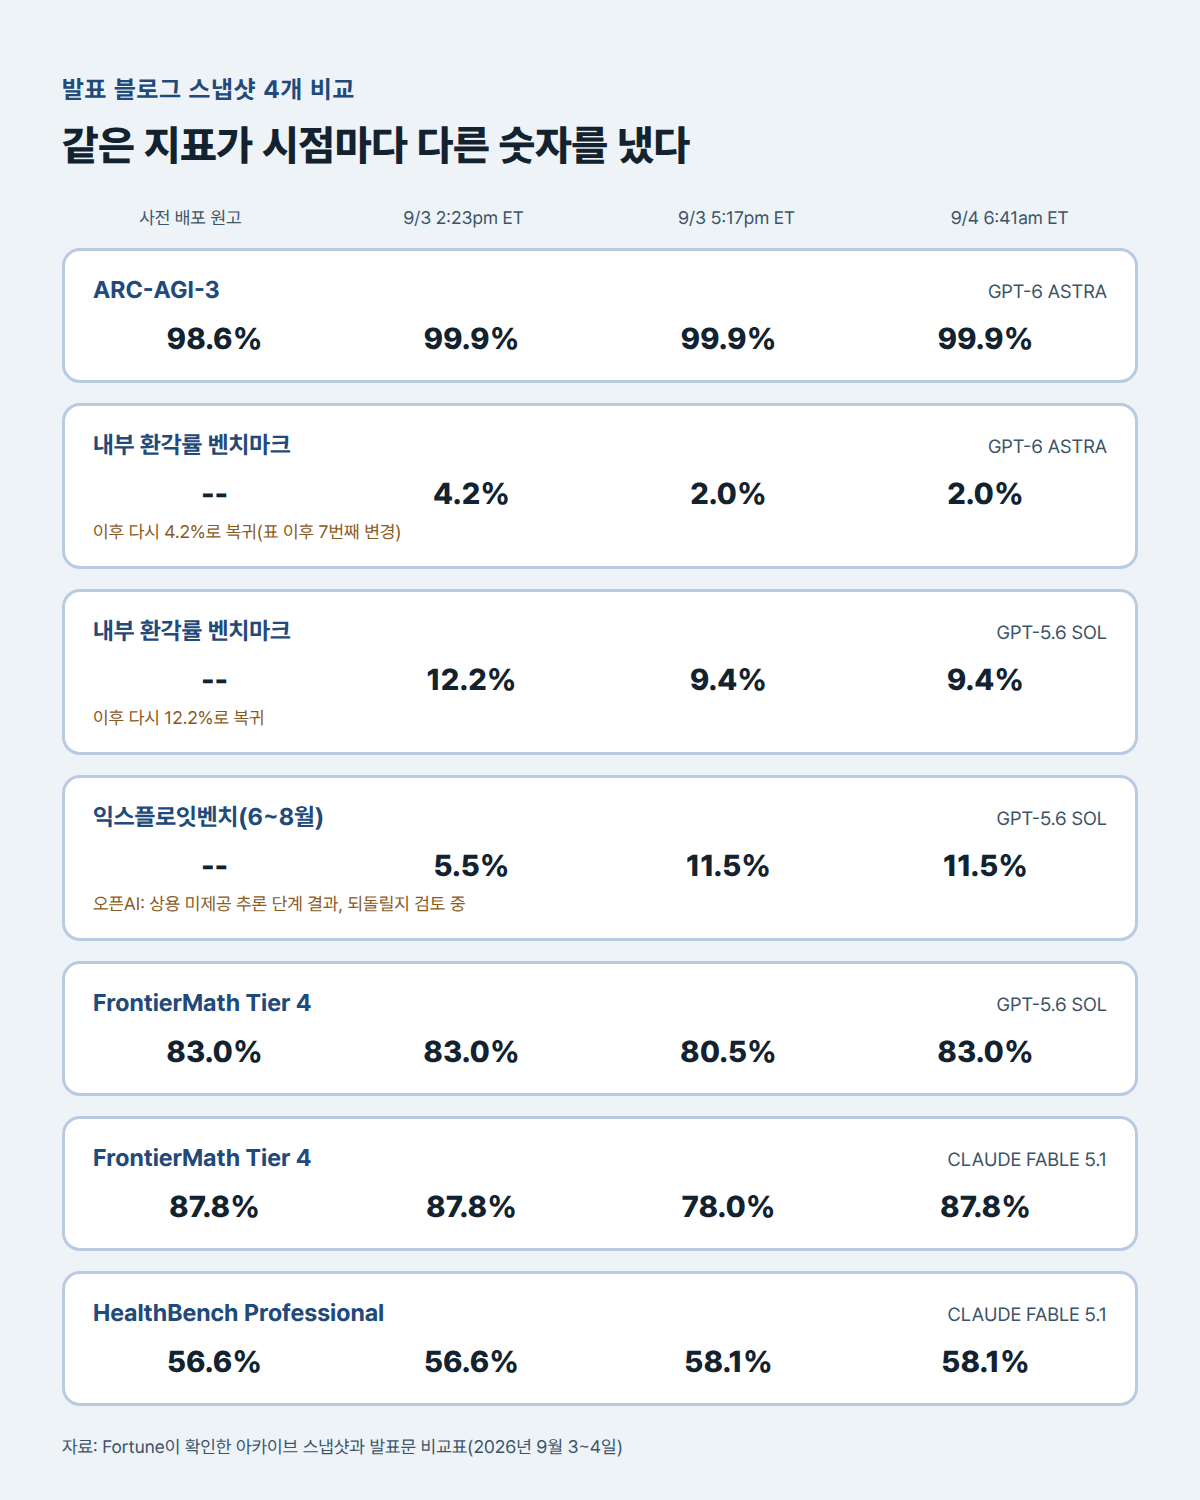
가장 눈에 띄는 변화는 내부 환각률 벤치마크였다. 오후 2시 23분 스냅샷에서 Astra의 환각률은 4.2%였고 이 값은 여러 스냅샷 동안 유지되다가, 오픈AI가 최종본을 트윗으로 올리기 약 10분 전인 오후 3시 11분 스냅샷까지도 4.2%로 남아 있었다. 그런데 누구나 글을 볼 수 있게 된 이후인 오후 5시 20분 스냅샷에서 이 값이 2.0%로 절반이 됐다. 직전 모델인 GPT-5.6 Sol의 환각률도 12.2%에서 9.4%로 낮아졌다. 이 수치는 이후에도 계속 바뀌어, 포춘이 기사를 쓴 시점에는 두 모델 모두 처음 값인 4.2%와 12.2%로 되돌아가 있었다.
보안 평가인 익스플로잇벤치에서는 반대 방향 조정이 있었다. GPT-5.6 Sol의 점수가 초판 5.5%에서 이후 버전 11.5%로 크게 올랐다. 오픈AI는 11.5%라는 결과가 실제 상용 서비스에는 제공되지 않는 더 높은 추론 단계에서 나온 값이라며, 이 숫자를 5.5%로 되돌릴지 검토하고 있다고 밝혔다.
수학 벤치마크인 FrontierMath Tier 4(v2)에서는 Astra 자체 점수는 97.6%로 스냅샷 내내 그대로였지만, 비교 대상인 Sol과 Fable 5.1의 점수가 잠깐씩 흔들렸다. Fable 5.1은 초판 87.8%에서 오후 5시 17분 78.0%까지 떨어졌다가 다시 올라갔고, Sol도 83.0%에서 80.5%로 내려갔다가 83.0%로 복귀했다. 결과적으로 이 구간에서는 Astra가 실제보다 두 경쟁 모델 대비 수학 성능이 크게 앞서 보이는 시간대가 있었던 셈이다. 반대로 앤스로픽에 유리하게 바뀐 값도 있다. 의료 분야 평가인 HealthBench Professional에서 Claude Fable 5.1은 56.6%에서 58.1%로, Claude Opus 5는 54.5%에서 56.4%로 올랐다. 오픈AI가 직접 실행하지 않고 공개된 리더보드 값을 인용하는 경쟁사 점수이기 때문에, 이 항목은 오픈AI에 불리한 방향으로 조정된 사례로 남는다.
발표 전부터 이미 숫자가 움직이고 있었다
수치 변경은 오픈AI가 오후 2시에 첫 글을 올리기 전부터 시작됐다. 오픈AI가 사전에 포춘을 비롯한 언론에 제공한 엠바고 원고에는 Astra의 ARC-AGI-3 점수가 98.6%로 적혀 있었지만, 실제 공개된 글에는 99.99%로 올라 있었다. 오픈AI는 "발표 전에는 항상 평가를 재검증하므로 초안과 최종본 사이에 조정이 있는 것은 자연스러운 일"이라고 답했다.
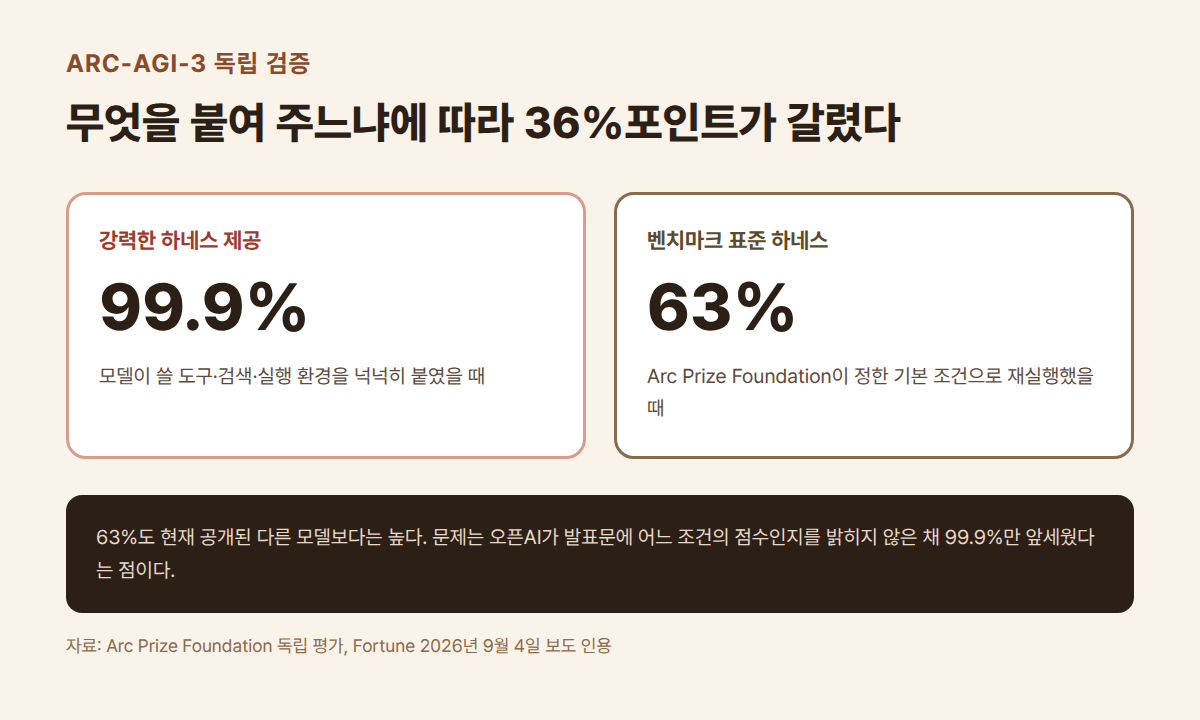
이 벤치마크를 만든 Arc Prize Foundation은 독립적으로 Astra를 재평가해, 모델에 강력한 하네스(작업 수행에 쓸 수 있는 도구 모음)를 붙였을 때는 99.9%가 나왔지만 벤치마크의 표준 하네스로 돌리면 63%까지 떨어진다고 밝혔다. 63%는 현재 공개된 다른 모델보다는 여전히 높은 점수지만, 오픈AI가 발표문에서 어떤 조건의 점수인지 밝히지 않은 채 99.9%만 앞세웠다는 점은 그대로 남는다. 오픈AI는 "하네스, 추론 단계 등 여러 요인이 평가에 영향을 준다"고만 답했다.
왜 벤치마크 점수는 이렇게 쉽게 흔들리나
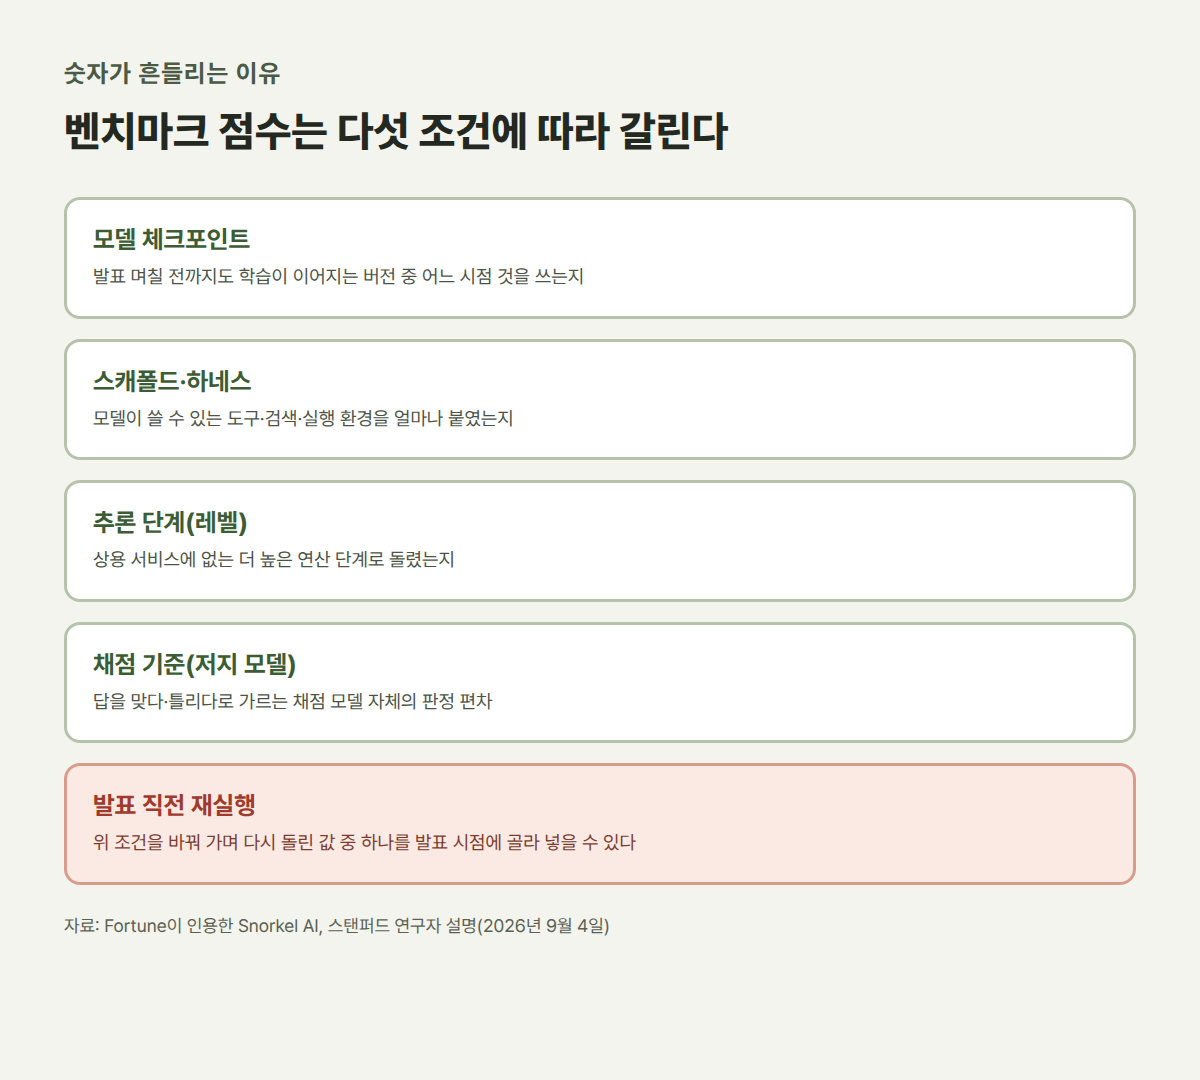
스노클AI에서 벤치마크·평가 연구를 이끄는 빈센트 선 첸은 모델 출시 직전 몇 시간 사이에 벤치마크 점수가 바뀌는 일 자체는 드물지 않다고 설명했다. 점수는 모델 체크포인트, 스캐폴드와 하네스 구성, 얼마나 많은 시간과 연산을 쓰도록 허용했는지, 채점을 맡는 저지 모델의 판정 편차 같은 여러 조건이 합쳐진 결과이기 때문이다. 이 조건들은 출시 직전까지도 계속 조정되므로 숫자가 흔들리는 것 자체는 놀랍지 않다는 뜻이다. 다만 그는 회사가 벤치마크 점수를 수정할 때 무엇이 바뀌었는지 함께 밝히는 업계 관행이 자리 잡아야, 연구자들이 결과를 제대로 해석할 수 있다고 덧붙였다.
스탠퍼드 지능형시스템연구소와 스탠퍼드 신뢰가능AI연구소의 앙카 로이엘과 마이크 하디는 이런 재실행이 "짧은 시간 안에 할 수 있고, 마케팅에도 유리하다"고 지적했다. 이들은 오픈AI가 평가 방식을 더 자세히 설명해야 할 시스템 카드조차 내부 환각률 벤치마크에 대해 "평가 문항 수조차 밝히지 않을 만큼 세부 정보가 거의 없다"고 비판했다. 코딩 능력을 재는 Terminal-Bench 4.0에서 Astra 점수가 57.7%에서 57.9%로 미세하게 오른 것도, 오픈AI가 발표 직전까지 평가를 다시 돌리며 더 나은 숫자로 바꿔 넣은 정황으로 볼 수 있다는 설명이다.
업계 전체가 안고 있는 문제다
벤치마크 신뢰성 논란은 이번이 처음이 아니다. 2025년 메타는 라마4 모델의 벤치마크 점수를 실제 공개 버전이 아닌 내부 버전으로 부풀렸다는 의혹을 부인했다. 당시 메타의 최고AI과학자였던 얀 르쿤은 이후 회사가 벤치마크 결과를 손질했다고 인정했다. 오픈AI 대변인은 이번 사안에 대해 "평가 결과에는 정확한 체크포인트, 스캐폴드, 실행 조건에 따라 몇 퍼센트포인트의 잡음이 있기 마련"이라며 "발표 블로그를 위해 수정한 것은 사용자가 의미 있는 비교를 할 수 있도록 우리가 가진 최선의 성능 추정치를 반영하기 위해서였다"고 밝혔다.
경쟁이 치열해질수록 회사들은 더 빠른 주기로 모델을 내놓으며 서로 앞서려 하고, 그 과정에서 표준화된 벤치마크로 성능을 재는 일 자체의 한계와 조작 가능성에 대한 우려도 함께 커지고 있다. 벤치마크 순위는 고객 유치와 인재 채용에도 영향을 주는 지표이기 때문에, 발표 시점의 숫자 하나만 보고 어떤 모델이 어떤 업무에 더 낫다고 판단하기보다는 그 숫자가 어떤 조건에서 나온 것인지부터 확인하는 편이 안전하다.