
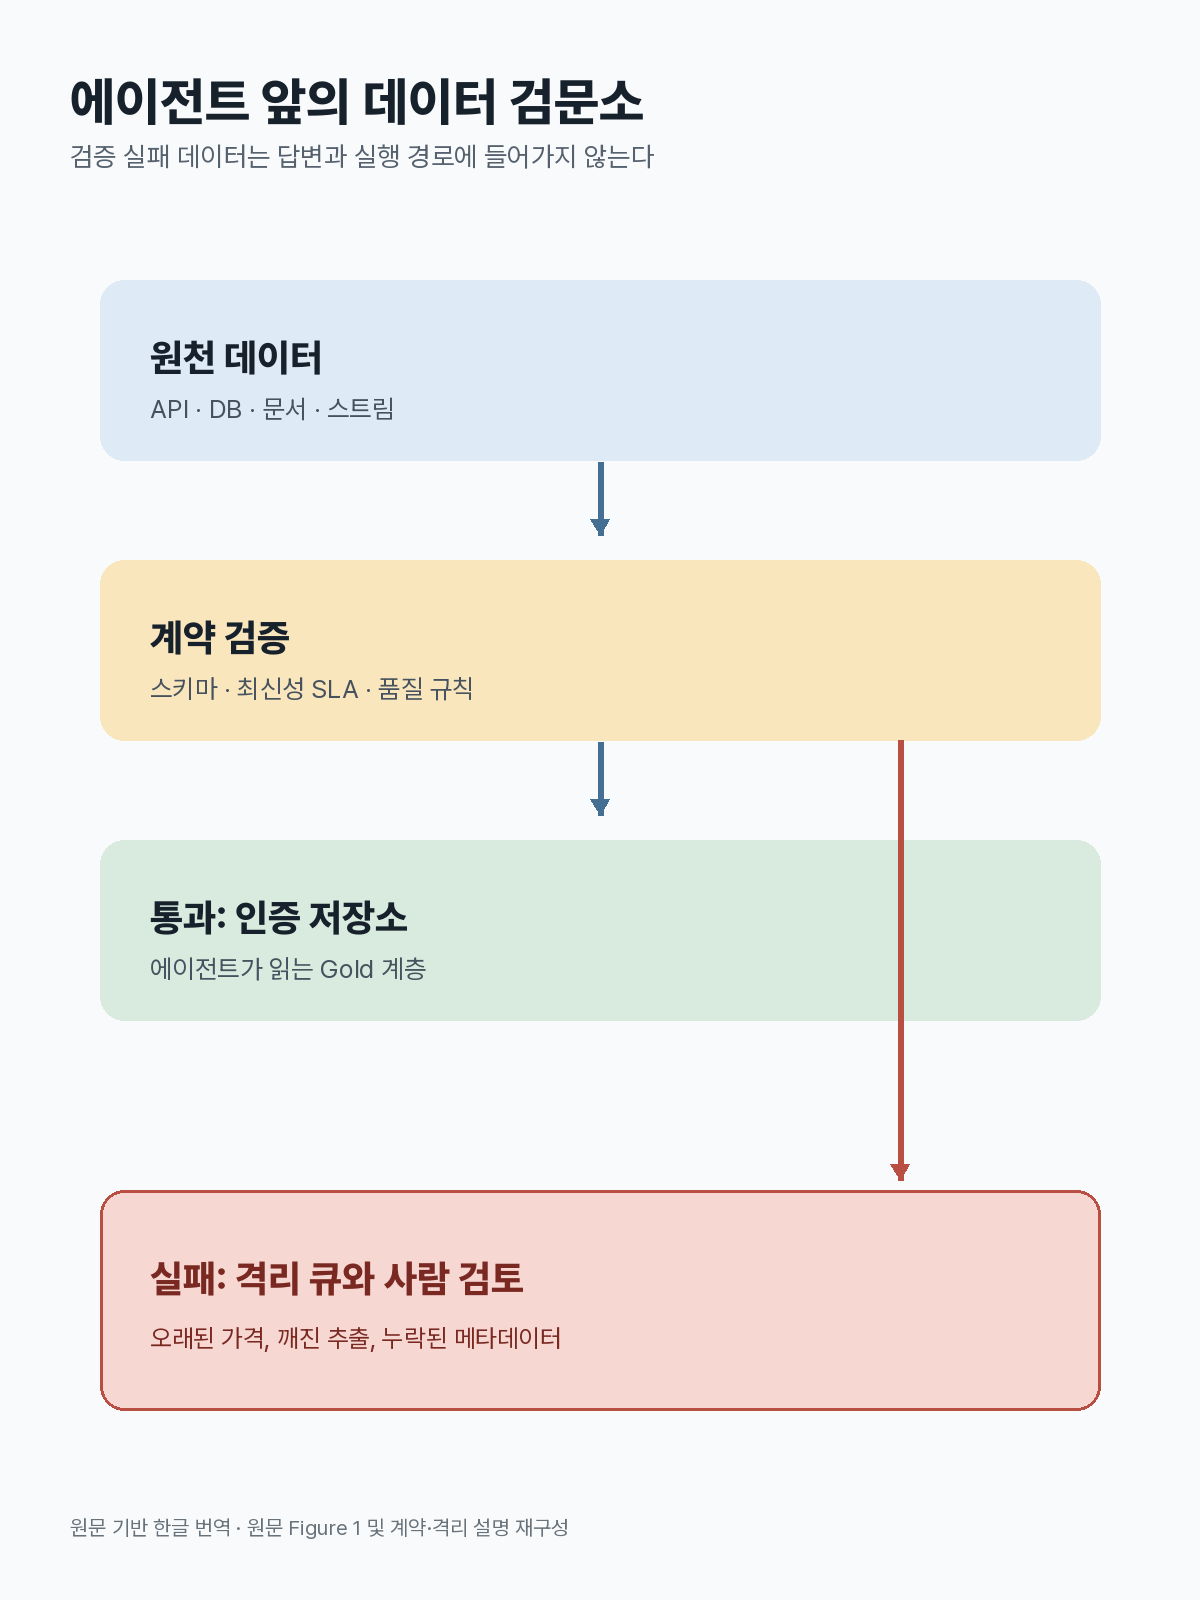
AI 에이전트를 업무에 붙이는 팀은 대개 모델, 프레임워크, 도구 연결부터 고른다. 하지만 에이전트가 가격을 안내하고, 주문 상태를 확인하고, 티켓을 만드는 순간 더 먼저 확인할 대상은 데이터다. 사람은 낯선 수치나 오래된 문서를 보고 동료에게 물어볼 수 있지만, 에이전트는 주어진 값을 바탕으로 다음 작업을 진행한다.
Martin Fowler에 실린 Pramod Sadalage와 Prem Chandrasekaran의 글은 이 차이를 다섯 가지 데이터 속성으로 정리한다. 에이전트가 쓸 데이터는 신뢰할 수 있고, 맥락이 있으며, 추적 가능하고, 권한이 통제되며, 실제 업무를 수행할 수 있어야 한다. 다섯 항목은 체크리스트라기보다 사람의 암묵지를 시스템 설계로 옮기는 일이다.
1. 신뢰: 최신성은 값이 아니라 적재 성공 시각으로 잰다
가격이 49.99달러에서 59.99달러로 바뀌었는데, 에이전트가 하루 전 데이터로 고객에게 전 가격을 제시했다고 하자. 모델은 조회와 답변을 정확히 수행했어도 손실은 발생한다. 원문은 이를 막기 위해 데이터 계약에 타입, 허용값, 품질 규칙과 함께 최신성 SLA를 넣으라고 제안한다.
중요한 기준은 값이 마지막으로 바뀐 시각이 아니라 파이프라인이 마지막으로 성공한 시각이다. 값이 바뀌지 않았다는 이유로 적재 장애를 놓치면 안 된다. 문서 검색용 임베딩도 같다. 정책 문서가 바뀐 뒤 재색인이 멈췄다면, 이전 문서를 검색하는 에이전트는 오래된 가격을 읽는 에이전트와 같은 방식으로 틀린 답을 낸다.

2. 맥락: ‘매출’의 뜻을 모델이 추측하게 두지 않는다
“3분기 제품 X 매출”이라는 질문에는 순매출인지 총매출인지, 회계연도가 언제 시작하는지, 어느 주문과 상품을 연결하는지가 숨어 있다. 분석가는 조직의 관례와 과거 쿼리로 빈칸을 메우지만, 에이전트는 테이블명과 조인 경로를 그럴듯하게 추측할 수 있다.
그래서 지표 정의, 엔터티 관계, 실행 가능한 업무 역량을 버전 관리되는 정의로 분리한다. 지표 모델은 매출 산식과 유효한 차원을, 도메인 모델은 고객·주문·상품의 관계를, 역량 모델은 읽기와 쓰기를 어디까지 허용하는지를 선언한다. 에이전트가 원본 스키마를 직접 해석하는 대신 이 정의를 통과하게 하면, 모델의 추측을 줄이고 정의 변경의 책임자도 분명해진다.
3. 추적: 로그에 ‘무엇’뿐 아니라 ‘왜’를 남긴다
자율 에이전트가 30초 만에 승인한 거래를 여섯 달 뒤 감사해야 한다면, 서비스 계정의 접속 시각만으로는 부족하다. 어떤 고객 데이터와 제재 목록, 어떤 정책 조건을 어떤 순서로 확인했는지, 최종 결정에 어떤 근거가 붙었는지가 하나의 실행 추적에 남아야 한다.
원문은 분산 시스템의 trace와 span 모델을 에이전트 의사결정에 적용한다. 도구 호출, 참조한 출처, 적용한 규칙, 결과와 결정이 연결돼야 사후에 이유를 재구성할 수 있다. 관측은 자율성이 커진 뒤 추가할 기능이 아니라, 추천만 하는 초기 단계부터 넣을 기반이다.
4. 거버넌스: 넓은 서비스 계정 대신 위임된 짧은 권한을 쓴다
에이전트가 개인 고객 정보를 읽고 외부로 메시지를 보낼 수 있으면, 악성 문서나 웹페이지의 지시가 프롬프트 인젝션을 통해 데이터를 빼내는 경로가 생긴다. 원문은 사용자 권한을 위임하고, 특정 작업에만 쓰는 짧은 만료 토큰을 발급하며, 최소 권한을 적용하는 방식을 제시한다.
실행 권한은 문서 검색 결과가 결정해서도 안 된다. 검색된 정책 문서는 제안의 근거가 될 수 있지만, 환불이나 티켓 생성 같은 작업의 허용 여부는 미리 선언된 사전조건을 현재 상태에 대조해 판단해야 한다. 문서가 바뀌면 그 문서에서 뽑은 규칙을 사람 검토 대기열로 보내는 흐름도 필요하다.
5. 실행성: 검색, 실시간 조회, 쓰기 작업을 같은 권한으로 묶지 않는다
RAG는 문서를 찾아줄 수 있지만 현재 결제 서비스의 상태를 확인하거나 고객 지원 티켓을 만들지는 못한다. 원문은 접근을 검색·인용, 실시간 읽기, 상태를 바꾸는 쓰기 작업으로 나눠 올리라고 설명한다. 각 단계가 늘릴 수 있는 가치와 피해 범위가 다르기 때문이다.
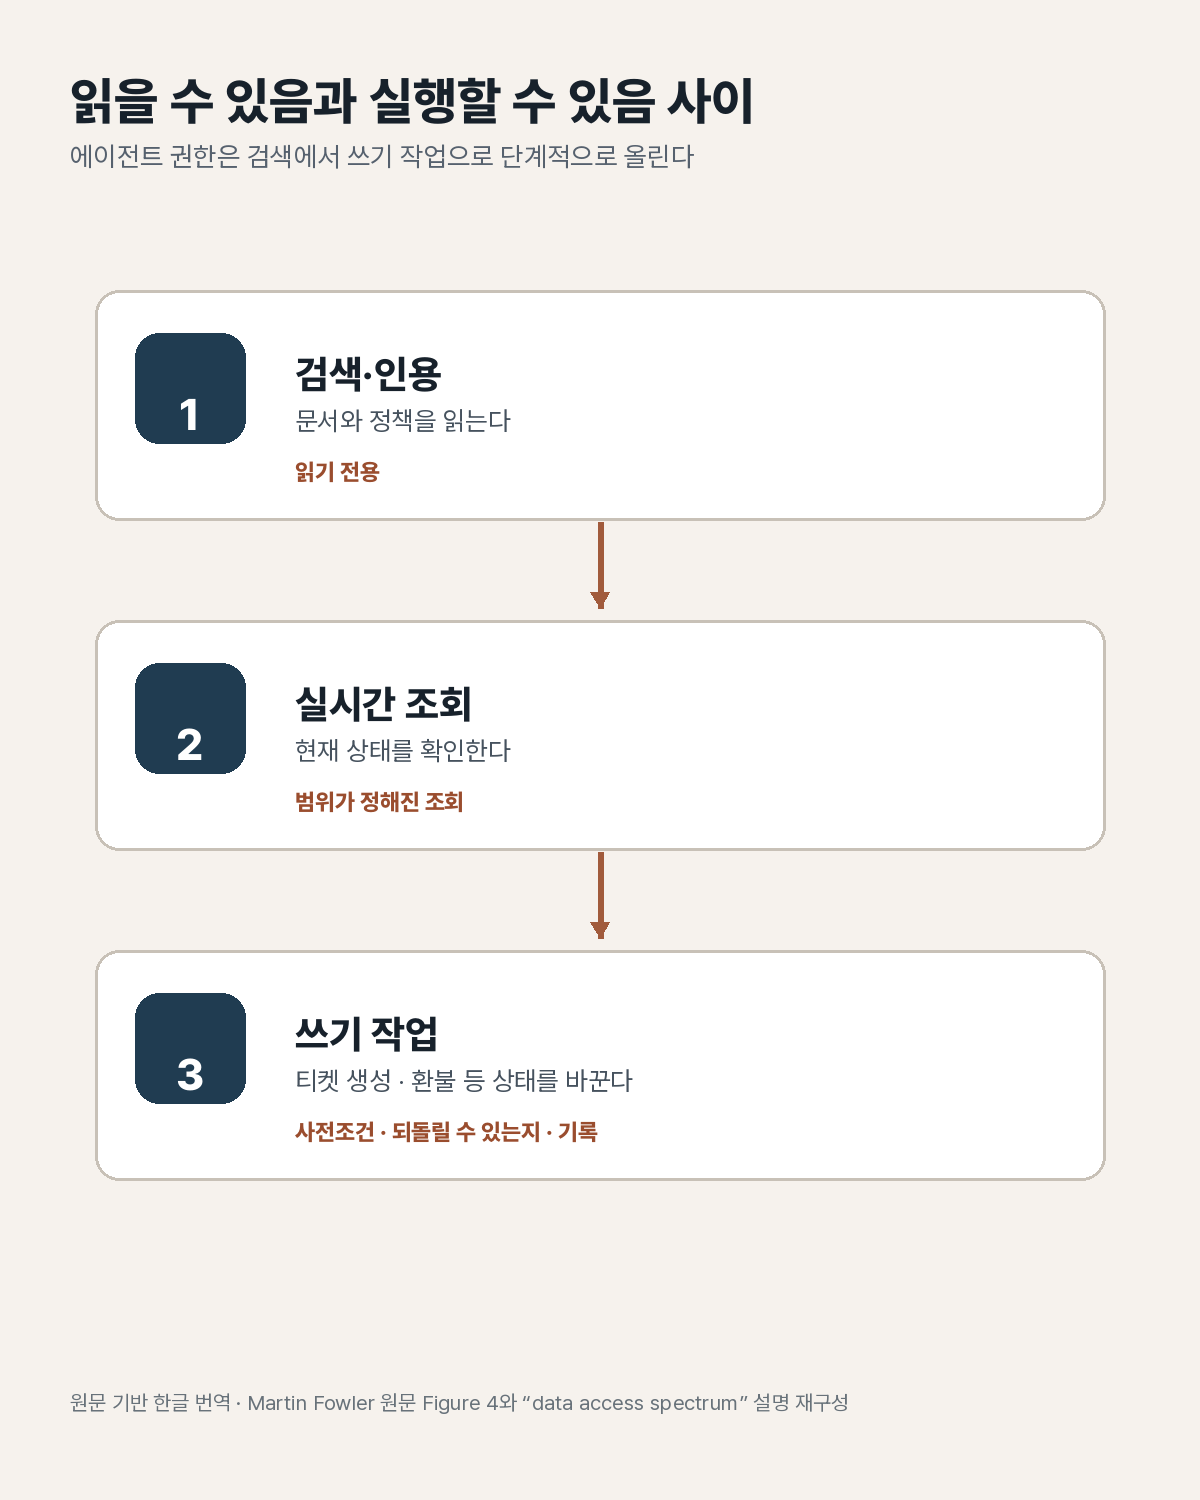
처음부터 모든 업무를 자동화할 필요는 없다. 검색과 추천을 기록하는 단계에서 시작해, 사람이 승인하는 실행으로 넓히고, 되돌릴 수 있는 작업만 제한적으로 자율화하는 순서가 실무적이다. 작업 금액보다 되돌릴 수 있는지 여부가 자율성의 경계를 정하는 데 더 유용하다는 것이 원문의 판단이다.
도입 순서는 아래에서 위로, 관측은 첫날부터
다섯 조건은 서로 독립적이지 않다. 신뢰할 수 없는 데이터 위에 지표 정의를 잘 올려도 답은 신뢰하기 어렵고, 의미가 정의되지 않은 데이터에 쓰기 권한을 주면 자동화가 위험해진다. 데이터 계약과 격리, 좁은 맥락 모델, 단계적 접근 권한을 아래에서 위로 쌓는다. 그 사이 모든 층의 실행 추적은 첫날부터 남긴다.
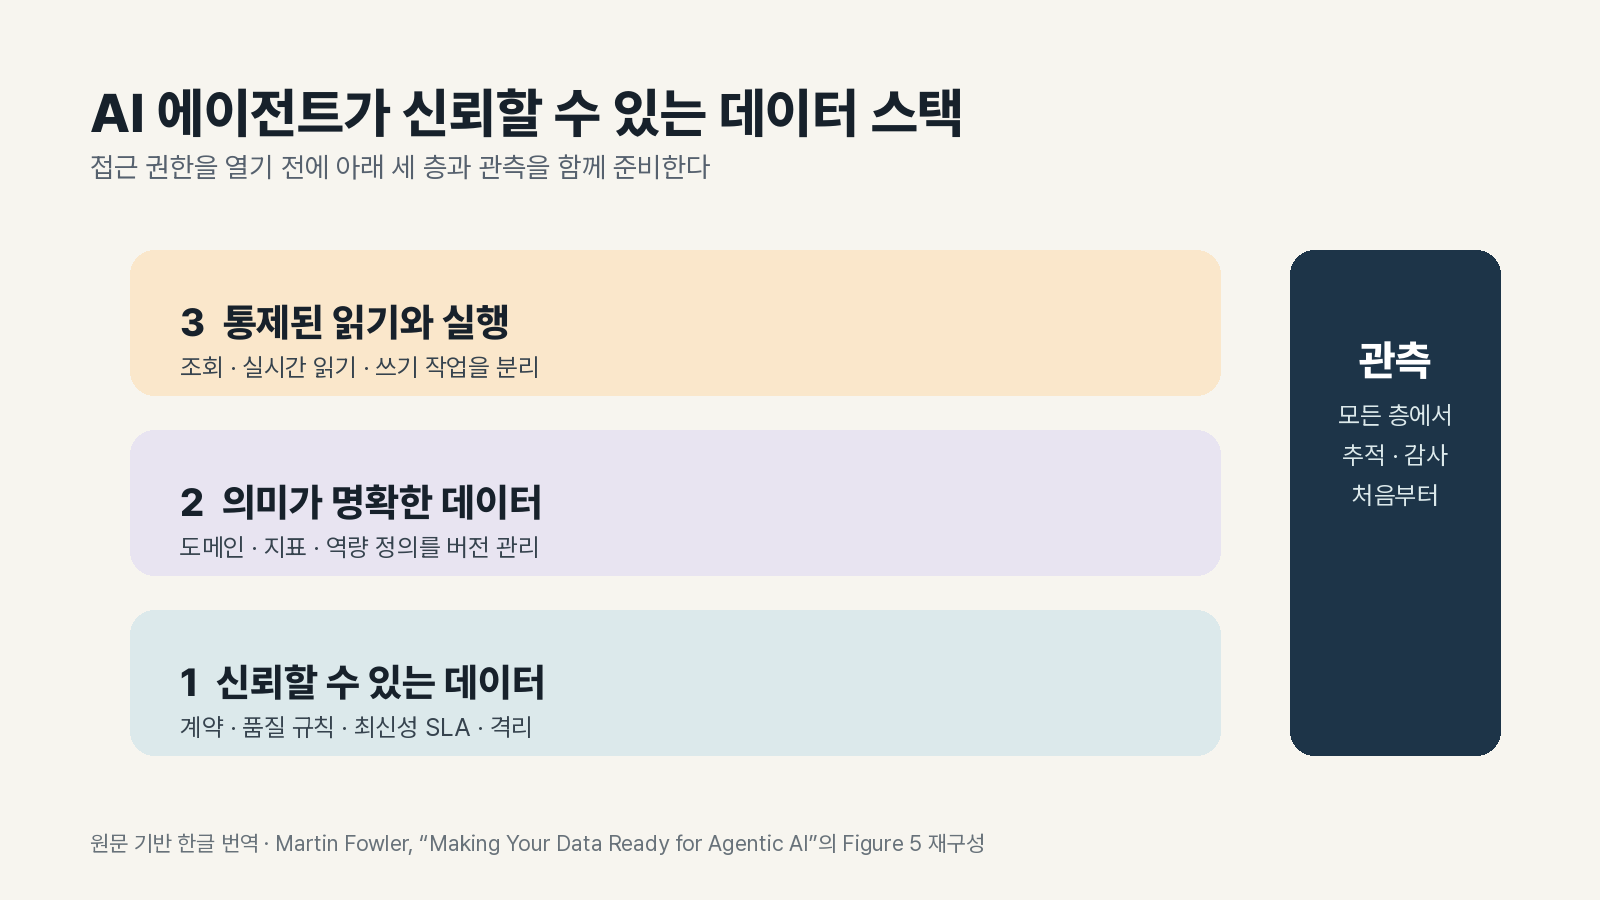
가장 먼저 고를 대상은 가장 넓은 데이터셋이 아니라, 가격·재고·고객 기록처럼 틀렸을 때 바로 피해가 나는 한 가지 업무다. 그 업무에 닿는 데이터의 최신성, 계약 위반 시 중단 방식, 지표 정의, 실행 권한과 로그를 하나의 좁은 경로에 적용해 보면 다음 확장에 필요한 빈칸이 드러난다.
출처: Making Your Data Ready for Agentic AI, Martin Fowler, 2026-08-27