
Earendil은 2026년 8월 4일 Pi를 기본 도구 4개와 1,000토큰 미만의 시스템 프롬프트·도구 정의로 시작하는 코딩 하네스라고 소개했다. 필요한 기능을 미리 전부 싣는 대신, 터미널에서 코드를 읽고 명령을 실행하고 파일을 바꾸는 데 필요한 작은 기본면을 남긴 뒤 프로젝트별 작업 흐름은 확장으로 더하는 방식이다.
이 선택의 핵심은 ‘기능이 적다’가 아니다. 코딩 에이전트에서 모델은 매 턴 프롬프트, 도구 설명, 이전 작업 맥락을 함께 받는다. 하네스가 모든 사용자를 위한 절차와 도구를 기본값으로 넣으면, 실제 과업과 무관한 맥락도 반복해서 비용과 주의력을 차지한다. Pi는 공통 부분을 작게 유지하고, 필요한 절차만 나중에 붙이는 경계를 택했다.
Pi의 최소 구성은 무엇을 남기고 무엇을 밖으로 미루나
Pi의 기본 구성은 모델이 작업 공간과 상호작용할 수 있는 도구, 짧은 안내문, 그리고 사용자가 추가하는 확장으로 나뉜다. 기본 구성만으로도 일반적인 코드 탐색·편집·실행을 시작할 수 있고, 특정 저장소의 배포 절차나 반복 측정처럼 모든 사람에게 필요하지 않은 흐름은 확장에 둔다. 그래서 확장성은 기본 기능의 목록이 길어서가 아니라, 기본면과 사용자별 절차의 경계가 분명해서 생긴다.
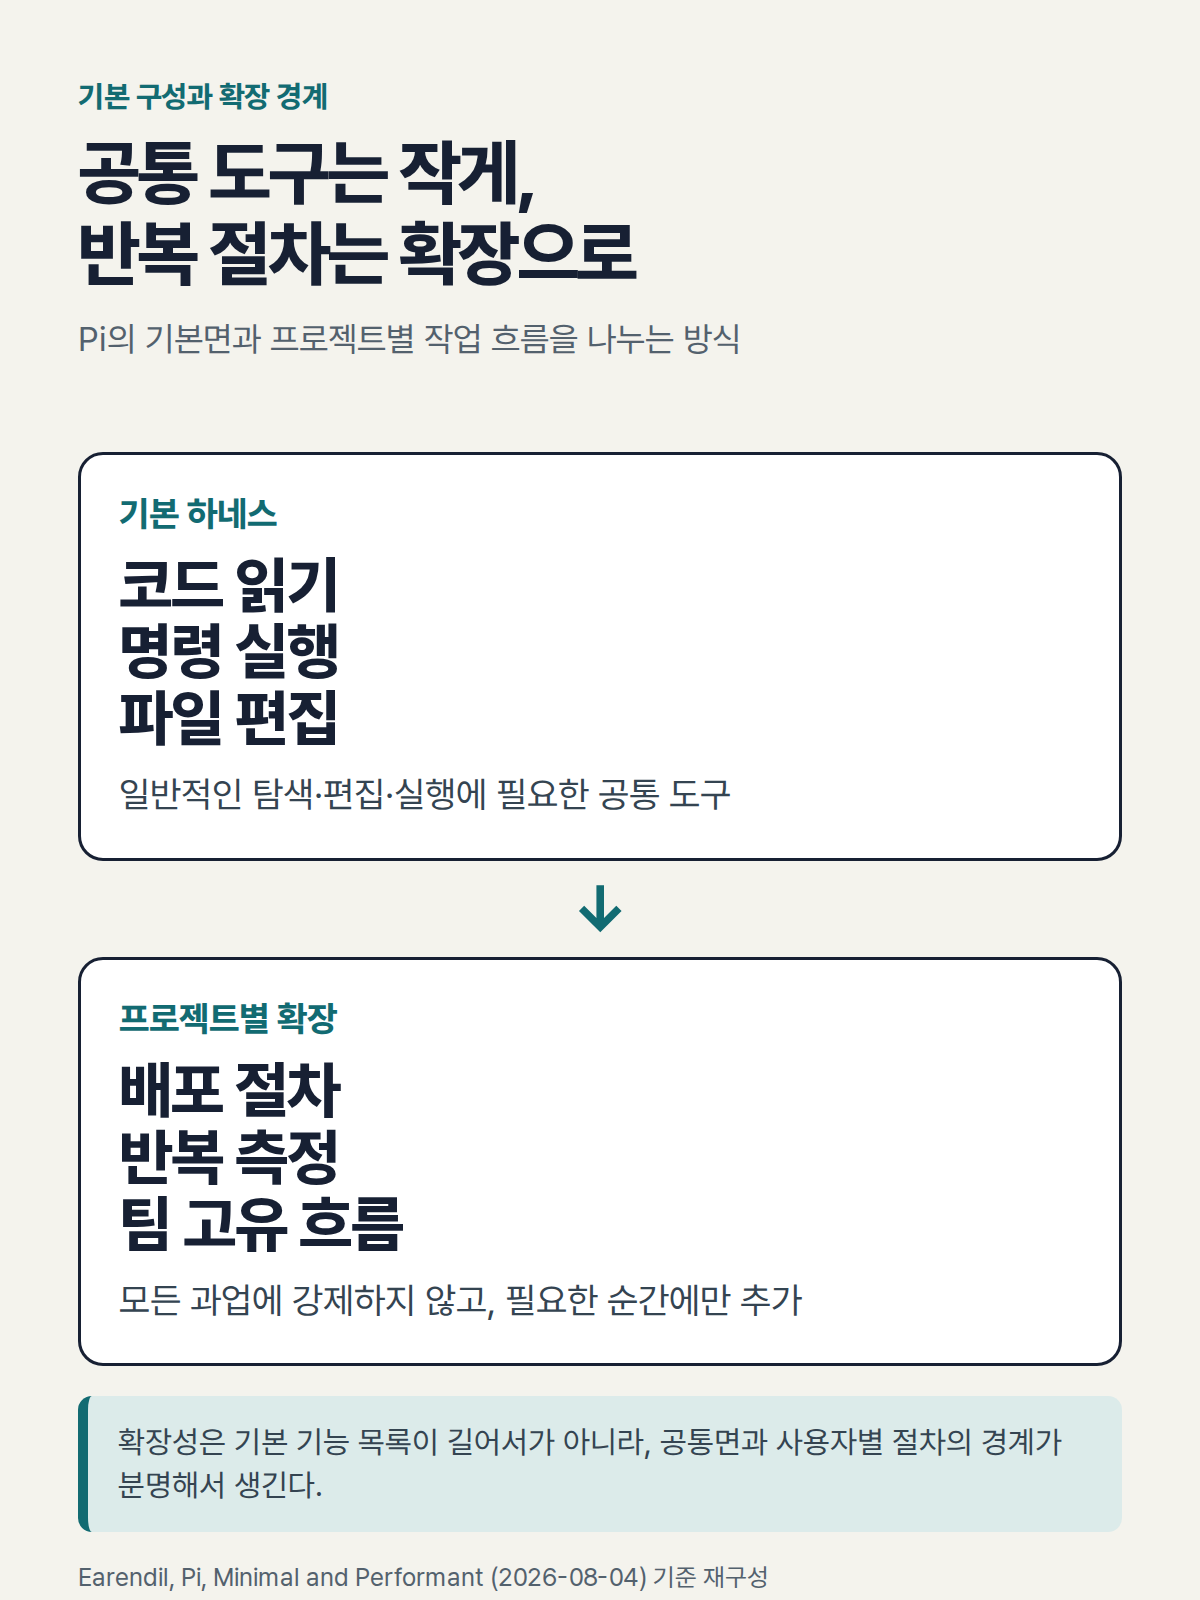
이 구조는 ‘확장을 많이 설치할수록 좋다’는 뜻도 아니다. 확장은 모델이 수행해야 할 일을 더 정확히 정의할 때만 효용이 있다. 예를 들어 빌드 시간을 줄이는 반복 실험에는 측정 명령, 성공 판정, 되돌리기, 실행 기록이 필요하지만 일반적인 버그 수정에는 그 흐름이 매번 필요하지 않다. 같은 도구라도 기본값으로 강제하지 않고 과업에 맞춰 올리는 편이 작업 맥락을 더 작게 유지한다.
하네스는 같은 모델의 과업 비용을 어떻게 바꾸나
이 주장은 Databricks의 내부 벤치마크에서 더 구체적으로 보인다. Databricks는 여러 언어와 수백만 줄 규모 코드베이스에서 자사 엔지니어가 실제로 했던 변경을 과업으로 만들고, 과업과 정답을 검토했다. 같은 모델과 같은 추론 강도를 Claude Code·Codex 계열 하네스와 Pi로 실행했을 때, 일부 경우 과업당 비용은 2배 이상 차이 났지만 품질은 같았다고 보고했다.
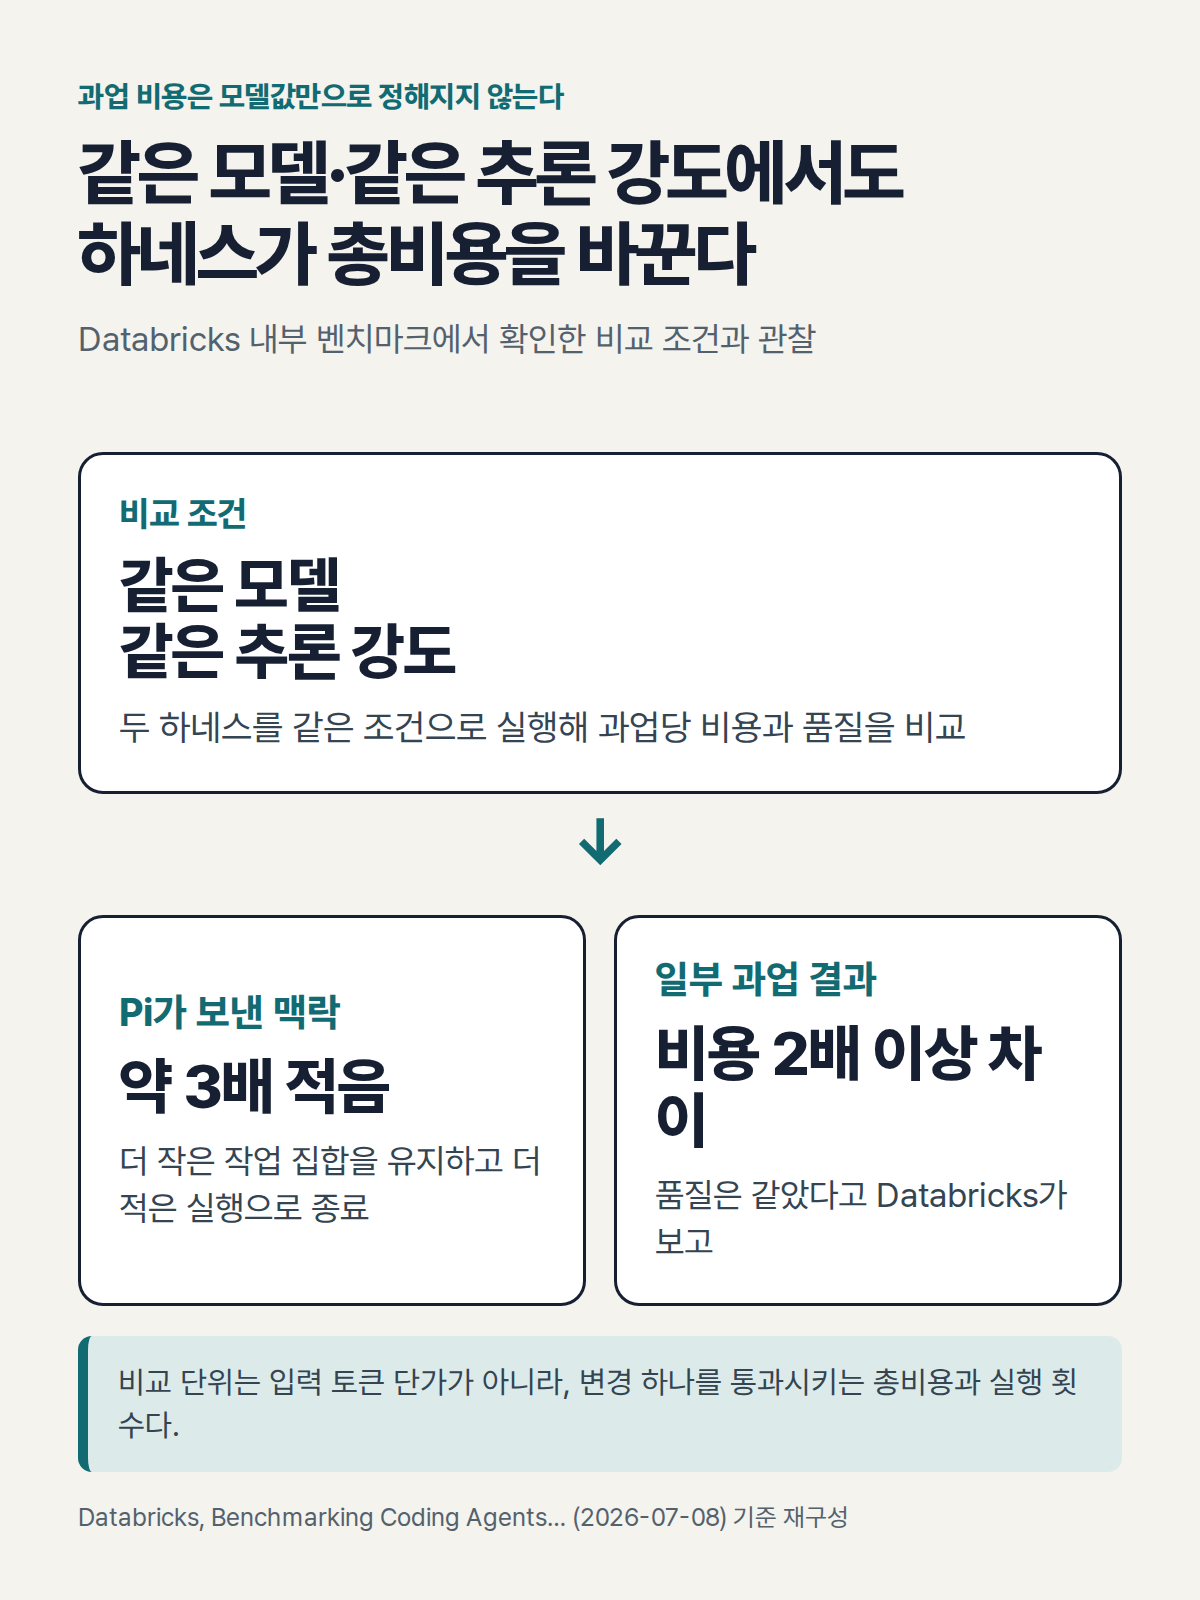
Databricks가 지목한 차이는 모델 가격표가 아니라 매 턴 넣는 맥락의 양이었다. Pi는 매 턴 약 3배 적은 맥락을 보내고, 더 작은 작업 집합을 유지하며, 더 적은 실행 횟수로 끝냈다고 기록했다. 따라서 팀이 비교해야 할 단위는 입력 토큰 단가만이 아니라 ‘이 변경 하나를 통과시키는 데 든 총비용과 실행 횟수’다. 특정 모델이 싸더라도 긴 맥락과 재시도를 반복하면 과업 단위에서는 반대 결과가 나올 수 있다.
pi-autoresearch는 확장을 어떤 작업 단위로 만들었나
Shopify의 David Cortés는 Pi에 Autoresearch 확장을 만들며 이 경계를 실제 작업 흐름으로 옮겼다. 시작점은 ‘빌드 시간을 줄인다’처럼 측정 가능한 목표다. 기준값을 먼저 재고, 각 반복에서 가설을 세운 뒤 변경을 시험한다. 기준값보다 빨라진 결과는 남기고, 느려지거나 실패한 결과는 버린 다음 다음 가설로 넘어간다. 원샷으로 최적화안을 요구하는 대신, 측정과 되돌리기를 에이전트의 반복에 넣은 것이다.
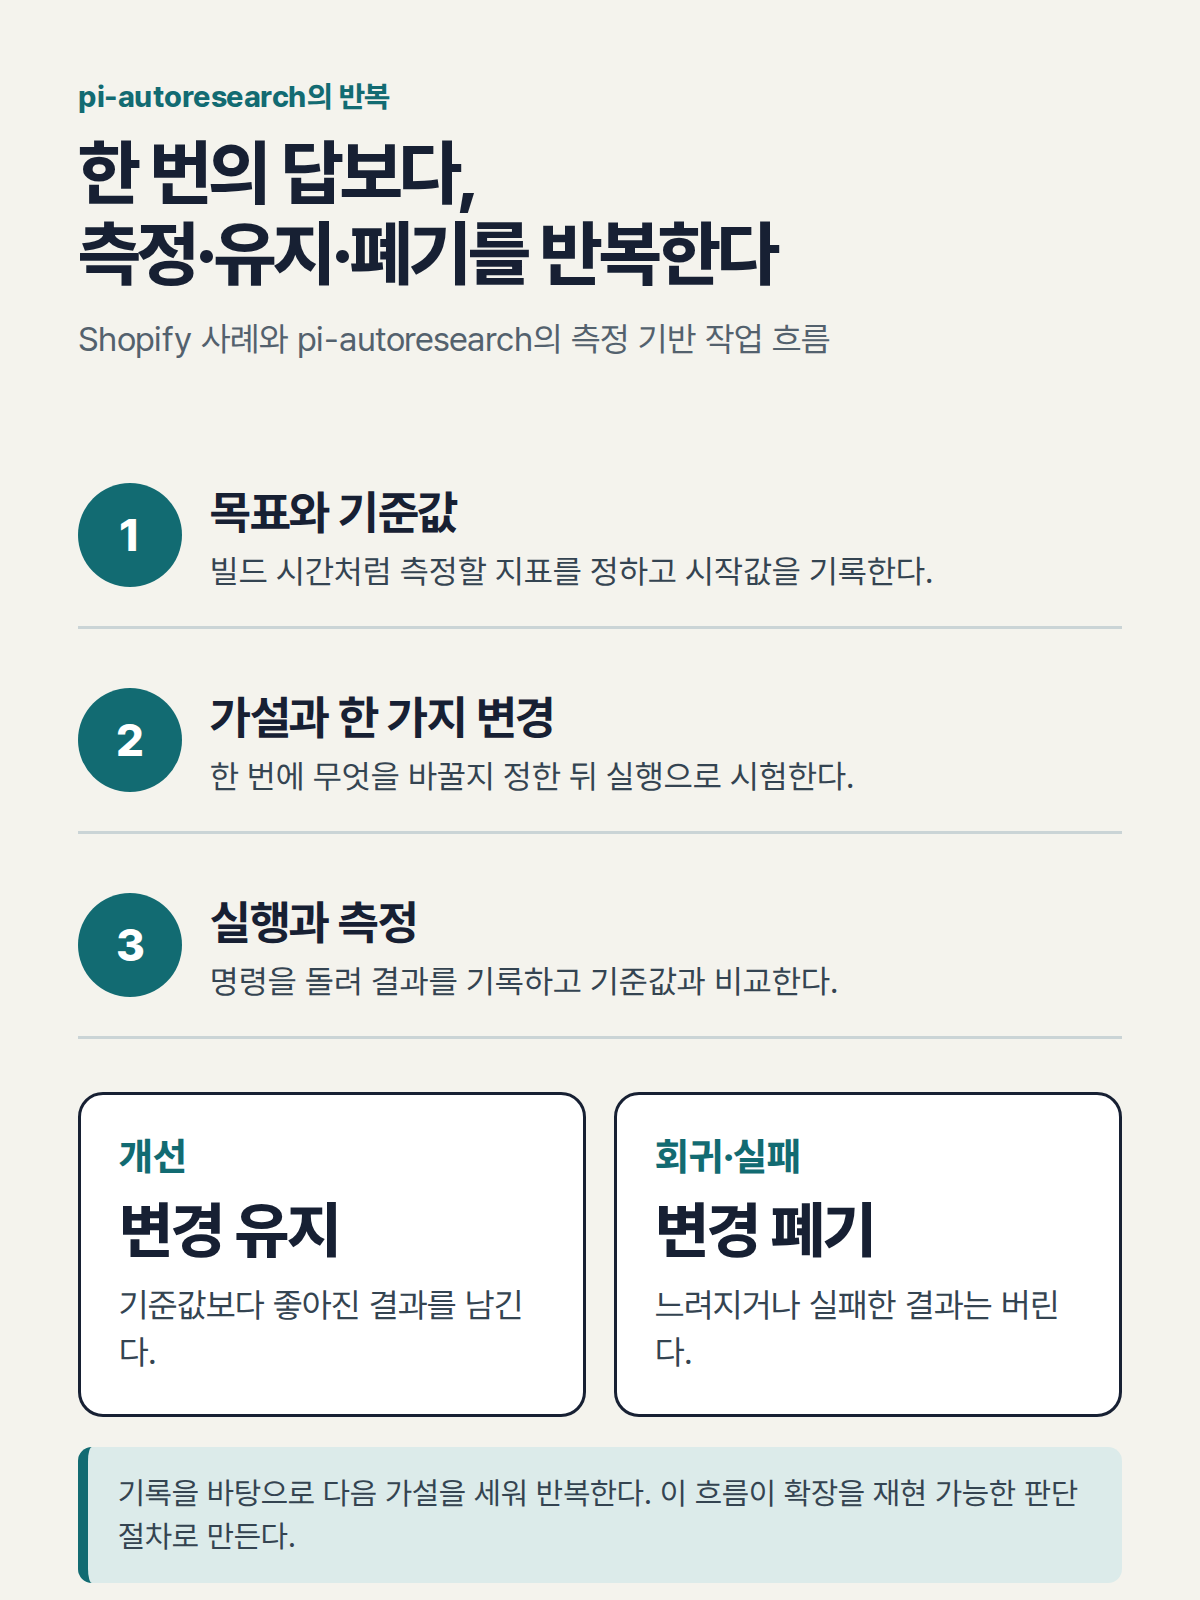
공개 저장소의 pi-autoresearch도 이 흐름을 확장 도구와 스킬로 나눈다. 확장은 실험을 초기화하고 명령을 실행하며 결과를 기록하는 공통 기반을 제공하고, 스킬은 어떤 지표와 명령을 쓸지처럼 도메인별 내용을 정한다. 실행 기록은 .auto/log.jsonl에, 목표와 시도 내용은 .auto/prompt.md에 남겨 새 세션이나 맥락 압축 뒤에도 다시 이어갈 수 있다. 확장이 단순히 버튼을 추가하는 기능이 아니라, 반복 가능한 판단 절차를 보존하는 장치가 되는 지점이다.
도입할 때는 기능 수가 아니라 과업의 측정 경계를 정해야 한다
Pi의 사례가 주는 실무적 기준은 단순하다. 먼저 모든 코딩 작업에 공통인 최소 도구와 안내문을 정하고, 다음으로 반복해서 나타나는 특정 과업에만 확장을 붙인다. 확장을 검토할 때는 “무엇을 자동화하는가”보다 “성공을 어떤 명령과 수치로 판정하고, 실패한 변경을 어떻게 되돌리는가”를 먼저 물어야 한다. 측정값과 되돌리기 경계가 없는 확장은 작업을 빠르게 시작하게 할 수는 있어도, 더 나은 결과를 축적하는 흐름까지 보장하지 못한다.
결국 최소 하네스의 장점은 적은 코드 자체가 아니라 선택권의 위치에 있다. 공통 하네스는 모델의 작업 맥락을 불필요하게 부풀리지 않고, 팀의 특수한 절차는 필요한 순간에만 명시적으로 추가한다. Databricks의 과업 단위 측정과 Shopify의 반복 실험은 그 선택이 비용 관리와 개선 루프를 함께 설계하는 방식이 될 수 있음을 보여 준다.
출처: Earendil, “Pi, Minimal and Performant”, 2026년 8월 4일 · Databricks, “Benchmarking Coding Agents on Databricks’ Multi-Million Line Codebase”, 2026년 7월 8일 · Shopify Engineering, “Autoresearch isn’t just for training models”, 2026년 4월 15일 · pi-autoresearch 저장소