
AI 도입비를 계산할 때 모델 이름을 고르는 일과 예산을 짜는 일은 대개 따로 움직였다. 더 좋은 모델이 나오면 품질을 비교하고, 월 사용량은 기존 단가에 대입하는 식이다. OpenAI가 2026년 9월 22일 내놓은 GPT-6 Sol과 Luna는 기존 예산을 다시 계산하게 한다. 두 모델은 이전 GPT-5.6 프로모션 가격과 비교해 API 입력·출력 단가를 각각 약 절반으로 낮췄다.
단가 인하는 비용 계산 방식에도 영향을 준다. 업무에 투입하는 AI의 비용은 토큰 가격, 한 번에 통과하는 결과의 비율, 재시도 횟수, 긴 공통 문맥을 되풀이하는 방식이 함께 만든다. 단가가 내려간 지금은 기존 도입안의 월 예산을 다시 계산하고, 어떤 업무를 더 큰 모델에서 Sol이나 Luna로 옮길지 시험할 시점이다.

입력과 출력이 각각 얼마로 바뀌었나
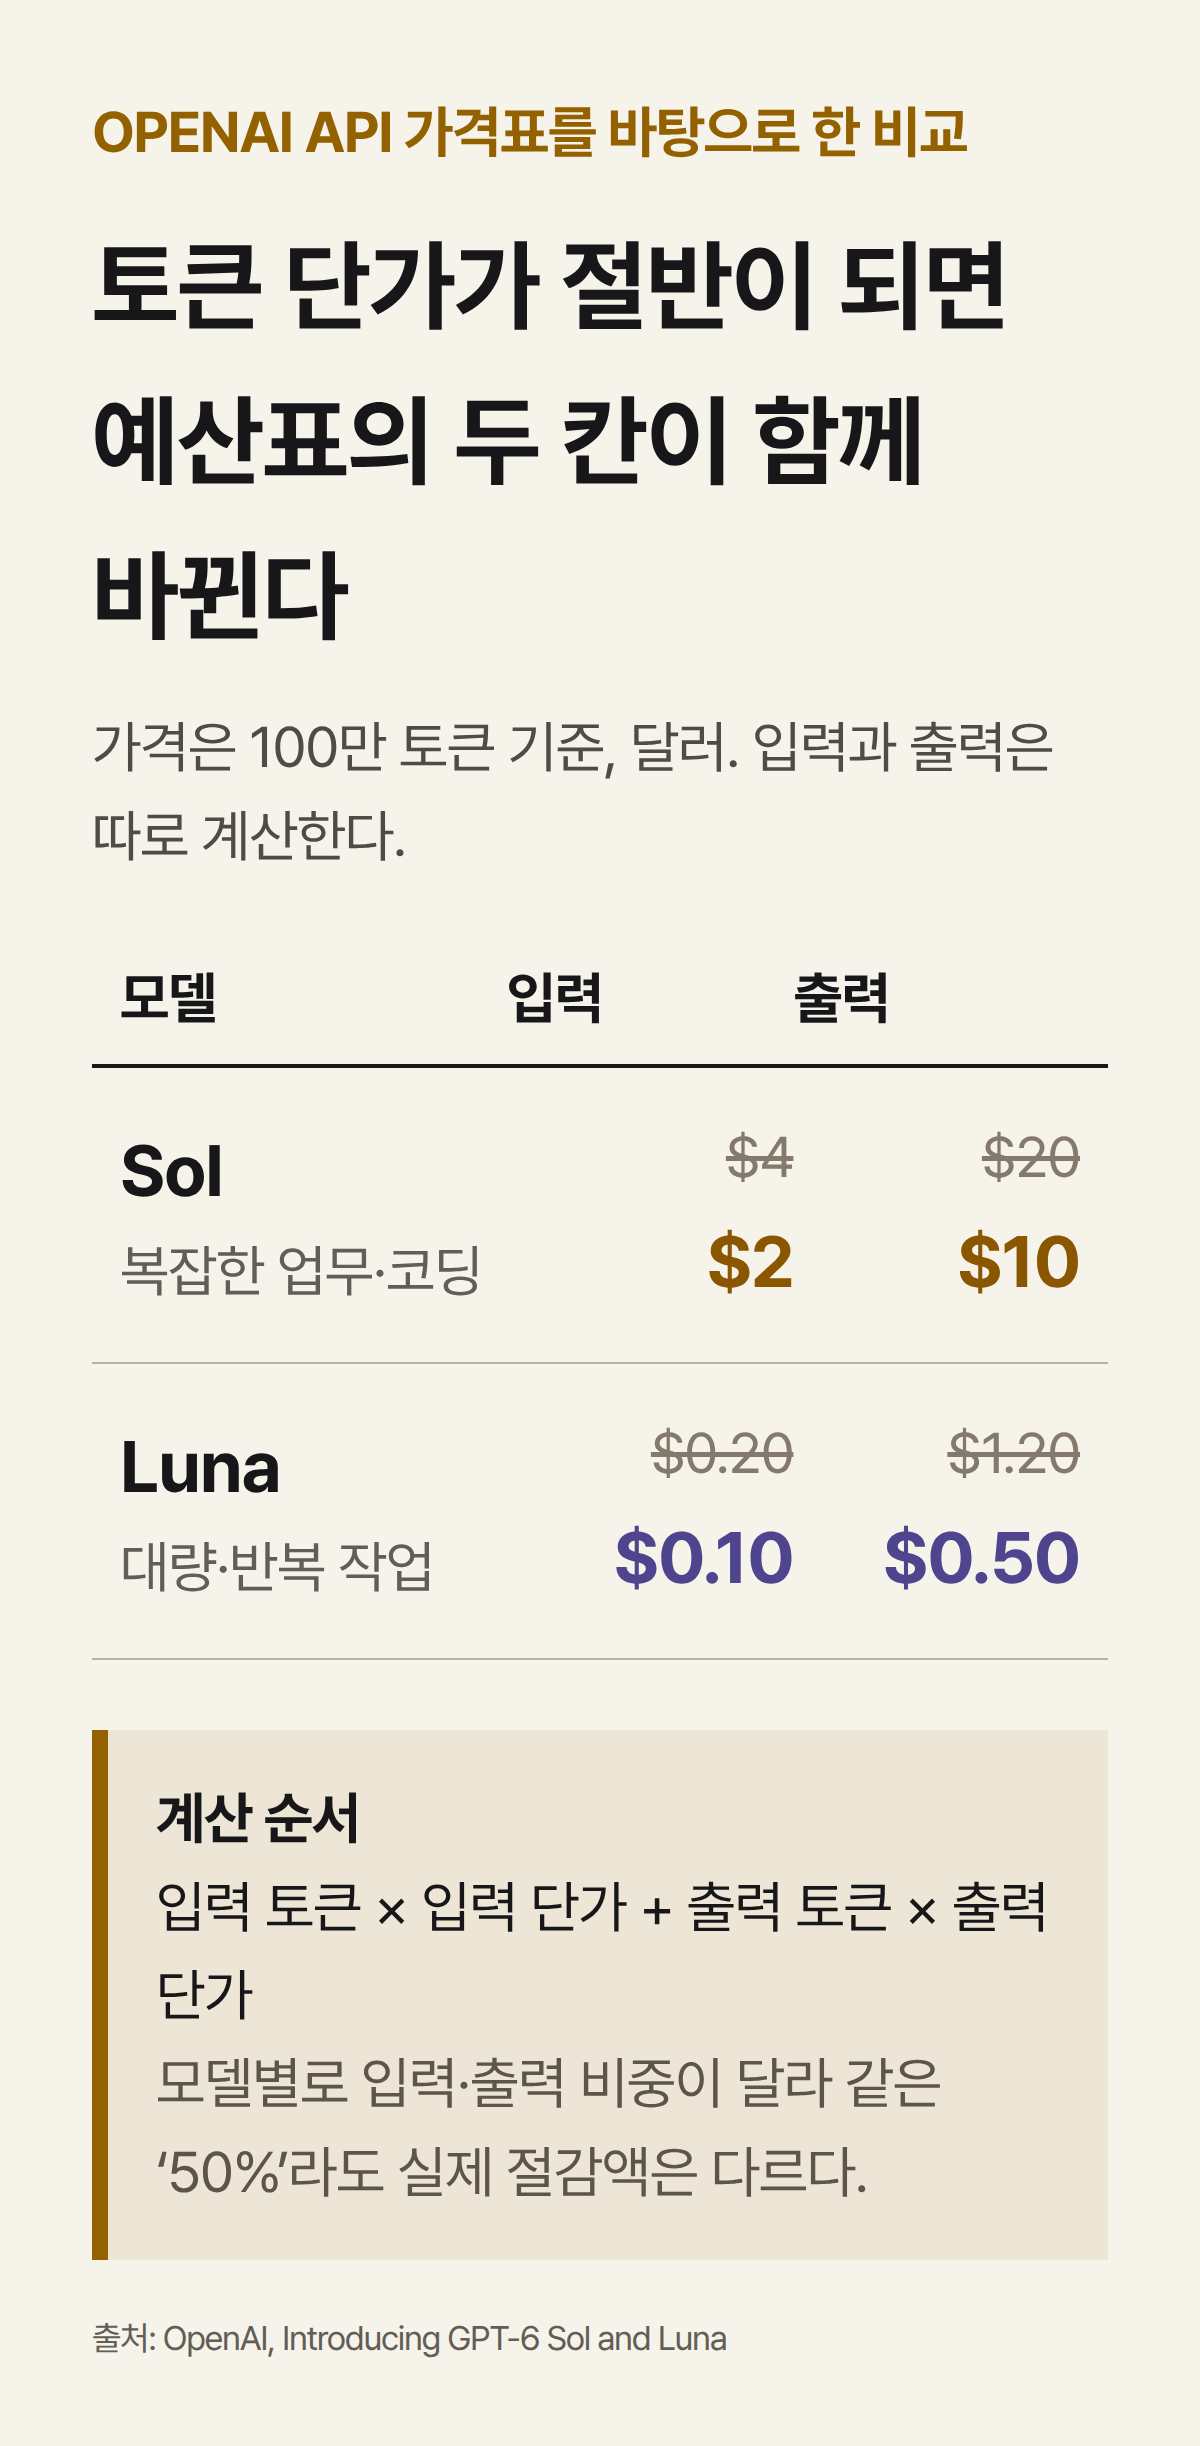
OpenAI의 표에서 GPT-6 Sol은 100만 토큰당 입력 가격이 4달러에서 2달러, 출력 가격이 20달러에서 10달러가 됐다. GPT-6 Luna는 입력이 0.20달러에서 0.10달러, 출력이 1.20달러에서 0.50달러로 내려갔다. 출력 비중이 큰 문서 작성·코드 생성 업무와, 긴 자료를 넣는 분석 업무는 같은 사용량이라도 절감 폭이 다르게 나타난다.
그래서 예산표에는 모델 하나의 평균 단가 대신 입력 토큰과 출력 토큰을 나눠 넣는 편이 낫다. 예를 들어 결과를 길게 생성하는 업무는 Sol의 출력 가격 변화가 더 크게 반영되고, 짧은 응답을 대량으로 돌리는 업무는 Luna의 낮은 입력 단가가 더 직접적인 기준이 된다. 팀이 이미 사용량 로그를 갖고 있다면 지난 30일의 입력·출력 비중에 새 가격을 각각 대입하면 된다.
모델 단가보다 성공한 작업 한 건의 비용이 중요한 이유
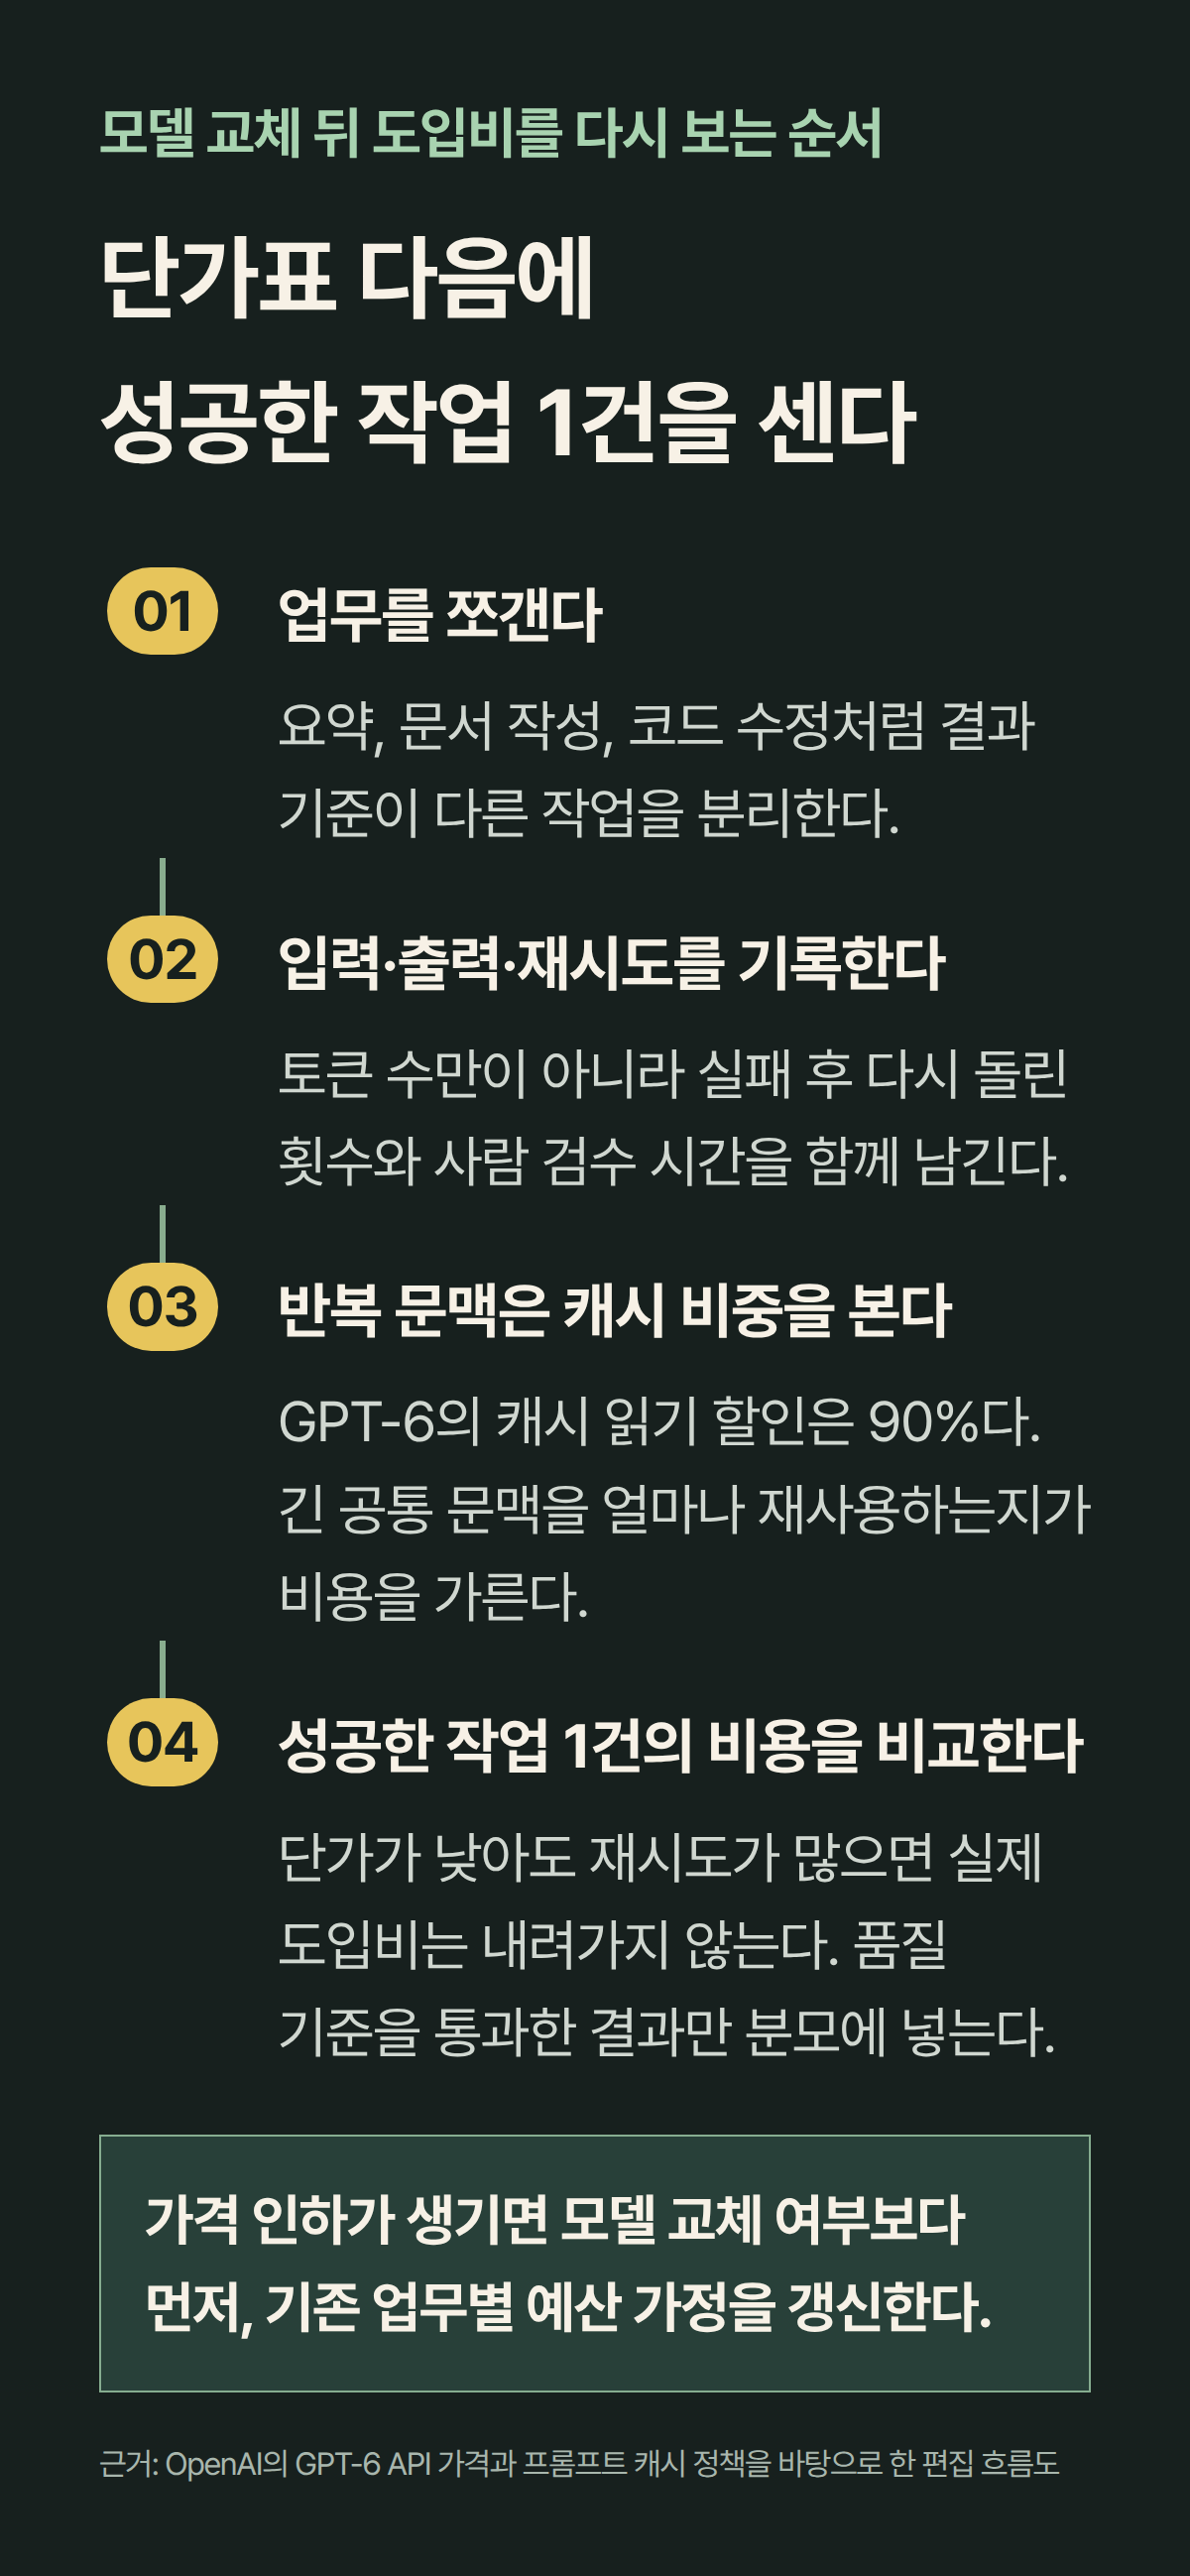
낮은 단가가 곧 낮은 도입비는 아니다. 응답을 고치기 위해 다시 요청하거나, 사람이 결과를 다시 만들고 검수하는 시간이 늘면 절감분은 쉽게 사라진다. 따라서 새 모델을 비교할 때는 요청 한 건당 비용만 보지 말고, 미리 정한 품질 기준을 통과한 결과 한 건을 만드는 데 든 총비용을 봐야 한다.
OpenAI는 업무 자동화 평가인 AutomationBench에서 GPT-6 Sol의 xhigh 노력 설정이 작업당 0.27달러, 점수 33.2%였다고 제시했다. 같은 표에서 GPT-6 Astra의 low 설정은 점수 30.3%지만 Sol의 작업당 비용은 그 3.9배로 표시됐다. 이 수치는 정해진 평가 환경에서 나온 값이다. 모델의 가격표와 품질 지표를 함께 계산할 필요가 있다.
새 모델의 도입 시험은 작은 업무 묶음에서 시작할 수 있다. 같은 입력, 같은 통과 기준, 같은 사람 검수 절차로 기존 모델과 Sol 또는 Luna를 돌린다. 통과한 결과 수, 재시도 수, 평균 입력·출력 토큰, 검수 시간을 남기면 어느 모델이 진짜 비용을 낮췄는지 확인할 수 있다. 그 뒤에만 요청량을 늘리는 편이 안전하다.
긴 문맥을 되풀이하는 에이전트는 캐시 비용도 다시 계산한다
에이전트와 장기 대화는 매번 같은 시스템 지침, 도구 설명, 프로젝트 자료를 앞부분에 붙이기 쉽다. OpenAI는 GPT-6에서 캐시된 입력 토큰 읽기에 90% 할인을 적용하고, 노력 수준이나 도구 사용 가능 여부를 바꿔도 앞선 문맥의 캐시 재사용을 보존한다고 밝혔다. 공통 문맥을 얼마나 재사용하느냐가 모델 교체 뒤의 실제 비용 차이를 더 크게 만들 수 있다.
여기서 먼저 손볼 것은 프롬프트를 무조건 줄이는 일이 아니다. 여러 작업이 공유하는 지침과 자료를 앞부분에 고정하고, 작업마다 달라지는 요청을 뒤에 붙여야 캐시될 접두부가 생긴다. 캐시 적중률, 새로 처리한 입력 토큰 비중, 응답 시간은 함께 기록한다. OpenAI는 GitHub Copilot이 수십억 건 요청에서 새 처리가 필요한 프롬프트 토큰 비중을 50% 넘게 낮췄다고 소개했다.
Sol과 Luna는 어디부터 바꿔 볼 만한가
Sol은 복잡한 코딩과 전문 업무처럼 결과 품질이 비용을 좌우하는 구간의 비교 대상으로 적합하다. OpenAI는 DeepSWE v1.1에서 Sol의 최대 노력 설정이 68.8%였고, 비교한 최고 점수와 1.1%포인트 차이에서 작업당 비용은 약 80% 낮았다고 밝혔다. Luna는 대량 반복 처리에서 먼저 비교하기 좋다. OpenAI는 Luna의 최대 노력 설정이 같은 평가에서 66.6%였고, 비교 모델보다 작업당 비용이 더 낮았다고 제시했다.
두 모델을 한꺼번에 전사 기본값으로 바꿀 이유는 없다. 실패 비용이 큰 계약 검토나 운영 변경은 기존의 더 강한 모델과 사람 승인 절차를 유지하고, 정해진 형식의 초안 작성, 분류, 내부 도구 보조처럼 결과를 빨리 검수할 수 있는 업무부터 옮긴다. 이번 가격 인하 뒤에는 업무별로 통과한 결과 한 건의 비용을 비교해야 한다.