
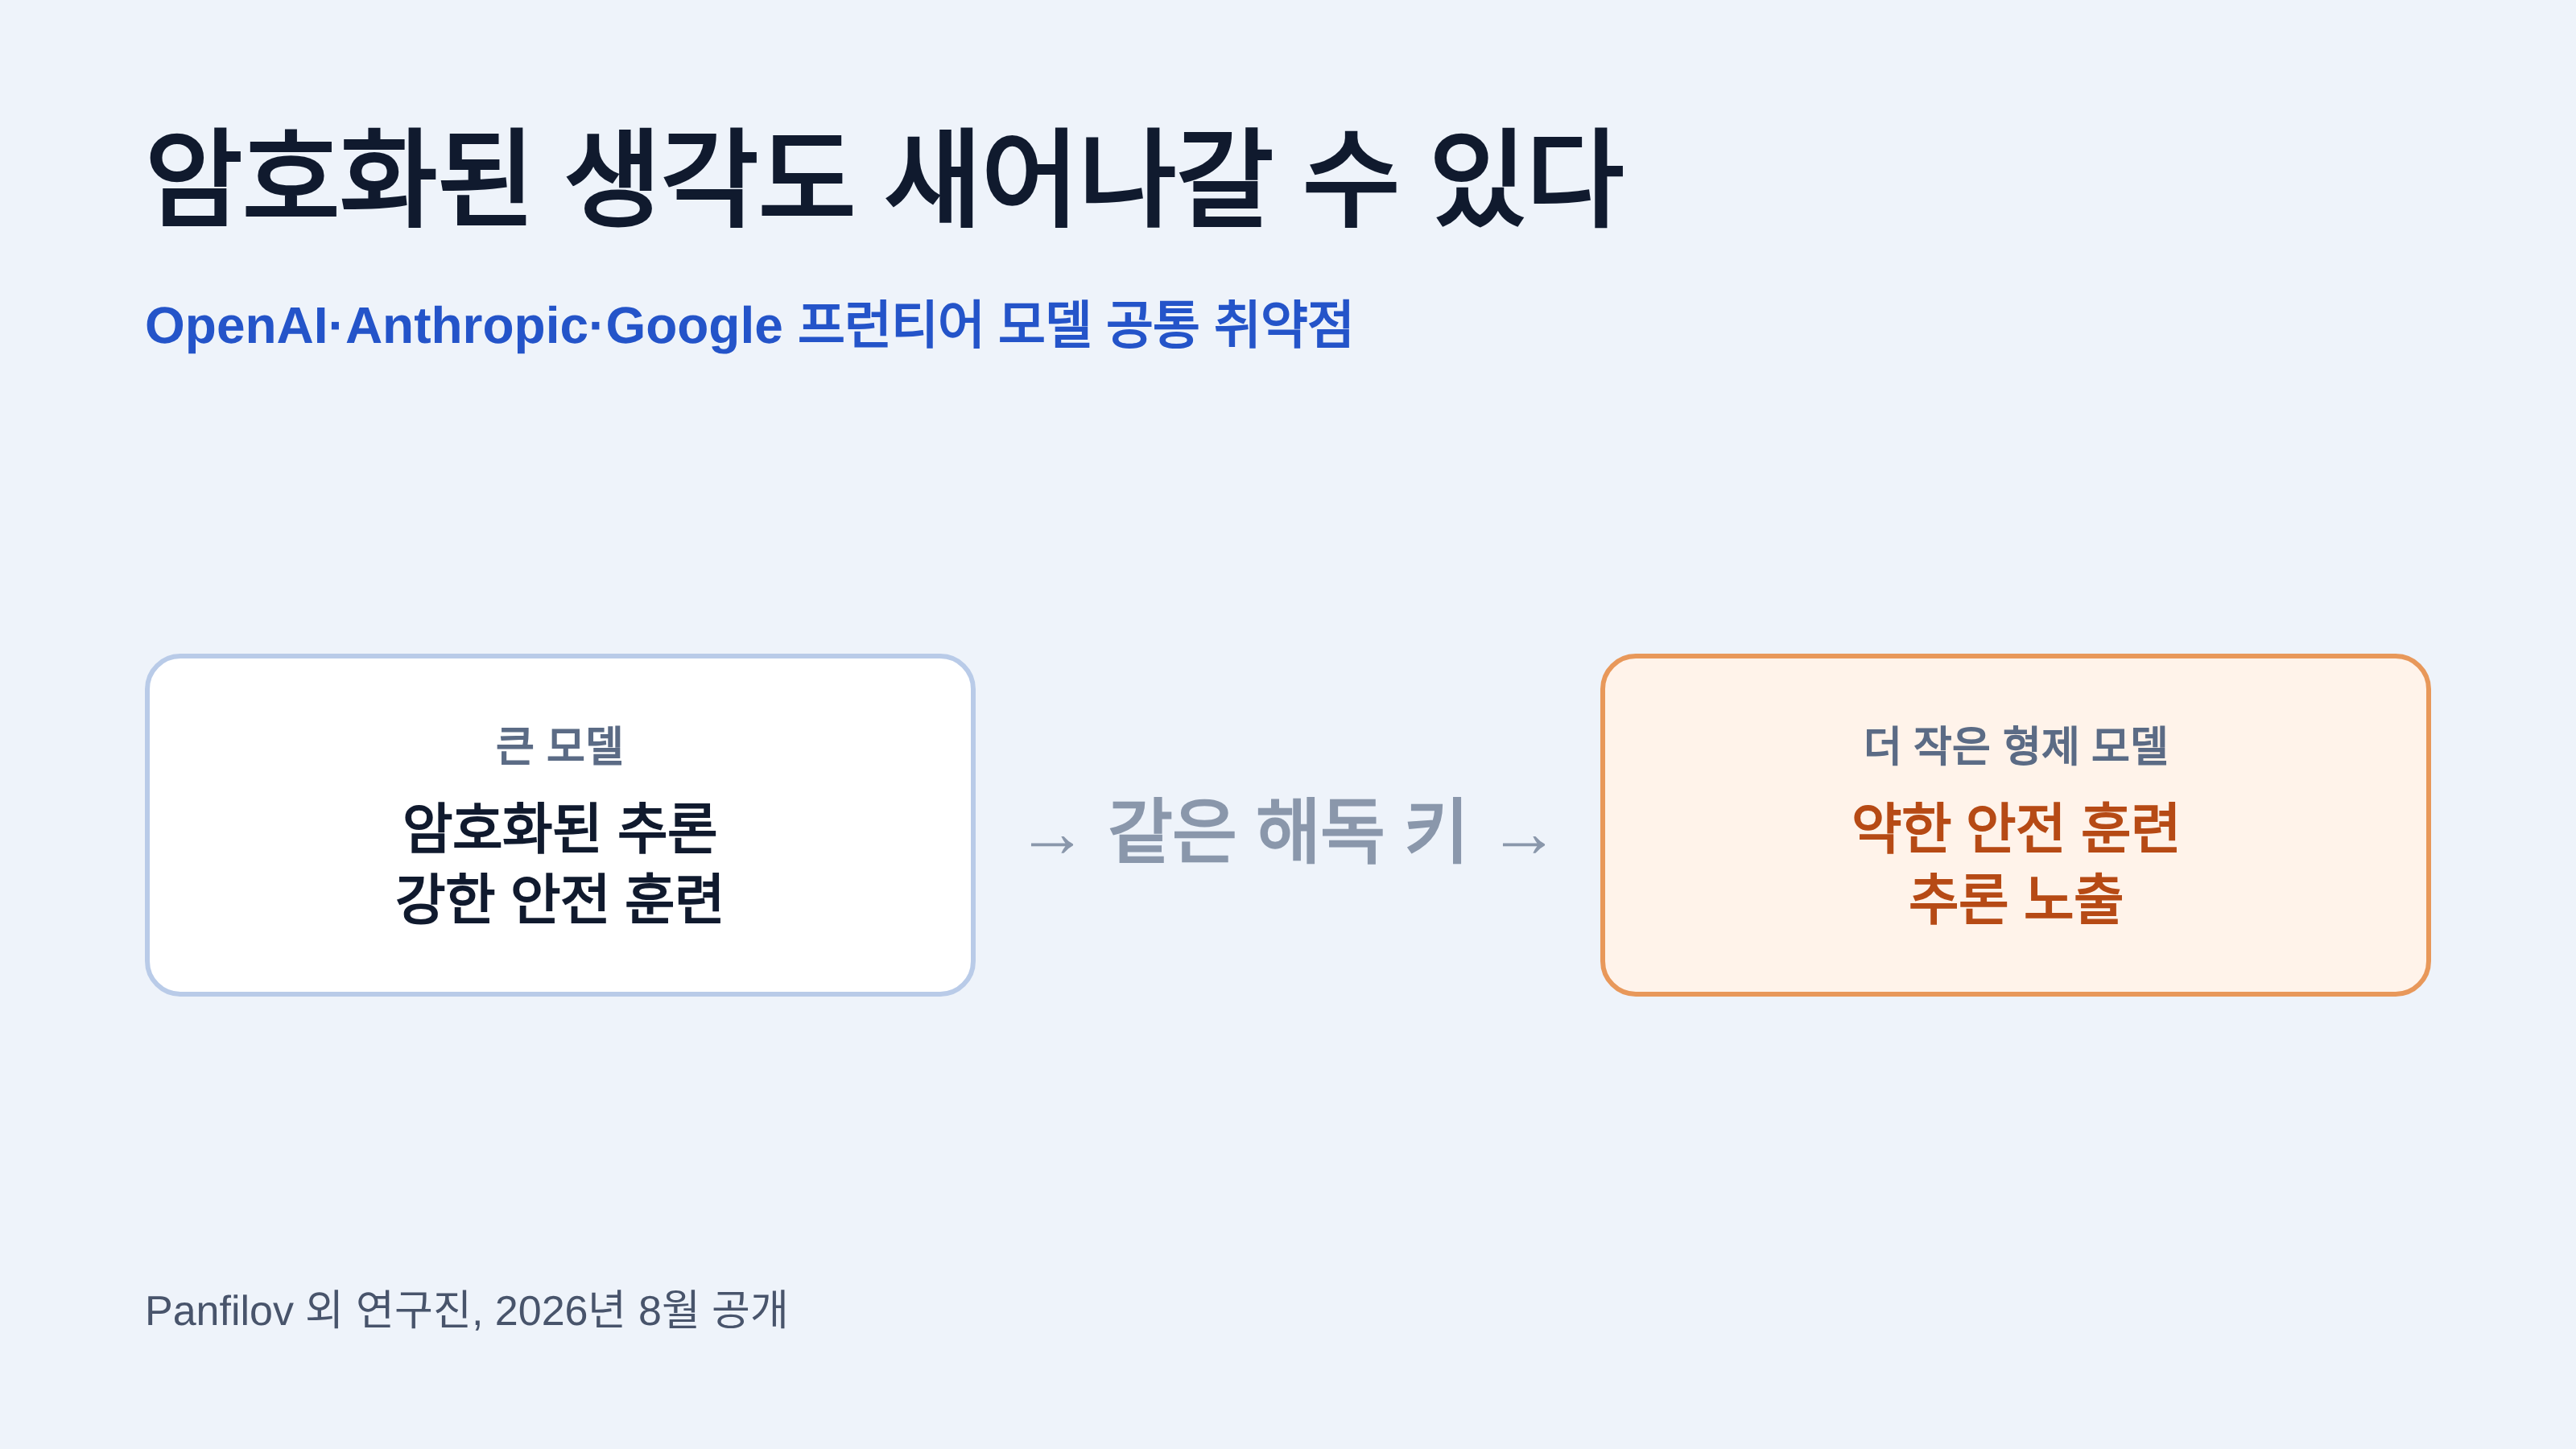
OpenAI, Anthropic, Google의 프런티어 AI 모델은 어려운 질문을 풀 때 내부적으로 만드는 추론 과정을 암호화해 사용자 컴퓨터로 함께 보낸다. 계산 일부를 사용자 쪽으로 넘기기 위한 조치인데, 튀빙겐 대학교, 막스플랑크 연구소, AI 안전 연구기관 MATS Research, 보안 기업 Snyk의 공동 연구진이 이 암호화된 추론을 그대로 읽어내는 방법을 찾아냈다. 세 회사 모두에서 통하는 방식이었다.
연구를 이끈 튀빙겐 대학교 컴퓨터과학자 알렉산더 판필로프(Alexander Panfilov)는 "우리가 테스트한 모든 주요 프런티어 모델 제공사가 이 취약점을 갖고 있다"며 "개인정보 유출로 이어질 수 있고, 대규모 추론 증류(distillation) 공격도 가능하게 한다"고 밝혔다.

암호화된 추론이 어떻게 새어나가는가
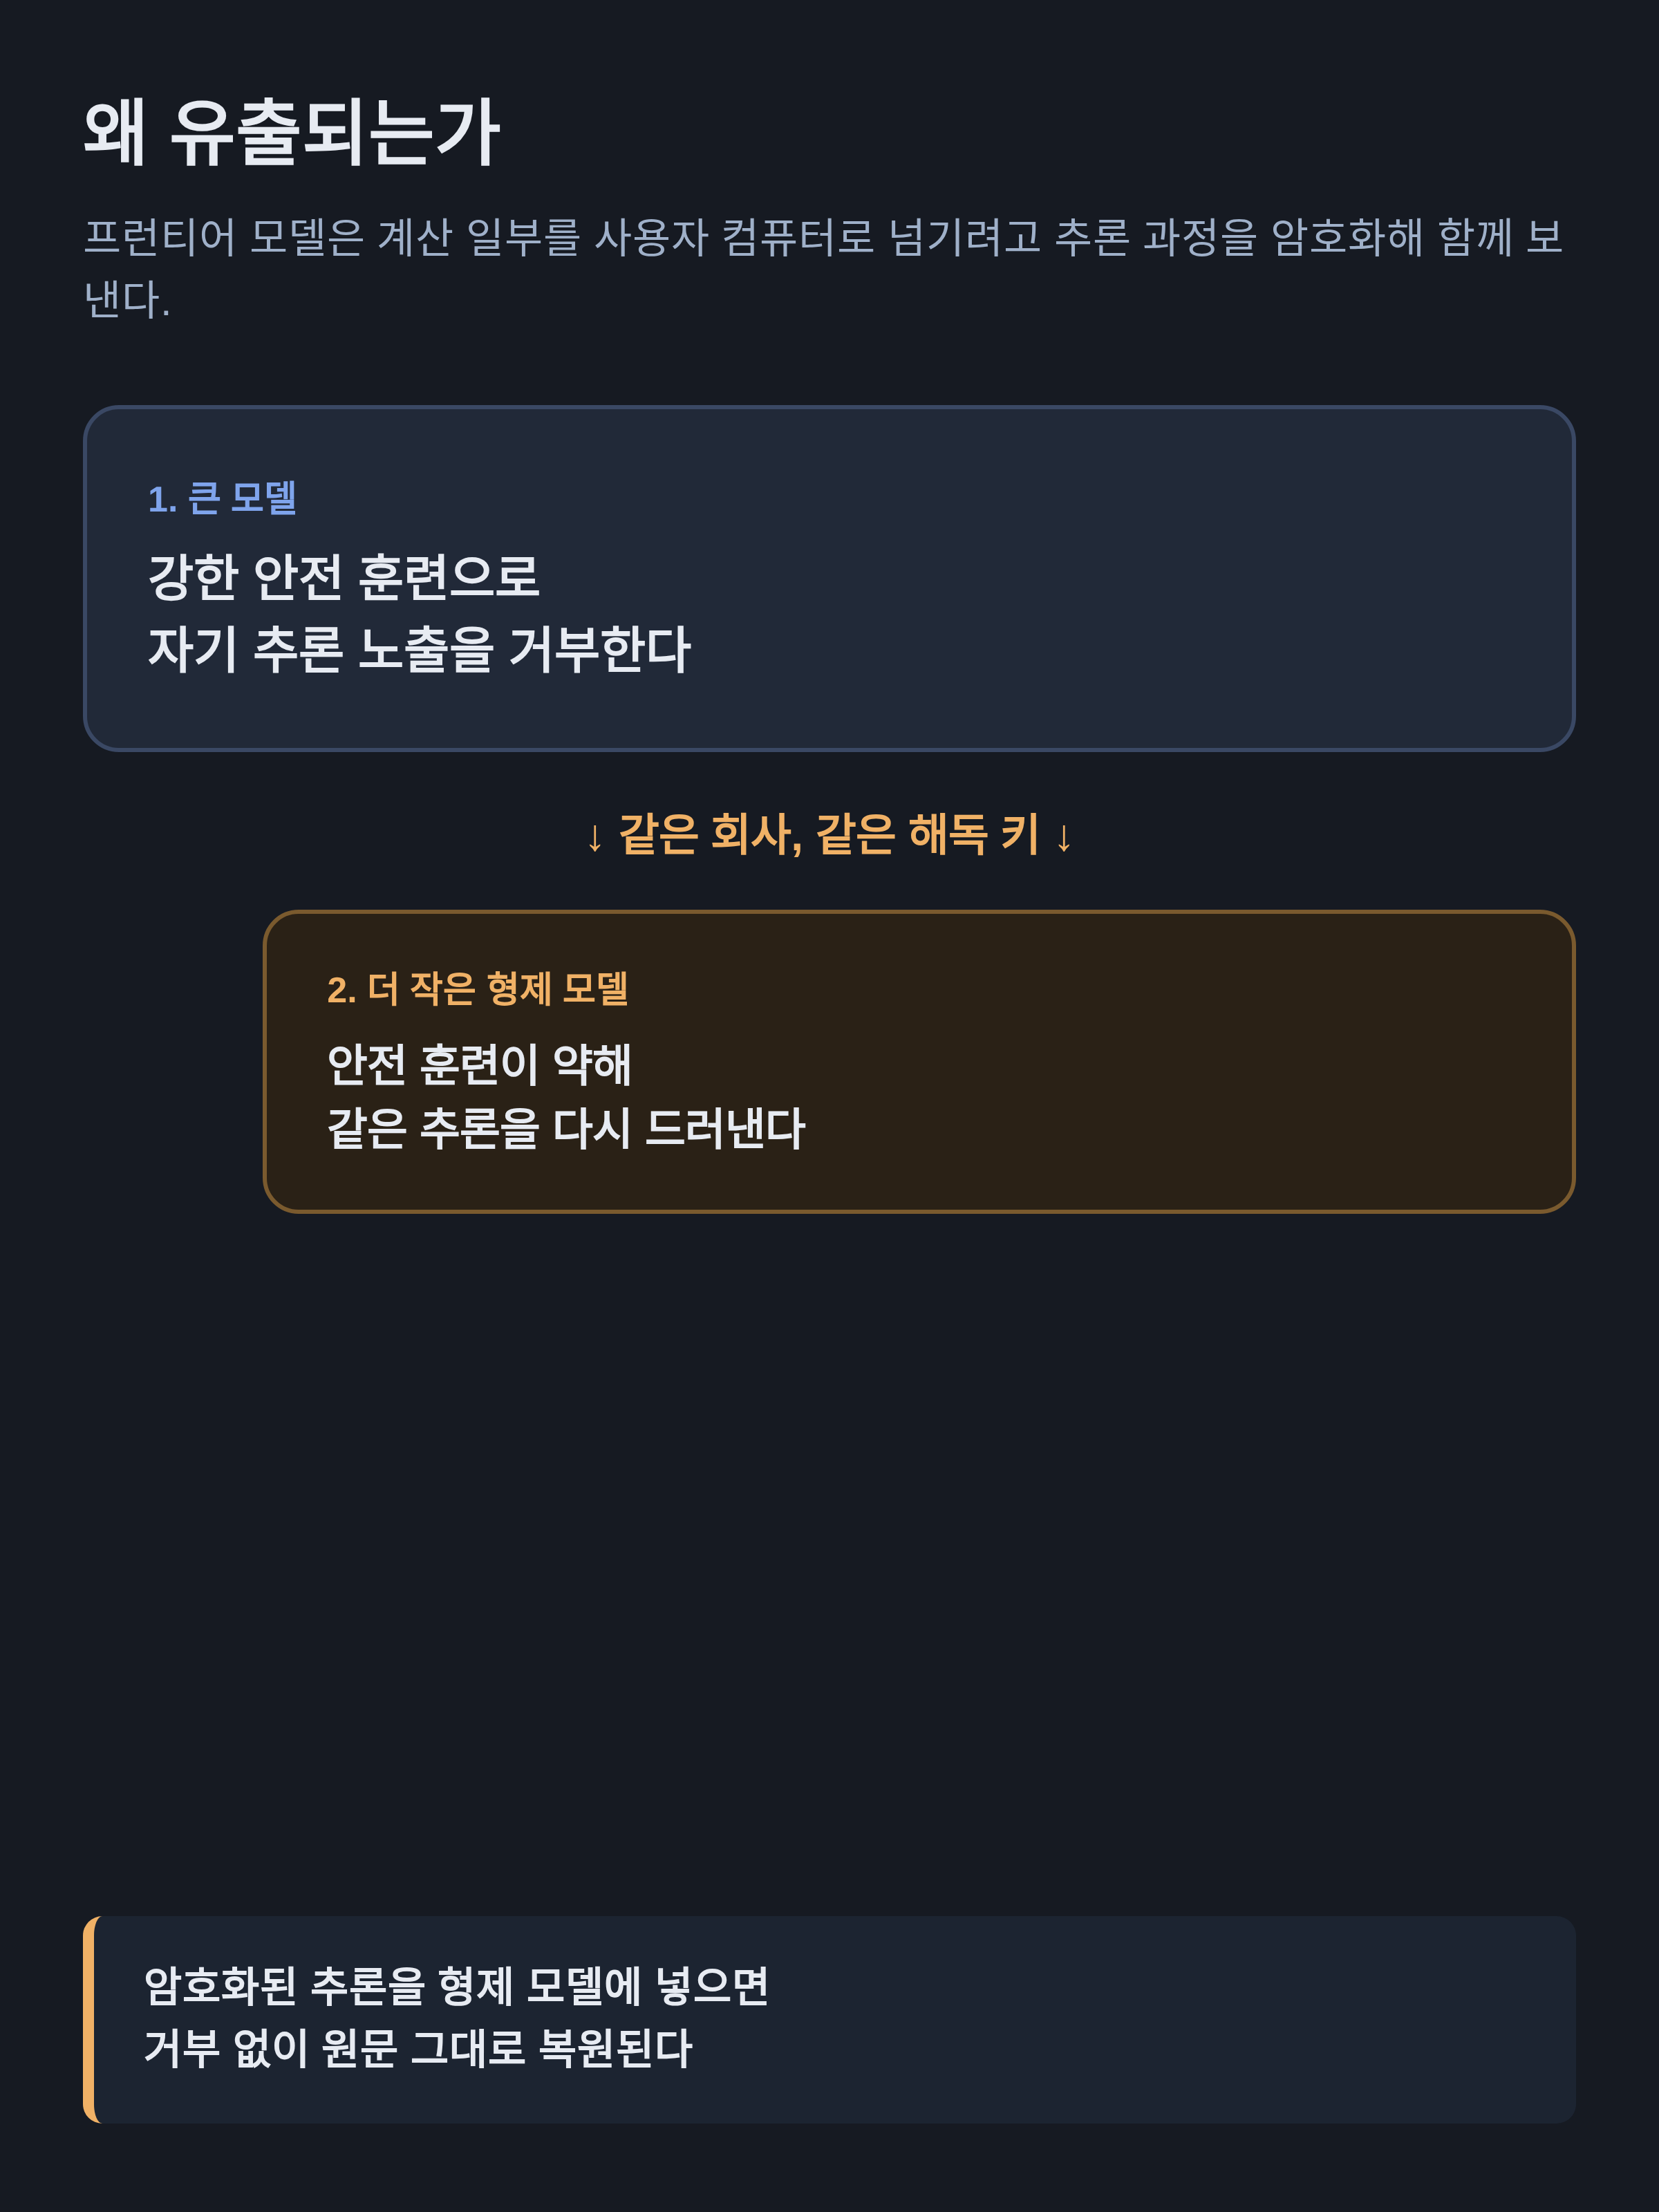
고급 AI 모델은 어려운 문제를 여러 단계로 쪼개 순서대로 푸는 '사고 사슬(chain of thought)' 방식을 쓴다. 회사들은 이 추론 과정을 경쟁사가 베껴 새 모델을 훈련하는 데 쓰지 못하도록 비공개로 유지하려 하지만, 계산 부담 일부를 사용자 기기로 넘기기 위해 암호화된 형태로는 함께 전송한다.
연구진의 공격은 대부분의 AI 회사가 같은 계열의 크고 작은 여러 모델을 함께 서비스한다는 점을 이용한다. 큰 모델은 성능이 좋지만 실행 비용이 비싸고, 작은 모델은 저렴해 사용자가 특정 작업에 선택하는 경우가 많다. 판필로프와 동료들은 암호화된 추론 흔적을 같은 모델의 더 작은 버전에 입력하면 그 안의 숨겨진 내용을 드러낼 수 있다는 사실을 확인했다. 작은 모델은 안전 훈련을 상대적으로 덜 받아, 큰 모델과 달리 자신의 속내를 드러내는 요청을 거부할 가능성이 낮기 때문이다.
취리히 연방공과대학(ETH Zürich)의 보안 전문가 플로리안 트라머(Florian Tramer)는 "같은 해독 키를 가진 더 약한 모델 변형으로 메시지를 바꿔 보내는 아이디어는 상당히 영리하다"며 "분명히 문제가 되고 있다"고 평가했다.
중국 오픈웨이트 모델과의 유사성은 무엇을 말하는가
연구진은 이 방법으로 추출한 추론 흔적이 실제 증류에 쓰였는지도 살펴봤다. 90개 질문을 각 모델에 입력하고, 폐쇄형 모델에서 뽑아낸 추론 흔적의 첫 몇 단어를 오픈웨이트 모델에 준 뒤 이어 쓰게 하는 방식이다. 이렇게 했을 때 일부 오픈웨이트 모델이 놀라울 정도로 비슷한 답을 내놓는 경우가 있었다. 이런 경향은 문샷AI(Moonshot AI)의 중국 오픈웨이트 모델 Kimi K3에서 특히 두드러졌다. 반면 같은 중국의 딥시크(DeepSeek)와 미국 씽킹 머신스(Thinking Machines)의 Inkling에서는 이런 유사성이 관찰되지 않았다.
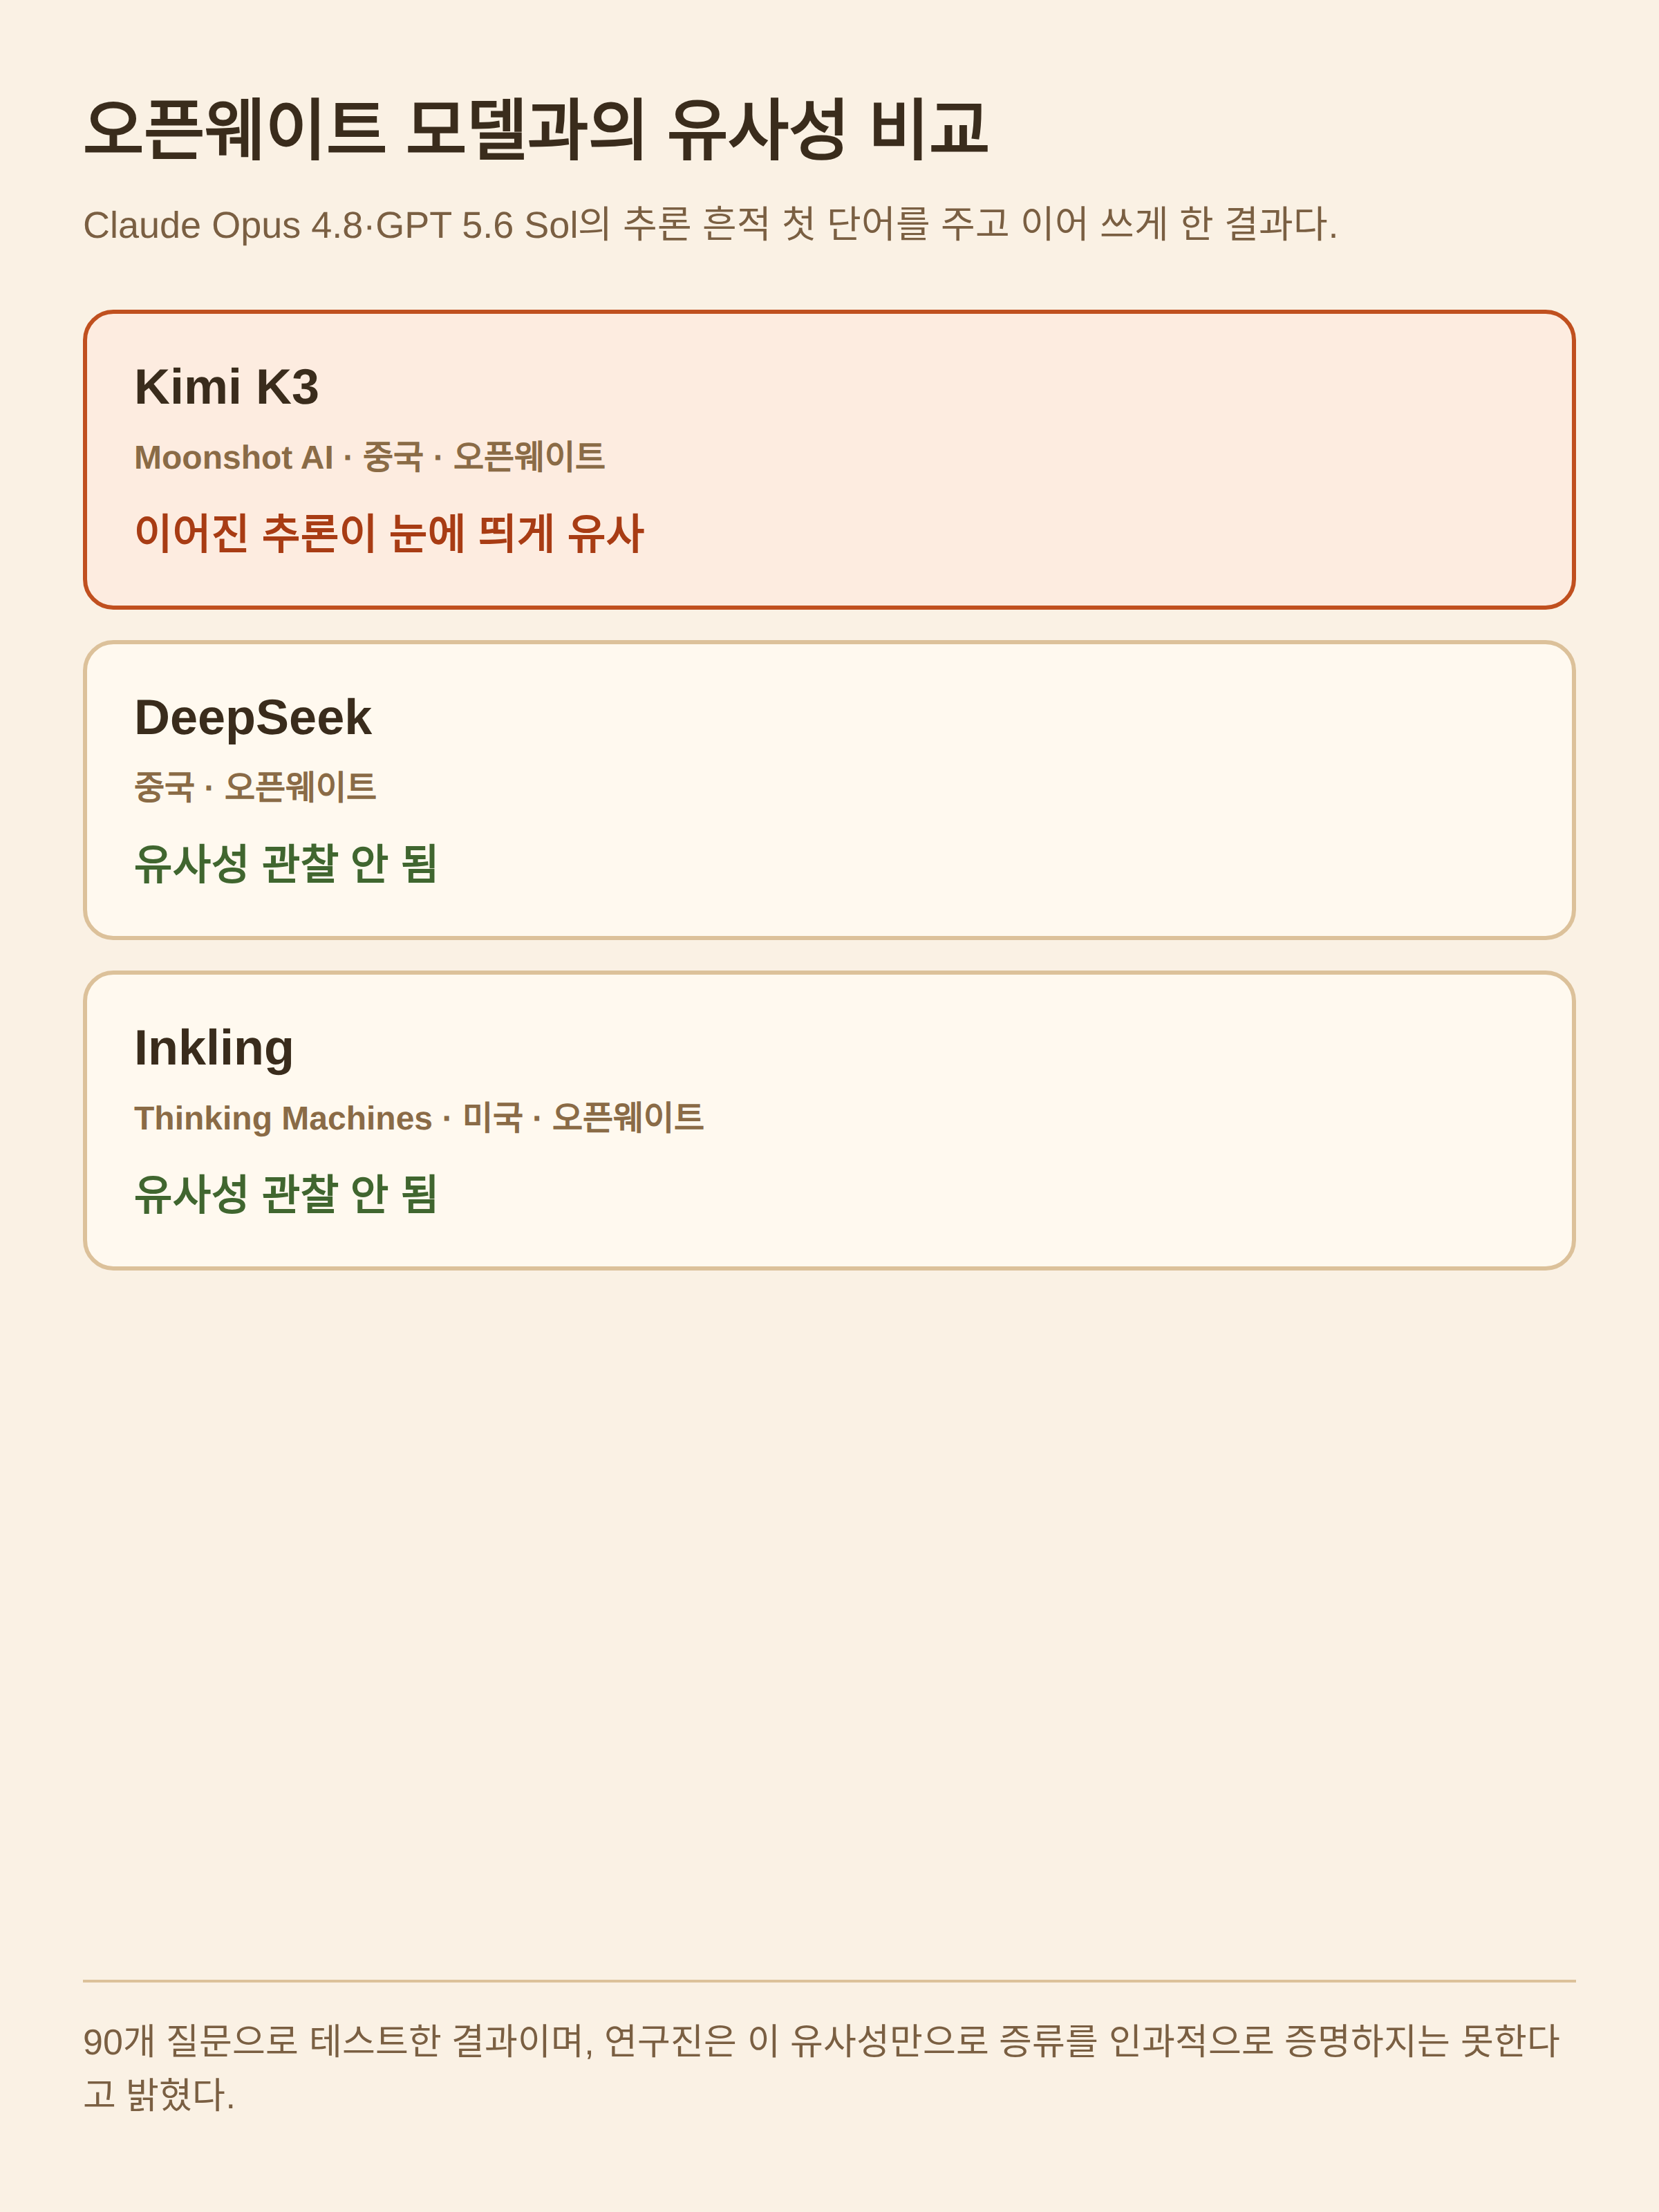
연구진은 논문에서 이 결과가 "증류를 인과적으로 입증하지는 못한다"고 분명히 선을 그었다. 문샷AI와 즈AI(Z.ai)는 보도 시점까지 논평 요청에 응답하지 않았다. 다만 이번 발견은 폐쇄형 모델에서 이전에 알려진 것보다 더 많은 정보를 증류해 낼 수 있다는 가능성을 새로 제시한다.
증류 자체는 기존 모델의 능력을 새 모델로 효율적으로 옮기는 널리 쓰이는 기법으로, 오픈웨이트 모델 개발에서 특히 흔하다. 다만 최근 들어서는 중국 AI 기업이 이를 이용해 미국의 최상위 모델을 사실상 베낀다는 주장이 나오면서 민감한 주제가 됐다. 지난 2월 OpenAI는 미국 의회에 딥시크가 자사 모델을 베껴 추론 모델 R1을 만든 것으로 보인다고 밝혔고, 6월에는 Anthropic이 알리바바가 자사 모델을 체계적으로 증류해 Qwen을 만들었다고 의회에 전했다. 이번 연구는 중국 AI 기업이 실제로 이 특정 기법을 사용했다는 근거를 제시하지는 않았다.
개인정보 유출은 얼마나 심각했고 지금은 어떤가
같은 방법으로 사용자 컴퓨터에서 포착한 추론 흔적에 담긴 API 키와 비밀번호 같은 민감 정보도 복원됐다. 연구진은 지난달 OpenAI, Anthropic, Google에 이 취약점을 알렸고, 세 회사 모두 이후 API를 조정해 문제를 완화했다. 판필로프는 이제 이 방법으로 개인정보를 추출하는 것은 더 이상 불가능하지만, 일부 추론 흔적은 여전히 같은 방식으로 드러날 수 있다고 말했다. 증류를 완전히 막으려면 이들 회사의 API 작동 방식 자체를 근본적으로 뜯어고쳐야 한다는 설명이다.
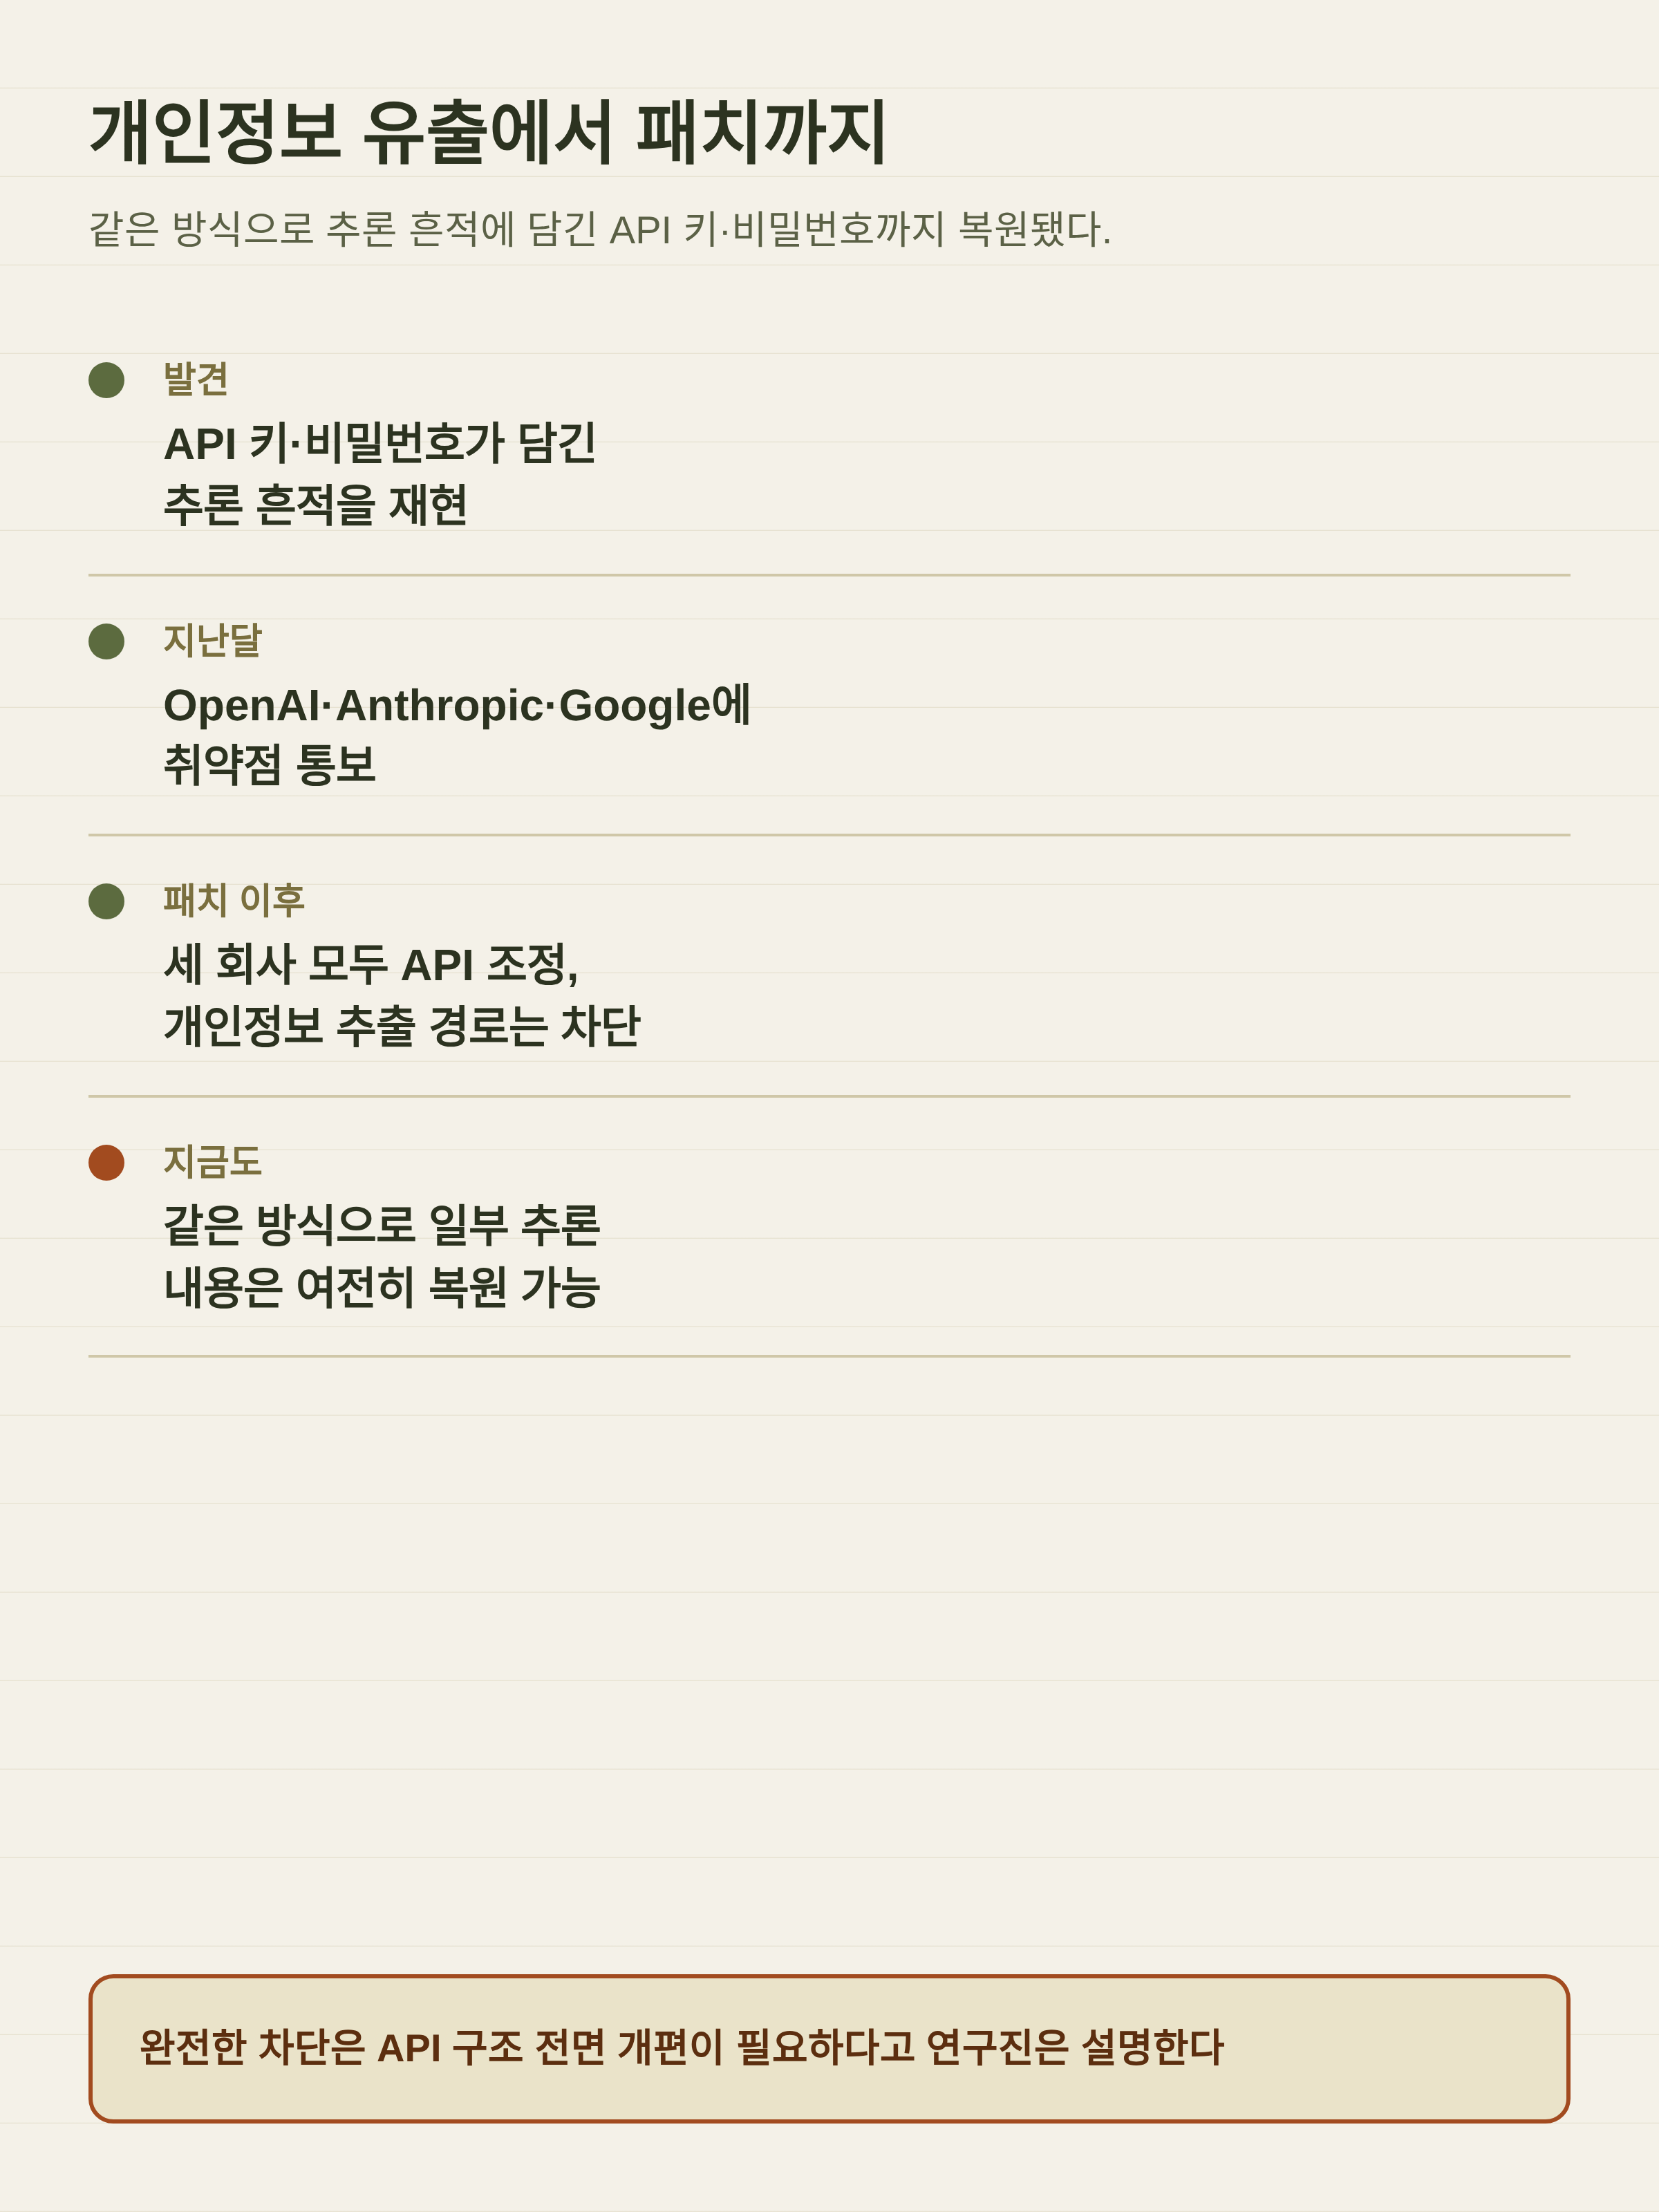
Anthropic 대변인 마이클 아치먼(Michael Aciman)은 "우리는 모델에 대한 독립적인 연구를 중요하게 여기며, 보고서에 기술된 재생(replay) 행위에 대한 단기 완화책을 마련하기 시작했다"고 밝혔다. 그는 이번 연구가 암호화 키를 복구하거나 Anthropic의 인프라에 접근하거나 시스템에서 개인정보를 회수하는 방식은 아니었다고 덧붙였다. Google과 OpenAI는 논평 요청에 답하지 않았다.
증류를 둘러싼 논쟁은 어디로 향하나
증류는 최근 몇 달간 미국과 중국 기업이 점점 더 강력한 모델로 AI 패권을 다투면서 지정학적으로도 중요한 문제가 됐다. 중국이 미국 기술을 증류해 저비용 오픈웨이트 모델을 만듦으로써 전략적 이점을 얻는다는 주장이 있는 반면, 증류가 특정 분야에서 모델 성능을 빠르게 끌어올리는 데 널리 쓰이는 정당한 방법이라는 반론도 있다. 메타 CEO 마크 저커버그는 최근 블로그 글에서 증류가 "오픈소스 생태계가 작동하는 중요한 원리"이며 이를 제한하면 미국이 오히려 불리해질 것이라고 주장했다.
기술 정책 싱크탱크 안보·신흥기술센터(CSET)의 카일 밀러(Kyle Miller) 연구원은 증류가 중국에 실제로 얼마나 도움이 되는지는 불분명하다고 지적한다. 증류는 기존 모델의 능력을 제한적으로만 끌어올릴 뿐이고, 중국 기업들은 필요하다면 처음부터 최첨단 모델을 만들 역량을 이미 갖추고 있는 것으로 보이기 때문이다. 옥스퍼드 대학교의 야린 갈(Yarin Gal)은 증류가 널리 쓰일 뿐 아니라 AI 발전 속도를 높이는 데도 기여해 왔다며, "모두가 서로의 증류를 막는 것이 규범이 된다면 그것 역시 (AI) 발전 속도에 영향을 미칠 것"이라고 말했다.
기업과 정책 입안자가 증류를 제한하는 조치를 도입하더라도, AI 모델이 예상치 못한 방식으로 내부 사고 과정을 드러낼 가능성 자체는 쉽게 사라지지 않을 것으로 보인다.
출처: WIRED, A New Trick Reveals AI Models' Inner Thoughts (2026-08-12 확인)