
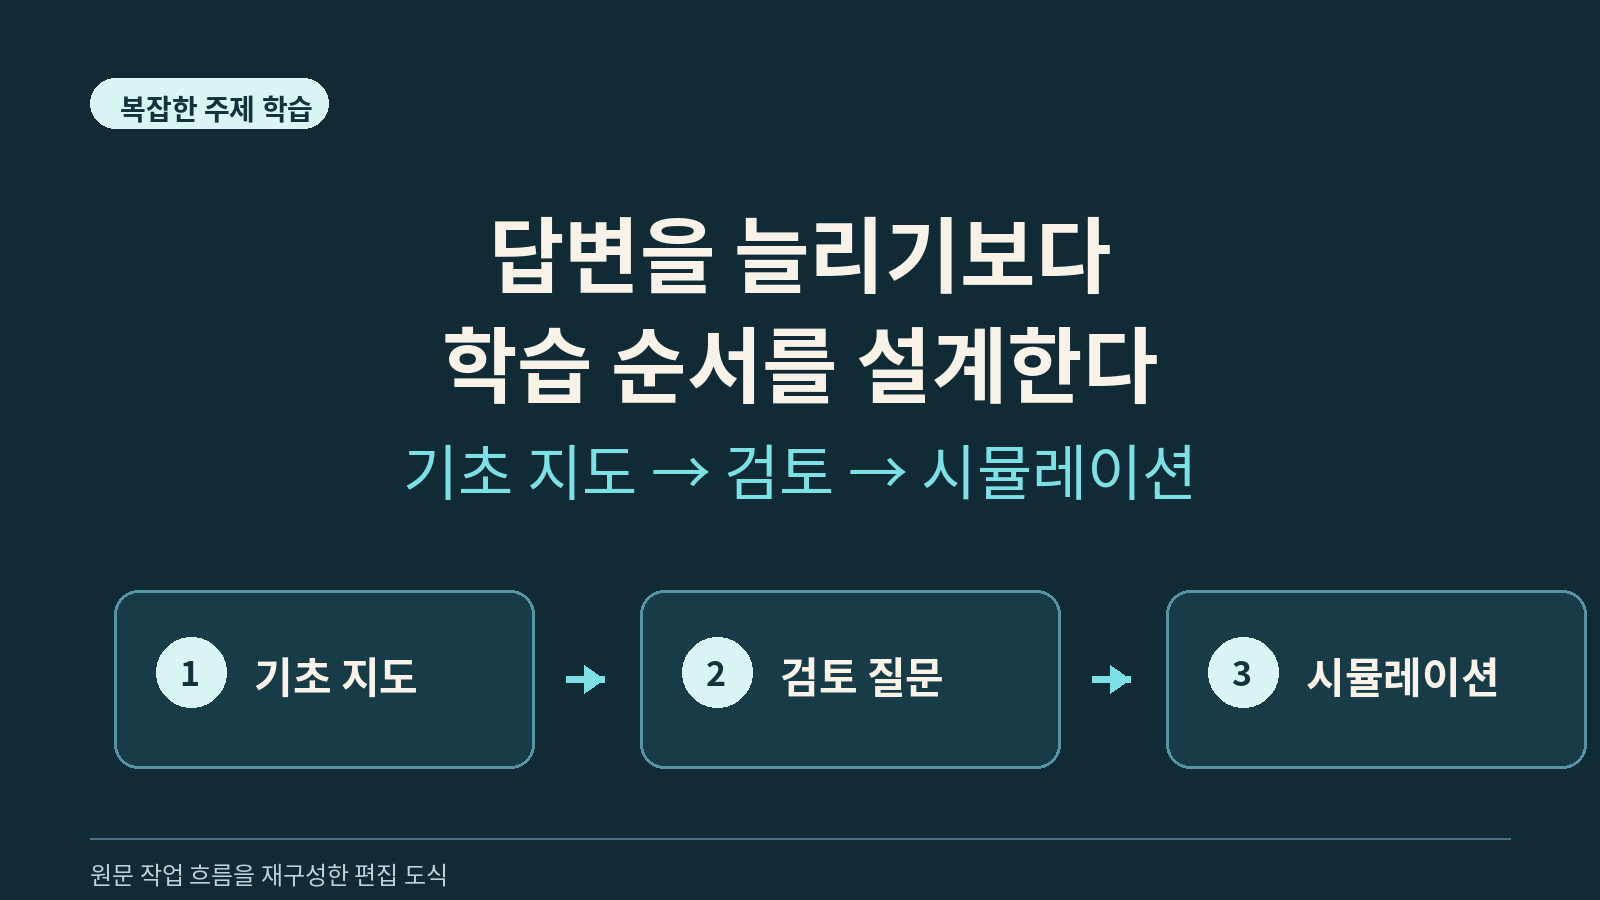
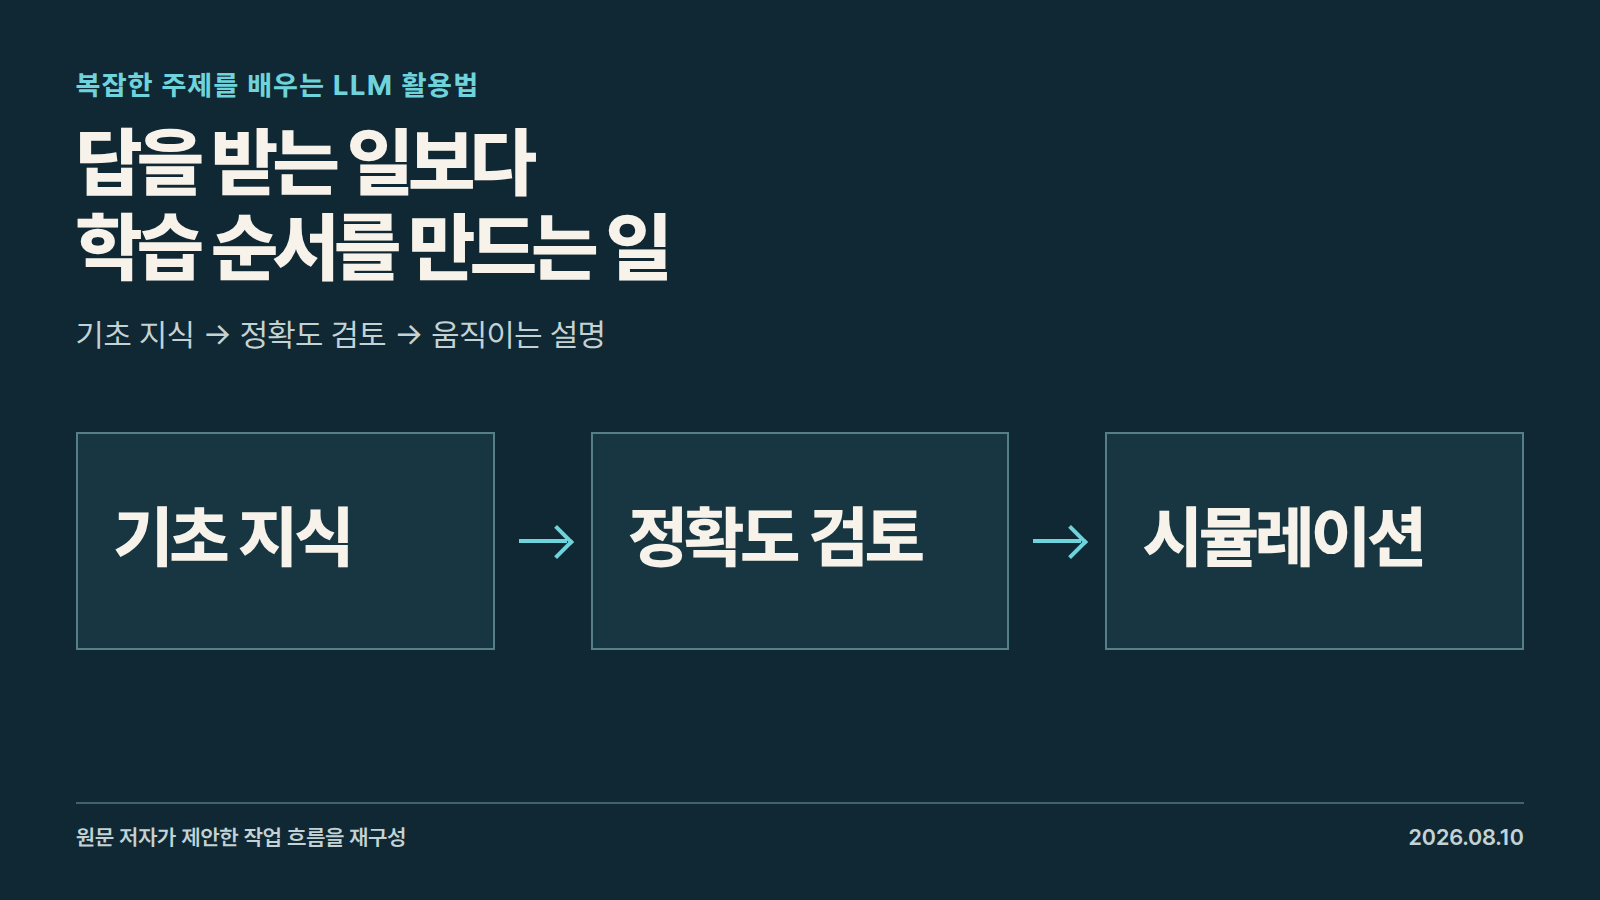
복잡한 주제를 LLM으로 배울 때 가장 먼저 바꿀 것은 프롬프트의 길이가 아니라 학습의 순서다. 개발자 Laurentiu Raducu는 2026년 8월 9일 글에서 Claude Code 또는 OpenCode의 계획 모드로 주제의 기초 지식을 만들고, 그 지식의 정확도를 다시 검토한 뒤, 저해상도 시뮬레이션으로 과정을 구현하는 흐름을 제안했다. 마지막에는 저장소를 만들고 GitHub Pages에 올렸다. 답변 한 번을 읽고 끝내는 대신, 다음 단계의 입력이 될 학습 지도를 먼저 만든 셈이다.
저자가 고른 사례는 반도체 제조다. 모래를 싣고 이동하는 수레가 채집부터 데이터센터에 칩이 도착할 때까지 어떻게 바뀌는지 애니메이션으로 따라가게 했다. 이 사례가 보여 주는 핵심은 ‘그림으로 외우기’가 아니다. 어떤 단계가 먼저이고, 무엇이 다음 변화를 일으키며, 객체가 어느 지점에서 달라지는지를 화면의 시간 순서로 다시 묻는 데 있다.
왜 기초 지식을 먼저 만들어야 하는가
처음부터 “이 주제를 시뮬레이션으로 만들어 달라”고 요청하면 화면에 넣을 대상과 빠진 단계를 판별할 기준도 함께 비어 있다. 반대로 기초 지식 단계에서 용어, 물질이나 장치, 각 단계의 앞뒤 관계를 한 장의 지도처럼 정리하면 검토할 질문이 생긴다. “무엇이 빠졌나”, “어떤 변화가 다음 단계를 일으키나”라고 물을 수 있어야 수정도 구체적이 된다. 여기서 검토는 정답 인증 도장이 아니라 다음 요청의 대상과 조건을 구체화하는 단계다.
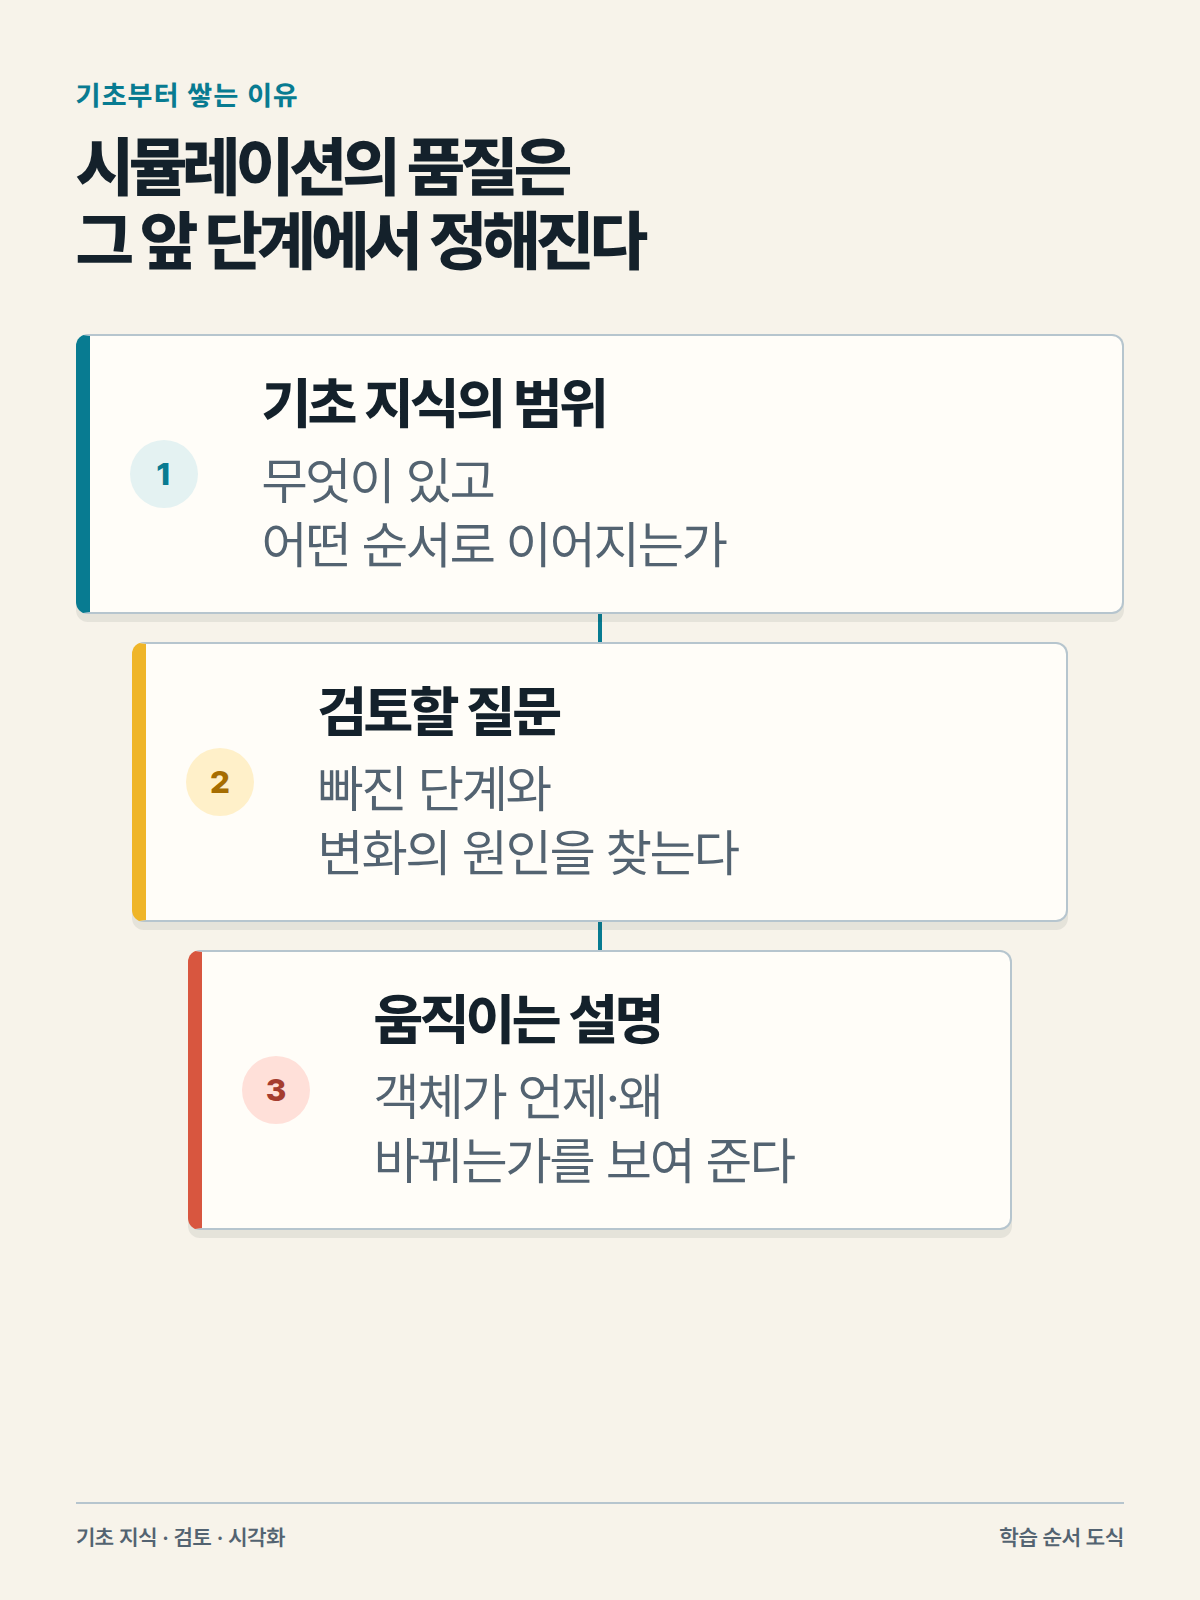
시뮬레이션은 결과물이 아니라 질문을 만드는 도구다
저자는 저해상도 표현만으로는 석영 모래가 용광로를 지난 뒤 무엇으로 바뀌었는지 충분히 떠올리기 어려울 수 있다고 썼다. 그래서 사진을 3D 객체로 바꾸는 도구로 모델을 더 구체화하고, 이전 공정을 묻는 도전 과제와 직관적인 퍼즐을 더하는 방법을 제시한다. 화면을 멈춘 뒤 “왜 지금 바뀌었나”를 설명하지 못한다면, 다음 장면으로 넘어가기보다 기초 지도와 검토 단계로 돌아갈 이유가 생긴다.
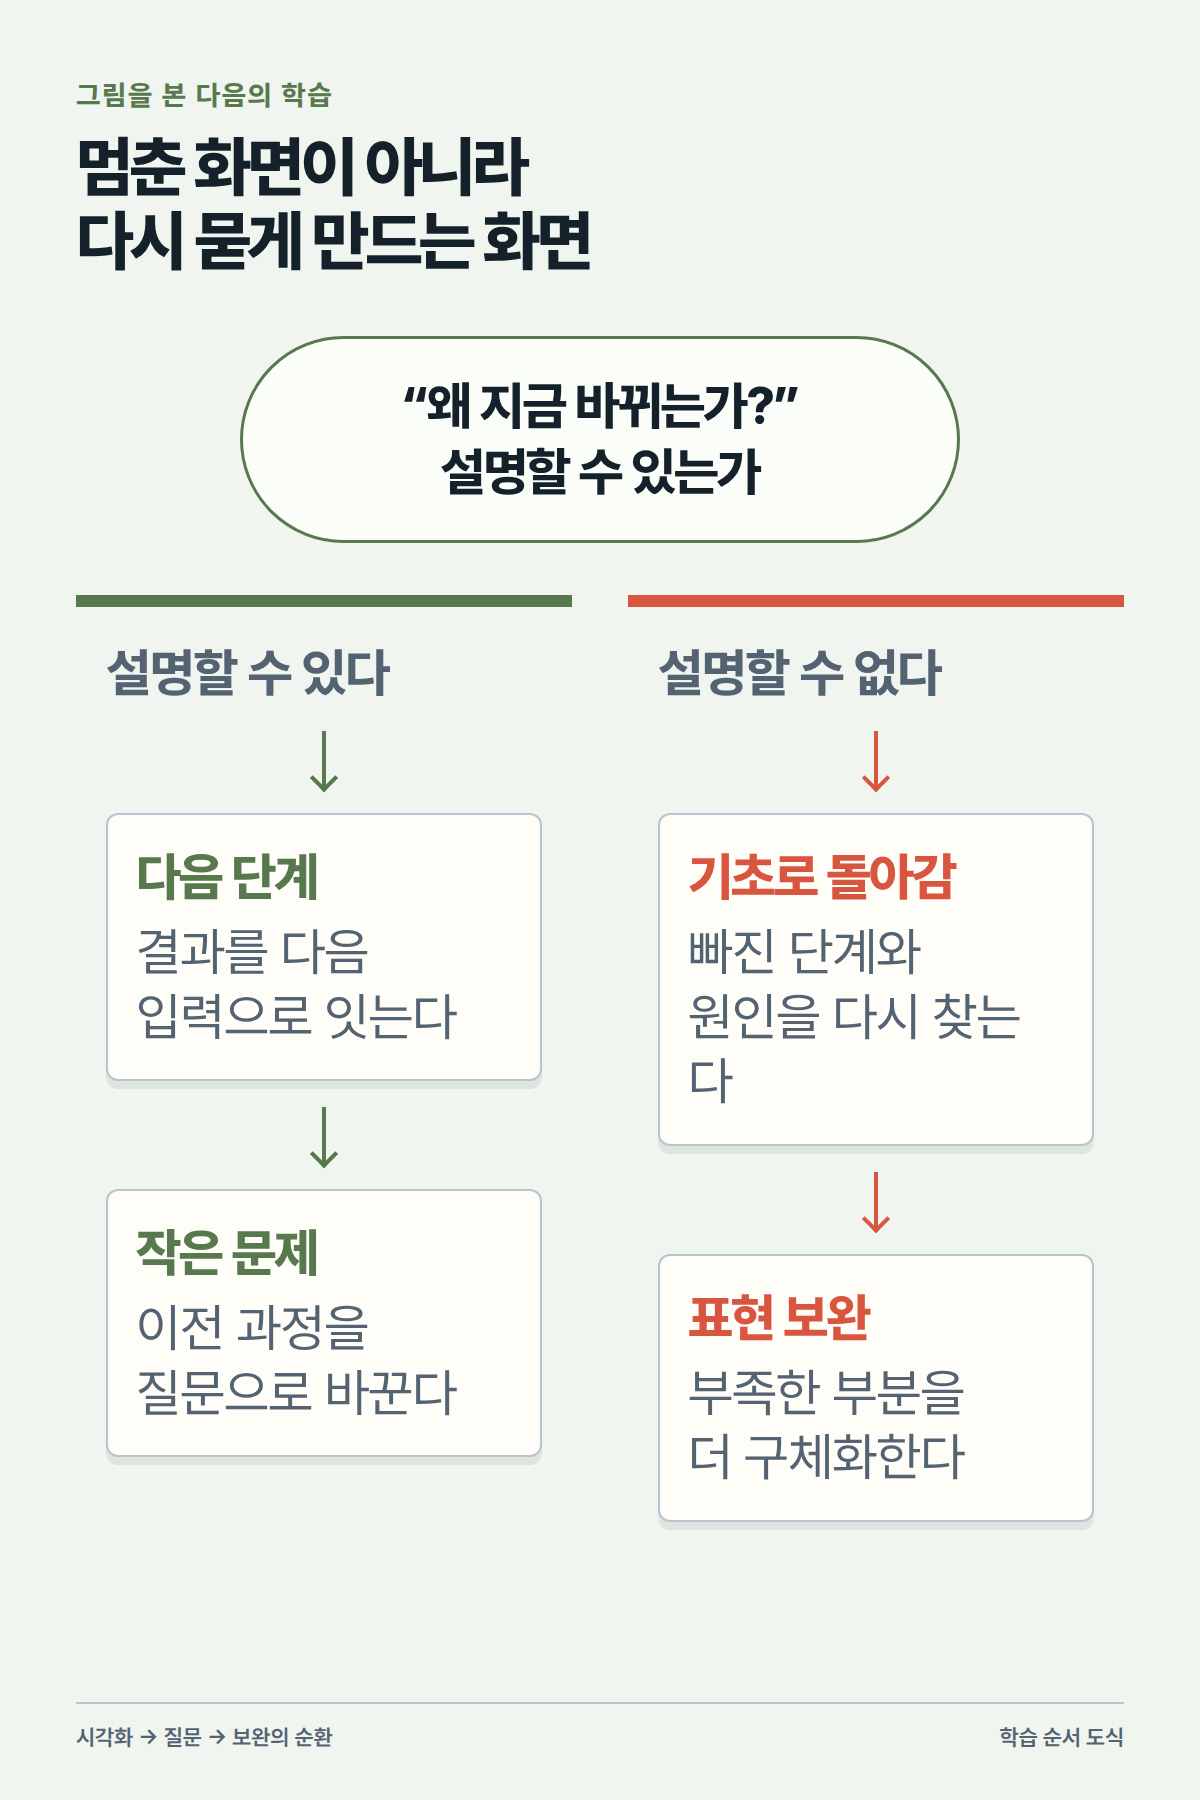
LLM에게 무엇을 순서대로 요청할까
이 방식을 적용할 때 첫 요청은 완성된 설명이나 앱이 아니라 “주제를 이루는 대상, 단계, 각 단계의 입력과 출력, 아직 확실하지 않은 연결을 표로 정리해 달라”가 된다. 두 번째 요청에서는 그 표의 누락·중복·인과 관계를 검토하게 한다. 세 번째에서야 각 단계를 눈에 보이는 객체와 이동으로 바꾸고, 일시 정지·단계 이동·이전 단계 질문 같은 상호작용을 붙인다.
예를 들어 새 API 인증을 배운다면 첫 표에는 클라이언트, 인증 서버, 토큰, 보호 자원과 요청·응답의 순서를 넣는다. 검토 단계에서는 토큰이 발급된 뒤 어디에 전달되고 어떤 조건에서 거절되는지를 따로 확인한다. 그 다음에야 브라우저·서버·저장소를 오가는 흐름을 장면으로 만들 수 있다. 화면의 화살표 하나가 실제로는 어떤 요청과 상태 변화를 뜻하는지 묻는 순간, 막연한 설명은 점검 가능한 학습 과제로 바뀐다.
이 순서는 기술 분야에만 국한되지 않는다. 새 API의 인증 흐름, 물류의 재고 이동, 조직의 승인 절차처럼 ‘무엇이 먼저 일어나고 무엇이 바뀌는가’가 중요한 주제라면 같은 방식으로 적용할 수 있다. LLM은 긴 설명을 즉시 내놓는 도구이기도 하지만, 더 유용한 역할은 학습자가 검토할 수 있는 중간 구조를 빠르게 만들고 바꾸는 데 있다. 복잡함을 줄이는 것은 답변의 분량이 아니라, 답변을 다시 쓰게 만드는 순서다.
출처: Laurentiu Raducu, How I use LLMs to learn complex topics (2026-08-10 확인)