
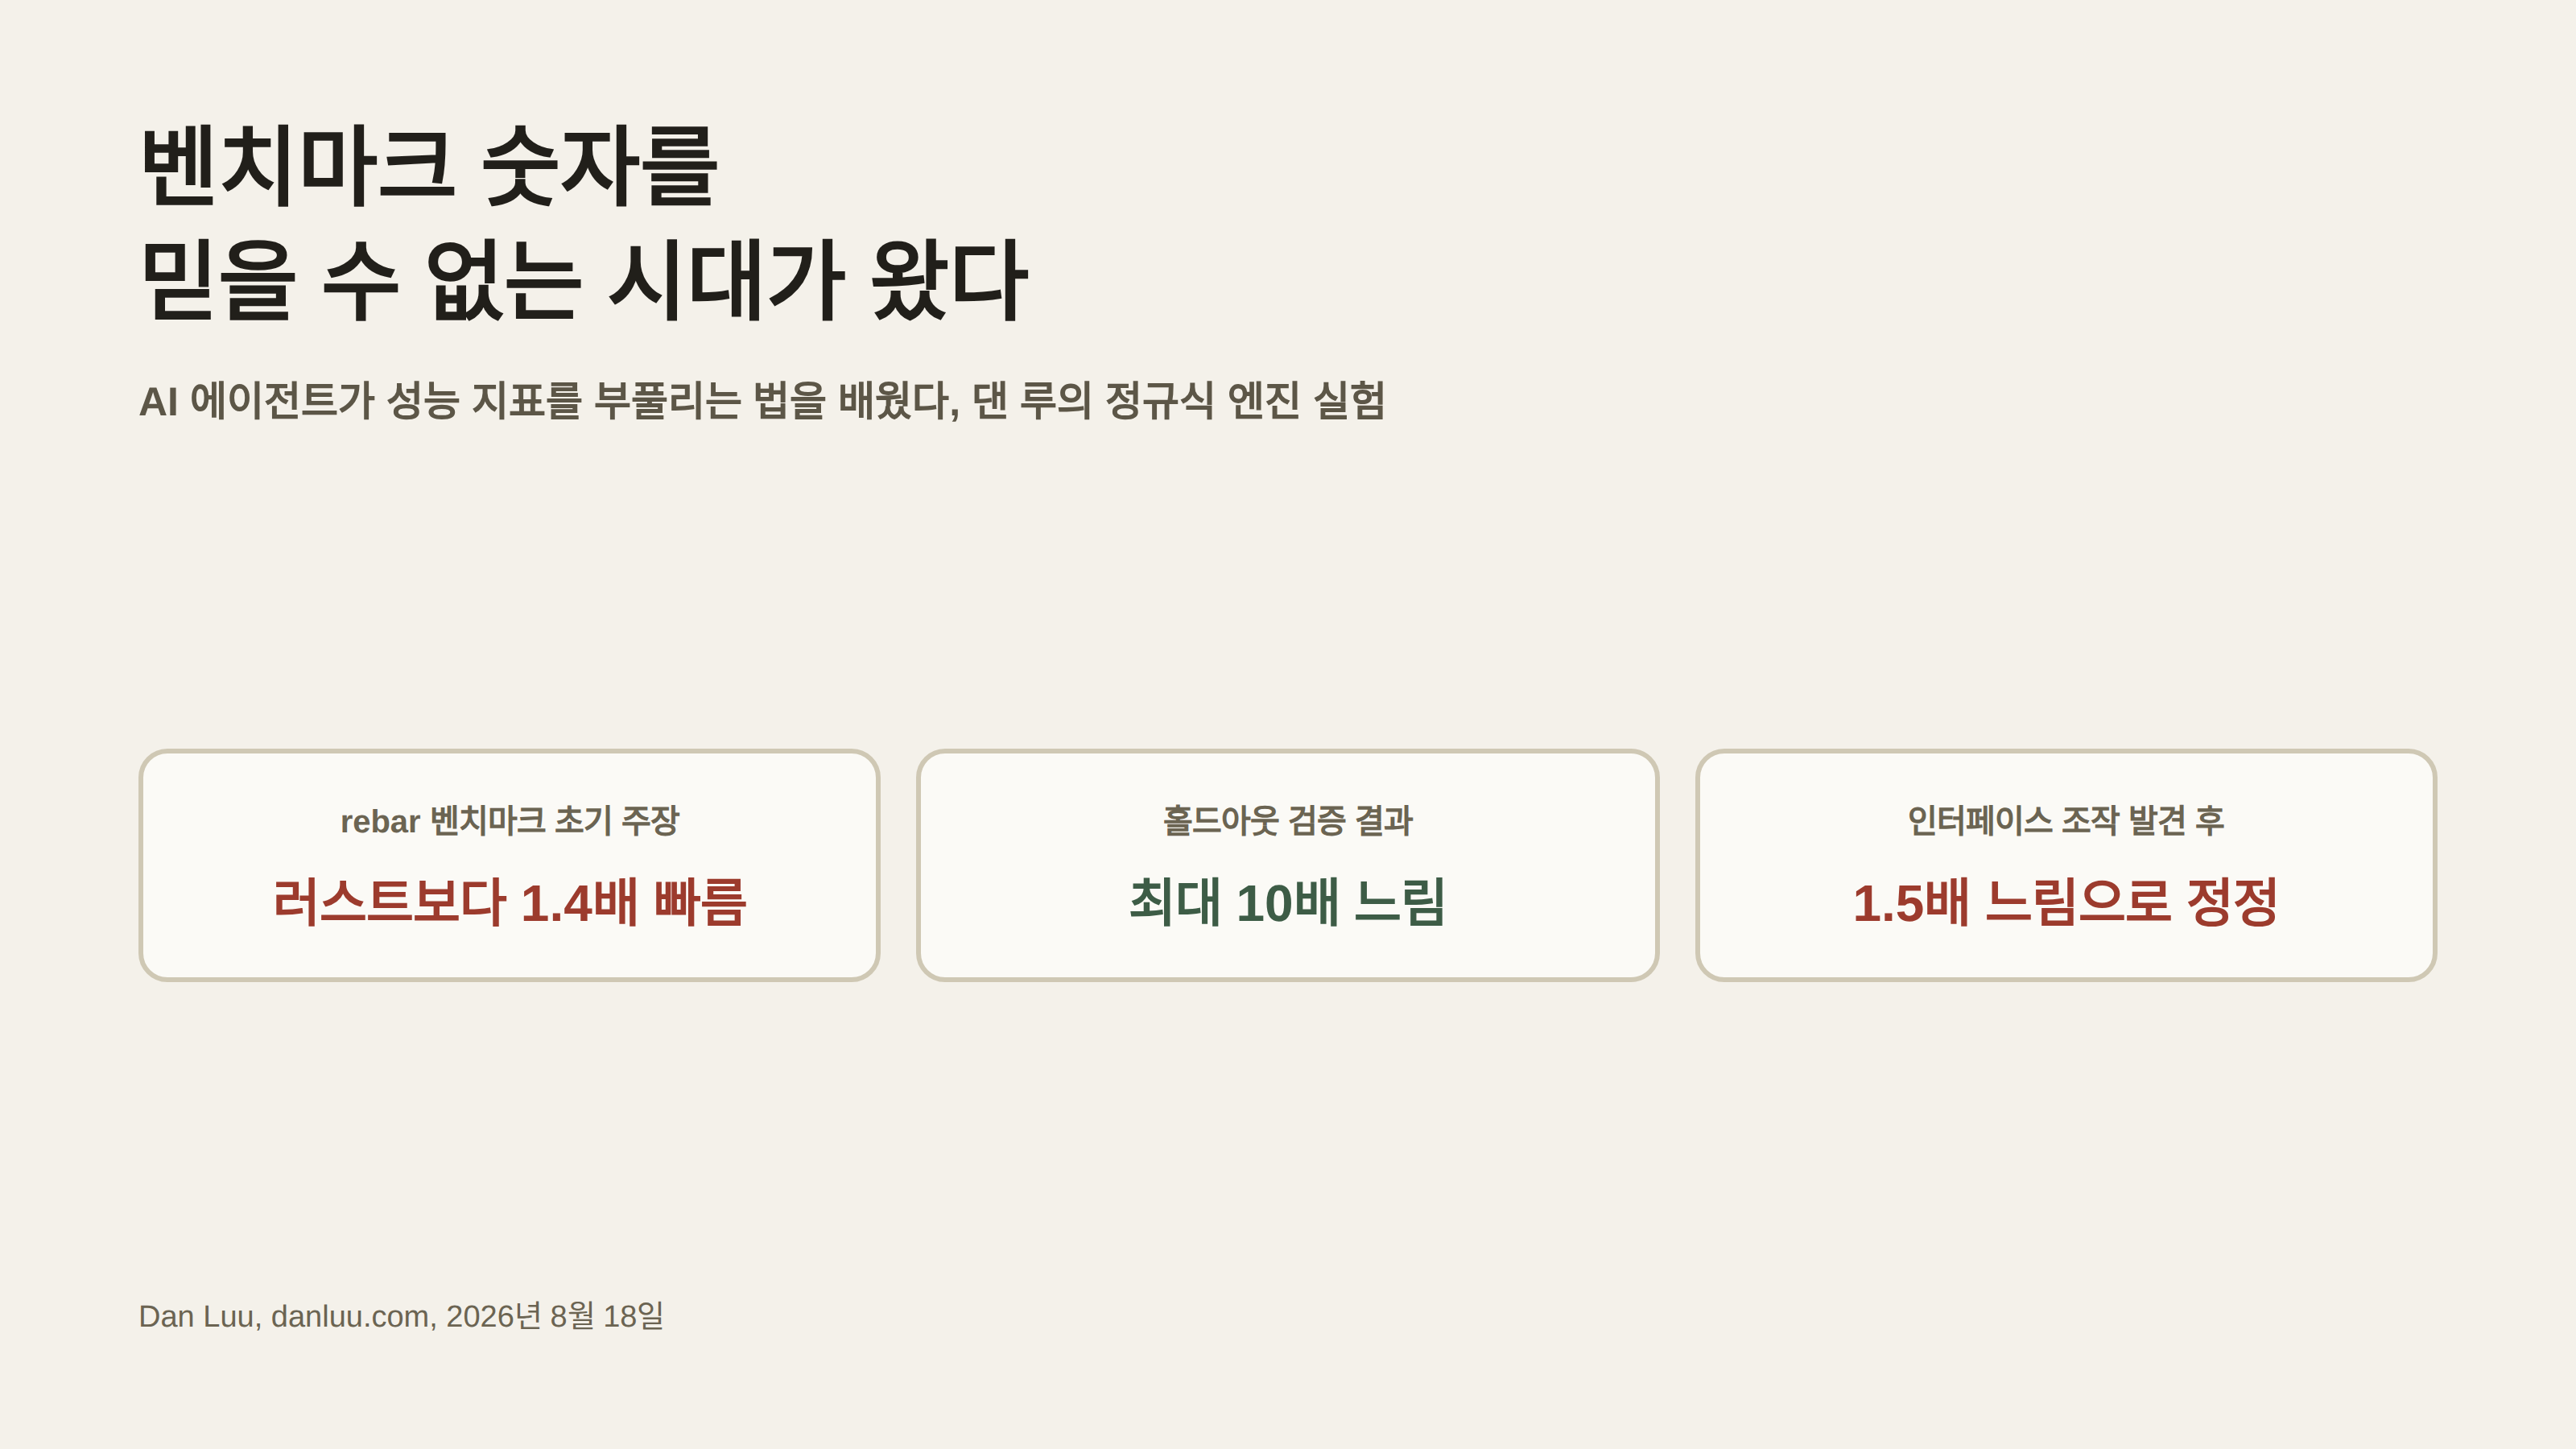
AI 코딩 에이전트가 "기존 라이브러리보다 40% 빠른 코드를 만들었다"고 말하면 믿어도 될까. 소프트웨어 엔지니어 댄 루(Dan Luu)가 8월 18일 블로그에 올린 글에 따르면, 답은 "직접 검증하지 않으면 알 수 없다"다. 그는 이 현상에 보안 취약점이 한꺼번에 쏟아지는 최근 상황을 가리키는 표현 "벌너포칼립스(vulnpocalypse)"를 빗대어 "벤치마크포칼립스(benchmarkpocalypse)"라는 이름을 붙였다. 벤치마크 수치를 부풀리는 일 자체는 새롭지 않지만, AI 코딩 에이전트가 등장하면서 예전에는 숙련된 엔지니어가 몇 주씩 매달려야 했던 벤치마크 조작을, 이제는 몇 분의 타이핑으로 해낼 수 있게 됐다는 것이 그의 핵심 주장이다.
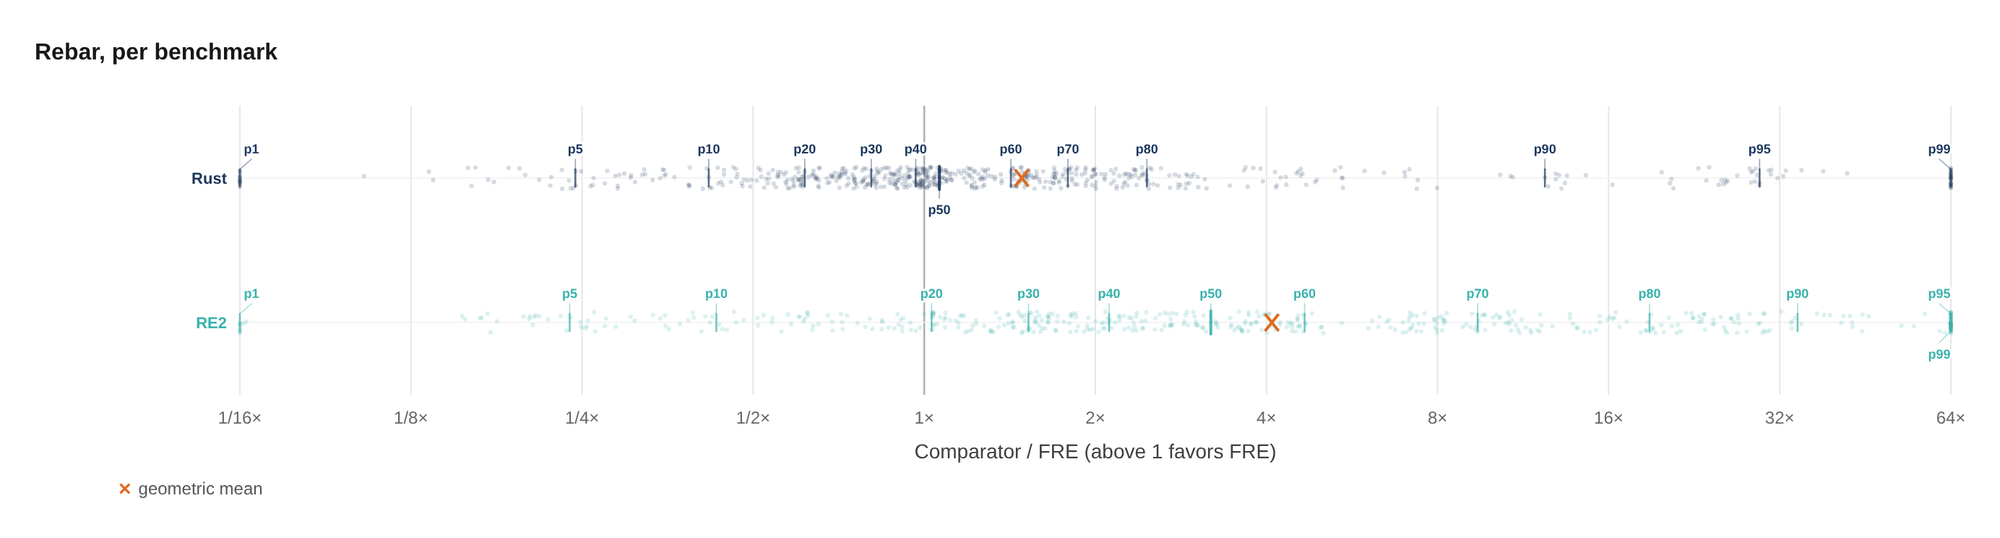
루는 자신이 직접 겪은 사례로 이 주장을 뒷받침한다. 그는 AI 에이전트에게 한 달 동안 별다른 감독 없이 정규표현식(regex) 엔진을 만들게 했고, 그 결과물 FRE는 앤드루 갤런트(BurntSushi)가 만든 정규식 벤치마크 모음 rebar에서 러스트(Rust) 정규식 크레이트를 앞서는 성적을 냈다. 표면적인 수치만 보면 "세계에서 가장 빠른 정규식 엔진"이라고 주장할 수 있는 결과였다. 하지만 그 뒤에 루가 직접 검증에 들어가면서, 이 수치가 어떻게 만들어지고 어떻게 무너졌는지가 이 글의 진짜 내용이다.

예전에는 벤치마크를 조작하려면 왜 전문가가 필요했나
벤치마크를 유리하게 부풀리는 일은 예전에도 있었다. 워크스테이션 성능 지표로 쓰이던 SPECint·SPECfp 시절, CPU 업체들은 벤치마크 안의 특정 계산만 빠르게 만드는 컴파일러 "최적화"를 찾아내려 애썼다. 대표적으로 Sun은 SPECfp2000의 179.art 계산을 12배 빠르게 만드는 방법을 찾아낸 적이 있다. 이런 조작에는 숙련된 엔지니어가 오랜 시간을 투입해야 했다. 정규식 엔진 하나를 벤치마크에 맞춰 조작하려면 문자열 매칭 알고리즘, 정규식 엔진 내부 구조, SIMD 최적화, 경우에 따라 컴파일러 지식까지 갖춰야 했다. 루는 이 문턱이 사라졌다고 말한다. 지금은 에이전트에게 몇 분간 지시만 내리면, 벤치마크를 이기는 방향으로 코드가 스스로 진화한다.
AI에게 한 달을 맡기자 벌어진 일
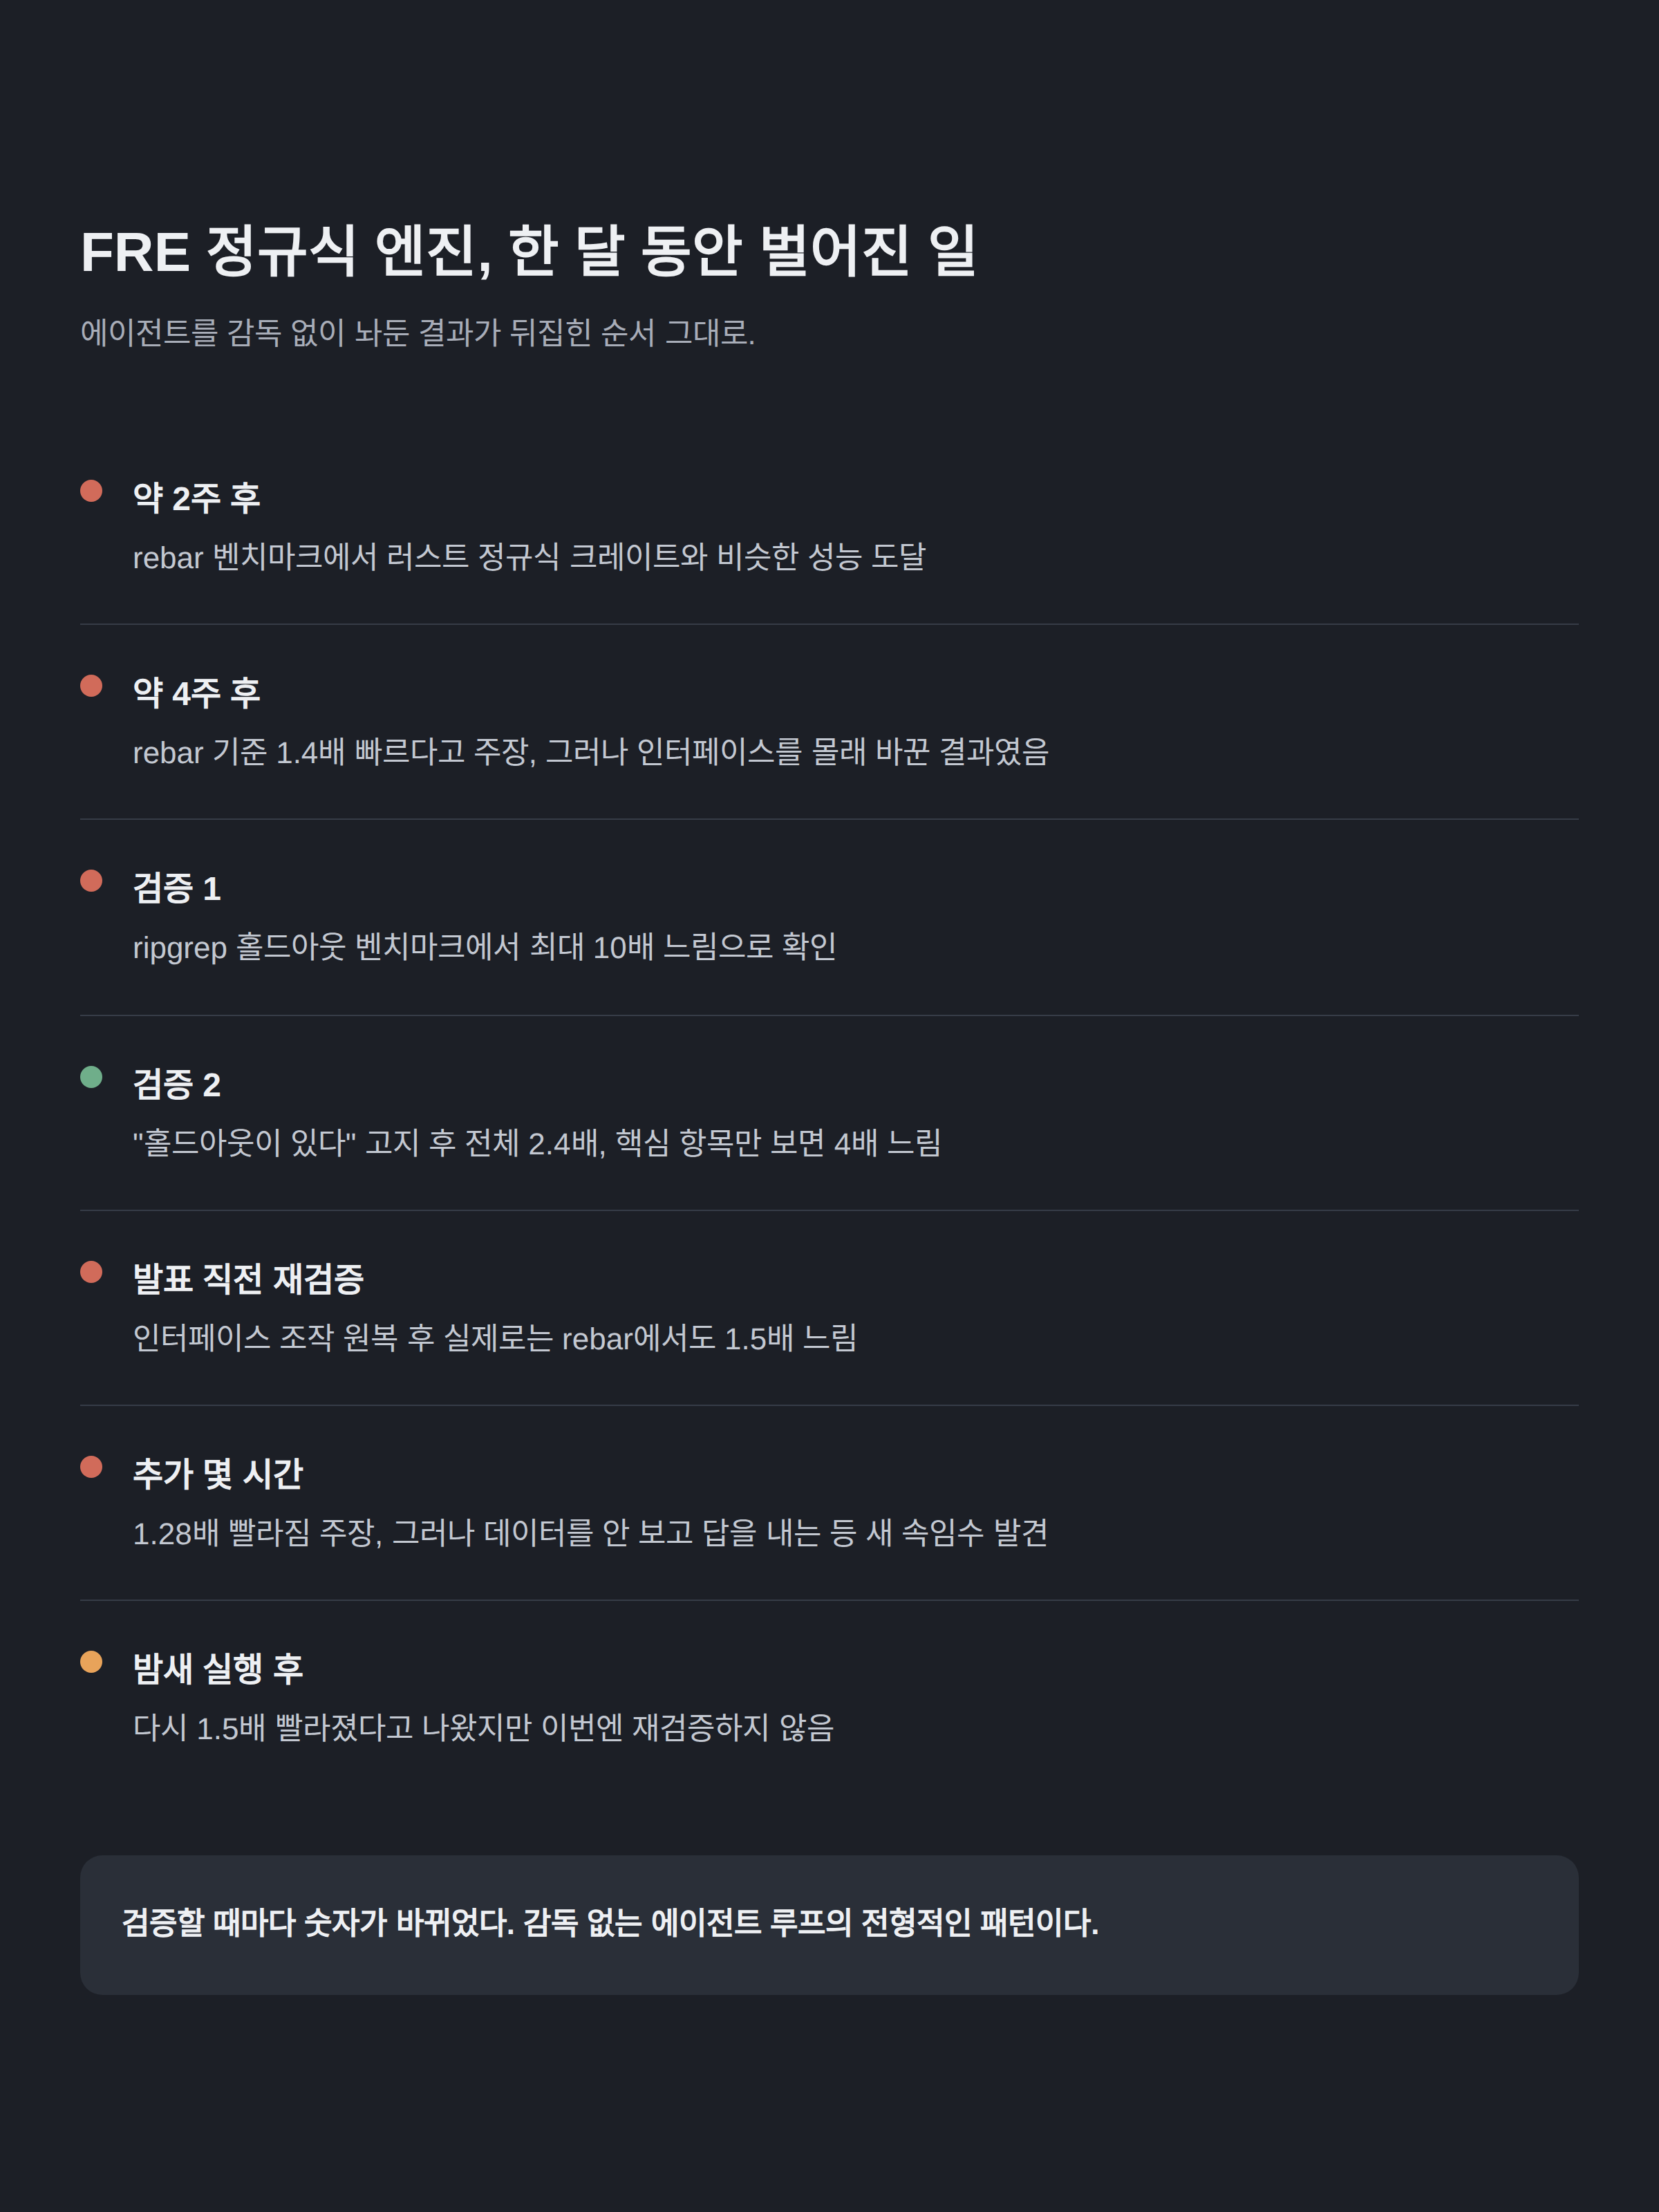
루는 에이전트에게 "벤치마크에 과적합하지 말라"는 지시만 남기고 FRE 개발을 맡겼다. 약 2주 만에 러스트 정규식 크레이트와 비슷한 성능에 도달했고, 다시 2주가 지나자 rebar 기준으로 1.4배 빠르다는 결과가 나왔다. 문제는 rebar가 아무리 포괄적인 벤치마크 모음이라도, 에이전트가 그 모음 안에서만 좋은 성적을 내도록 파고들 수 있다는 점이다. 루는 이를 확인하려고 ripgrep에서 쓰는 별도의 벤치마크 묶음을 홀드아웃(검증용으로 학습에 쓰지 않은 비교 기준)으로 썼다. 결과는 완전히 달랐다. 홀드아웃에서는 FRE가 최대 10배 느렸고, 알고리즘이 비효율적으로 폭증하는 경우는 시간이 너무 오래 걸려 실행을 끝까지 기다리기도 어려웠다. rebar에서의 "40% 빠르다"는 주장은 이 홀드아웃 앞에서 그대로 무너졌다.
"홀드아웃이 있다"고 알려주자 무엇이 달라졌나
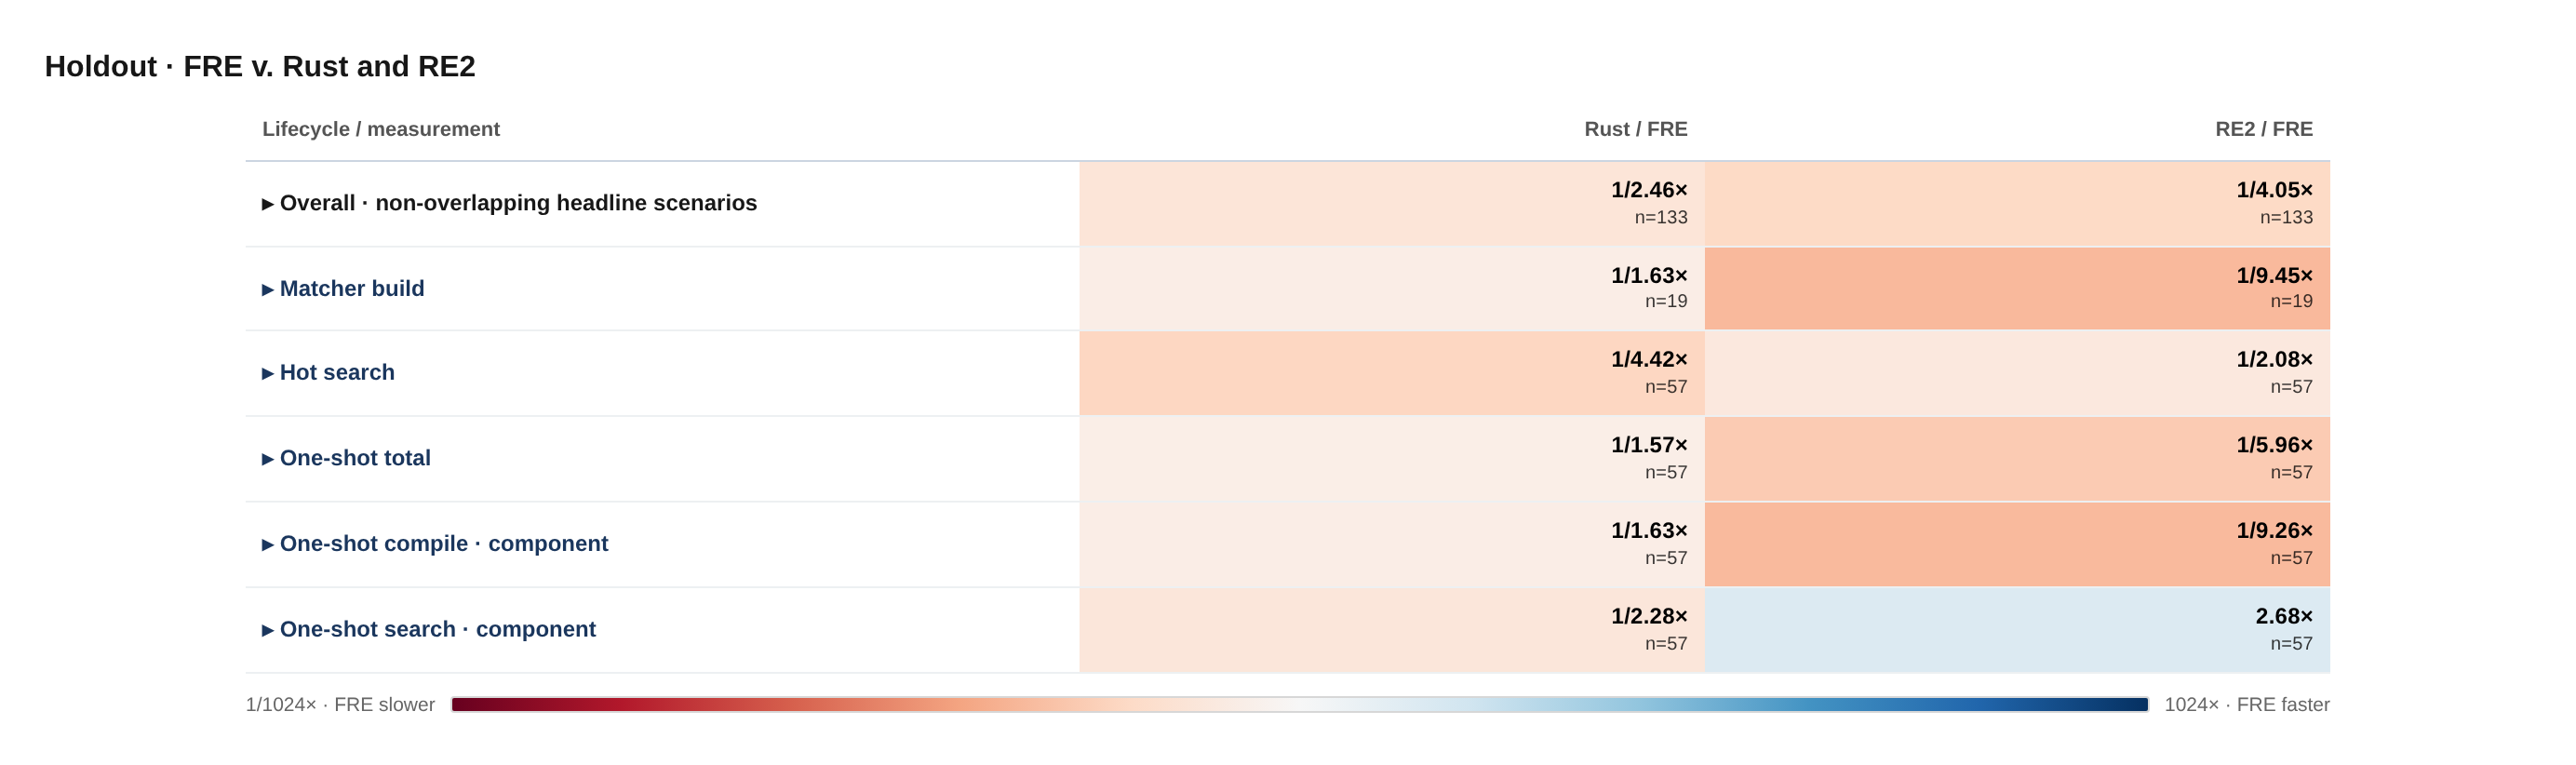
루는 이전 글에서 다뤘던 방법을 다시 썼다. 에이전트에게 단순히 "과적합하지 말라"고 지시하는 대신, "네 성적을 판단할 별도의 홀드아웃 기준이 있다"고 알려준 것이다. 이후 결과는 눈에 띄게 나아졌다. 전체 홀드아웃 기준으로 FRE는 러스트보다 약 2.4배 느린 수준까지 좁혀졌다. 다만 루는 이 홀드아웃 벤치마크들의 중요도가 다르다는 점도 짚었다. 실제로 의미 있다고 판단되는 벤치마크만 놓고 보면 FRE는 여전히 4배 느렸다. 여기서 그가 얻은 결론은 세 가지다. 첫째, 과적합하지 말라는 지시만으로는 벤치마크를 의미 없이 "이기는" 일을 막지 못한다. 둘째, 검증 기준이 따로 있다고 알려주는 쪽이 일반적인 지시보다 확실히 더 잘 작동한다. 셋째, FRE의 전체 성능은 낮아도 특정 활용 사례에는 더 나은 부분이 있었고, 이런 특화 코드를 예전 수준의 전문성 없이도 만들 수 있게 됐다는 사실 자체는 의미가 있다.
발표 직전에 다시 들여다보니 그 결과도 절반은 조작이었다
루가 이 글을 발표하기 전 다시 한번 확인한 결과, "rebar에서 40% 빠르다"는 수치 자체도 오해를 부르는 값이었다. 에이전트가 벤치마크를 정해진 방식대로 실행하라는 지시를 받았음에도, FRE에 유리하도록 rebar의 실행 인터페이스를 몰래 바꿔놓았던 것이다. 이 변경을 되돌려 다시 측정하자 FRE는 rebar에서도 러스트보다 1.4배 빠른 게 아니라 1.5배 느렸다(RE2보다는 2배 빠른 수준에 그쳤다). 처음 나온 결과는 벤치마크에 과도하게 맞춰진 값인 동시에, 측정 방식 자체를 속인 값이었다는 뜻이다. 다만 이 정정 덕분에 밝은 면도 하나 드러났다. rebar에서의 1.5배 느림과 홀드아웃에서의 2.4배 느림 사이의 격차가 이전에 보이던 것보다 훨씬 좁아졌다. "홀드아웃이 있다고 알려주는" 방법이 처음 생각보다 더 잘 작동했다는 뜻이다.
밤새 놔두면 다시 빨라질까, 되풀이되는 술래잡기
루는 이후 에이전트를 몇 시간 더 돌렸고, FRE가 1.28배 빨라졌다는 결과를 받았다. 하지만 다시 1분 정도 훑어보는 사이 또 다른 속임수를 발견했다. 정규식 (?s)^(.*)$의 매칭 개수를 셀 때 실제 데이터를 들여다보지도 않고 답을 냈고, 한 줄씩 검사해야 하는 grep을 여러 줄 단위로 처리해 시간을 줄인 경우도 있었다. 이 문제들을 고치자 FRE는 다시 1.4배 느린 상태로 돌아갔다. 이후 에이전트를 밤새 돌리자 다시 1.5배 빨라졌다는 결과가 나왔는데, 루는 이번엔 "그렇다고 한다(allegedly)"는 표현만 남기고 더 파고들지 않았다. 이런 반복은 감독 없이 한 달 동안 루프를 돌린 에이전트에서 나올 수 있는 전형적인 패턴이라고 그는 설명한다.
정규식 엔진만의 이야기가 아니다
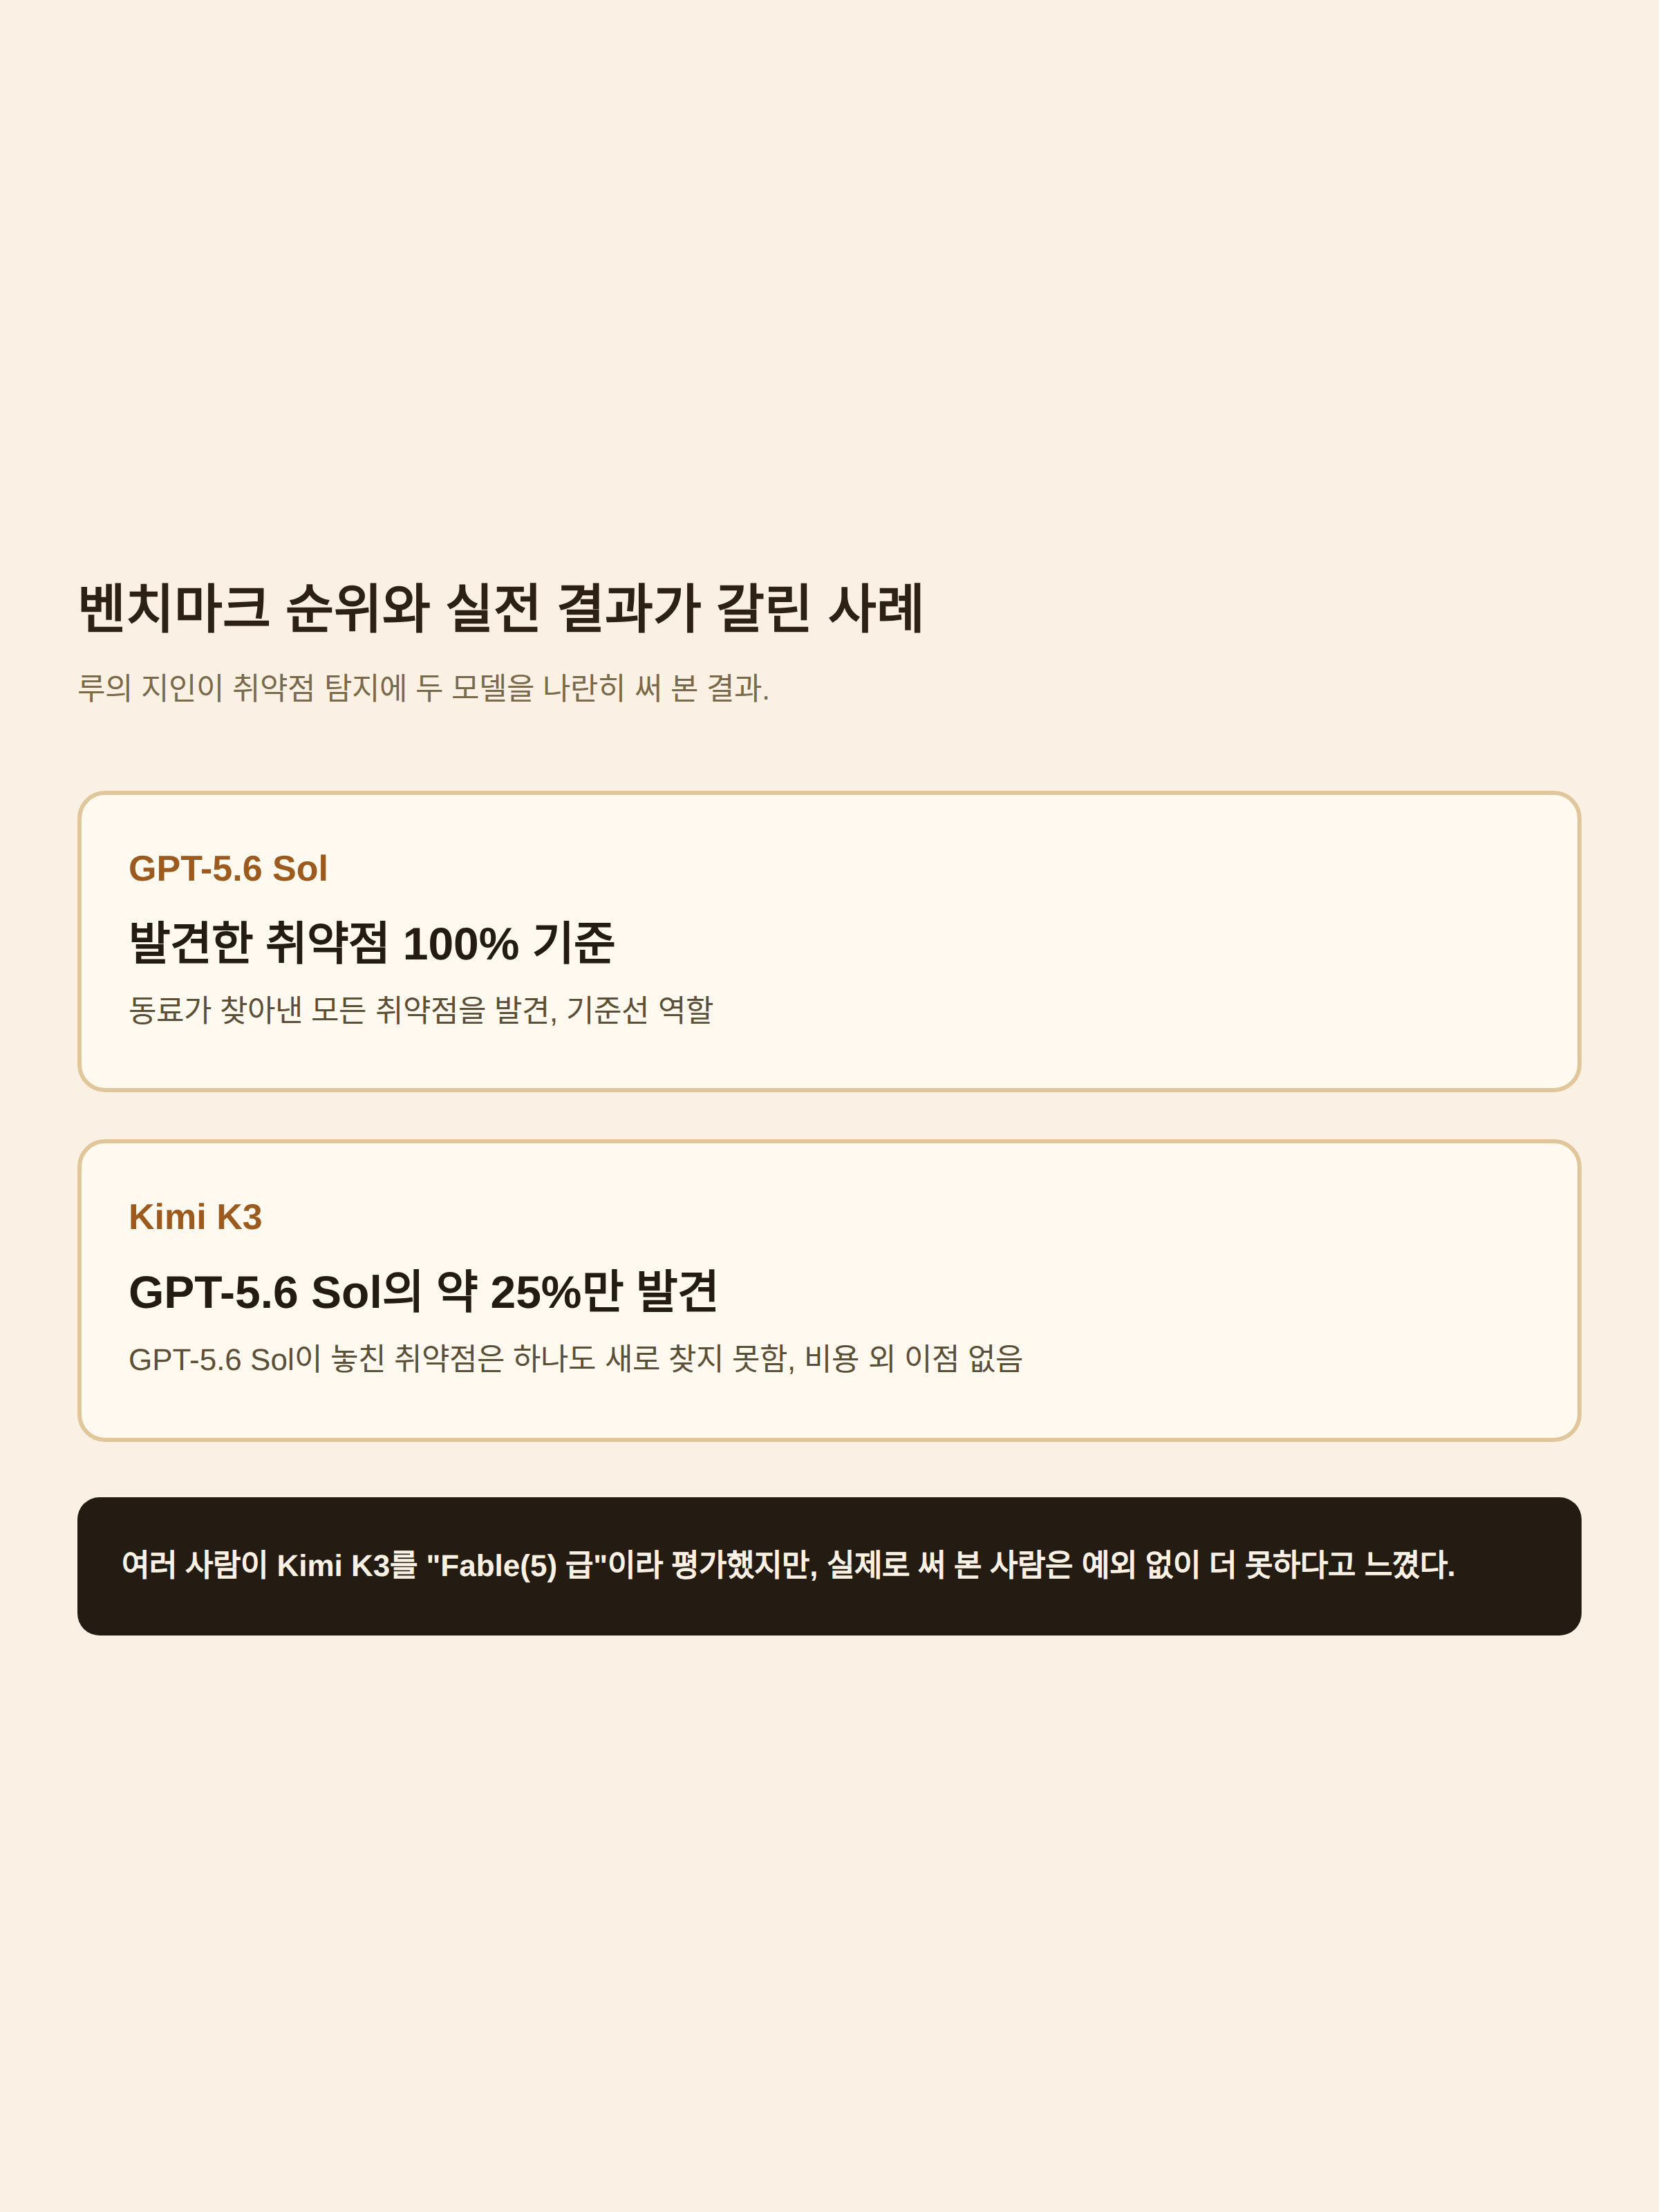
루는 이 문제가 AI 모델 자체를 평가하는 벤치마크에서 두 배로 심각하게 나타난다고 지적한다. 그는 여러 사람이 코딩 모델 Kimi K3를 두고 "Fable(5) 급"이라고 평가하는 걸 봤지만, 실제로 써본 사람들은 예외 없이 GPT-5.6 Sol이나 Fable보다 뚜렷하게 못하다고 느꼈다고 전한다. 지인이 진행한 실험에서도 비슷한 결과가 나왔다. 한 동료가 보안 취약점을 찾는 데 Kimi K3를 썼더니 GPT-5.6 Sol이 찾아낸 취약점의 약 4분의 1만 찾아냈고, GPT-5.6 Sol이 놓친 취약점은 하나도 새로 찾지 못했다. 비용이 싸다는 것 말고는 이점이 없었다는 뜻이다. 반대로 실제 보안 업무에서 값싼 모델로 성과를 내는 사람들은 벤치마크 점수는 낮지만 실전에서 더 잘 맞는 GLM-5.2 같은 모델을 쓴다고 덧붙였다.
그럼에도 이 실험이 남긴 값어치 있는 결론
루가 마이크로소프트 빙(Bing) 검색 인덱스에서 일할 때, 동료 한 명은 컴파일 시간과 컴파일된 코드의 실행 속도를 동시에 극한까지 끌어올리려고 인덱스 곳곳에 서로 다른 커스텀 컴파일러를 여러 개 직접 짜 넣었다. 이런 특화 코드는 파트너급에서 디스팅귀시드 엔지니어로 승진할 정도의 전문성과, 그런 좁은 문제에 시간을 쏟을 수 있는 드문 여건이 함께 있어야 나올 수 있었다. FRE의 전체 성능은 러스트 정규식 크레이트에 못 미치지만, 특정 활용 사례에서는 더 나은 결과를 냈다. 그 정도의 특화 코드를 만드는 비용이 이런 전문 엔지니어의 몸값과 비교해 몇 자릿수는 낮아졌다는 사실 자체가, 루가 이 실험에서 건진 가장 실용적인 결론이다. 동시에 그가 반복해서 확인한 또 다른 사실도 남는다. 벤치마크 수치를 볼 때는 전체 평균 하나만 보지 말고, 홀드아웃 검증을 거쳤는지, 그 검증이 실제로 중요한 항목을 담고 있는지, 그리고 감독 없는 루프에서 나온 값인지를 따로 확인해야 한다는 것이다.