
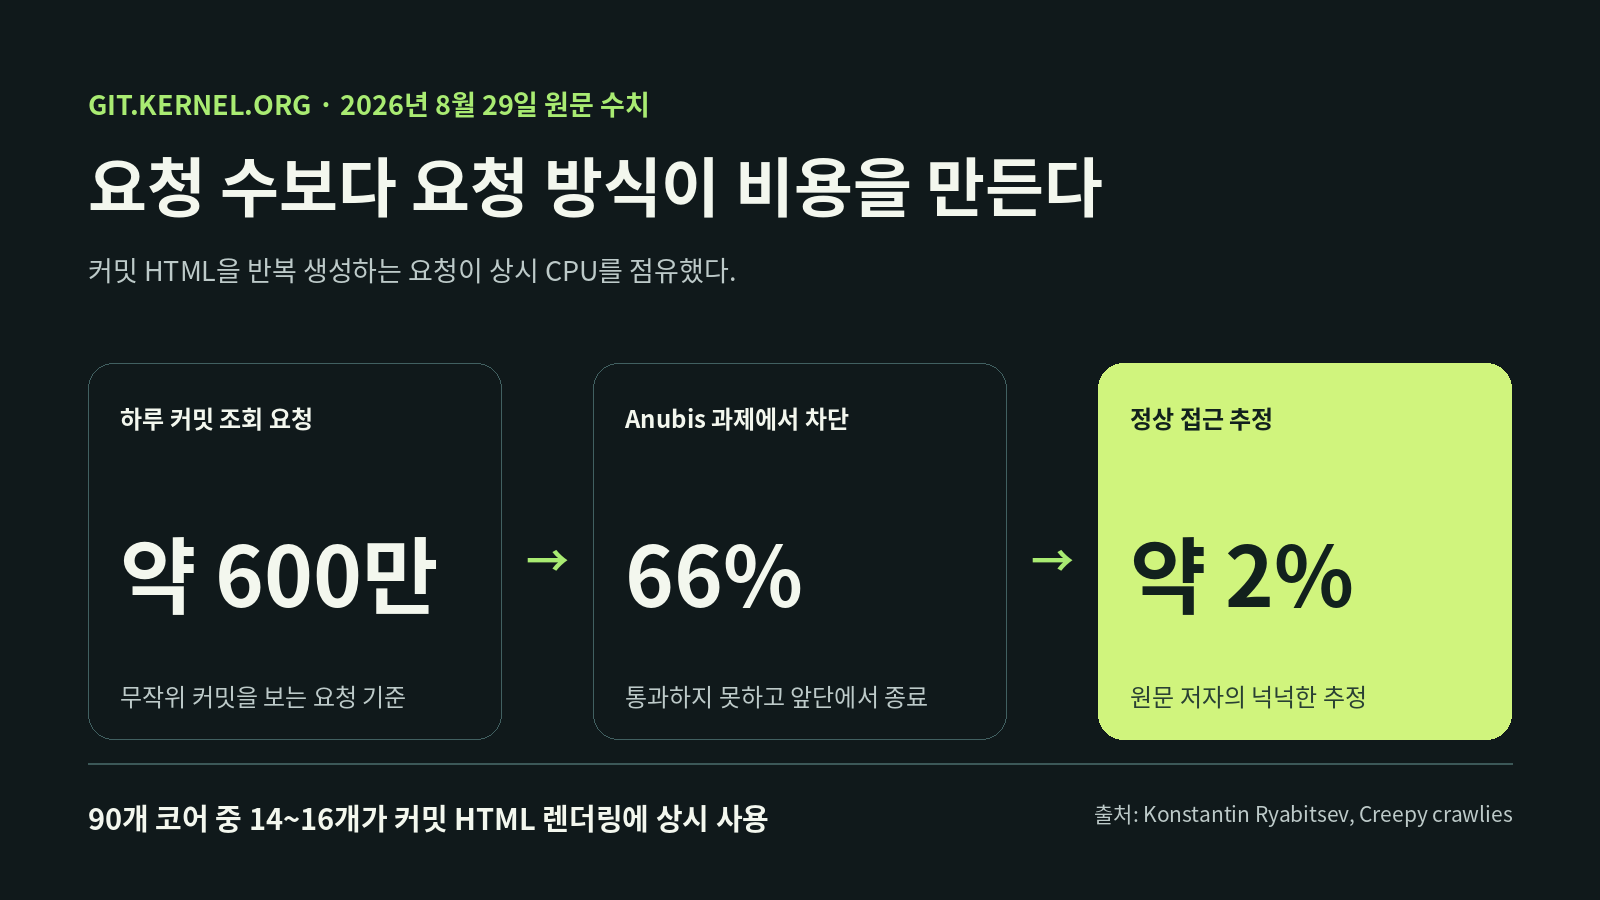
AI 크롤러 비용은 요청 수만 세어서는 보이지 않는다. Linux 커널 인프라를 운영하는 Konstantin Ryabitsev는 2026년 8월 29일, git.kernel.org에서 스크레이퍼가 커밋을 HTML로 하나씩 렌더링하게 만드는 데 드는 CPU 시간이 Git 복제를 포함한 모든 정상 접근보다 크다고 공개했다. 5개 지역 노드의 90개 코어 가운데 14~16개가 이 작업에 계속 쓰이고, 평균으로는 전체 처리 용량의 약 20%다.
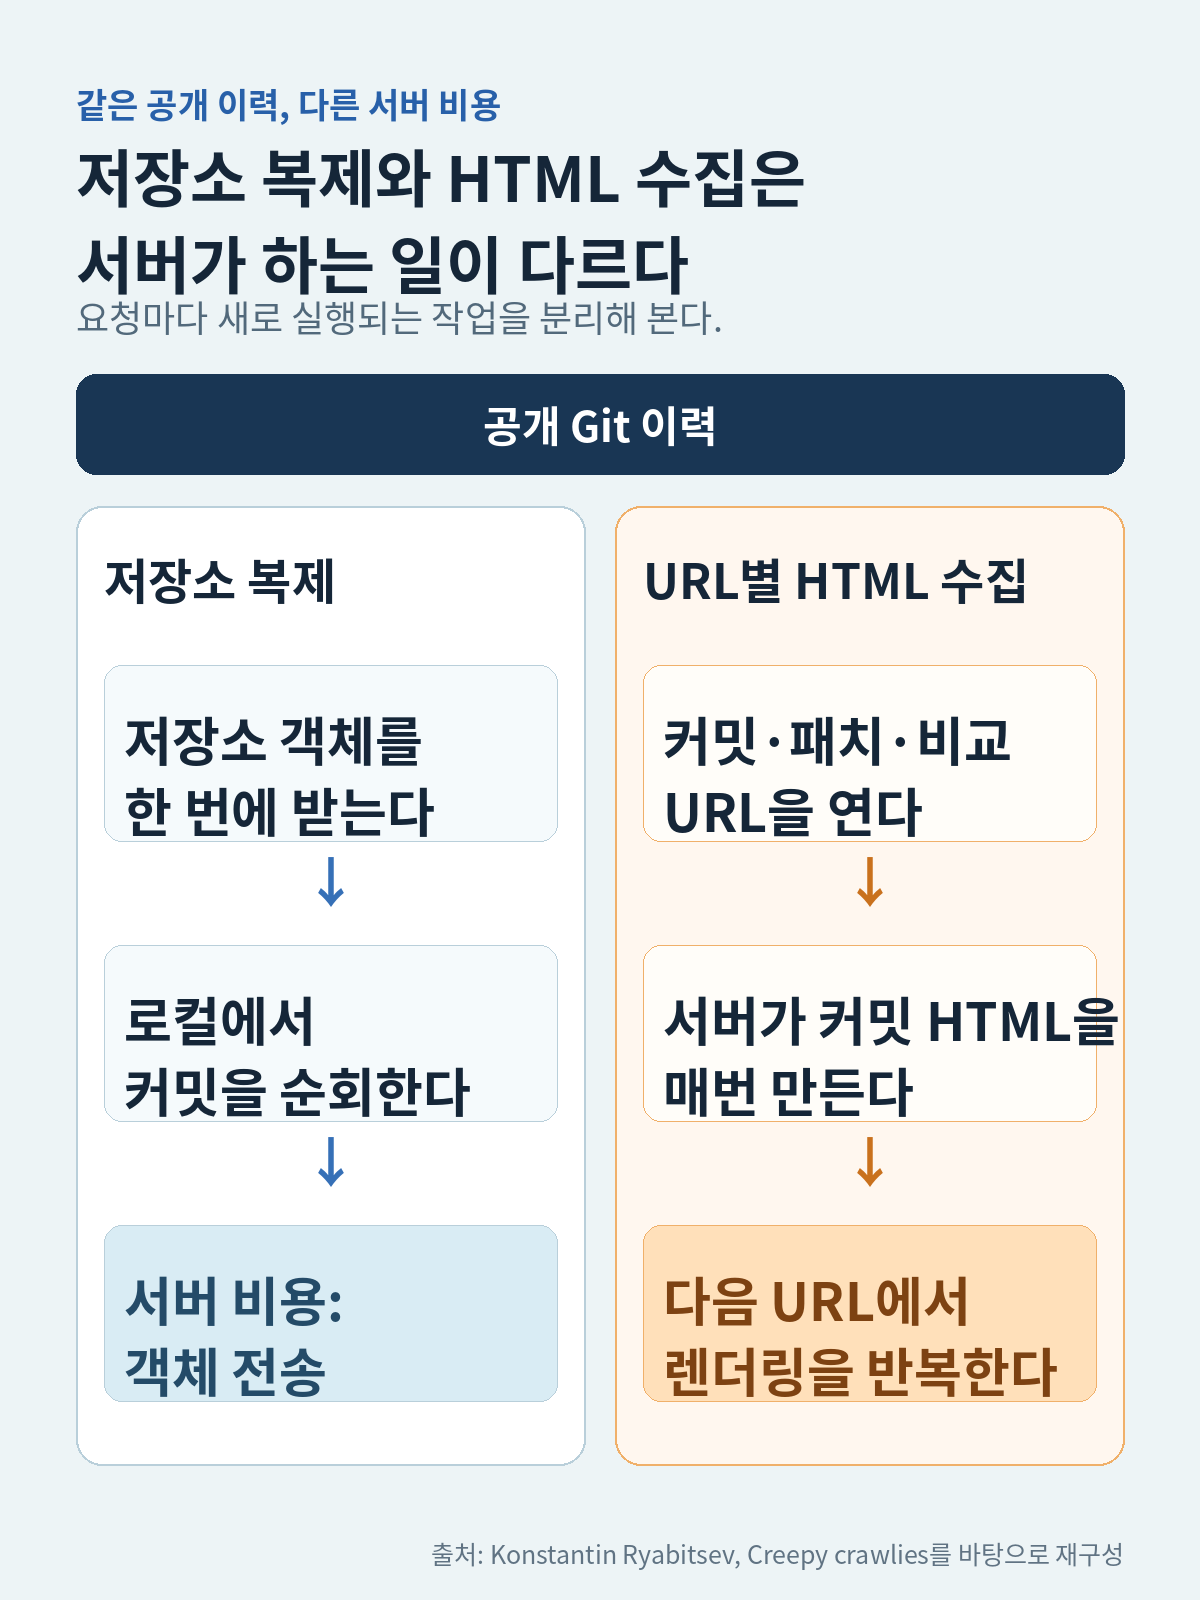
같은 커밋 이력을 가져가더라도 비용은 달라진다. Git 저장소는 복제해서 로컬에서 커밋을 순회할 수 있다. 반면 크롤러가 커밋 URL, 패치 URL, 비교 URL을 매번 열면 서버는 요청마다 동적 HTML을 만들고 응답해야 한다. 운영자가 통제해야 할 대상은 “AI 크롤러가 몇 번 왔는가”보다 어떤 URL 조합이 어떤 계산을 반복시키는가다.

왜 Git 복제가 가능한데 HTML 요청이 서버를 묶는가
linux.git에는 당시 약 148만 개의 커밋이 있었고, git.kernel.org에는 그 포크가 약 922개 있었다. 저장소 내부에서는 같은 객체를 공유하므로 포크 수가 곧 저장 비용으로 늘지는 않는다. 그러나 URL을 따라가며 HTML을 모으는 쪽에서는 같은 커밋이 포크마다 다른 페이지 경로가 된다. 저자는 단일 포크만으로도 커밋, 패치, 일반 텍스트 표시, 임의 두 커밋의 차이를 조합해 매우 넓은 유효 URL 공간을 만들 수 있다고 설명한다.
이 차이는 전송량 그래프만으로도 잡히지 않는다. Git 복제는 큰 데이터를 보내더라도 서버가 준비한 객체를 전달하는 작업에 가깝다. 커밋 페이지는 요청 경로를 해석하고, 해당 객체와 메타데이터를 읽고, HTML을 만들어 보낸다. 데이터는 같아도 앞의 경로는 로컬 순회로 끝날 수 있고, 뒤의 경로는 서버의 렌더러를 반복 호출한다. 요청 한 건의 바이트보다 요청이 비싼 계산을 몇 번 열었는지가 비용 예산의 단위가 된다.
IP 차단과 계산 과제는 왜 오래 가지 못했나
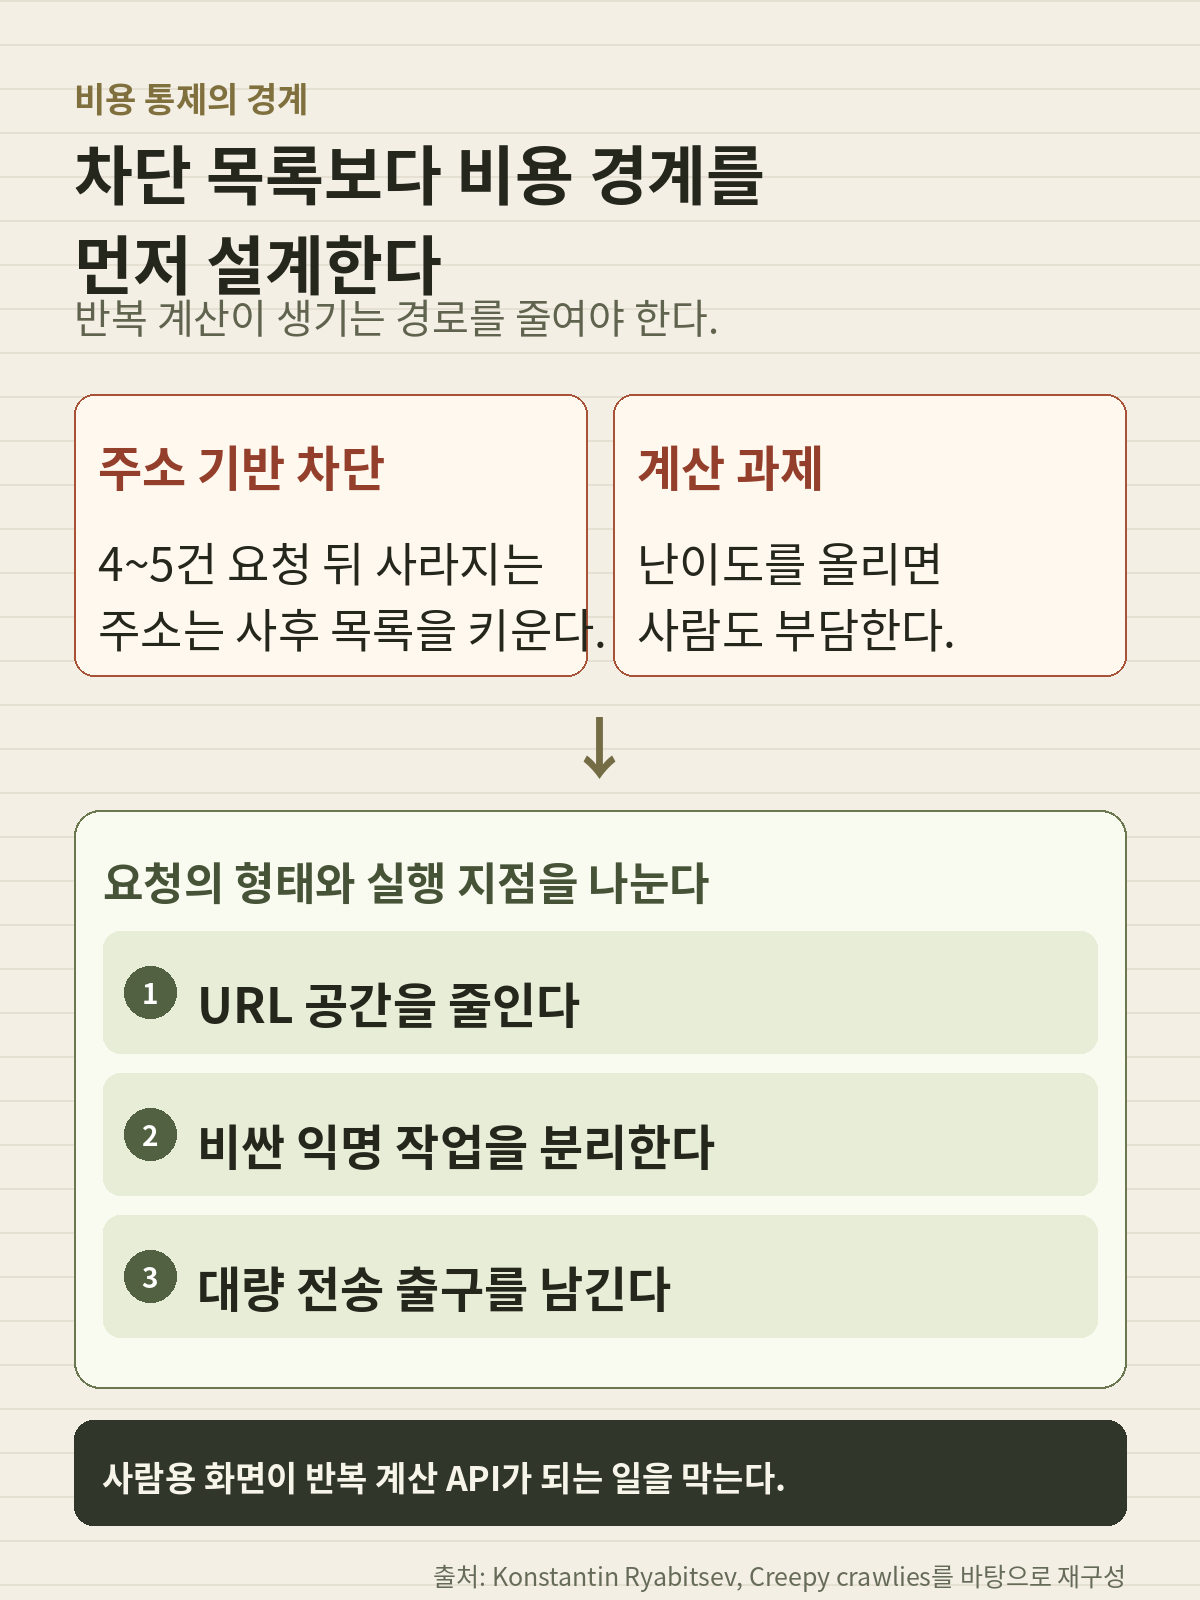
처음에는 사용자 에이전트와 IP 주소를 보고 차단할 수 있었다. 이후 크롤러는 일반 브라우저처럼 보이거나, 클라우드 대역과 주거·모바일 IP로 분산됐다. 원문에 따르면 후자의 주소는 4~5건만 요청한 뒤 다시 나타나지 않는 경우가 많았다. 주소를 사후에 목록에 넣어도 이미 요청은 끝났고 방화벽 규칙만 늘어난다.
운영진은 브라우저에 해시 계산을 요구하는 Anubis를 앞단에 놓았다. 난이도 4에서는 효과가 있었고, 난이도 5로 올리자 휴대전화 사용자는 몇 초를 기다리며 기기가 뜨거워지는 부담을 겪었다. 이후에도 통과하는 자동 요청이 늘었다. 현재 원문 수치에서는 하루 약 600만 건 가운데 66%가 과제에서 걸러지지만 33%는 계산을 풀고 본 사이트에 도달한다. 계산 과제는 무비용 자동화를 줄일 수 있어도, 공격자가 계산비를 감수하면 정상 사용자에게 먼저 마찰을 준다.
비용 통제는 요청의 출발점과 실행 지점을 나눠야 한다
이 사례에서 바로 적용할 수 있는 순서는 세 가지다. 먼저 URL 공간을 줄인다. 익명 사용자가 조합할 수 있는 렌더링 경로와 오래된 보기 기능을 점검해, 같은 원본을 여러 방식으로 다시 계산하는 경로부터 닫는다. 다음으로 비싼 작업은 익명 요청의 기본 경로에서 분리한다. 원문 운영진도 크롤링 가능한 기능을 끄고 비용이 큰 작업에 접근 관문을 두겠다고 밝혔다.
마지막으로 대량 이용자가 쓸 수 있는 값싼 출구를 남긴다. Git 복제처럼 전체 데이터를 가져갈 정식 경로가 있다면, 이를 제한하기보다 HTML 화면의 무차별 순회가 그 경로로 바뀌도록 설계할 수 있다. 이 구분은 공개 데이터를 감추기 위한 조치가 아니다. 서버가 사람용 화면을 매 요청마다 조립하는 비용과, 대량 처리를 위해 제공한 전송 경로를 분리하는 일이다.
대시보드에는 요청 수와 함께 렌더링 원인을 남긴다
그래서 웹 서비스의 크롤러 대시보드에는 총 요청 수 외에 두 축이 필요하다. 첫째는 경로별 계산 비용이다. 캐시 적중률, DB 조회, 템플릿 렌더링, 외부 API 호출처럼 요청 뒤에 실제로 발생한 작업을 구분해야 한다. 둘째는 URL 생성 규칙이다. 하나의 원본 객체가 포크, 날짜, 보기 형식, 비교 범위에 따라 몇 개의 접근 가능한 URL로 늘어나는지 확인하면, 트래픽 급증 뒤에 숨어 있던 증식 지점을 찾을 수 있다.
차단 성공률도 단독 지표가 아니다. Anubis를 통과한 요청이 어떤 경로를 열었는지, 그 경로가 정상 사용자의 작업과 얼마나 겹치는지를 같이 봐야 한다. 비용이 큰 익명 경로를 줄이고 대량 접근에는 복제·내보내기·공식 API처럼 예측 가능한 통로를 제공하면, 공개성은 유지하면서 사람용 화면이 계산 대행 API로 변하는 일을 막을 수 있다.
출처: Konstantin Ryabitsev, Creepy crawlies (2026-08-30 확인)