
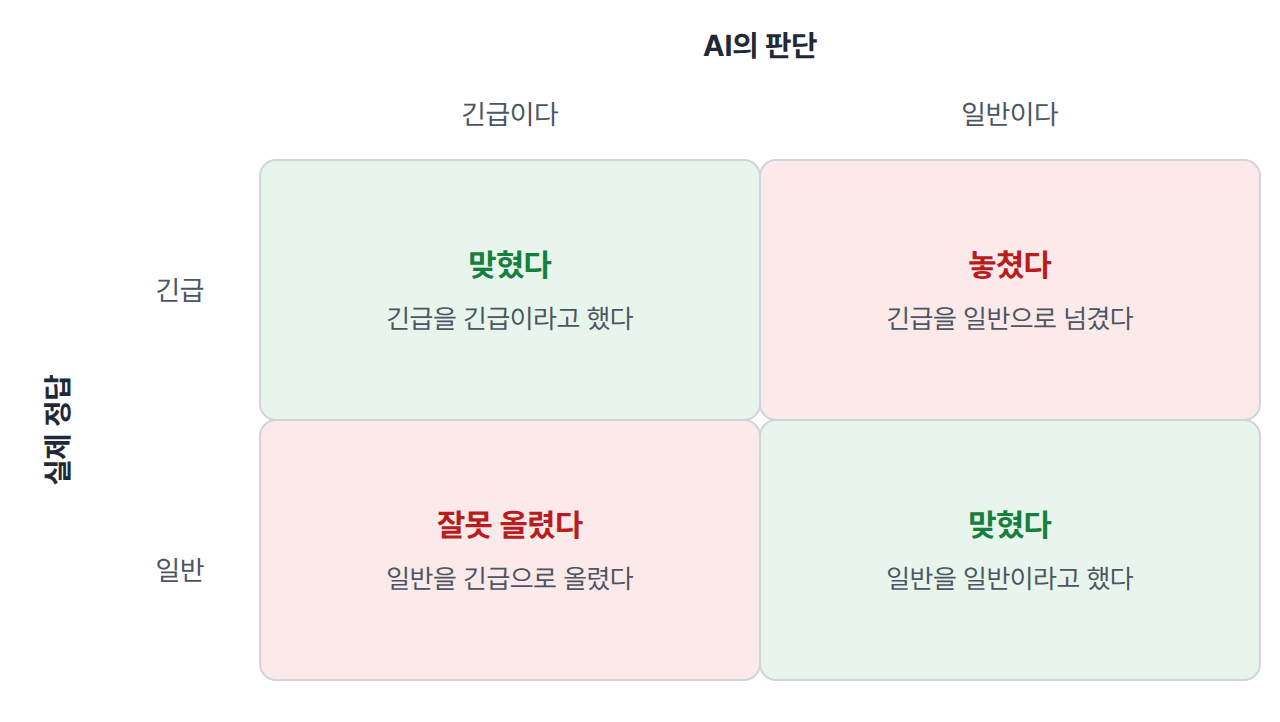
AI에게 고객 문의 분류를 맡겼다고 하자. 하루에 수십 건씩 들어오는 문의를 읽고 긴급이면 담당자에게 바로 올리고, 일반이면 대기열로 보낸다. 몇 주 돌려보니 그럭저럭 도는 것 같다. 그런데 어느 날 고객에게서 연락이 온다. 사흘 전에 급하다고 보냈는데 왜 답이 없냐고.
이 순간 드는 질문이 이 글의 주제다. 내가 맡긴 일을 AI가 실제로 얼마나 잘하고 있는지, 무엇을 근거로 믿을 수 있나. 전수 확인은 불가능하다. 확인할 수 있었으면 애초에 AI에게 맡기지 않았다. 그렇다고 검증을 포기하고 감으로 믿을 필요도 없다. 위 표의 네 칸에 결과를 나눠 넣으면, AI가 어디서 틀리는지 확인할 수 있다.
이 방법이 작동하는 조건. 같은 판단이 수십 건 이상 반복되고, 실수의 비용이 방향에 따라 달라야 한다. 계약서 검토처럼 건수가 적은 일에는 표를 채울 표본이 안 나온다. 틀려도 타격이 없는 일은 이렇게까지 볼 필요가 없는데, 이 경우는 글 끝에서 다룬다.
1단계
샘플을 뽑아 직접 채점한다
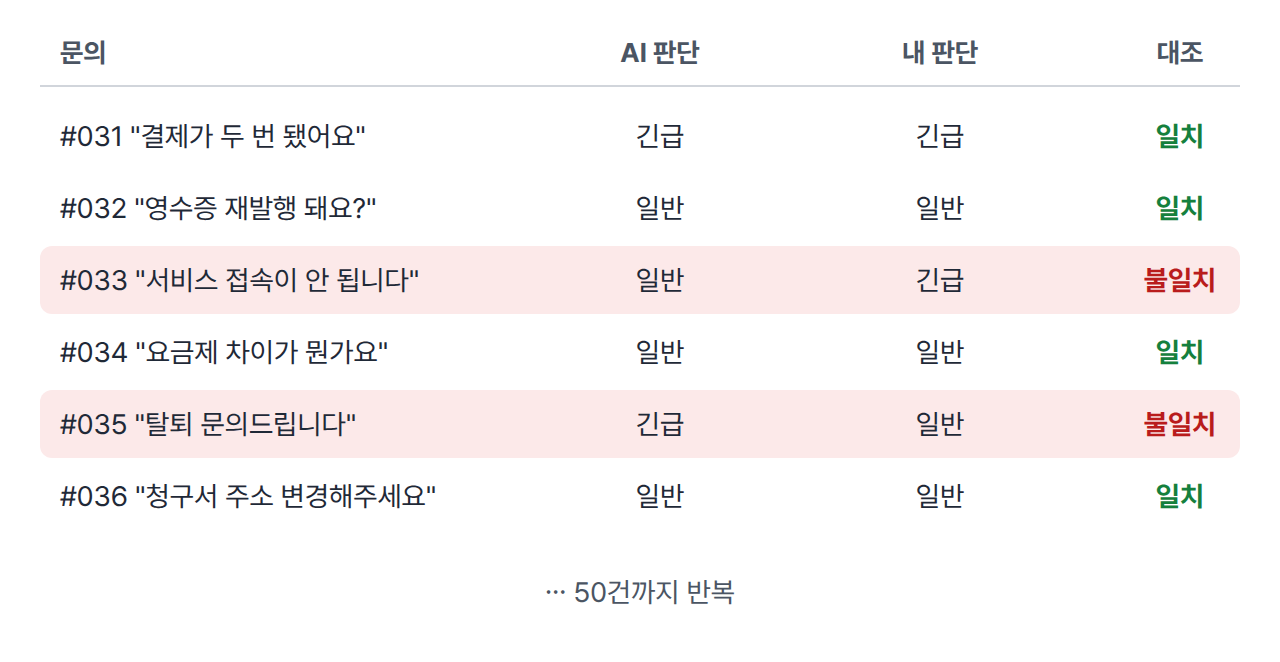
최근 처리된 문의 중 50건을 무작위로 뽑는다. 그리고 AI의 판단을 가린 채 내가 먼저 판단한다. 이 순서가 중요하다. AI의 답을 먼저 보면 판단이 그쪽으로 끌려가서, 채점이 아니라 동의가 되어버리기 때문이다.
내 판단을 다 적은 뒤에 AI의 판단을 옆에 놓고 대조한다. 50건이면 한 시간 안에 끝나는 일이고, 이 한 시간이 "그럭저럭 도는 것 같다"를 숫자로 바꿔준다.
2단계
4칸짜리 표에 채운다
대조가 끝나면 50건은 네 종류로 나뉜다. 긴급을 긴급이라고 한 것, 긴급을 일반으로 넘긴 것, 일반을 긴급으로 올린 것, 일반을 일반이라고 한 것. 이걸 처음의 표에 숫자로 채운다.
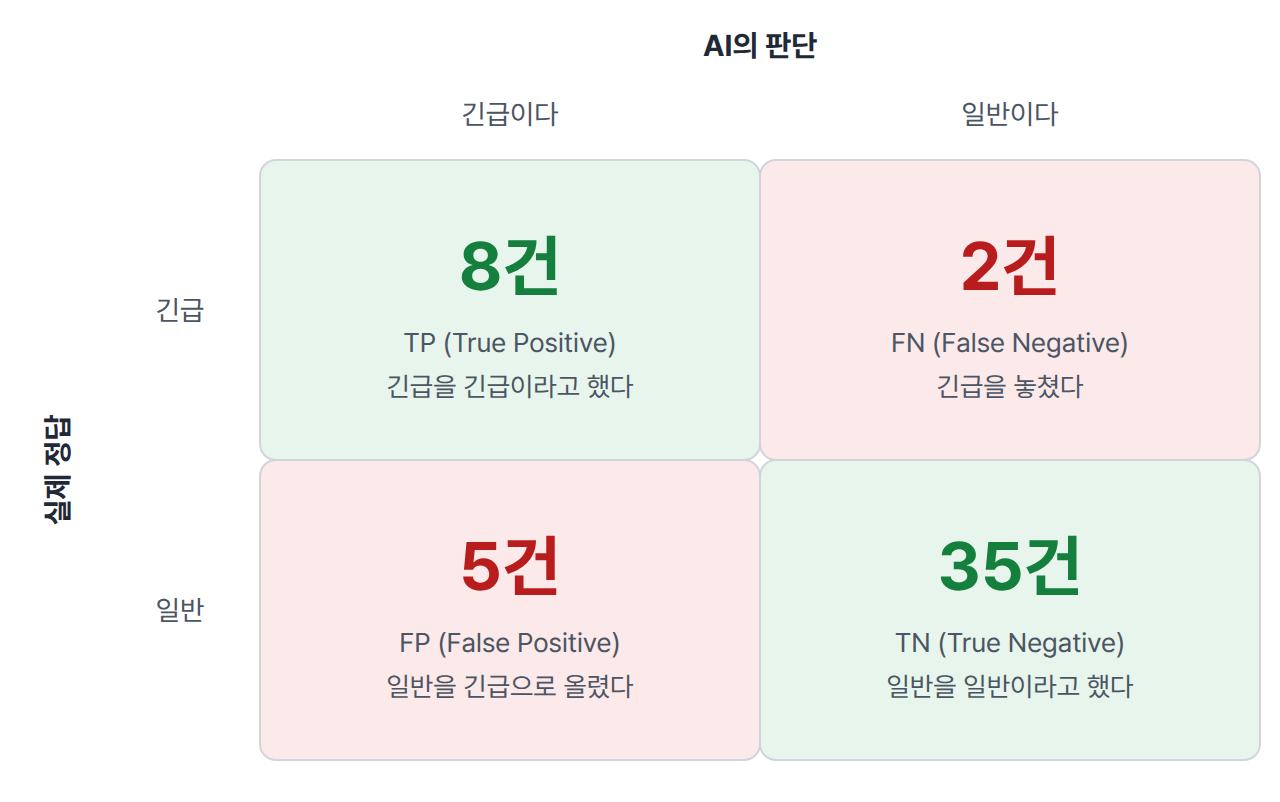
용어가 매번 헷갈린다면 뒤에서부터 읽으면 된다. Positive와 Negative는 AI가 뭐라고 판단했는지다. 여기서는 긴급이 Positive, 일반이 Negative다. True와 False는 그 판단이 맞았는지에 대한 채점이다. 그러니까 False Negative는 "Negative라고 판단했는데 그 판단이 False였다", 즉 일반이라고 넘겼는데 사실은 긴급이었다는 뜻이 된다. 통계에서 말하는 2종 오류다. 실제는 긴급인데 일반이라고 판단한 경우다. 반대로 False Positive는 1종 오류다. 실제는 일반인데 긴급이라고 판단했다.
표를 채우는 순간 "그럭저럭 도는 것 같다"가 구체적인 사실 네 개로 바뀐다. 긴급 10건 중 8건을 잡았고 2건을 놓쳤다. 긴급이라고 올린 13건 중 5건은 일반이었다. 이제 마지막 질문 하나가 남는다.
3단계
어떤 칸의 실수가 더 비싼지 정한다
빨간 칸은 두 개다. 그리고 이 둘은 같은 실수가 아니다. 긴급을 놓치면(FN, 2종 오류) 고객이 사흘을 기다리다 떠난다. 일반을 긴급으로 올리면(FP, 1종 오류) 담당자가 안 급한 문의를 먼저 열어보느라 시간을 쓴다. 문의 분류에서는 앞쪽이 명백히 비싸다. 고객 한 명을 잃는 비용과 담당자의 몇 분은 비교가 안 되기 때문이다.
어떤 실수가 더 비싼지 정해지면, 표에서 봐야 할 숫자가 정해진다. 그 숫자들을 표의 칸 이름으로 직접 계산해보자. 먼저 놓침 쪽이다.
재현율(Recall) = TP ÷ (TP + FN) = 8 ÷ (8 + 2) = 80%
분모의 TP + FN이 무엇을 더한 것인지 보자. TP는 긴급을 긴급이라고 해서 잡은 건이고, FN은 긴급을 일반으로 넘겨서 놓친 건이다. 잡았든 놓쳤든, 실제로 긴급이었던 건은 반드시 이 두 칸 중 하나에 들어간다. 그래서 TP + FN을 더하면 실제 긴급 전체 10건이 된다. 그중 잡아낸 TP의 비율이니, 재현율은 "실제 긴급 중 몇 건을 건졌나"라는 질문의 답이 된다. 놓침(FN)이 늘수록 분모만 커져서 값이 떨어진다. 놓침을 재는 지표인 이유다.
정밀도(Precision) = TP ÷ (TP + FP) = 8 ÷ (8 + 5) = 62%
이번 분모는 TP + FP다. TP는 긴급이라고 해서 맞은 건, FP는 긴급이라고 해서 틀린 건이다. 맞았든 틀렸든, AI가 긴급 도장을 찍은 건은 반드시 이 두 칸 중 하나에 들어간다. 그래서 TP + FP를 더하면 AI가 긴급이라고 주장한 전체 13건이 된다. 그중 진짜 긴급이었던 TP의 비율이니, 정밀도는 "AI의 주장 중 몇 건이 진짜였나"의 답이다. 오탐(FP)이 늘수록 값이 떨어진다. 오탐을 재는 지표인 이유다.
정리하면 두 식은 분자가 TP로 같고, 분모에 어느 빨간 칸을 더하느냐만 다르다. 표 위에 그리면 이렇게 된다.
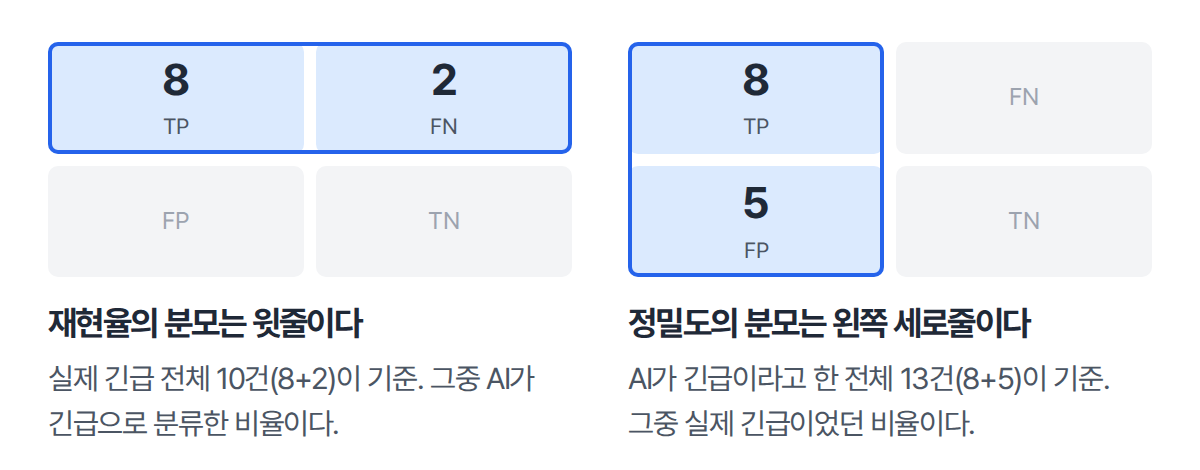
두 지표가 헷갈릴 때는 분모만 보면 된다. 실제 기준이면 재현율, 주장 기준이면 정밀도다. 문의 분류에서 비싼 실수는 놓침이니, 이 시스템의 성적표는 재현율 80%다. 실제 긴급 다섯 건 중 하나는 대기열로 새고 있다는 뜻이고, 사흘을 기다린 그 고객이 바로 이 2건 안에 있었다. 정밀도 62%는 상대적으로 감수할 수 있는 숫자다. 오탐의 비용은 담당자의 시간뿐이니까.
일이 달라지면 비싼 칸도 달라진다. 두 가지 전형적인 경우를 보자.
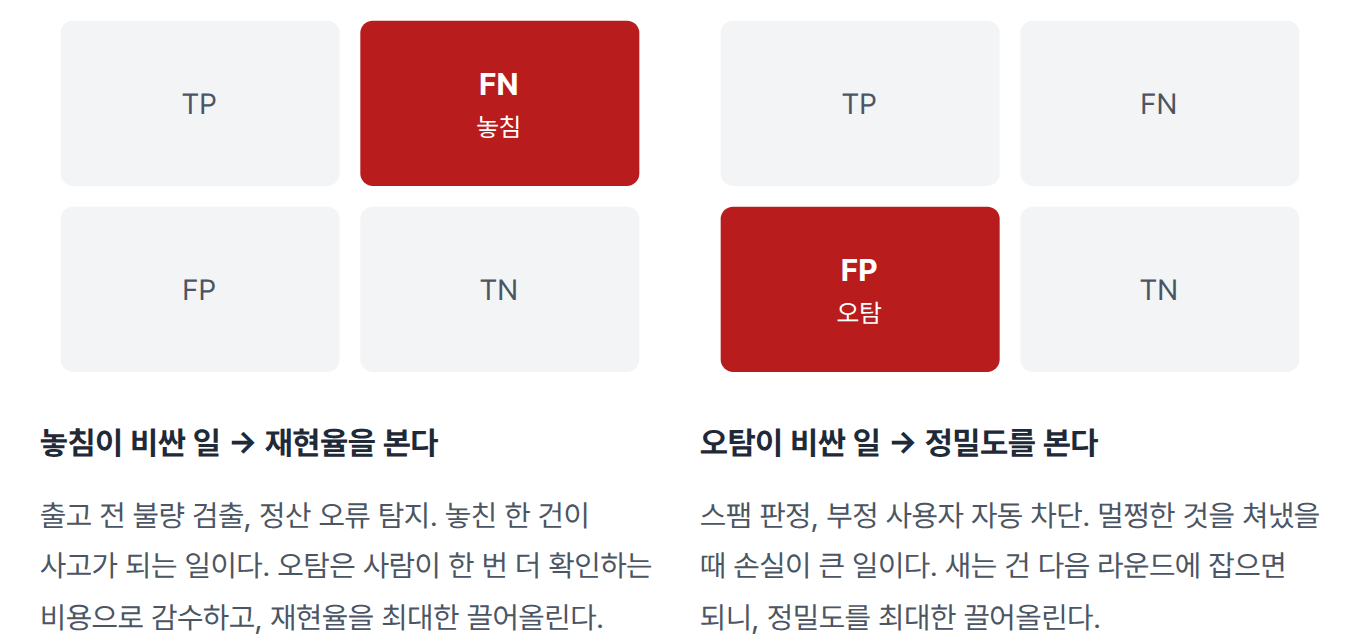
정리하면 이렇다. 표 4칸을 채우는 것까지는 기계적인 작업이지만, 어떤 칸이 비싼지 정하는 것은 내 일에 대한 판단이다. 그리고 이 판단이 서야 개선 방향도 선다. 재현율이 문제면 애매한 건은 일단 긴급으로 올리도록 프롬프트를 바꾸고, 정밀도가 문제면 확신이 없을 때 사람에게 넘기게 한다. 어느 쪽이든 FP와 FN 사이의 교환이고, 어느 쪽으로 밀지는 비용이 정해준다.
정확도라는 숫자를 조심해야 하는 이유
그런데 왜 처음부터 정확도(Accuracy)를 안 봤을까.
정확도(Accuracy) = (TP + TN) ÷ 전체 = (8 + 35) ÷ 50 = 86%
분자의 TP + TN은 초록 칸 두 개, 즉 방향을 가리지 않고 판단이 맞은 모든 건이다. 그걸 전체 50건으로 나누니 "전체 중 얼마나 맞혔나"의 답이 된다. 하나로 요약되고 직관적이다. 문제는 이 요약이 네 칸을 뭉개버린다는 데 있다.
극단적인 예를 들면 바로 보인다. 긴급 문의가 전체의 5%뿐이라면, 모든 문의를 일반이라고 찍는 시스템도 정확도 95%가 나온다. 긴급을 단 한 건도 못 잡는데도 그렇다. 이때 재현율은 0%다. 정확도는 높은데 재현율이 바닥이라면, 그 시스템은 정답을 맞히는 게 아니라 다수 쪽에 베팅하고 있을 뿐이다.
누군가 "정확도 95%"라고 말하면 되물을 것은 하나다. 놓침과 오탐이 각각 몇 건이냐. 그 대답이 표 4칸이고, 대답을 못 하면 그 95%는 검증된 숫자가 아니다.
그래도 숫자 하나로 요약해야 한다면, F1
정밀도와 재현율 두 개를 계속 들고 다니기 번거로울 때가 있다. 프롬프트 몇 개를 비교하거나 개선 전후를 한 줄로 기록할 때다. 이럴 때 쓰라고 만든 요약 숫자가 F1이고, 정의는 정밀도와 재현율의 조화평균이다.
F1 = 2 × (정밀도 × 재현율) ÷ (정밀도 + 재현율) = 2 × (62% × 80%) ÷ (62% + 80%) ≈ 70%
둘을 더해 2로 나누는 산술평균을 안 쓰고 굳이 조화평균을 쓰는 이유가 있다. 산술평균은 한쪽이 무너져도 다른 쪽이 높으면 가려준다. 아까의 "전부 일반 찍기"를 뒤집어서, 모든 문의를 긴급이라고 찍는 시스템을 생각해보자. 놓침이 없으니 재현율은 100%다. 하지만 긴급이라고 한 50건 중 진짜 긴급은 10건뿐이라 정밀도는 20%다. 산술평균을 내면 60%로 그럴듯해 보이는데, F1은 33%로 곤두박질친다.
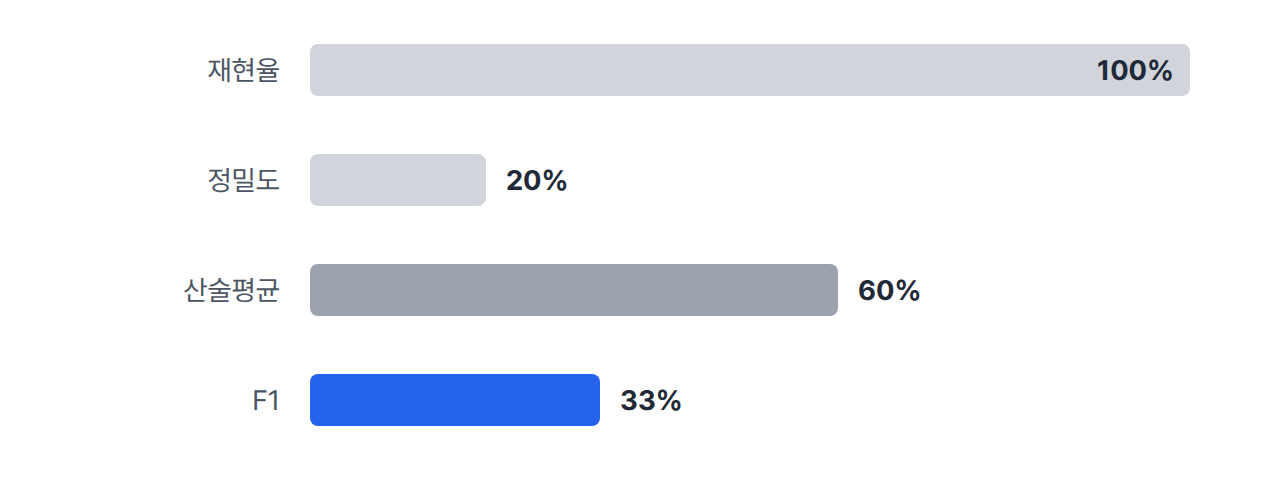
조화평균이 작은 값 쪽으로 끌려가는 평균이기 때문이다. 두 값이 비슷하면 산술평균과 거의 같은 값이 나오지만, 두 값이 벌어질수록 낮은 쪽에 가까워진다. 그래서 F1이 높으려면 정밀도와 재현율이 둘 다 높아야 한다. 한쪽을 포기해서 번 점수는 인정하지 않겠다는 설계다.
다만 F1은 두 오류를 똑같이 중요하게 취급한다는 점을 기억해야 한다. 어떤 실수가 비싼지 이미 정했다면 그에 맞는 지표(재현율 또는 정밀도)가 먼저고, F1은 비교와 기록을 위한 요약으로 쓰는 게 맞다.
모든 일을 이렇게까지 볼 필요는 없다
반대로 두 실수의 비용이 둘 다 낮은 일도 있다. 리뷰 천 건을 긍정과 부정으로 나눠 여론의 흐름을 보는 작업이 그렇다. 몇 건이 잘못 분류돼도 전체 통계는 거의 흔들리지 않고, 틀린 한 건이 사고로 이어지지도 않는다. 이런 일은 샘플 몇십 건으로 정확도만 대충 확인하고 넘어가도 충분하다.
그러니 이 방법은 검증의 강도를 정해주는 도구이기도 하다. 비싼 실수가 있는 일에는 4칸을 다 채우고, 없는 일에는 힘을 빼면 된다.
표가 실제로 알려주는 것
4칸 표의 산출물은 재현율 80% 같은 숫자가 아니다. 진짜 산출물은 그 숫자를 읽기 위해 답해야 했던 질문, 즉 내 일에서 어떤 실수가 비싼가에 대한 정의다. 이 정의는 AI를 바꿔도, 프롬프트를 갈아엎어도 그대로 남아서 다음 검증의 기준이 된다.
AI에게 일을 맡기는 것과 그 결과를 믿는 것은 다른 문제다. 둘 사이를 잇는 데 필요한 건 대단한 평가 인프라가 아니라, 샘플 50건과 한 시간, 그리고 표 4칸이다.