
100만 토큰은 긴 문서 작업에서 무엇을 바꾸나
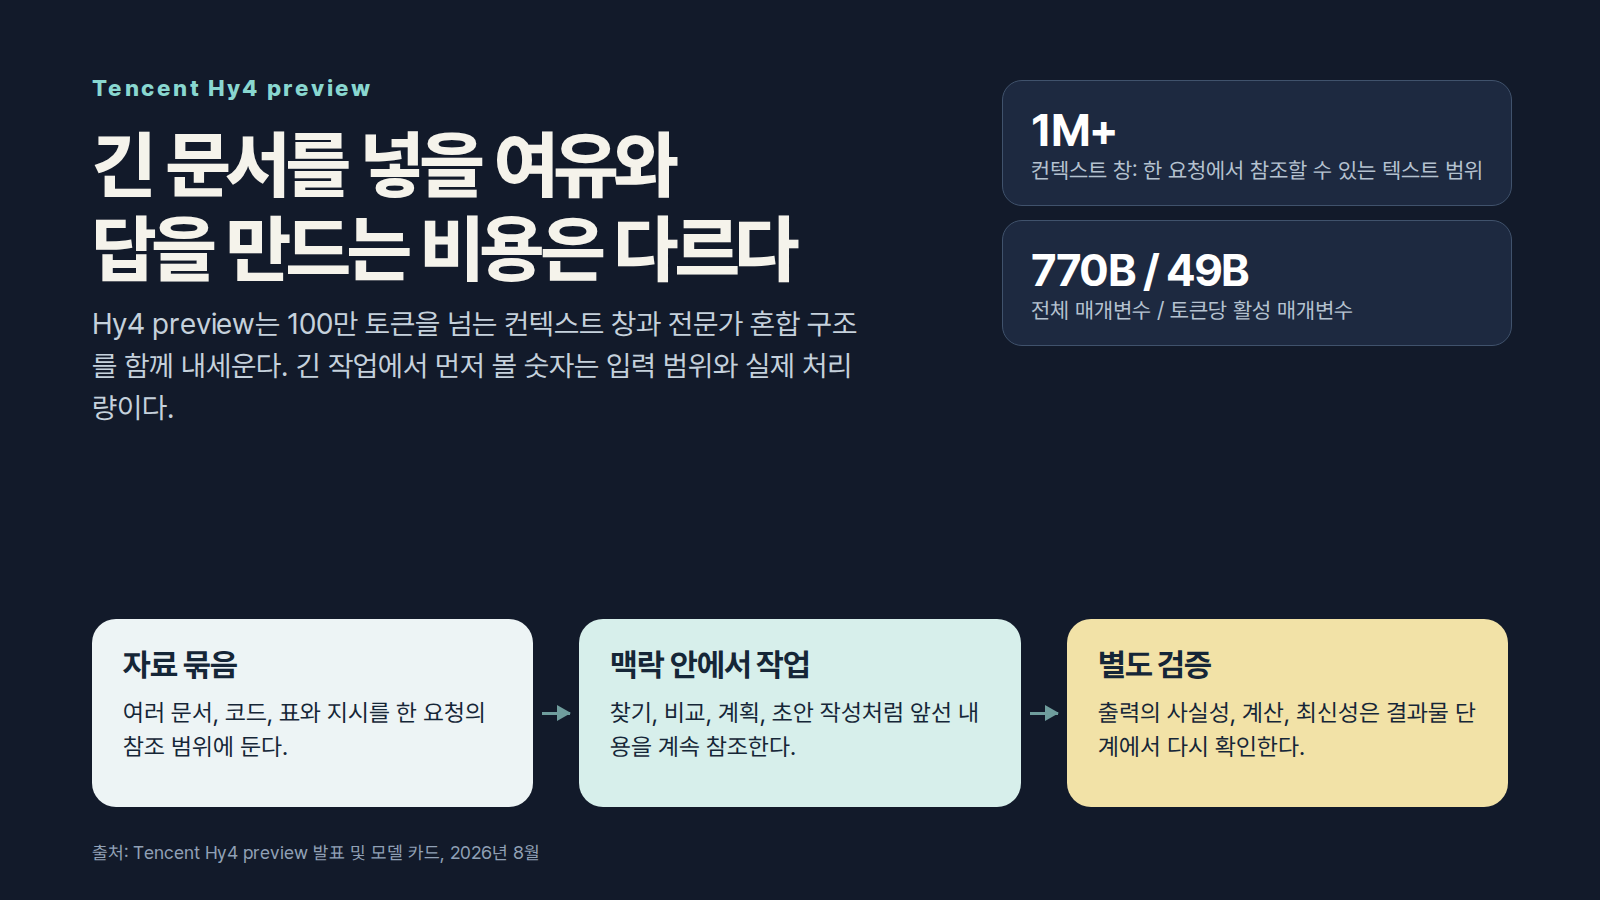
Tencent는 2026년 8월 28일 Hy4 preview를 공개하고 모델 가중치를 오픈소스로 배포했다. 전체 매개변수는 7,700억 개, 토큰마다 활성화되는 매개변수는 490억 개이며, 컨텍스트 창은 100만 토큰을 넘는다. 긴 회의록, 정책 문서, 코드, 표를 하나의 작업 안에서 함께 참조할 수 있는 선택지가 늘어난 셈이다.
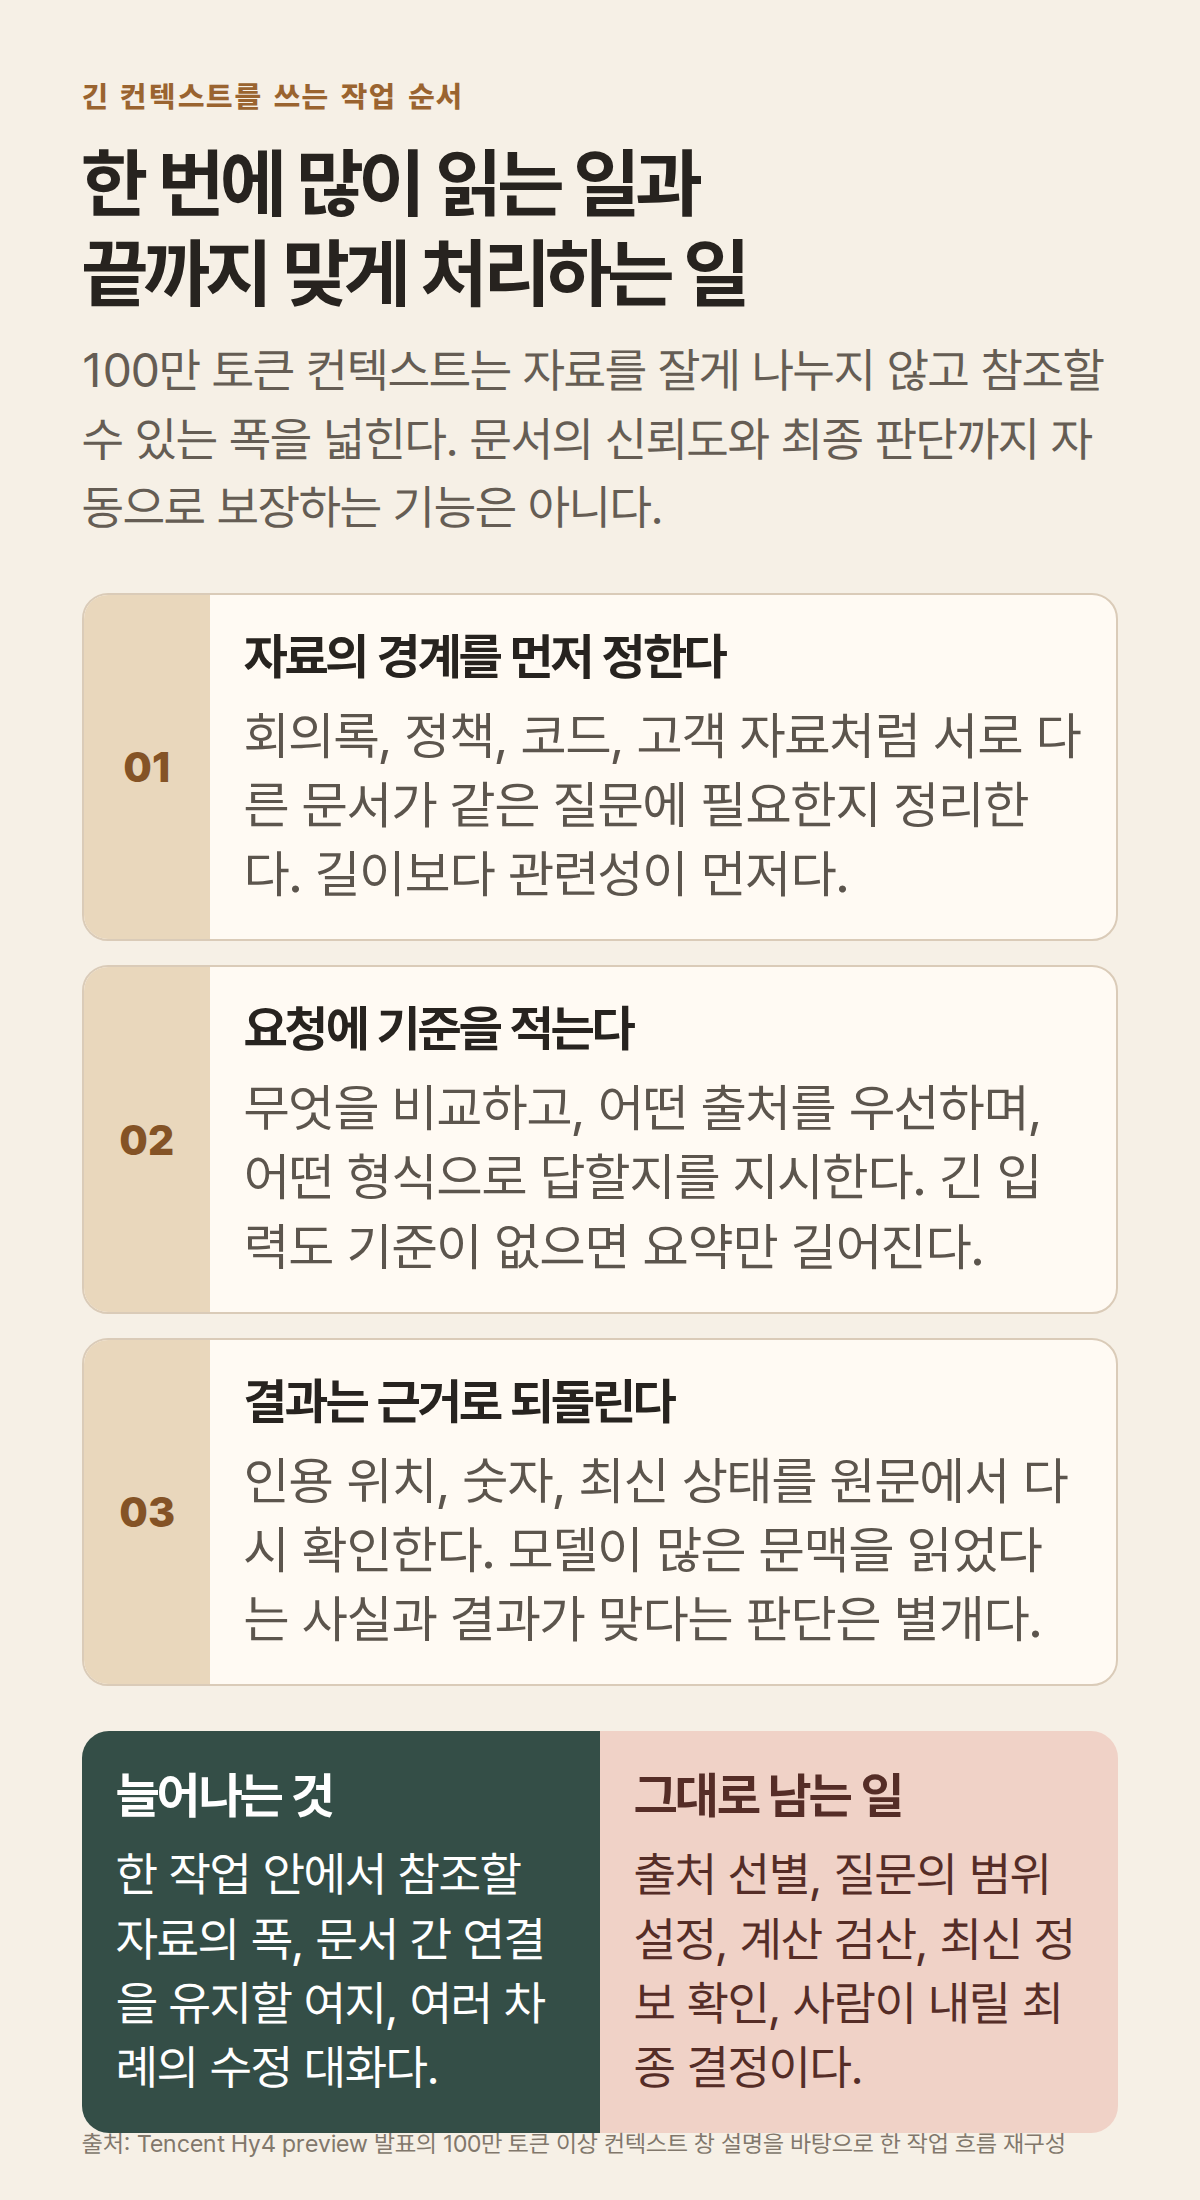
여기서 컨텍스트 창은 모델이 한 요청에서 읽고 참조할 수 있는 텍스트의 범위다. 문서 여러 개를 잘게 쪼개어 요약한 뒤 다시 연결하는 과정을 줄일 수 있지만, 100만 토큰이 곧바로 정확한 결론을 뜻하지는 않는다. 자료를 고르는 기준, 질문의 범위, 인용과 숫자 검산은 결과 단계에서 여전히 분리해 다뤄야 한다.

문서를 많이 넣는다고 답의 품질까지 따라오지는 않는다
긴 컨텍스트가 특히 유용한 장면은 앞에서 읽은 내용을 잊지 않고 다음 단계로 넘어가야 할 때다. 예를 들어 여러 회의록에서 같은 결정의 배경을 찾고, 관련 정책과 수치를 대조한 뒤, 실행 항목을 문서로 정리하는 작업이 그렇다. 코드베이스의 여러 파일과 이슈 기록을 함께 읽고 수정 계획을 세우는 일도 같은 범주에 들어간다.
Hy4 preview 모델 카드는 소프트웨어 엔지니어링, 사무·분석, 게임 개발, 과학 연구를 주요 작업 영역으로 든다. 사무·분석 항목에서는 여러 파일에 흩어진 맥락을 문서, 스프레드시트, 발표 자료로 옮기는 흐름을 설명한다. 이 설명이 가리키는 실무 변화는 파일 하나를 잘 요약하는 모델보다, 자료 묶음과 지시를 오래 유지하는 모델의 활용도가 커진다는 점이다.
공식 성능표는 어떤 종류의 작업을 겨냥했나
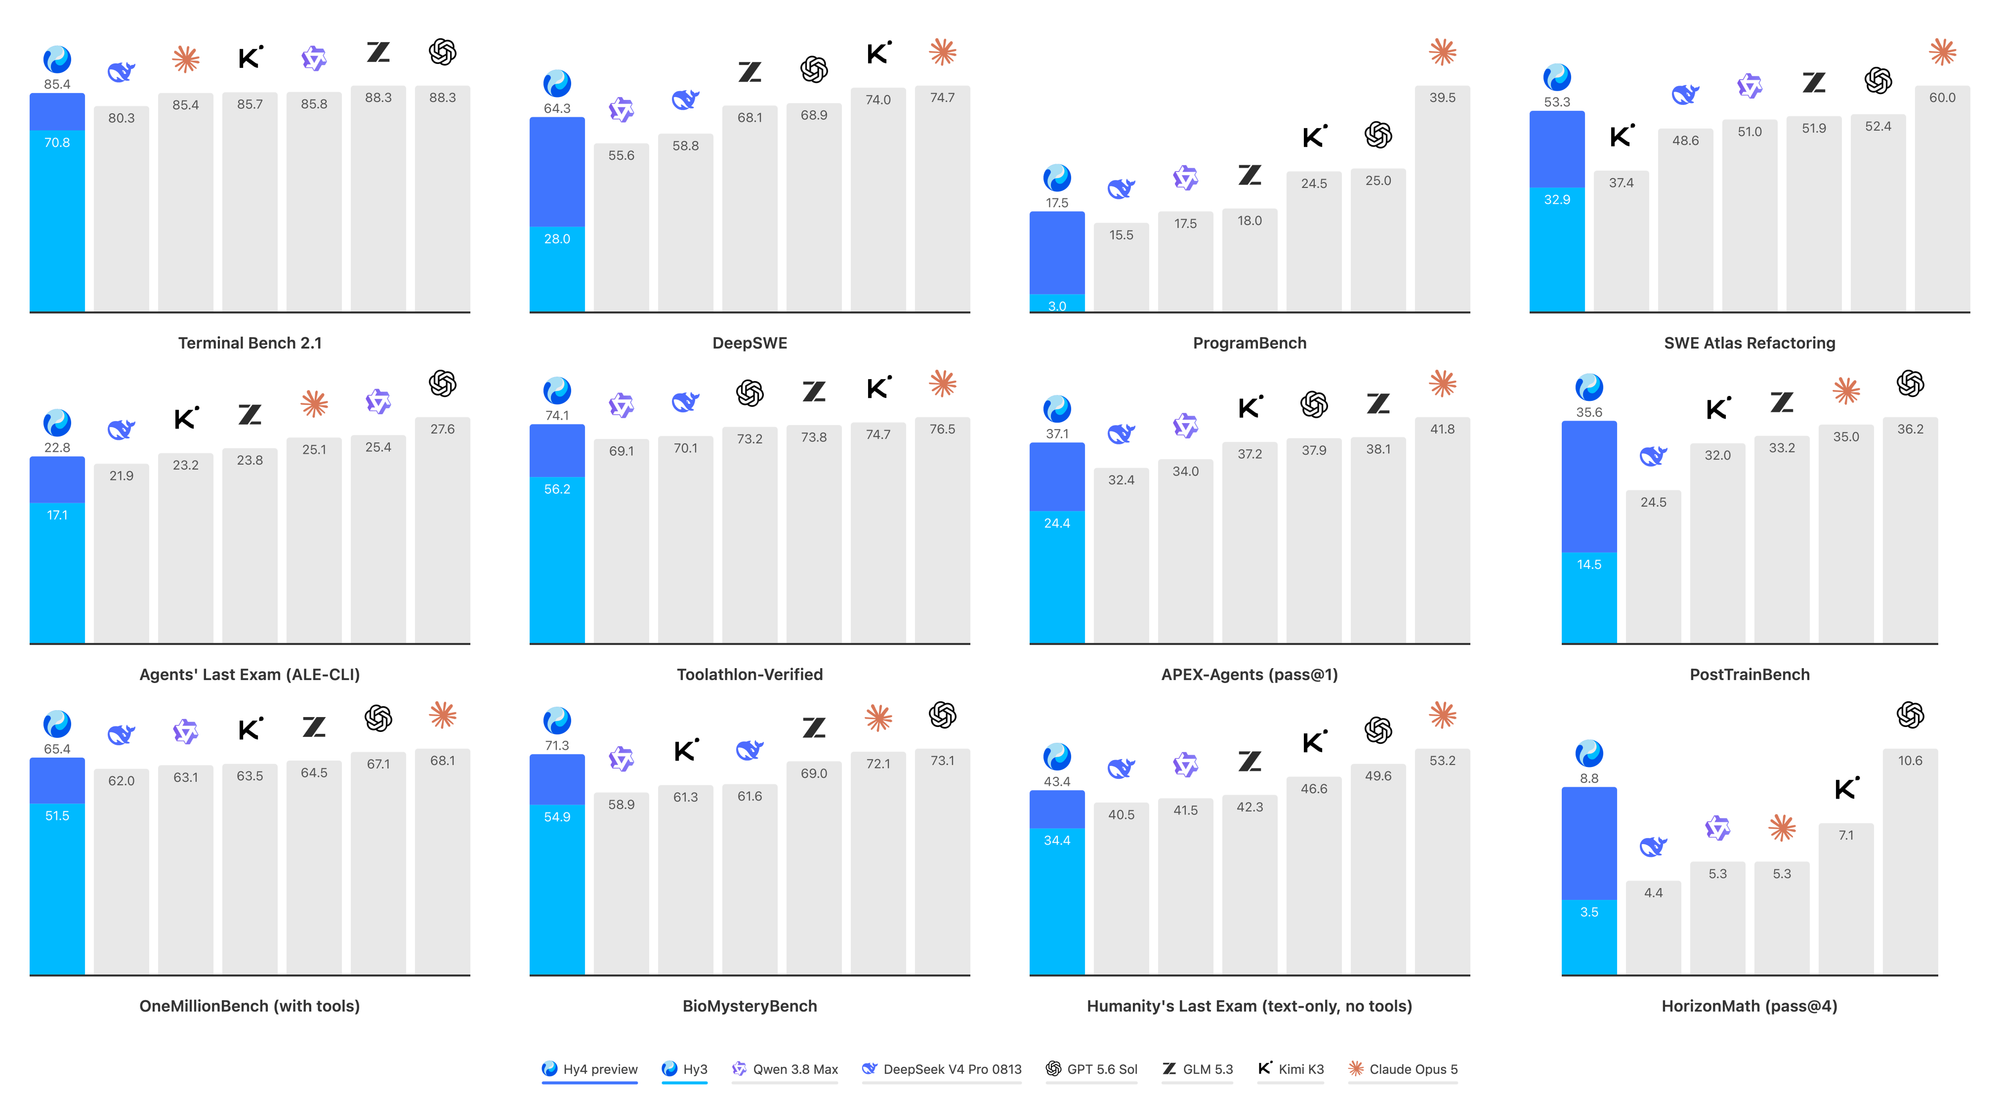
Tencent가 공개한 성능표는 Terminal Bench 2.1, DeepSWE, ProgramBench, SWE Atlas Refactoring, OneMillionBench 등 코딩과 에이전트형 작업, 장문 추론 평가를 나란히 둔다. Hy4 preview가 모든 항목에서 가장 높은 막대를 보이는 표는 아니다. 대신 긴 개발 과업과 도구 사용, 여러 단계의 문제 풀이를 한 제품군 안에서 겨냥하고 있음을 보여 준다.
Tencent는 별도로 내부 전문가 163명이 203개 엔지니어링 과제의 결과를 가린 평가에서 Hy4 preview의 평균 점수가 4점 만점에 2.99점이었다고 밝혔다. 같은 평가에서 GLM 5.3은 2.92점, Kimi K3는 2.94점이었다. 이 수치는 Tencent가 설계한 과제와 평가 절차에서 나온 결과이므로, 실제 도입에서는 자기 문서 형식과 반복 작업을 넣어 비교하는 편이 맞다.
긴 입력을 반복할 때 비용은 어디에서 갈리나
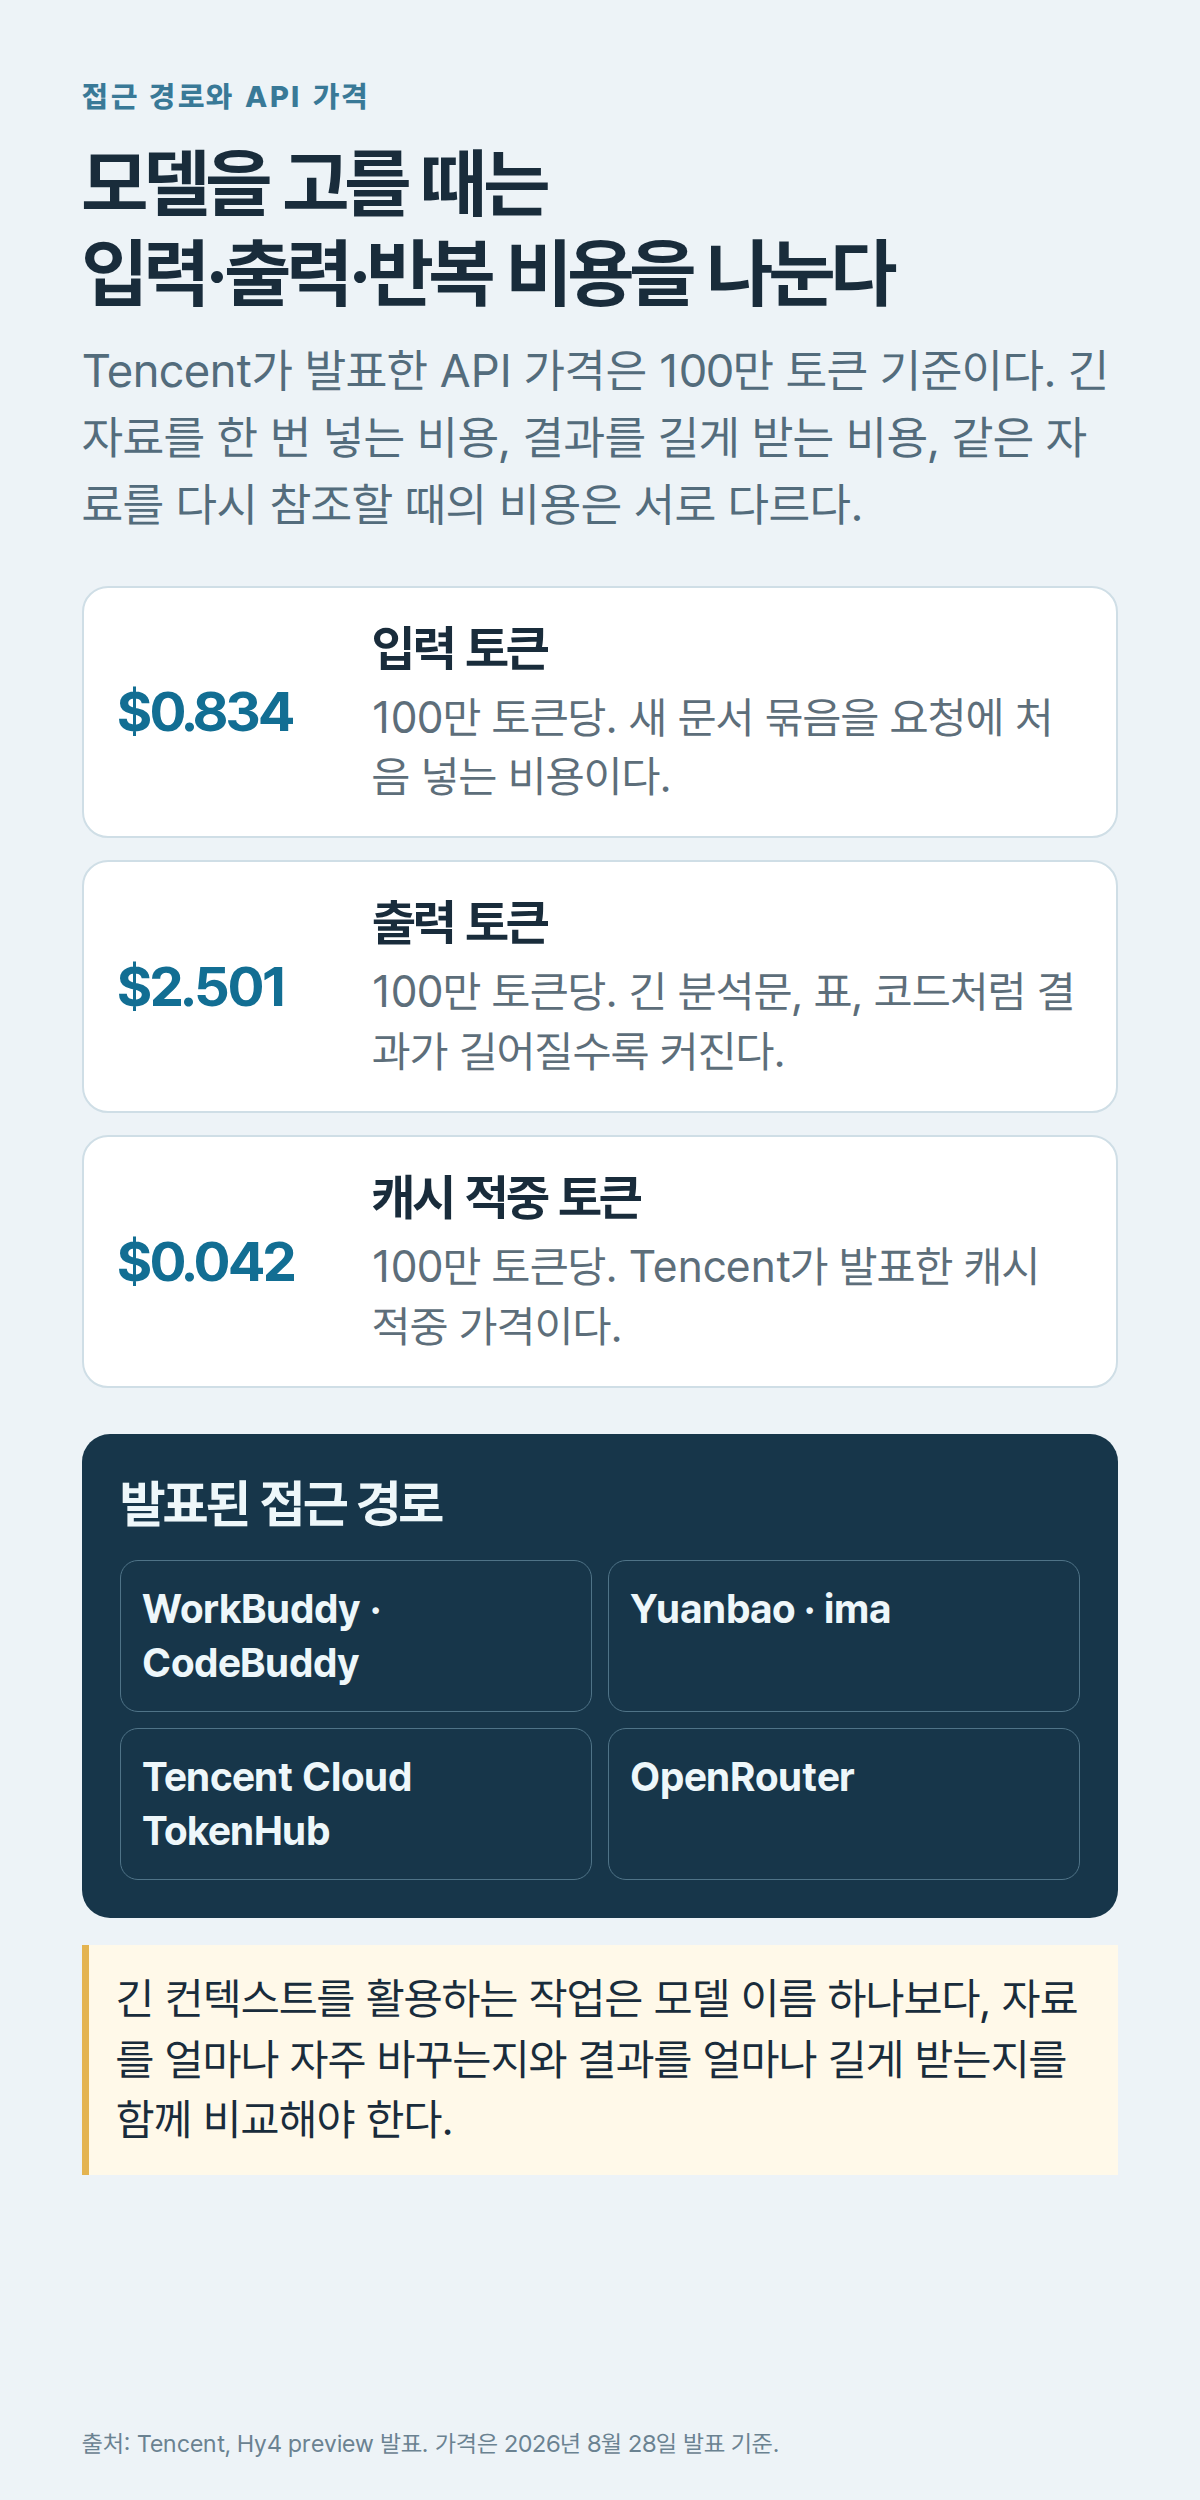
API 가격은 100만 토큰 기준으로 입력 0.834달러, 출력 2.501달러, 캐시 적중 0.042달러다. 같은 자료를 반복해 참조하는 작업은 입력 토큰만 볼 일이 아니다. 문서를 얼마나 자주 바꾸는지, 답변을 표와 보고서처럼 길게 받는지, 캐시가 실제 요청에 적용되는지를 함께 계산해야 한다.
Hy4 preview는 WorkBuddy와 CodeBuddy, Yuanbao, ima에서 사용할 수 있고 Tencent Cloud TokenHub와 OpenRouter를 통한 API 접근도 제공한다. 처음에는 긴 자료를 넣는 비용과 결과 길이를 작은 실제 업무 묶음으로 비교해 본 뒤, 문서 분할과 재입력 부담이 줄어드는지 확인하는 순서가 낫다. 긴 컨텍스트 자체가 목적이 아니라, 자료를 다시 옮기고 잃어버리는 시간을 줄이는 수단이기 때문이다.
출처: Tencent, Tencent Releases and Open-Sources Tencent Hy4 preview · Tencent Hy4 preview 모델 카드