
서비스를 소개한 글에 추천이 100개쯤 붙었다. 그런데 정작 사이트를 쓰는 사람은 몇 명인데 서버는 계속 버거워했다. 맞춤형 뉴스 피드 리더 Sprinklz를 만든 새미 스트라우스(Sammy Straus)가 공개한 운영 경험이다. 개발자 커뮤니티 Hacker News에 서비스를 알린 뒤 사이트가 느려졌고, 며칠이 지나도 나아지기는커녕 더 심해졌다.
요청 기록을 나눠 보니 실제 이용과 다른 트래픽이 드러났다. 요청 대부분은 뉴스 기사 조회를 시도하지 않았다. 전체 트래픽의 거의 절반은 웹사이트 변화를 반복 확인해 AI 뉴스레터로 요약하는 한 서비스에서 왔다. 제품에 대한 관심을 확인하려던 운영자에게 먼저 필요한 일은 서버에 도착한 요청과 실제 이용을 구분하는 것이었다.
첫 페이지를 받았다고 뉴스를 읽은 것은 아니다
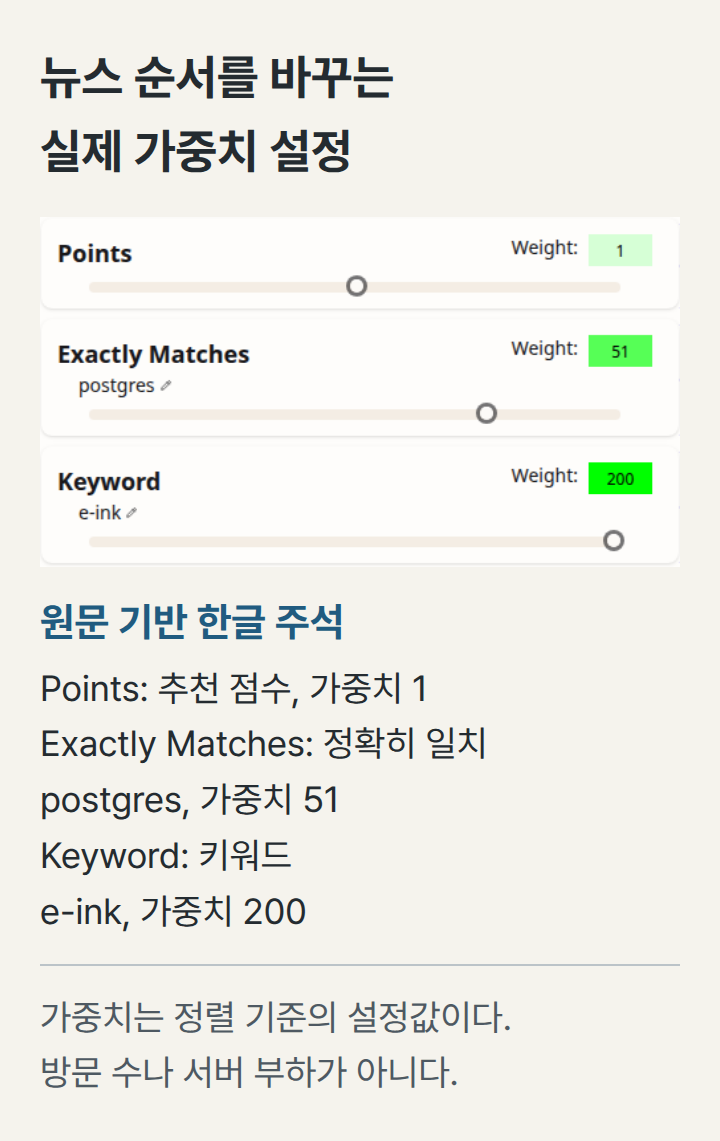
Sprinklz는 뉴스의 순서를 사용자가 바꿀 수 있는 피드 리더다. 추천 점수 외에 특정 키워드나 주제의 가중치를 조절할 수 있고, 관심 없는 주제가 뒤로 밀리도록 설정한다. 실제 공개 데모에는 기사 목록 옆에 점수와 키워드별 가중치 설정이 놓여 있다. 소개 글이 주목받은 이유도 대규모 언어 모델(LLM) 이야기를 덜 보고 싶은 사람들이 이 기능을 반겼기 때문이라고 저자는 설명한다.
이 서비스는 브라우저에서 자바스크립트를 실행해 화면을 구성하는 단일 페이지 애플리케이션(SPA)이다. 저자는 URL 경로마다 요청 횟수를 기록했고, 대부분의 요청이 뉴스 조회 단계까지 가지 않는 것을 발견했다. 실제 뉴스 이용과 동떨어진 요청이 서버를 차지하고 있었던 셈이다. 이 사례에서 자바스크립트를 실행하지 않은 요청이 단서가 됐지만, 모든 서비스에서 자바스크립트 실행 여부만으로 사람과 봇을 가를 수 있는 것은 아니다.
운영자는 같은 시간대의 첫 페이지 요청, 뉴스 조회 요청, 로그인한 활성 이용자를 따로 볼 수 있다. 첫 페이지 요청만 급증하고 뉴스 조회와 활성 이용자는 따라오지 않는다면, 먼저 요청이 어디서 끝나는지 살펴볼 이유가 생긴다. 반대로 실제 이용까지 함께 늘었다면 처리 용량을 늘려야 할 가능성이 커진다. 방문 수 하나에 이 둘을 합쳐 놓으면 홍보 성과도, 장애 원인도 읽기 어렵다.
요청을 누가, 어느 경로로 보냈는가
스트라우스는 NGINX라는 웹서버의 접근 로그를 모아 요청 주체별로 확인했다. 그 결과 트래픽 거의 절반을 보내는 한 주체를 찾았고, 해당 서비스가 사이트 변경 사항을 AI 뉴스레터로 요약한다고 소개하는 것을 확인한 뒤 차단했다. 저자는 집계 기간과 요청 건수 대신 이 주체의 비중을 “거의 절반”으로 설명했다.
나머지 요청도 한 종류가 아니었다. 이름을 밝힌 AI 크롤러, 구글 검색 색인용 크롤러, 취약점을 찾는 스캐너가 섞여 있었다. 워드프레스를 쓰지 않는 사이트에 -/wp-content/phpinfo.php를 요청한 흔적도 있었다. 이 경로는 저자가 적은 탐색 사례이지 Sprinklz의 정상 기능 주소가 아니다.
그래서 요청 경로별 횟수와 요청 주체별 빈도를 함께 보는 편이 낫다. 총요청이 많다는 사실만으로는 특정 주체가 같은 주소를 거듭 확인하는지, 여러 이용자가 실제 기능을 쓰는지 알 수 없다. 로그에 응답 상태와 처리 시간을 함께 남기면 없는 주소를 탐색하는 요청과 오래 걸리는 정상 기능도 구별하기 쉬워진다. 제품의 이용 지표와 서버 운영 지표를 같은 시간 범위로 비교하되, 서로 같은 수치라고 취급하지 않는 방식이다.
검색은 열어 두고 반복 수집은 줄일 수 있다
저자는 일부 AI 크롤러의 수집을 삼가 달라는 robots.txt를 추가하고 검색용 트래픽은 허용했다. 10월 14일 직접 확인한 Sprinklz의 파일은 이 구분을 더 세분화한다. Googlebot 등 검색 크롤러는 허용하고, GPTBot과 ClaudeBot 등은 수집 금지로 표시한다. OAI-SearchBot 같은 검색용 봇과 ChatGPT-User 같은 사용자 요청용 봇은 별도 그룹에서 허용한다. 같은 회사 이름이 붙은 봇도 용도에 따라 다르게 취급한다.
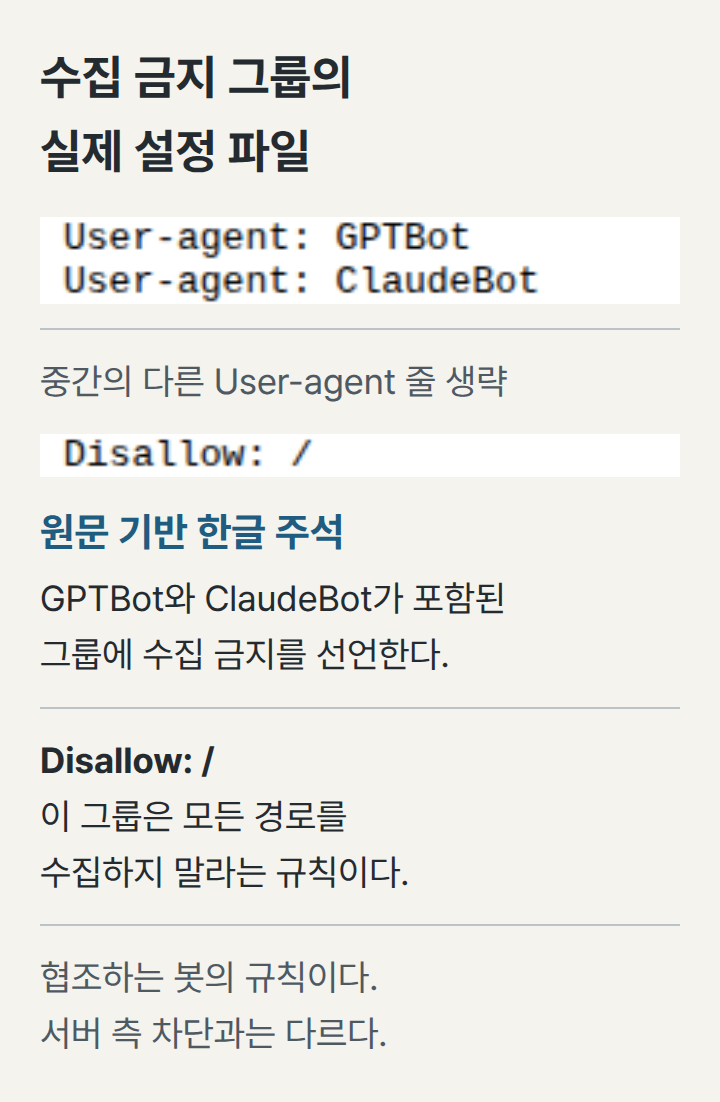
robots.txt는 협조하는 크롤러가 따르는 규칙이다. 구글의 공식 설명도 이 파일이 크롤러의 행동을 강제하지 못한다고 명시한다. 파일에 수집 금지를 적는 것과 서버가 요청을 실제로 막는 것은 다른 조치다. 규칙을 무시하고 같은 주소를 계속 요청하는 주체에는 서버 측 차단이나 요청 빈도 제한이 필요하다.
NGINX의 공식 요청 제한 모듈은 IP 같은 기준별로 처리 속도를 제한할 수 있다. 허용 속도를 넘으면 요청을 늦추고, 설정한 순간 허용량까지 넘으면 거절한다. 제한을 실제로 적용하지 않은 채 초과 요청을 집계하는 시험 모드도 제공한다. 정상 이용자의 동작을 보면서 기준을 정할 수 있다는 뜻이다. 스트라우스도 요청 제한을 추가했지만, 자신의 구체적인 설정값은 공개하지 않았다.
봇을 막은 뒤에도 서버 개선은 남는다
이 경험을 쓴 저자의 결론은 수집 봇을 없애는 데서 끝나지 않는다. 실제 이용자의 요청이 많아져도 감당할 수 있는 사이트를 만들고 싶어 이후 몇 주 동안 기반 구조를 개선했다고 적었다. 특정 처리량을 달성했다는 수치는 제시하지 않았다.
서비스를 홍보한 뒤 비슷한 느려짐을 만났다면, 서버 증설에 앞서 요청 경로와 반복 요청 주체를 나눠 보는 것이 출발점이 된다. 불필요한 요청을 줄인 다음에도 정상 뉴스 조회가 느리다면 그 경로의 처리 비용을 줄여야 한다. 이후에는 같은 시간 범위의 실제 이용과 응답 시간을 다시 비교해, 차단 효과와 제품 성능 개선을 따로 확인할 수 있다.
출처: Sammy Straus의 운영 경험, Sprinklz robots.txt, Google의 robots.txt 설명, NGINX 요청 제한 모듈