
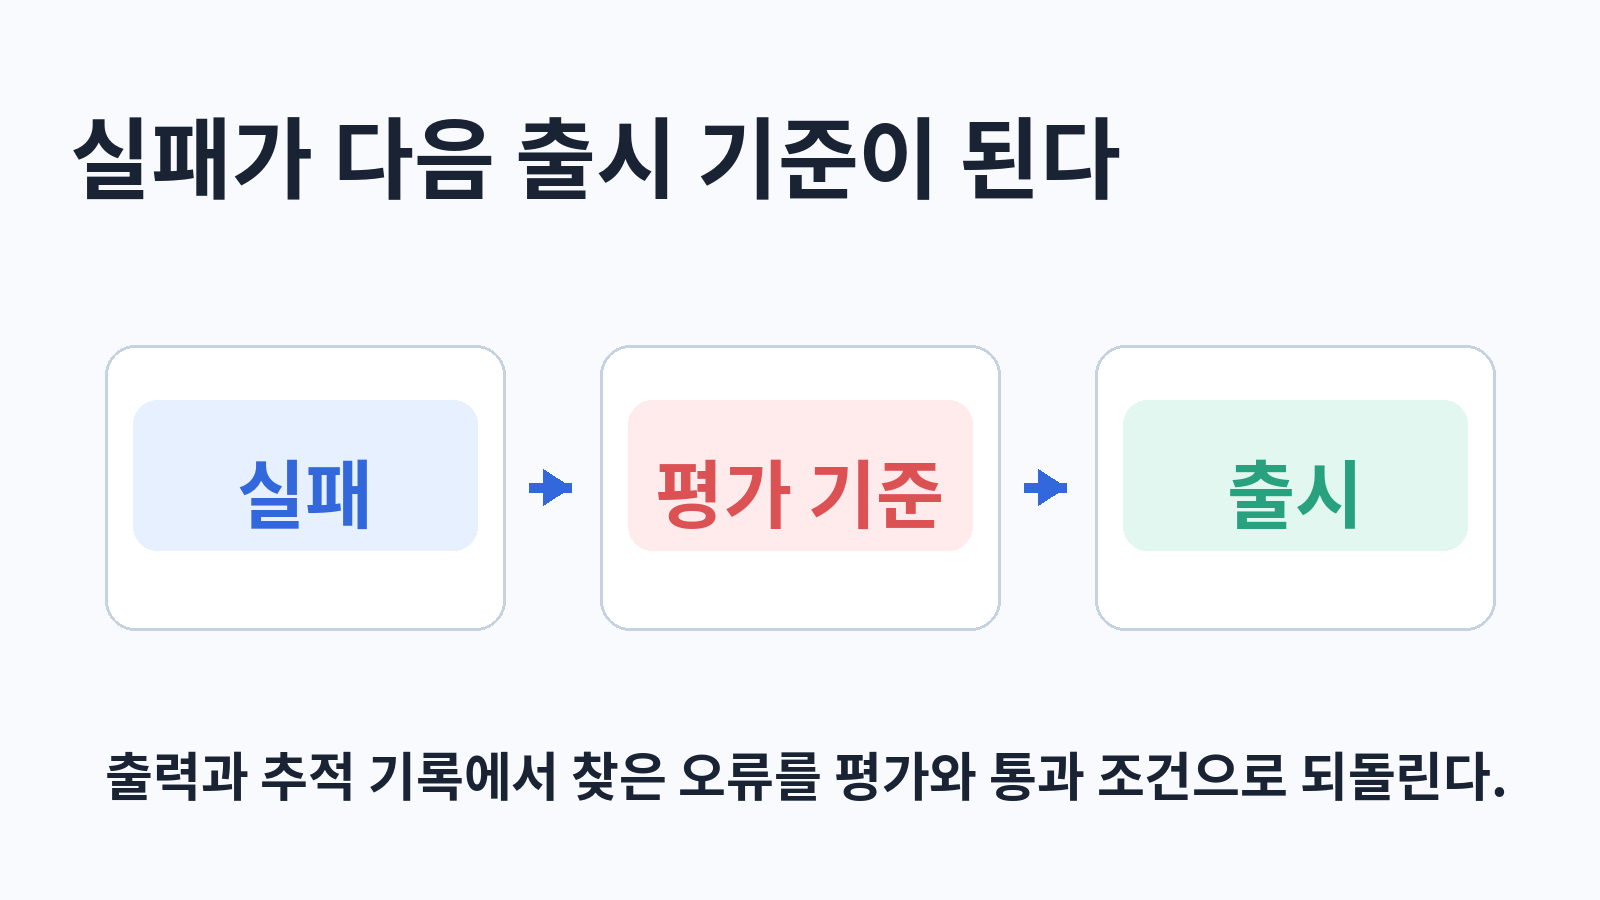
생성형 AI 기능은 같은 입력에도 다른 답을 낼 수 있고, 좋은 답의 기준에는 정확성뿐 아니라 말투·관련성·안전성·형식이 함께 들어간다. 검색, 추론, 도구 호출, 응답 생성이 이어지는 에이전트에서는 마지막 문장이 맞아도 중간에 잘못된 도구를 호출했을 수 있다. Airbnb 엔지니어링 팀은 2026년 7월 28일 공개한 글에서 이 문제를 해결하는 출발점을 ‘평가 주도 개발(Eval-driven development, EDD)’로 제시했다. 모델을 고른 뒤 품질을 재는 절차가 아니라, 제품이 무엇을 잘해야 하는지 먼저 정하고 그 기준으로 기능을 만드는 방식이다.
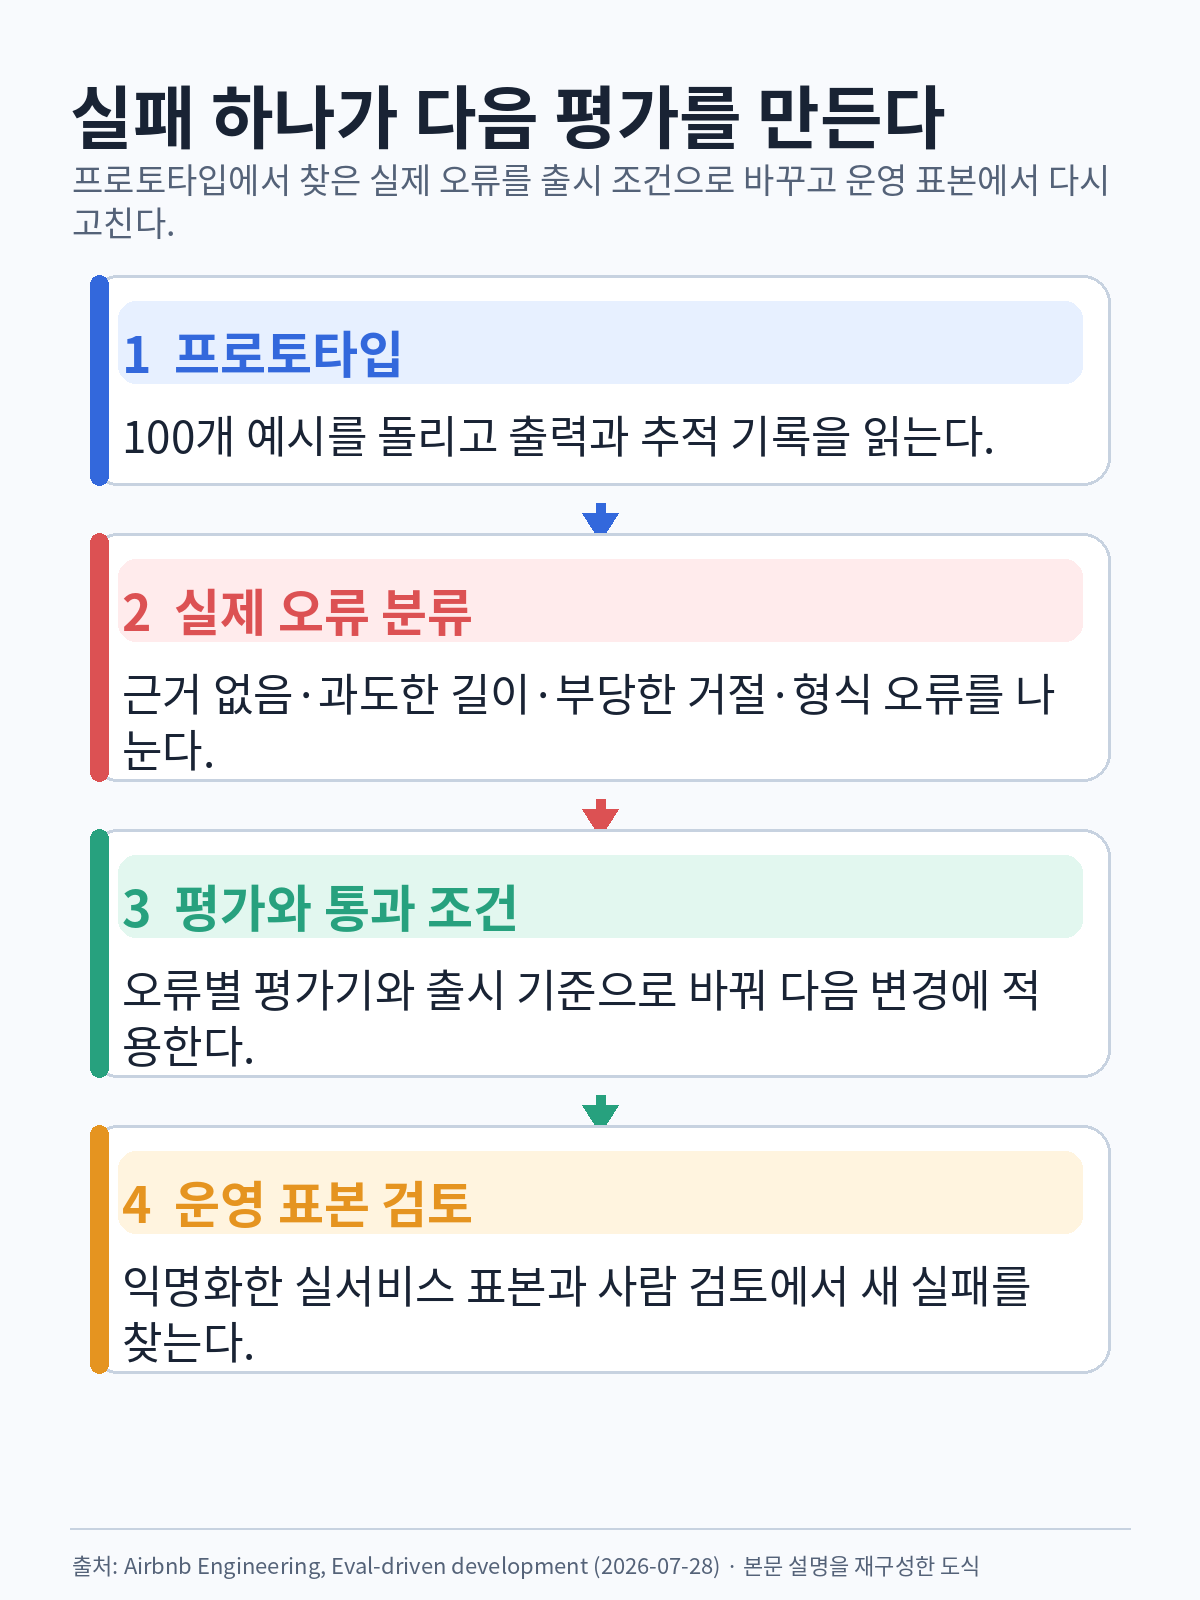
Airbnb가 강조한 첫 습관은 단순하다. 프로토타입에 100개 입력을 넣고 출력과 추적 기록을 직접 읽는 일이다. 합성 예시여도 된다. 그 안에서 실제 실패를 찾아 분류해야 ‘도움이 되는가’ 같은 넓은 점수가 놓치는 오류를 잡을 수 있다. 근거 없는 정책 내용을 만들어 내는 답, 너무 긴 답, 정당한 질문을 거절하는 답, 깨진 JSON은 모두 서로 다른 실패다. 하나의 평균 점수로 합치면 다음 수정이 무엇이어야 하는지가 사라진다.
평가는 출시 전 마지막 관문이 아니라 개발의 입력이 된다
EDD는 실패를 예측해 완벽한 시험표를 먼저 만드는 방법이 아니다. 제품을 돌려 보고, 실제 오류를 발견하고, 그 오류를 판정 규칙으로 바꾼 뒤, 다음 변경 때 계속 검사하는 순환이다. 이 과정은 PM·운영·도메인 전문가에게도 “좋다”의 뜻을 구체적으로 말하게 한다. 출시 조건과 우선순위가 프롬프트 작성자 한 명의 감각에 묶이지 않는 이유다.
그래서 평가 항목은 많을수록 좋지 않다. 원문은 하나의 정확성 차원에 하나의 평가기를 두고, 서로 다른 3~5개의 날카로운 LLM 심판이 20~30개의 흐릿한 심판보다 낫다고 권한다. 예를 들어 고객 지원 답변이라면 출처 충실성, 간결성, 형식 유효성은 분리할 수 있다. 팀은 각 기준의 최종 판정을 내릴 사람도 정해야 한다. 정답의 경계가 제품 정책과 경험 설계에 걸치면, 모델 점수만으로 의견 차이를 끝낼 수 없기 때문이다.
코드 검사, LLM 심판, 사람의 판단은 어떻게 나눌까
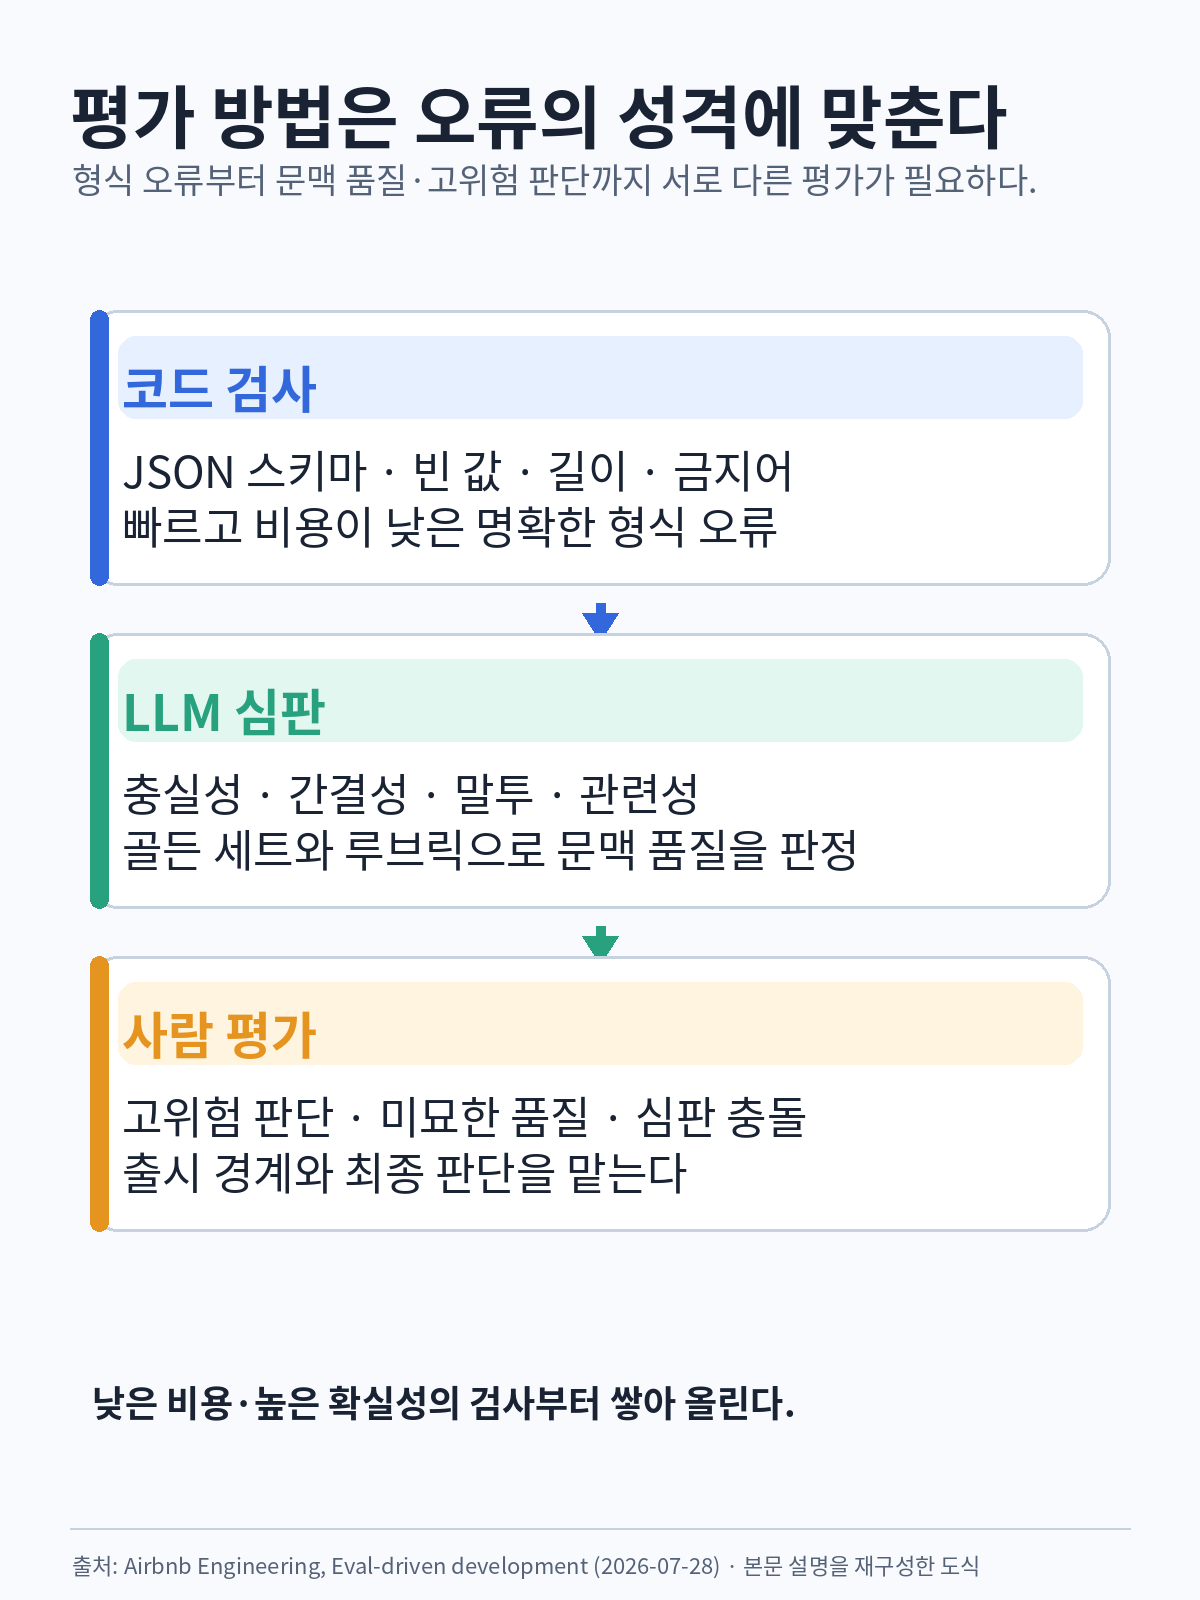
Airbnb는 평가를 세 겹으로 둔다. 먼저 JSON 스키마, 빈 값, 길이 범위, 금지어처럼 명확한 실패는 코드 검사로 빠르게 거른다. 그다음 말투·일관성·문서 충실성처럼 문맥이 필요한 항목은 별도 루브릭을 받은 LLM 심판이 본다. 고위험 판단, 미묘한 창의성, 자동 심판끼리의 충돌은 사람이 맡는다. 세 방법을 서로 대체재로 놓기보다, 비용이 낮고 확실한 검사부터 쌓아 올리는 구조다.
LLM 심판은 강한 모델을 붙인다고 바로 신뢰할 수 있는 도구가 되지 않는다. Airbnb는 좋은 사례와 나쁜 사례를 모두 포함한 50~100개 골든 세트로 심판을 먼저 맞춰 보라고 권한다. 사람이 붙인 판정과의 일치율을 측정하고, 높은 80%대에서 90%대 합의에 이를 때까지 루브릭과 예시를 고친다. 원문의 예시에서는 정책 충실성 심판이 PM과 처음 78%만 일치했지만, 정확한 바꿔쓰기를 오류로 처리한다는 원인을 찾아 루브릭을 보완한 뒤 88%로 올랐다. 이 단계는 심판의 숫자를 늘리기보다 판정 문장을 읽을 수 있게 만드는 작업이다.
에이전트는 최종 답만 맞으면 통과할 수 없다
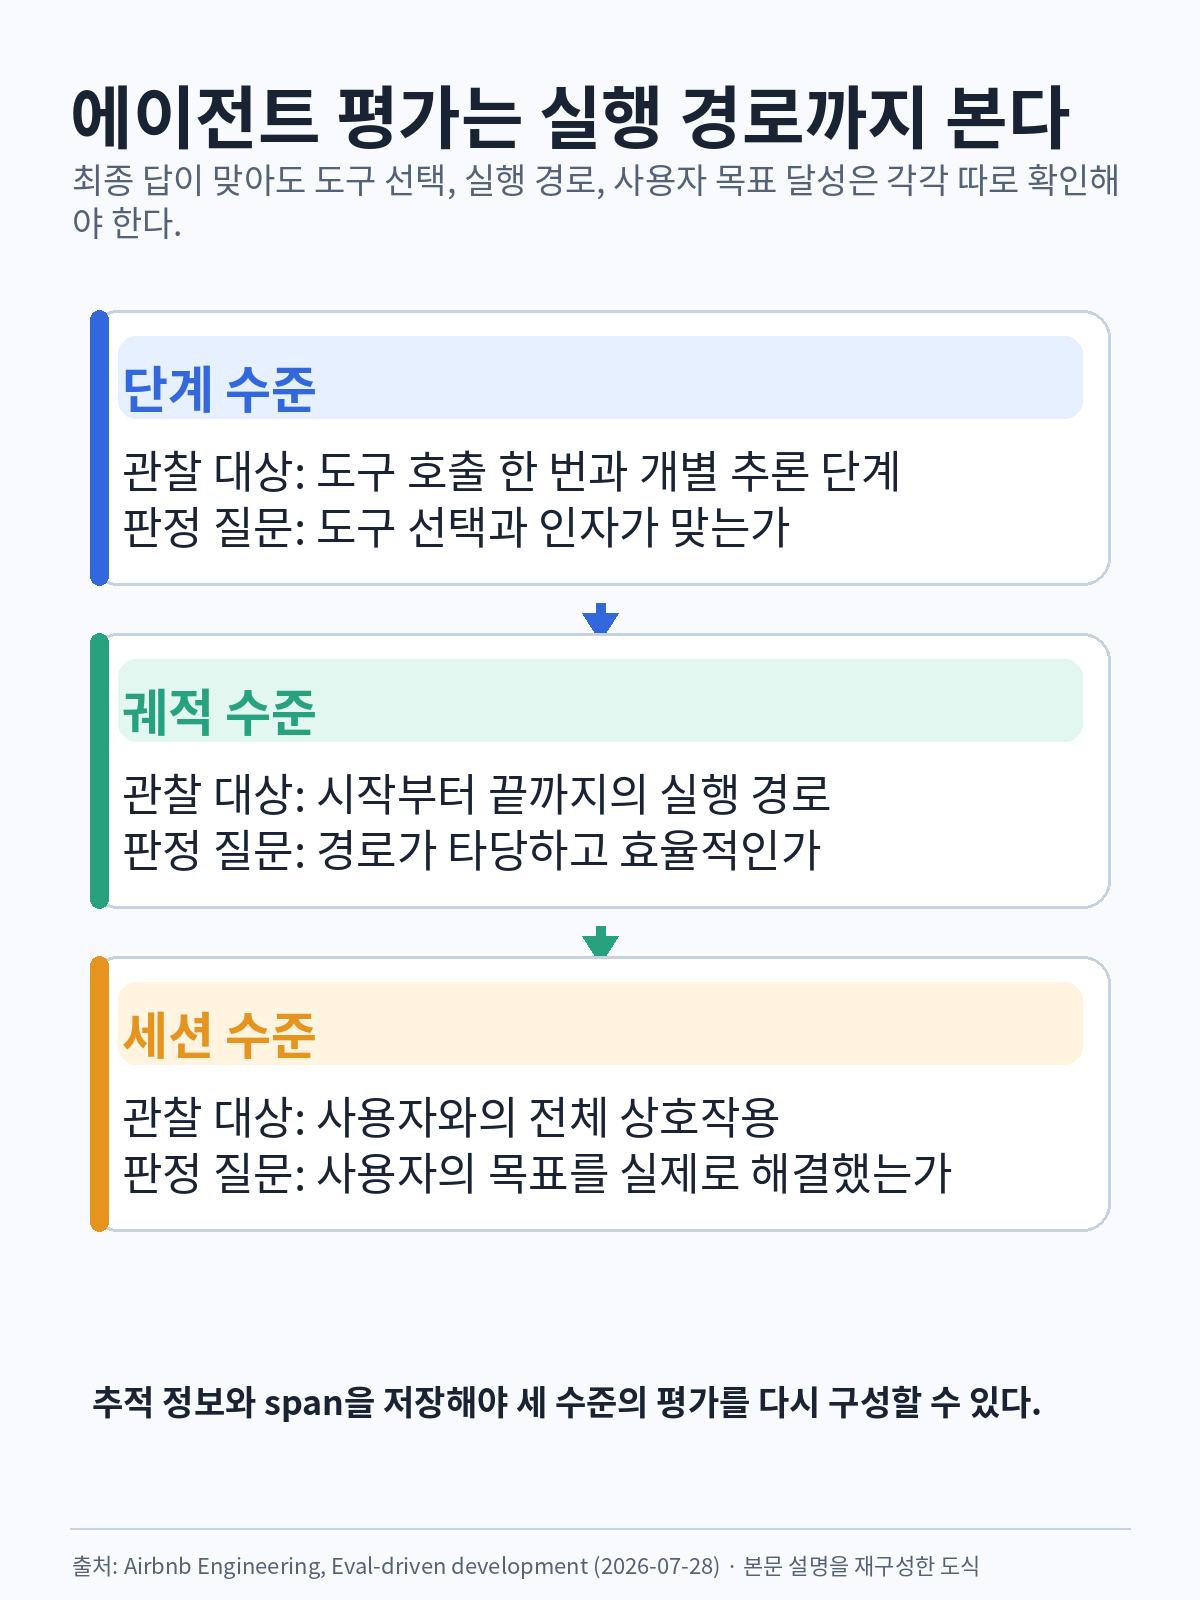
도구를 쓰는 에이전트는 최종 답변만 평가하면 실패를 숨긴다. 올바른 답에 도달했더라도 잘못된 검색 조건, 불필요한 호출, 엉킨 하위 에이전트 경로가 남을 수 있다. Airbnb는 개별 도구 호출과 추론 단계를 보는 단계 수준, 전체 경로의 타당성과 효율을 보는 궤적 수준, 사용자의 목표가 해결됐는지를 보는 세션 수준을 분리했다. 이를 위해 애플리케이션 루트 아래의 추적 정보와 span을 저장하고, 트리 순회로 특정 하위 에이전트와 도구 호출을 재구성하는 방식을 소개한다.
평가의 끝도 출시가 아니다. Airbnb의 예시 운영안은 익명화한 실서비스 트래픽의 5%를 매일 표본으로 뽑아 코드 검사와 LLM 심판을 돌리고, 표시된 출력은 사람이 검토하는 방식이다. 매주 PM 검토에서 새 실패 유형이 나오면 평가 항목과 시스템 개선으로 다시 연결한다. 이 흐름에서 평가는 모델의 성적표가 아니라 제품팀이 어떤 오류를 허용하지 않을지 합의하고, 그 합의를 운영 중에도 지키는 장치가 된다.