
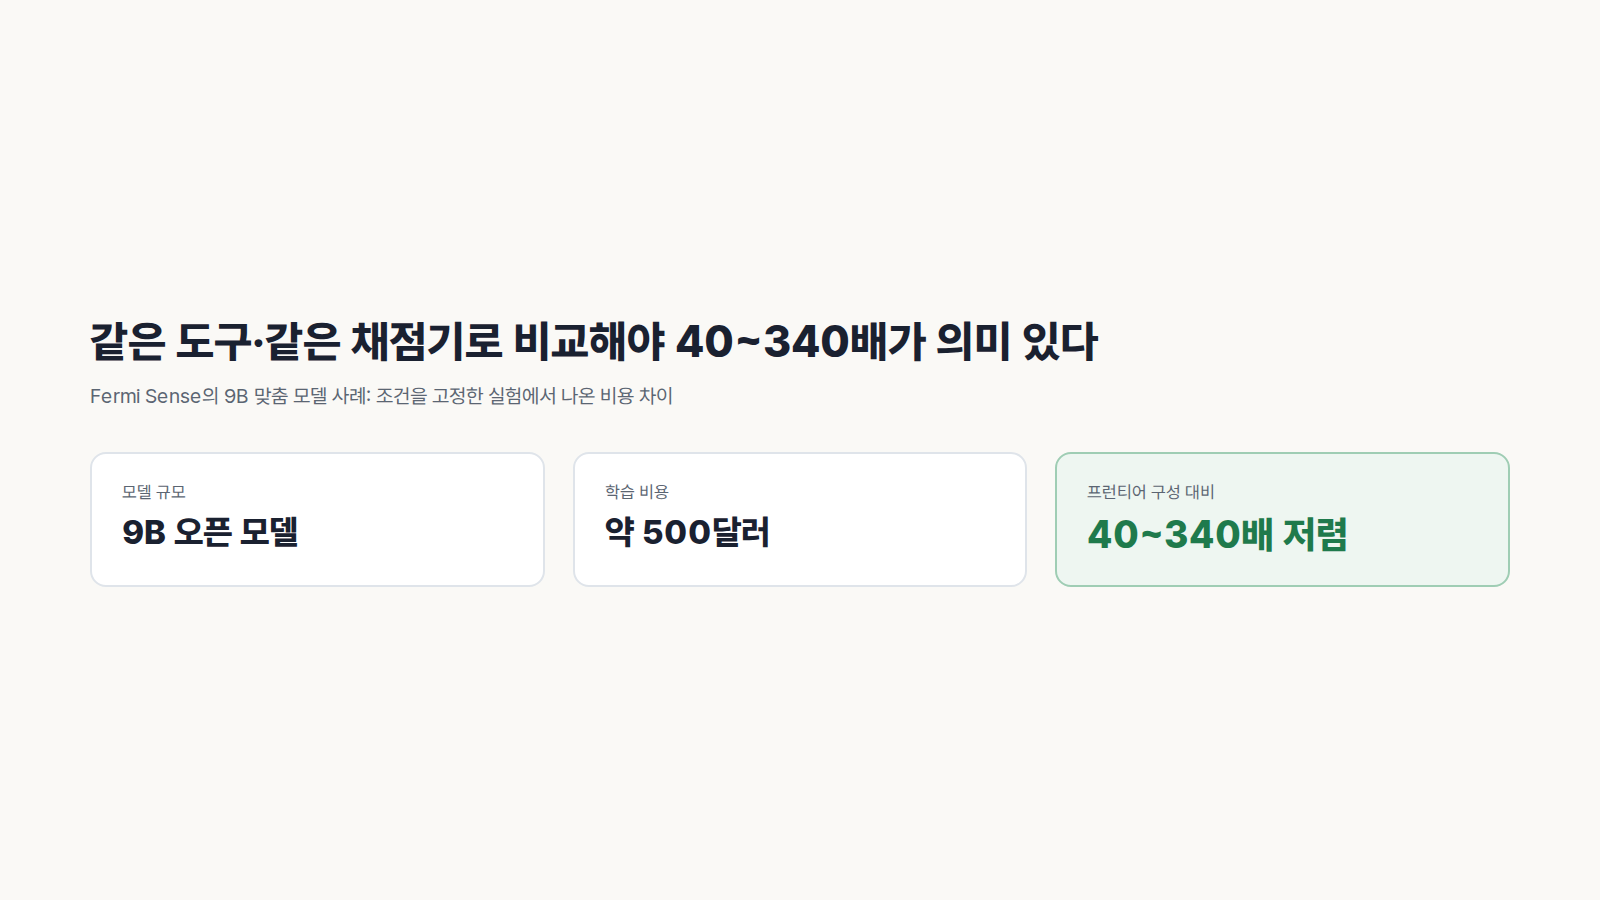
작은 오픈 모델이 거대 모델을 이겼다는 말은 이제 흔하다. 그래서 이런 결과를 볼 때는 제목보다 실험 조건을 먼저 봐야 한다. Fermi Sense는 전자상거래 상품 정보 검수 업무에 9B 규모 오픈 모델을 강화학습으로 미세조정했고, 같은 도구·이미지·채점기를 붙인 여러 프런티어 모델 설정보다 좋은 결과를 냈다고 공개했다.
이 회사가 말하는 비용도 구체적이다. 학습에는 약 500달러를 썼고, 운영 비용은 상품 1,000건당 0.50달러 수준이었다고 한다. 회사가 제시한 비교에서는 가장 싼 프런티어 구성보다 약 40배, 가장 비싼 구성보다 약 340배 저렴하다. 숫자만 보면 “작은 모델이면 충분하다”는 결론으로 바로 가기 쉽다.
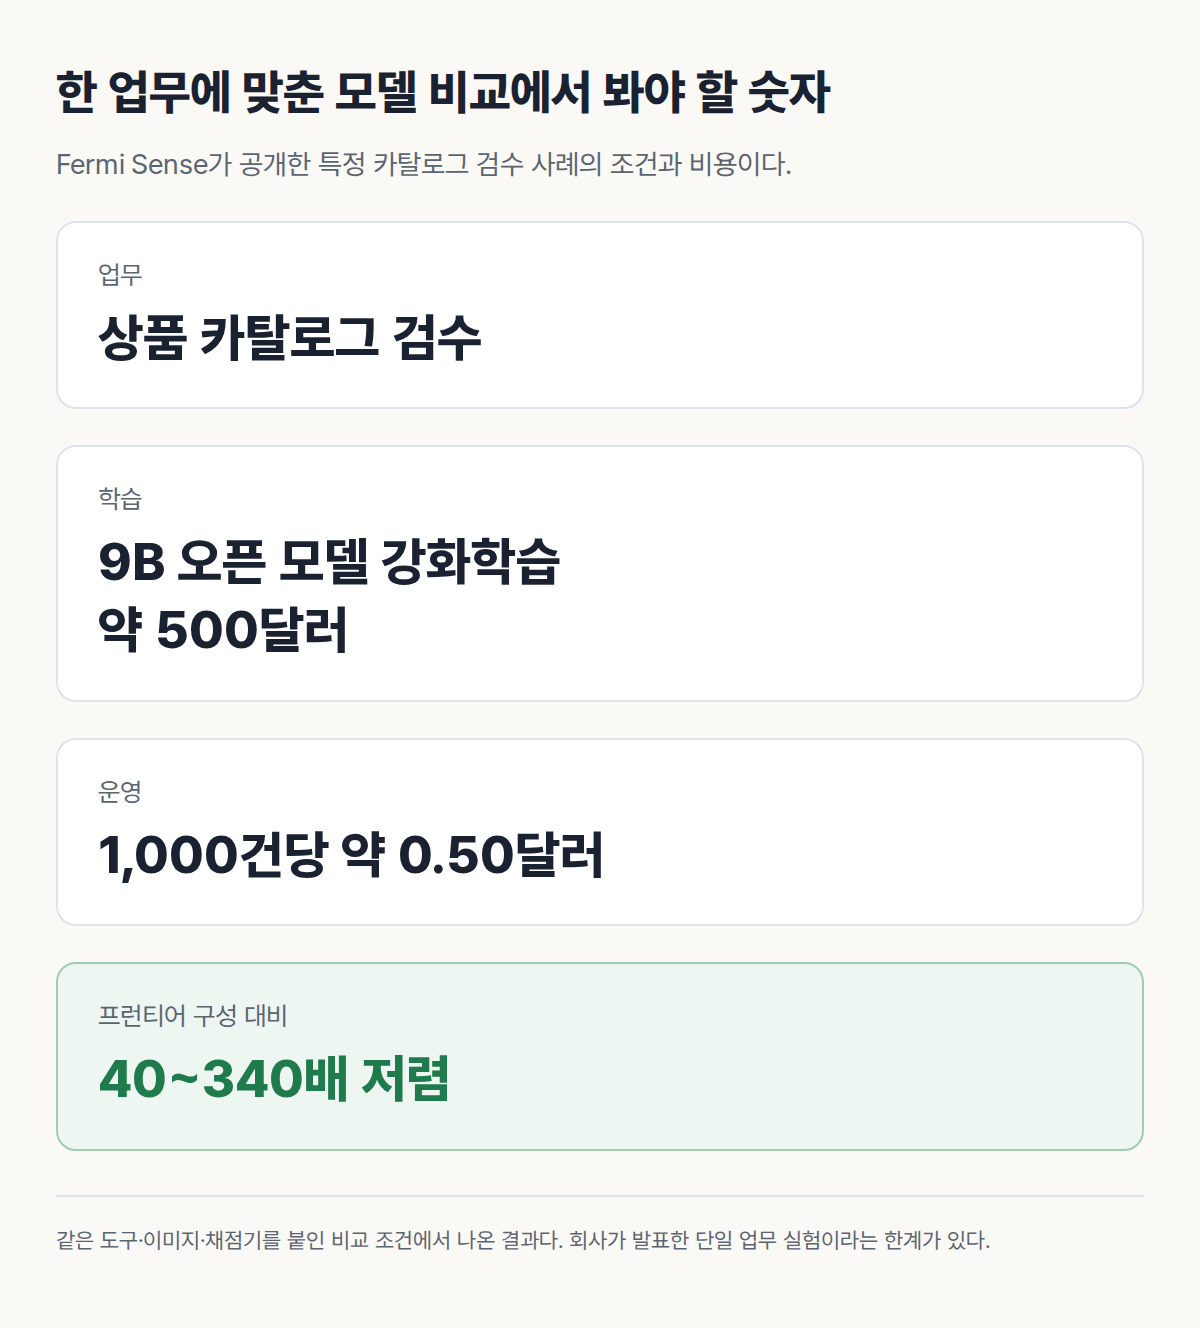
하지만 이 사례의 흥미로운 부분은 모델 크기가 아니라 업무의 모양이다. 이 모델은 범용 질문에 답하도록 만든 것이 아니라, 상품 카탈로그의 오류를 찾는 한 업무에 맞춰 훈련됐다. 제품명, 규격, 이미지, 분류처럼 입력 형식이 비교적 안정적이고, 결과가 맞았는지 틀렸는지 나중에 확인할 수 있는 일이다.
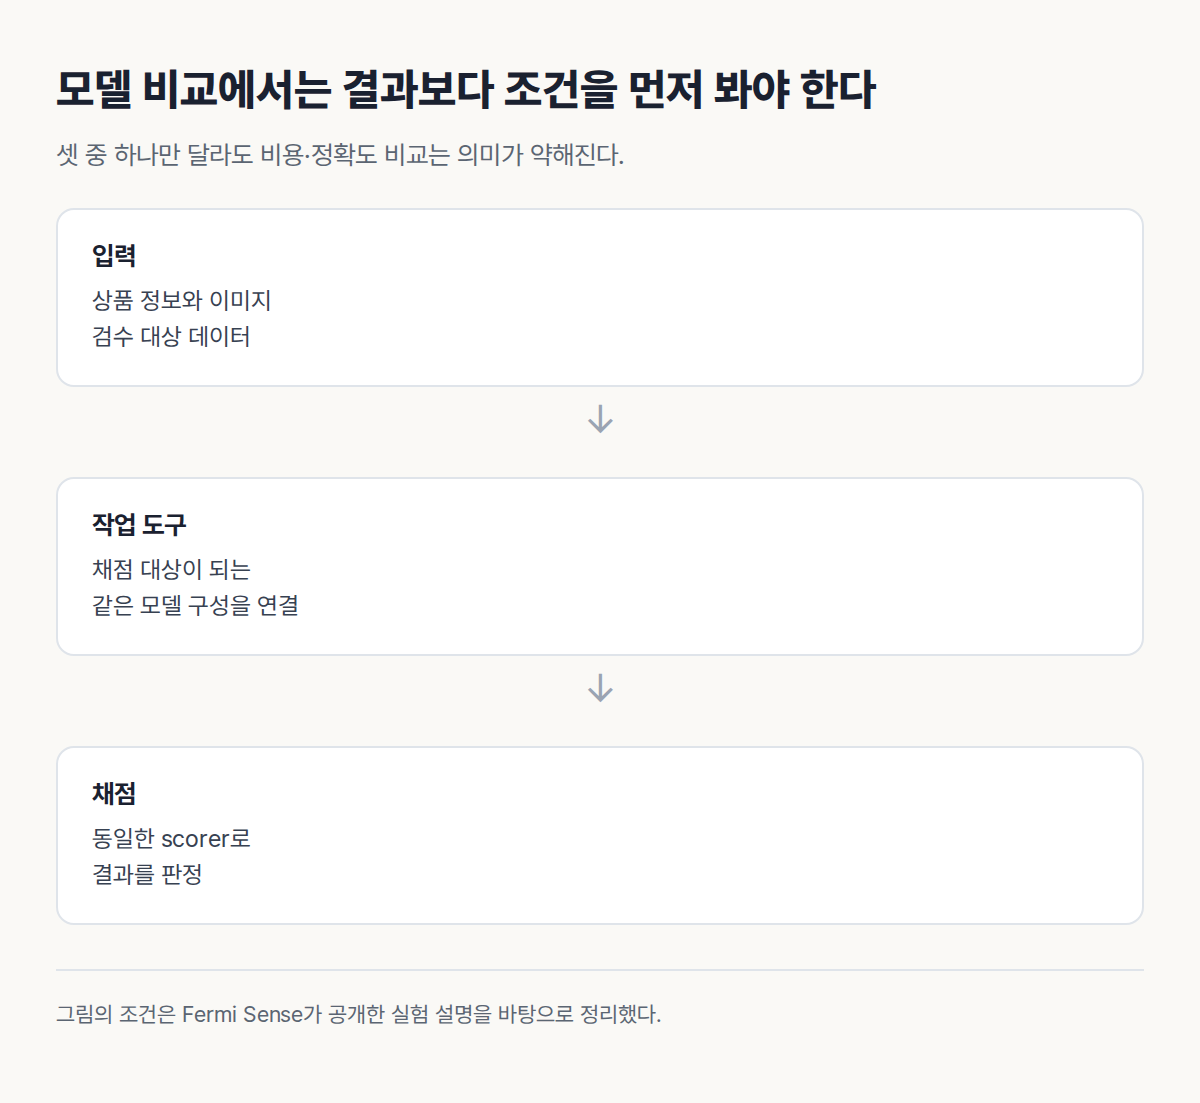
그런 업무에서는 모델을 얼마나 크게 쓰느냐보다 평가를 얼마나 단단하게 설계하느냐가 더 중요해질 수 있다. 같은 상품 데이터를 보여 줬는지, 같은 도구를 붙였는지, 같은 채점기로 결과를 평가했는지가 맞지 않으면 비용이나 정확도 비교는 의미가 약해진다. 회사가 같은 도구·이미지·채점기를 썼다고 강조한 이유도 여기에 있다.
학습비 500달러도 맥락 없이 보면 오해하기 쉽다. 이 돈은 회사 전체의 AI 전환 비용이 아니라 특정 업무에서 반복적으로 쓸 모델을 만드는 비용이다. 학습 뒤에도 데이터 정리, 정답 검수, 배포, 모니터링, 성능이 떨어졌을 때의 재학습 비용은 계속 든다. 반대로 처리량이 충분히 많다면 매 요청마다 비싼 모델을 부르는 비용보다 이 운영 비용이 훨씬 작아질 수 있다.
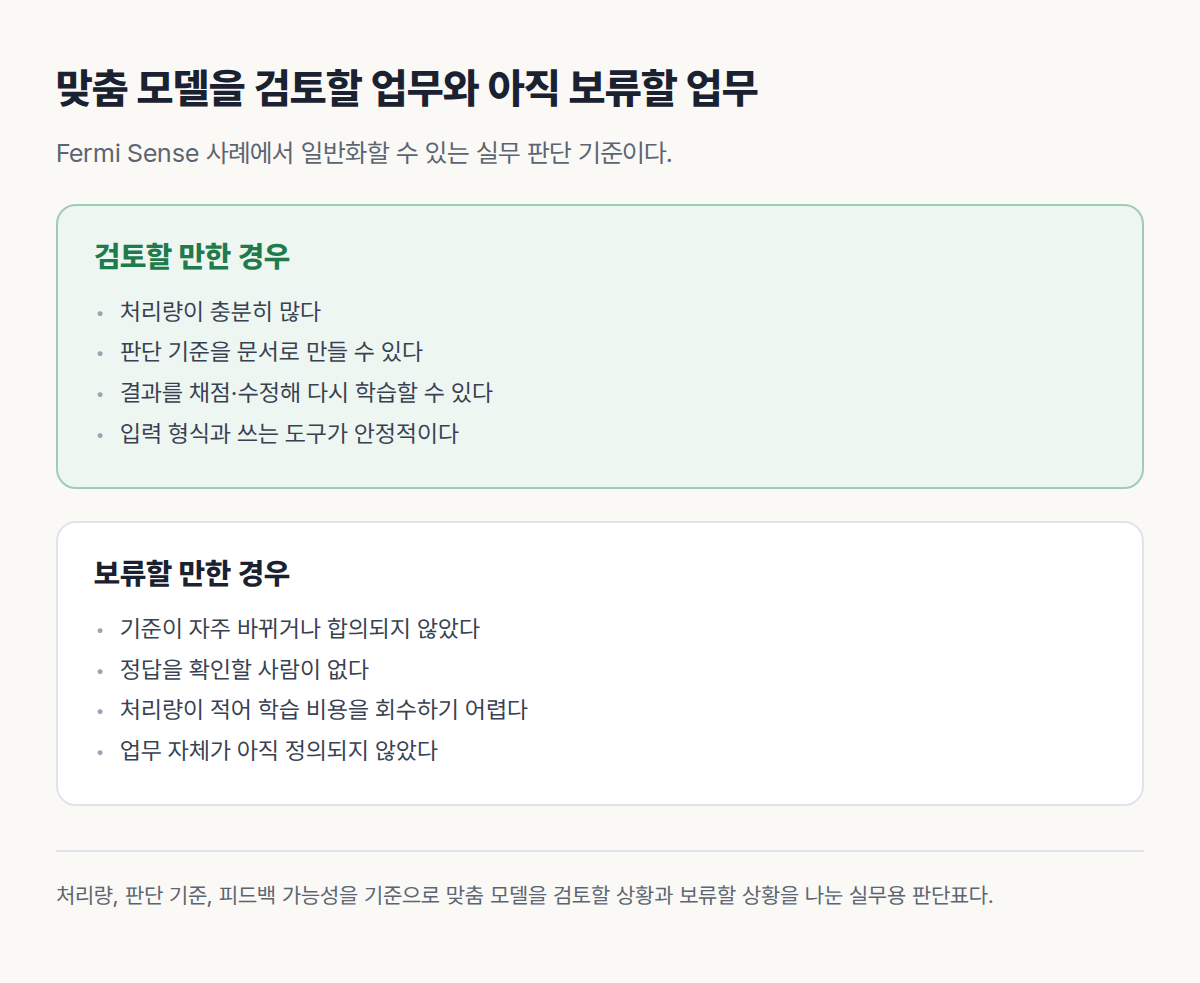
그래서 이 사례는 “거대 모델을 버리자”는 이야기가 아니다. 처음에는 범용 모델로 업무를 탐색하고, 사람이 고친 결과를 모으고, 판단 기준이 안정된 뒤에 맞춤 모델을 검토하는 순서가 더 현실적이다. 범용 모델은 업무를 정의하는 데 좋고, 맞춤 모델은 정의된 업무를 싸고 일정하게 반복하는 데 좋다.
맞춤 모델을 고려할 만한 신호도 비교적 분명하다. 처리량이 많고, 판단 기준을 문서로 만들 수 있고, 결과를 채점해 다시 학습에 쓸 수 있을 때다. 반대로 기준이 매주 바뀌거나, 정답을 확인할 사람이 없거나, 업무 자체가 아직 흔들린다면 모델을 학습하기 전에 일을 먼저 정리하는 편이 낫다.
전자상거래에서는 이런 식의 업무가 생각보다 많다. 상품명과 옵션의 충돌, 사진과 설명의 불일치, 금지된 표현, 잘못된 카테고리, 누락된 규격처럼 사람이 기준표를 들고 반복 확인하는 일이다. 이런 문제는 정답을 완벽하게 자동화하지 못해도, 사람이 최종 검수하기 전 걸러 주는 수준만으로 비용을 줄일 수 있다.
그렇다고 이 결과를 일반적인 모델 성능 순위로 받아들이면 안 된다. 회사가 공개한 자체 실험이며 외부 재현 결과가 아니다. 다른 카탈로그, 다른 언어, 다른 오류 유형, 다른 도구 환경에서도 같은 결과가 나온다는 뜻은 아니다. 특히 “프런티어 모델보다 낫다”는 표현은 그 회사가 정의한 업무와 채점 방식 안에서만 읽어야 한다.
그래도 질문의 순서는 바꿔 볼 만하다. “어떤 모델을 쓸까”보다 “우리 조직에서 무엇을 반복해서 확인하고, 무엇을 정답으로 판단할 수 있을까”가 먼저다. 이 두 가지가 선명해진 뒤에야 작은 모델을 학습하는 비용과 큰 모델을 계속 호출하는 비용을 제대로 비교할 수 있다.